トレーニングセットで最も忙しいように見えるスキャンが、なぜOCRモデルを損なう可能性があるのか
元論文: ERank in Latent Space as an Image-Complexity and Richness Measure — Maksim Smirnov, Grigory Kononov, Anastasiia Linich, Egor Surkov, Egor Shvetsov
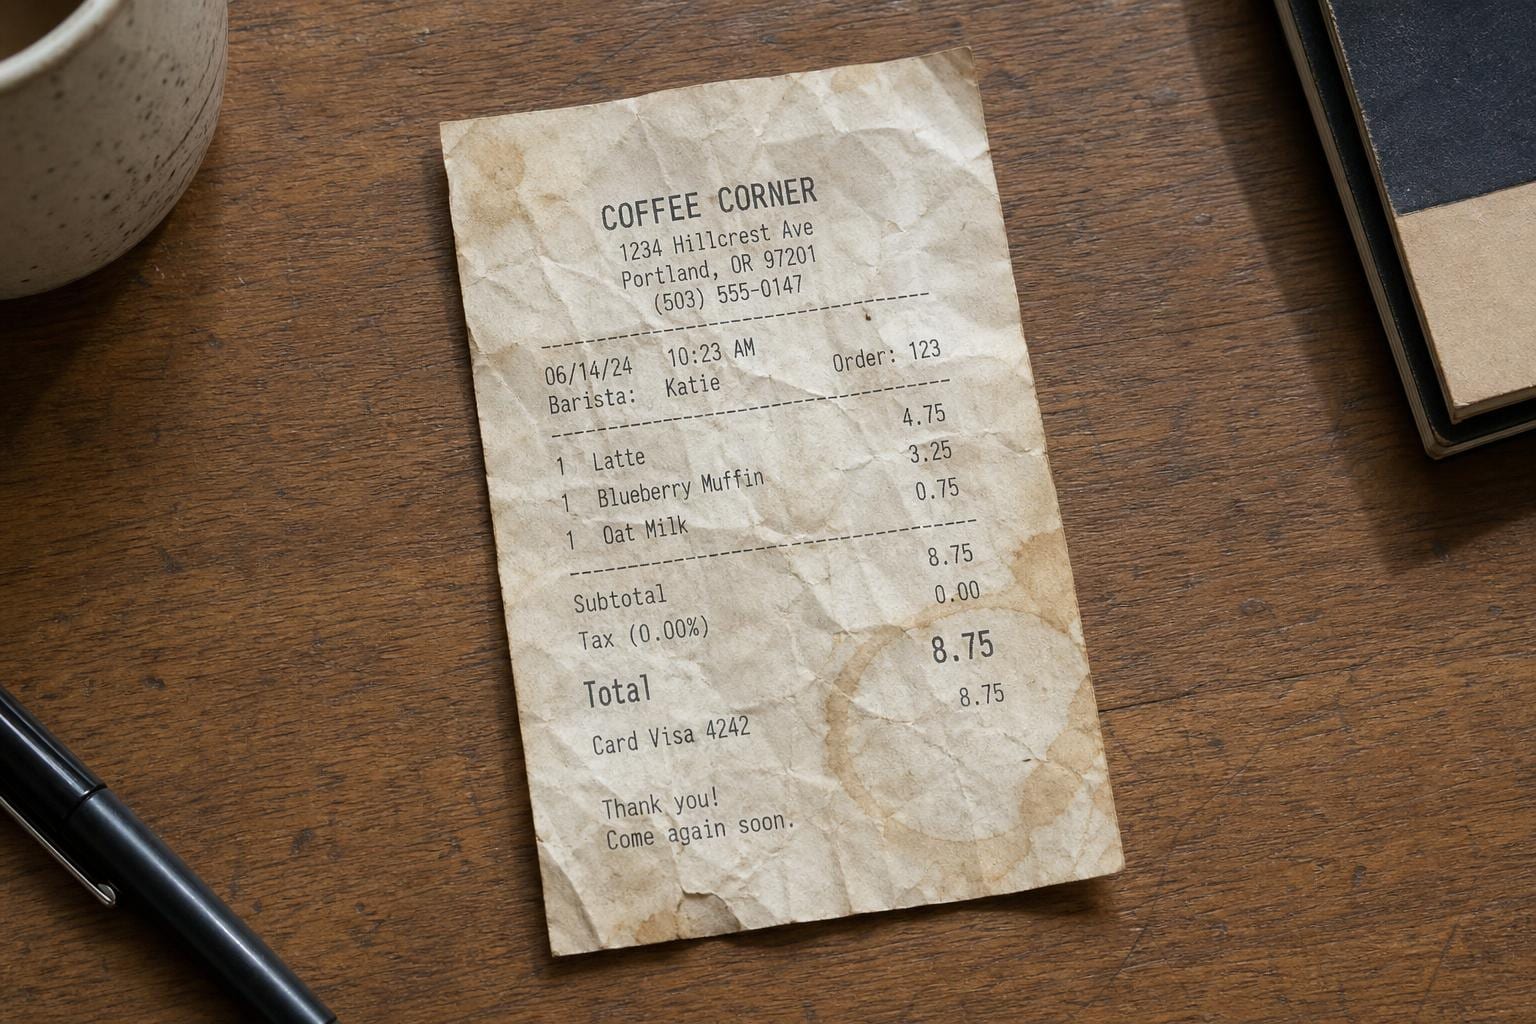
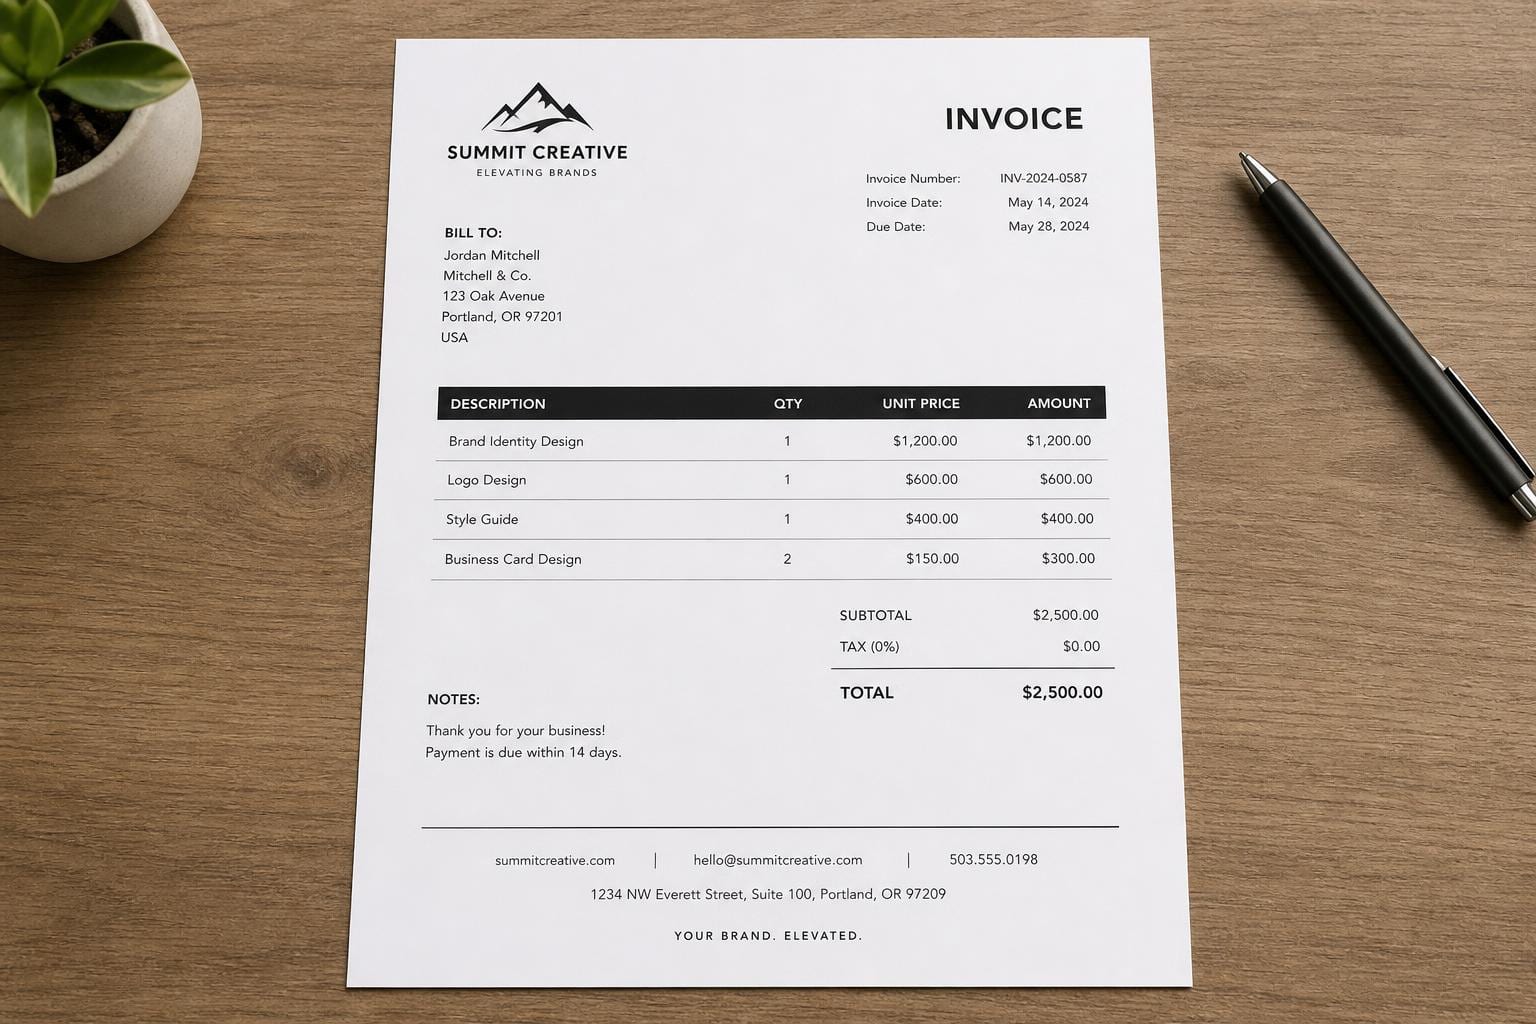
同じトレーニングフォルダに2つのドキュメントスキャンが置かれていると想像してください。一方は白い背景に黒い文字、隅にロゴが入ったきれいな請求書です。もう一方は、一週間財布の中で使われてきたレシートで、シミがあり、しわが寄っており、光を反射する光沢のある感熱紙に印刷されています。人間の目には、それらが異なることがわかります。新しい論文が主張するのは、この違いの数値も、ラベルなし、トレーニングなしで、ニューラルネットワークを1回通すだけで計算できるということです。そして、OCRデータをキュレーションする人々を驚かせるべき点はここにあります。OCRの文脈では、この数値で最も高いスコアを得たドキュメントこそ、しばしば捨てるべきものなのです。
この論文は「ERank in Latent Space as an Image-Complexity and Richness Measure」と題され、Maksim Smirnov、Grigory Kononov、Anastasiia Linich、Egor Surkov、Egor Shvetsovによって書かれています。線形代数の枠組みで包装された短く有用なアイデアですが、メトリクス自体が安価で再利用可能であること、そしてデータ選択の結果が「より多くの情報を持つデータほど常に良いトレーニングデータである」という直感に反していることから、理解する価値があります。
画像の「情報量」を測定するのは、思っているよりも難しい
一山の画像を視覚的な複雑さ(シンプルなものから複雑なものまで)でランク付けしたいとしましょう。これはすでに解決済みだと思われるかもしれませんが、実際にはそうでもありません。
安価な手法はすべて、他の何らかの指標の代理に過ぎません。JPEGファイルサイズ(またはコーデックのビットレート)は画像の圧縮性を示し、複雑さとは相関しますが、解像度、ノイズ、特定のコーデックの特性にも依存します。エッジ密度(SobelやCannyフィルタがエッジとして検出するピクセル数)はテクスチャは捉えられますが、砂利の写真と密集した文字の写真と同様に「複雑」とみなしてしまうため、コンテンツそのものに関心がある場合は有用ではありません。シャープネス指標(通常はラプラシアンフィルタの分散)は、豊かさではなく焦点の合っているかどうかを示します。これらはいずれも学習済みモデルを必要としない点が魅力ですが、互いに一致せず、人間が同じ画像をランク付けするのとも一致しません。
高価な手法は、単に人間に尋ねることです。IC9600は、まさにこの目的のために構築された公開データセットで、人間が注釈付けた複雑さスコアを持つ9,600枚の画像から成ります。これは良い正解データですが、数百万サンプルのトレーニングセットのすべての画像に対して人間のパネルを実行することはできず、また実行する必要もありません。
欠けているのは、その中間にあるものです。ピクセルレベルのヒューリスティックのように安価でありながら、人間評価者が暗黙的に行うように、学習済みモデルが画像で実際に「見ている」ことに基づいた情報を持つものです。ERankが埋めようとしているのは、まさにこのギャップです。
画像が実際に利用している方向の数を数える
以下に、数式を除いたメカニズムを示す。分類や埋め込みに用いられるような、凍結済みで既に訓練済みの画像エンコーダに画像を入力し、ネットワークの中間層にあるある特徴マップで処理を停止する。その特徴マップには、ネットワークが学習過程で検出したあらゆるパターン(特定の角度のエッジ、色のコントラスト、テクスチャの種類など)に対応するチャネルが存在する。画像の各空間位置において、これらのチャネルはそれぞれある活性化値で発火する。
ここで単純な問いを立てる。画像全体を通じて、これらのチャネルは互いにどれほど独立しているか? 空白の壁がネットワークに入力される場合、局所的な差異(平坦な色、エッジなし、テクスチャなし)が少ないため、ほとんどのチャネルは連動して動く。わずかな数のチャネルが変動の大部分を説明する。一方、農産物市場や散らかった机のような画像が入力されると、異なる領域で異なるチャネルの組み合わせが激しく活性化される(あるパッチではエッジ、別の場所では色のグラデーション、さらに別の場所では細かなテクスチャなど)。そのため、互いに独立して振る舞うチャネルの数が大幅に増える。
「どれだけのチャネルが独立して振る舞っているか」を、チャネル共分散行列の有効ランク(effective rank)を用いて形式化できる。画像全体におけるチャネル間の共分散を求め、その固有値を確率分布に正規化し、その分布のエントロピーを計算する。エントロピーを指数関数化することで、整数である必要はないがランクのように振る舞う数値、ERankが得られる。退屈な画像は、数百もの可能なチャネルの中から十数程度のERankを得るかもしれない。一方、豊かで複雑な画像は、その何倍もの値を示すかもしれない。これは、画像が実際に動かしている独立した「ノブ」の数を柔らかくカウントしたものであり、ラベル付きの判断でも、ファイルサイズでもなく、画像がネットワークの学習済み特徴空間内でどのように位置づいているかという性質そのものである。
この論文の巧妙な点は、訓練もラベルも、タスク固有の設定も不要なところにある。エンコーダを一度実行し、出力に対して少しの線形代数の計算を行うだけで完了する。
数値は実際に人間が「複雑」と呼ぶものを追跡しているのか?
まあまあよく追跡しています。IC9600の人間の評価に対して、ERankは相関係数 r = 0.72 で相関しています。これは完璧な一致ではありません。人間の評価の分散の約半分は説明されていませんが、主観的な人間の判断(「複雑さ」についても人々は完全に一致しないという、そもそもノイズの多いターゲット)に対して検証される、完全に自動でラベル不要の測定値としては、堅実な結果です。
ERankは、改善すべき安価なヒューリスティック(コーデックのビットレート、シャープネス、エッジ密度)とも連動しています。これは驚くべきことではなく、安心できる結果です。ERankが視覚的な「賑やかさ」の直感的な概念と完全に直交するものを測定していないことを確認しています。これは、生ピクセル統計ではなく、モデルの学習済み表現から構築された、同じアイデアのより確固たるバージョンです。
落とし穴:ノイズもまた複雑に見える
ここで、この論文が私に気に入られたアプローチをとっている。単に相関関係を報告して終わるのではなく、ノイズ下でのERankの振る舞いを詳しく検討している。正直なところ、ノイズはERankを過大評価してしまう。画像にランダムなピクセルノイズを加えると、ほぼ必然的にチャンネル間の相関が低下し、ノイズはエッジやテクスチャを無視するため、実際のコンテンツ量が増加していないにもかかわらず、ノイズの多い画像は高いERank値を記録することがある。
これは、文書形状のデータにおいて非常に重要である。スキャンアーティファクト、紙の粒状性、JPEG圧縮ブロック、透け水印などは、すべてこの意味でのノイズである。実際のコンテンツに変更がなくても、目に見える紙のテクスチャと薄い背景水印があるスキャンページは、同じテキストの鮮明なデジタルPDFエクスポートよりも「リッチ」なスコアを得る可能性がある。ERankは、「この画像には本当に多くの視覚的情報がある」と「この画像は単にノイズが多い」を明確に区別できない。この曖昧さが、このメトリクスがOCRデータフィルタとして非常に効果的に機能する理由の核心であり、数値を盲目的に信頼する前に心に留めておくべき点でもある。
真の発見:ERankによるプルーニングは一部のタスクには有益だが、他のタスクにはむしろ害となる
ここが本題だ。著者らはERankをデータ選択の基準として用い、ERank分布の上側または下側を切り捨てることでデータセットのサブセットを選定し、そのモデルを訓練した上で、複数のビジョンタスクにおける結果を測定した。
特に注目すべきは、互いに逆方向を指し示す2つの結果である。
-
低ERankの画像を除去することで、超解像タスクのパフォーマンスが向上した。 超解像モデルは、ぼやけたまたはダウンサンプリングされた入力から細部を再構築することを学ぶ。大部分が平坦な壁、空、空のテーブルトップなどの画像は、テクスチャの再構築についてモデルに教えるべきことがほとんどない。そのような画像の山で訓練することは、ほぼ自明な例に容量を無駄遣いすることになる。ERank分布の下側を切り捨てることで残るのは、より豊かで、よりテクスチャが豊富で、モデルの役割である「細部のハルシネーション(生成)」にとってより教育的なデータとなる。
-
高ERankの画像を除去することで、OCRタスクのパフォーマンスが向上した。 これは直感に反する結果である。訓練ドキュメント内の視覚的情報が多ければ多いほど、そのドキュメントを読むモデルにとって有益になると思うかもしれない。しかしOCRの場合、有用な信号である字形(glyphs)は、画像の比較的低複雑度の部分、すなわち主に平坦な背景と鮮明な暗いストロークに存在する。ドキュメントコーパスで最も高いERankスコアを記録する画像は、テキスト以外のものが特徴空間を支配している傾向がある。例えば、重い背景パターン、埋め込まれた写真、大理石模様の紙、高密度の透かし、あるいは単なるスキャンノイズなどであり、これらは論文で以前指摘された「ノイズ対信号の曖昧さ」そのものである。そのような画像で訓練することは、字形ではなく背景に労力を費やすことになり、ERank分布の上側にはそのような雑多な情報が不均衡に集中している。
そしてこれらを結びつける発見は、ERankによるプルーニングは分類、セグメンテーション、ノイズ除去には何の効果もなかったという点である。その理由についての要旨の記述は、明確な要約となっている:ERankが役立つのは、タスクの難易度が入力の豊かさまたは単純さによって支配されている場合に限られる。写真内の物体を名前付けできるか、または正確なマスクを描けるかは、画像全体でどのくらいの数の特徴チャネルが活性化するかには依存しない。犬が柄物の絨毯の上にいる場合が、ERankスコアが高いためだけに、犬が単色の芝生の上にいる場合よりも分類が難しいわけではない。「複雑さ=豊かさ」と「タスク=難しさ」は2つの異なる軸であり、この3つのタスクにおいてはそれらは一致しない。
この傾向は事前学習と微調整の両方で確認されており、これはある特定の訓練手法によるアーティファクトではなく、タスクがデータから実際に必要とする性質そのものであることを示唆している。
OCRの構築・選定において重要である理由
文書モデルの学習コーパスをキュレーションまたは監査している場合、ERankは、手動で画像にラベルを貼ったり、人間の複雑性評価パネルを待ったりすることなく、データセットのうち「有用なテキスト信号」よりも「背景のノイズ」である可能性が高いサブセットを自動的にフラグ付けするための無料かつ自動的な手段を提供します。これは研究上の興味深い事例ではなく、実際に使えるフィルタです。コーパス全体に対してエンコーダを一度実行し、ERankでソートして、学習に使用する前に上位のデータスライスを入念に確認しましょう。
また、ERankは、気づきやすいものの正確に言語化しにくいパターンに対して説得力のある説明を提供します。大理石模様の本末紙、透かしが強いフォーム、背景ロゴが印刷されたレシートなど、特定の文書タイプはOCRエンジンにとって慢性的に難易度が高い傾向にあります。これらを単に「難しい文書」と呼ぶだけでなく、なぜ難しいのかを定量化する方法が欲しかったのです。ERankは「なぜ」に対する数値を提供します。つまり、これらのページでは背景がテキストとモデルの注意を巡って競合しており、その競合はOCRを実行する前に測定可能なのです。
さらに注目すべき応用として、複数のOCRエンジン間で文書をルーティングするプラットフォームが、ERankを文書ごとのシグナルとして利用する可能性があります。具体的には、視覚的に混雑しているかノイズが多い可能性が高い高ERankのページを、より堅牢だが高価なエンジンに、そしてクリーンな低ERankのページを安価で高速なエンジンに送る仕組みです。ただし、この論文に基づいてそのようなパイプラインを構築・検証した例はまだありません。これは論文が主張していることではなく、結果から自然に導かれる拡張アイデアです。なお、日本語の縦書きレイアウトや漢字の処理は多くのOCR/VLMモデルにとって最も困難なケースの一つですが、本論文が英語のみを対象としており縦書きを無視している場合、日本語読者にとっては漢字や縦書きレイアウトがカバーされていないという点に留意が必要です。
まだ証明されていない点
人間の判断との相関係数 r = 0.72 は良好ですが、完全に一致しているわけではありません。人間が「複雑」と呼ぶもののうち、有意な割合はアクティブな特徴方向の数をカウントするだけで捉えきれず、ERank を有用なプロキシではなく真の基準(ground truth)として扱う前に、この点を念頭に置く価値があります。
この指標は、どの凍結済みエンコーダを使用するかにも依存します。自然画像で事前学習されたネットワークは、ドキュメントで事前学習されたものや、全く異なる目的関数で学習されたものとは異なるチャネルセットを学習するため、論文の結果は使用されたエンコーダに強く結びついています。異なるドメインで ERank を再利用する場合は、同じ閾値がそのまま適用できると仮定するのではなく、再検証を行う必要があります。
OCR に特化して最も注意深く監視すべきはノイズへの感度です。実際のスキャン、レシートなどのスマートフォンの写真、ファックスといった本番環境のドキュメントデータには、コンテンツの豊かさとは無関係な取得ノイズが大量に含まれているためです。ERank が「本質的に情報量の多い画像」と「ノイズの多い画像」を完全に区別できない場合、高 ERank の「不要な要素(clutter)」として除去されるものの一部は単なるスキャンの粒状ノイズであり、逆に本質的に複雑で情報密度の高いドキュメントの一部がそれらと一緒に破棄される可能性があります。論文の OCR 結果は集計レベルで妥当性を示しており、これが最も重要な証拠ですが、フィルタによって除外された個々のドキュメントがすべて適切に除外されたことを意味するわけではありません。
また、データ選択の結果は、前後の比較が明確な研究ベンチマークに基づいています。本番パイプラインはより複雑で、ドキュメントの種類、取得品質、同じコーパスに対する下流の用途が混在しています。特定のデータセットに対して「ERank で上位 N% を削減する」ことが適切なルールかどうかは、論文で効果があったパーセンタイルを盲目的にコピーするのではなく、個別に検証する必要があります。ERank は確立されたレシピではなく、自社のデータでテストする価値のある強力かつ低コストの一次フィルタとして扱うべきです。