Por qué las escaneos que parecen más ocupados en su conjunto de entrenamiento podrían estar perjudicando su modelo de OCR
Basado en: ERank in Latent Space as an Image-Complexity and Richness Measure — Maksim Smirnov, Grigory Kononov, Anastasiia Linich, Egor Surkov, Egor Shvetsov
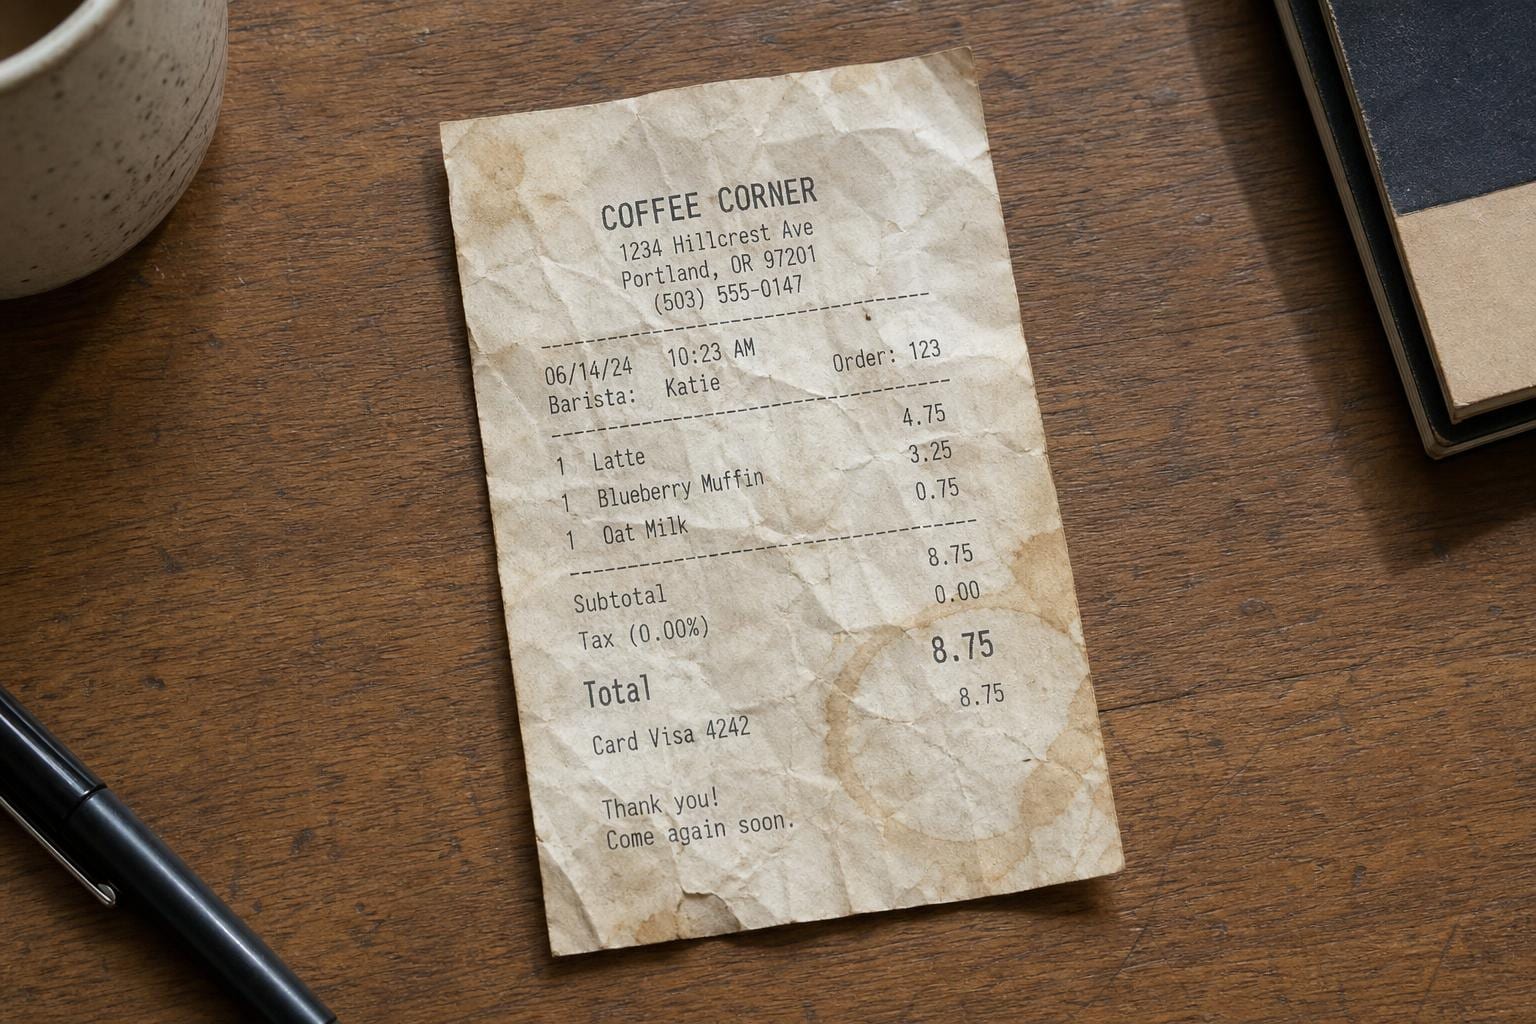
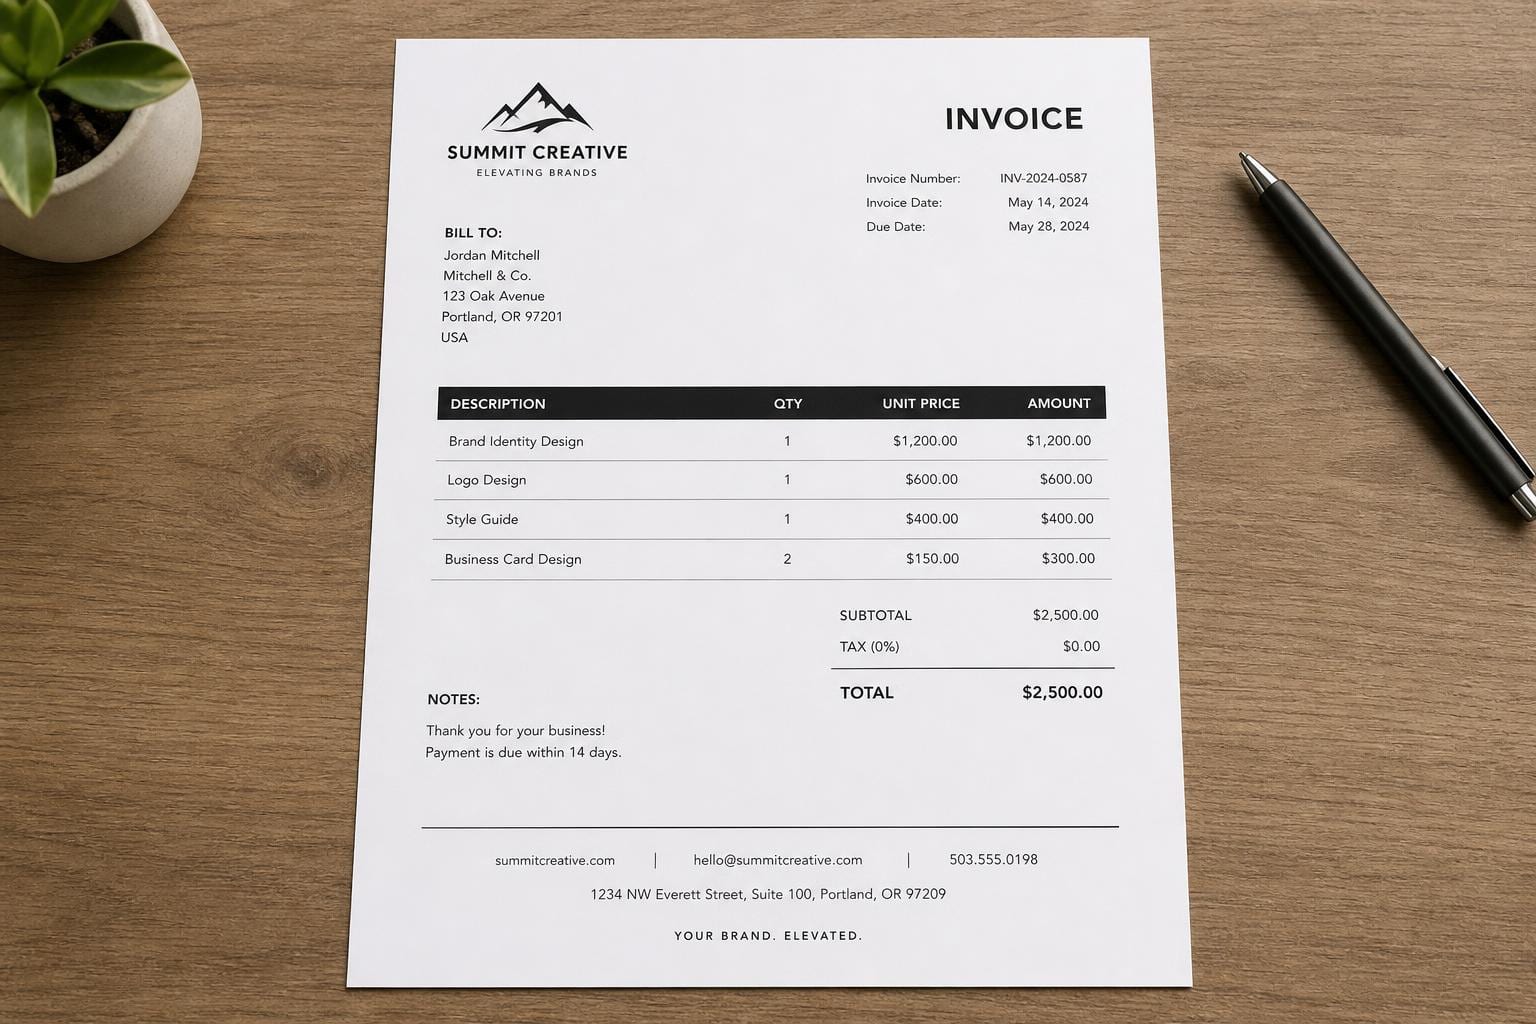
Imagina dos escaneos de documentos en la misma carpeta de entrenamiento. Uno es una factura limpia: fondo blanco, texto negro, un logotipo en la esquina. El otro es un recibo que ha pasado una semana en una billetera, manchado, arrugado, impreso en papel térmico brillante que refleja la luz. Tu ojo puede notar que son diferentes. Lo que argumenta un nuevo artículo es que también puedes obtener un número para esa diferencia, calculado en una sola pasada a través de una red neuronal, sin etiquetas y sin entrenamiento involucrado. Y aquí está la parte que debería hacer que cualquiera que gestione datos de OCR se ponga alerta: específicamente para OCR, los documentos que obtienen la puntuación más alta en esta métrica suelen ser los que deberías desechar.
El artículo se titula "ERank in Latent Space as an Image-Complexity and Richness Measure", de Maksim Smirnov, Grigory Kononov, Anastasiia Linich, Egor Surkov y Egor Shvetsov. Es una idea corta y útil disfrazada de álgebra lineal, y vale la pena entenderla tanto porque la métrica en sí es económica y reutilizable, como porque el resultado de selección de datos va en contra del instinto de que "más información siempre es mejores datos de entrenamiento".
Medir "cuánto hay en juego" en una imagen es más difícil de lo que parece
Supongamos que desea clasificar un montón de imágenes por complejidad visual, desde las más simples hasta las más saturadas. Podría pensar que esto ya está resuelto. No es así, no de manera clara.
Las opciones económicas son todos proxies de algo más. El tamaño del archivo JPEG (o la tasa de bits del códec) le indica qué tan comprimible es una imagen, lo cual se correlaciona con la complejidad, pero también con la resolución, el ruido y las particularidades de un códec específico. La densidad de bordes, es decir, cuántos píxeles un filtro Sobel o Canny marca como borde, capta la textura, pero trata una foto de grava y una foto de texto denso como igualmente "complejas", lo cual no es útil si realmente le importa el contenido. Las métricas de nitidez (generalmente la varianza de un filtro Laplaciano) le indican información sobre el enfoque, no sobre la riqueza. Ninguna de ellas requiere un modelo entrenado, que es su atractivo, y ninguna de ellas coincide entre sí ni con cómo una persona clasificaría las mismas imágenes.
La opción costosa es simplemente preguntar a las personas. IC9600 es un conjunto de datos público creado exactamente para esto: 9.600 imágenes con puntuaciones de complejidad anotadas por humanos. Es una buena verdad fundamental, pero no puede ejecutar un panel humano sobre cada imagen en un conjunto de entrenamiento de millones de muestras, y no debería necesitar hacerlo.
Lo que falta es algo intermedio: económico como las heurísticas a nivel de píxel, pero informado por lo que un modelo entrenado realmente "ve" en la imagen, de la manera implícita en que lo hacen los evaluadores humanos. Ese es el vacío que ERank intenta llenar.
Contando cuántas direcciones utiliza realmente una imagen
Aquí está el mecanismo, sin la matemática. Pasa una imagen a través de un codificador de imágenes congelado y ya entrenado, del tipo utilizado para clasificación o embeddings, y detente a mitad de camino, en uno de los mapas de características internos. Ese mapa de características tiene un canal para cada patrón aprendido que la red detecta: bordes en ciertos ángulos, contrastes de color, tipos de textura, lo que la red haya capturado durante su propio entrenamiento. En cada ubicación espacial de la imagen, cada uno de estos canales se activa con un cierto valor de activación.
Ahora hazte una pregunta simple: ¿qué tan independientes son estos canales entre sí en toda la imagen? Si una pared en blanco pasa por la red, la mayoría de los canales se moverán juntos, porque no hay nada local que los diferencie: color mayormente plano, sin bordes, sin textura. Un puñado de canales explica casi toda la variación. Si un mercado de agricultores o un escritorio desordenado pasa por la red, diferentes regiones activan combinaciones salvajemente diferentes de canales: bordes en un parche, gradientes de color en otro, textura fina en otro lugar, por lo que muchos más canales se comportan de manera independiente entre sí.
Puedes formalizar "cuántos canales se comportan de manera independiente" con el rango efectivo de la matriz de covarianza de los canales. Toma la covarianza entre los canales a lo largo de la imagen, obtén sus valores propios, normalízalos en una distribución de probabilidad y calcula la entropía de esa distribución. Exponencia la entropía y obtendrás un número, ERank, que se comporta como un rango pero que no necesita ser un número entero. Una imagen aburrida podría obtener un ERank de una docena aproximadamente, de cientos de canales posibles. Una rica y desordenada podría usar muchas veces esa cantidad. Es un conteo suave de cuántos "interruptores" independientes está girando realmente la imagen, no un juicio etiquetado, no un tamaño de archivo, solo una propiedad de cómo se sitúa la imagen en el propio espacio de características aprendido de la red.
Esta es la parte ingeniosa del artículo: no necesita entrenamiento, ni etiquetas, ni configuración específica para la tarea. Ejecuta el codificador una vez, haz un poco de álgebra lineal en la salida, y listo.
¿El número realmente refleja lo que los humanos consideran complejo?
Razonablemente bien. Frente a las calificaciones humanas en IC9600, ERank presenta una correlación de r = 0,72. No es una coincidencia perfecta; aproximadamente la mitad de la varianza en las calificaciones humanas queda sin explicar, pero es un resultado sólido para una medida completamente automática y sin etiquetas que se compara con el juicio subjetivo humano, el cual es un objetivo inherentemente ruidoso (las personas tampoco coinciden perfectamente entre sí sobre qué es "complejidad").
ERank también se correlaciona con las heurísticas de bajo costo que pretende mejorar: la tasa de bits del códec, la nitidez y la densidad de bordes varían en consonancia con él. Esto es tranquilizador más que sorprendente. Confirma que ERank no está midiendo algo totalmente ortogonal a la noción intuitiva de agitación visual. Es una versión mejor fundamentada de la misma idea, construida a partir de la representación aprendida por un modelo en lugar de estadísticas de píxeles crudos.
La trampa: el ruido también parece complejo
Aquí es donde el artículo hace algo que me gusta: no solo reporta una correlación y pasa a la siguiente sección. Examina cómo se comporta ERank ante el ruido, y la respuesta honesta es que el ruido lo infla. Si se añade ruido de píxeles aleatorios a una imagen, se descorrelacionan los canales casi por construcción, la estática no respeta bordes ni texturas, por lo que una imagen ruidosa puede acumular un ERank alto sin portar más contenido real del que tenía al principio.
Esto importa mucho para cualquier cosa con forma de documento. Los artefactos de escaneo, el grano del papel, los bloques de compresión JPEG y el sangrado de marcas de agua son todos ruido en este sentido. Una página escaneada con textura de papel visible y una marca de agua de fondo tenue puede puntuar como "más rica" que una exportación PDF digital nítida del texto idéntico, aunque nada del contenido real haya cambiado. ERank no separa limpiamente "esta imagen tiene genuinamente más información visual" de "esta imagen es simplemente más ruidosa". Esa ambigüedad resulta ser central para entender por qué la métrica funciona tan bien como filtro de datos para OCR, y también es lo que hay que tener en cuenta antes de confiar ciegamente en el número.
El hallazgo real: la poda por ERank ayuda en algunas tareas y perjudica activamente en otras
Esta es la parte con mordida. Los autores utilizaron ERank como criterio de selección de datos, lo que significa que entrenaron modelos en subconjuntos de un conjunto de datos elegidos mediante el corte de la parte superior o inferior de la distribución de ERank, y midieron qué ocurrió en varias tareas de visión por computadora.
Dos resultados destacan porque apuntan en direcciones opuestas:
-
La super-resolución mejoró cuando se eliminaron las imágenes con bajo ERank. Los modelos de super-resolución aprenden a reconstruir detalles finos a partir de una entrada borrosa o submuestreada. Una imagen que es mayoritariamente plana, como una pared, el cielo o una mesa vacía, le ofrece al modelo casi nada para aprender sobre la reconstrucción de texturas. Entrenar con un montón de esas imágenes desperdicia capacidad en ejemplos casi triviales. Al cortar la parte inferior de la distribución de ERank, lo que queda es más rico, con más textura y más instructivo para un modelo cuyo trabajo principal es alucinar detalles.
-
El OCR mejoró cuando se eliminaron las imágenes con alto ERank. Este es el resultado contraintuitivo. Uno pensaría que más información visual en un documento de entrenamiento ayudaría a un modelo que lee ese documento. Pero para el OCR, la señal útil, los glifos, reside en una parte de la imagen de complejidad comparativamente baja: mayoritariamente un fondo plano con trazos oscuros nítidos. Las imágenes que acumulan las puntuaciones de ERank más altas en un corpus de documentos tienden a ser aquellas donde algo distinto al texto domina el espacio de características: patrones de fondo pesados, fotografías incrustadas, papel marmolado, marcas de agua densas o simplemente ruido de escaneo, exactamente la ambigüedad entre ruido y señal que el artículo señala anteriormente. Entrenar con esas imágenes gasta esfuerzo en los fondos en lugar de en los glifos, y la parte superior de la distribución de ERank es desproporcionadamente donde reside ese desorden.
Y el hallazgo que lo une todo: la poda por ERank no tuvo ningún efecto en la clasificación, la segmentación o la eliminación de ruido. La formulación del resumen para explicar por qué es la síntesis limpia: ERank ayuda exactamente cuando la dificultad de la tarea está gobernada por lo rico o simple que sea la entrada. Que un modelo pueda nombrar el objeto en una foto o dibujar una máscara precisa alrededor de él no depende de cuántos canales de características active la imagen completa. Un perro sobre una alfombra con un patrón ocupado no es más difícil de clasificar que un perro sobre césped liso solo porque la alfombra tiene un ERank más alto. La complejidad como riqueza y la tarea como dificultad son dos ejes diferentes, y para esas tres tareas no se alinean.
Esto se mantuvo tanto en el preentrenamiento como en el ajuste fino, lo que sugiere que no es algún artefacto de un régimen de entrenamiento específico, sino una propiedad de lo que las tareas realmente necesitan de sus datos.
Por qué importa para quien construye o elige OCR
Si estás curando o auditando un corpus de entrenamiento para un modelo de documentos, ERank te ofrece una forma gratuita y automática de marcar el subconjunto de tus datos que es más probable que sea ruido de fondo en lugar de una señal de texto útil, sin necesidad de etiquetar manualmente una sola imagen ni esperar a un panel humano de complejidad. Eso es un filtro real y usable, no una curiosidad de investigación: ejecuta el paso del codificador una vez sobre tu corpus, ordena por ERank y examina detenidamente el segmento superior antes de entrenar con él.
También ofrece una explicación plausible para un patrón que es fácil de notar pero difícil de nombrar con precisión: algunos tipos de documentos son crónicamente más difíciles para los motores OCR, como los contraportadas de libros con mármol, formularios con marcas de agua intensas o recibos con logotipos impresos en el fondo, y es tentador simplemente llamarlos "documentos difíciles" sin tener una forma de cuantificar por qué. ERank te da un número para el "por qué": estas son las páginas donde el fondo compite con el texto por la atención del modelo, y esa competencia es medible antes de que siquiera ejecutes OCR en ellas.
Existe una aplicación adicional que vale la pena observar en lugar de adoptar directamente: una plataforma que enrute documentos a través de múltiples motores OCR podría, en principio, usar ERank como una señal por documento, enviando páginas con alto ERank (más propensas a estar visualmente desordenadas o ruidosas) a un motor más robusto o costoso, y páginas limpias con bajo ERank a uno más barato y rápido. Nadie ha construido ni validado esa canalización aún basándose en este artículo. Es una extensión natural del resultado, no una afirmación que haga el artículo.
Qué sigue sin estar demostrado
La correlación con el juicio humano, r = 0,72, es buena pero no ajustada. Una porción significativa de lo que los humanos consideran "complejo" no se captura al contar las direcciones de características activas, y vale la pena recordar esto antes de tratar a ERank como la verdad absoluta en lugar de un proxy útil.
La métrica también depende de qué codificador congelado se utilice. Una red preentrenada con fotografías naturales aprende un conjunto diferente de canales que una preentrenada con documentos o entrenada con un objetivo completamente distinto, y los propios resultados del artículo estarán vinculados al codificador que utilizaron. Quien reutilice ERank en un dominio diferente debería esperar validarlo de nuevo en lugar de asumir que los mismos umbrales se transfieren.
La sensibilidad al ruido es la que vigilaría más de cerca para OCR específicamente, dado lo mucho que los datos de documentos de producción (escaneos reales, fotos de recibos con el móvil, faxes) llevan ruido de adquisición que no tiene nada que ver con la riqueza del contenido. Si ERank no puede distinguir completamente entre "imagen genuinamente más rica" e "imagen con más ruido", una fracción de lo que se elimine como "clutter" de alto ERank podría ser simplemente grano de escaneo, y una fracción de documentos genuinamente complejos y densos en información podría desecharse junto con ellos. El resultado de OCR del artículo se mantuvo en agregado, que es la evidencia que importa, pero eso no significa que cada documento individual descartado por el filtro mereciera ser eliminado.
Y los resultados de selección de datos provienen de benchmarks de investigación con comparaciones limpias antes/después. Las tuberías de producción son más desordenadas: tipos de documentos mixtos, calidad de adquisición mixta, usos posteriores mixtos para el mismo corpus. Si "cortar el top N% por ERank" es la regla correcta para un conjunto de datos específico probablemente necesite su propia verificación, no una copia ciega de cualquier percentil que funcionó en el artículo. Trate a ERank como un filtro de primer paso fuerte y barato que vale la pena probar en sus propios datos, no como una receta establecida.