为什么训练集中看起来最繁忙的扫描图像可能会损害您的OCR模型
参考论文: ERank in Latent Space as an Image-Complexity and Richness Measure — Maksim Smirnov, Grigory Kononov, Anastasiia Linich, Egor Surkov, Egor Shvetsov
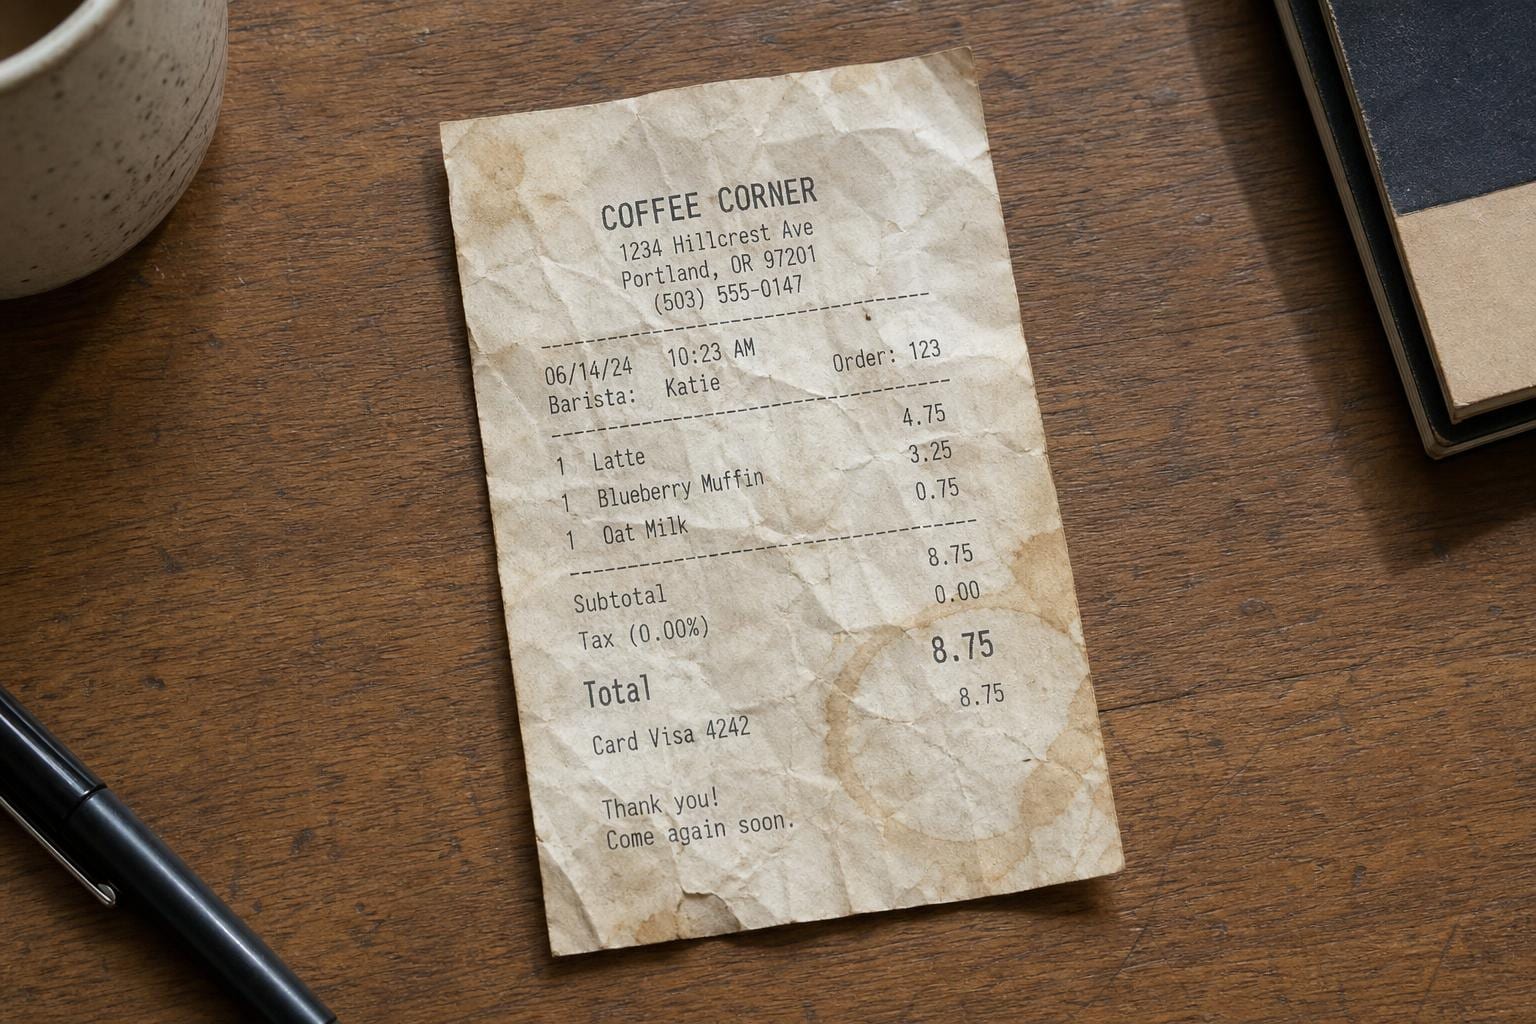
想象一下,两个文档扫描件放在同一个训练文件夹里。一个是干净的发票:白色背景、黑色文字、角落有个标志。另一个是一张在钱包里待了一周的收据,有污渍、有褶皱,印在反光的thermal纸上,反光严重。你的眼睛能看出它们不同。而一篇新论文指出,你也能用一个数字来量化这种差异,这个数字只需通过神经网络的一次前向传播就能算出,无需标签、无需训练。更让任何负责整理OCR数据的人警觉的是:就OCR而言,那些在这个指标上得分最高的文档,往往正是你应该丢弃的。
这篇论文题为《ERank in Latent Space as an Image-Complexity and Richness Measure》,作者是 Maksim Smirnov、Grigory Kononov、Anastasiia Linich、Egor Surkov 和 Egor Shvetsov。它用一些线性代数包装了一个简短而实用的想法,值得理解的原因有两个:一是该指标本身计算成本低且可复用;二是其数据选择结论与“信息越多,训练数据越好”的直觉相悖。
衡量图像中“信息量”比听起来更难
假设你想根据视觉复杂度对一堆图像进行排序,从简单到复杂。你可能会认为这已经是个被解决的问题。事实并非如此,至少没有干净利落的解决方案。
廉价的选项都是其他指标的代理。JPEG文件大小(或编解码器比特率)告诉你图像的可压缩性,这与复杂度相关,但也与分辨率、噪声以及特定编解码器的特性有关。边缘密度,即Sobel或Canny滤波器标记为边缘的像素数量,能捕捉纹理,但会将砾石照片和密集文本照片视为同样“复杂”,如果你真正关心的是内容,这就没有用处。锐度指标(通常是拉普拉斯滤波器的方差)告诉你的是对焦情况,而不是丰富度。它们都不需要训练模型,这是它们的吸引力所在,但它们彼此之间不一致,也不符合人类对相同图像的排名。
昂贵的选项是直接询问人类。IC9600是一个为此目的构建的公共数据集:9,600张带有标注复杂度评分的图像。它是一个很好的基准,但你不能对数百万样本的训练集中的每张图像都进行人工评估,而且你也不应该需要这样做。
缺少的是介于两者之间的东西:像像素级启发式方法那样便宜,但又由训练模型实际“看到”的内容所驱动,就像人类评分者隐式所做的那样。这就是ERank试图填补的空白。
计算图像实际使用的方向数量
以下是剥离了数学公式后的机制说明。将一张图像输入到一个已冻结且训练好的图像编码器中(这类编码器通常用于分类或生成嵌入表示),并在其中一个内部特征图处停止计算。该特征图中的每个通道都对应网络检测到的某种学习到的模式:特定角度的边缘、颜色对比度、纹理类型,或者是网络在自身训练过程中捕捉到的其他特征。在图像的每个空间位置上,这些通道都会以某种激活值被触发。
现在提出一个简单的问题:在整个图像范围内,这些通道彼此之间的独立性如何?如果输入网络的是一面空白墙壁,大多数通道会同步变化,因为缺乏局部细节来区分它们——主要是平坦的颜色,没有边缘,也没有纹理。少数几个通道就能解释几乎所有的变化。如果输入的是农贸市场或杂乱的桌面,不同区域会激活截然不同的通道组合:某个区域是边缘,另一个区域是颜色渐变,其他地方则是精细纹理,因此有更多的通道在彼此独立地运作。
你可以利用通道协方差矩阵的有效秩(effective rank)来形式化“有多少通道在独立运作”这一概念。计算图像中通道间的协方差,获取其特征值,将其归一化为概率分布,然后计算该分布的熵。对熵进行指数运算,即可得到一个名为 ERank 的数值,它表现得像秩,但不必是整数。一张乏味的图像可能在数百个可能的通道中仅获得十几的 ERank 分数。而一张内容丰富、杂乱的图像可能使用数十倍于此的通道。这是对图像实际调节的独立“旋钮”数量的软计数,它不是标签判断,也不是文件大小,而是图像在网络自身学习到的特征空间中呈现的一种属性。
这是该论文的精妙之处:它无需训练、无需标签,也无需针对特定任务进行设置。只需运行一次编码器,对输出进行一些线性代数运算,即可完成。
该数值是否真的能追踪人类所定义的“复杂”?
表现相当不错。在与 IC9600 中的人类评分对比时,ERank 的相关系数为 r = 0.72。这并非完美匹配,人类评分中约有一半的方差无法被解释,但对于一个完全自动、无需标签的度量指标而言,在与主观人类判断(这本身就是一个真正嘈杂的目标,因为人们在“复杂性”上也无法完全达成一致)进行对比时,这是一个相当扎实的结果。
ERank 也能追踪它旨在改进的那些廉价启发式方法:编解码器比特率、清晰度和边缘密度都与其同步变化。这令人安心,而非令人惊讶。它证实了 ERank 测量的内容并非与视觉繁忙度的直观概念完全正交。它是同一理念的更坚实基础版本,基于模型学习到的表示构建,而非原始像素统计。
陷阱:噪声看起来也很复杂
这篇论文中有一个我很喜欢的地方:它没有仅仅报告相关性就草草了事,而是深入考察了 ERank 在噪声下的表现。坦率地说,噪声会推高 ERank 的数值。如果你向图像添加随机像素噪声,几乎从构造上就破坏了通道间的相关性,因为静态噪声并不遵循边缘或纹理的规律。因此,一张带有噪声的图像可能会获得很高的 ERank 分数,尽管它并没有比原始图像包含更多的真实内容。
这对任何文档类图像都至关重要。扫描伪影、纸张颗粒感、JPEG 压缩块以及水印渗透,在这个意义上都属于噪声。一张带有明显纸张纹理和微弱背景水印的扫描页面,其“丰富度”评分可能高于同一文本的清晰数字 PDF 导出版本,尽管实际内容没有任何变化。ERank 无法清晰地区分“这张图像确实包含更多视觉信息”和“这张图像只是噪声更多”。这种模糊性恰恰是该指标作为 OCR 数据过滤器如此有效的核心原因,但这也意味着在盲目信任该数值之前,必须牢记这一点。
真正的发现:基于 ERank 的剪枝对某些任务有帮助,而对另一些任务则毫无益处甚至产生负面影响
这是本文最核心的部分。作者将 ERank 用作数据选择标准,这意味着他们根据 ERank 分布的顶部或底部截断来选取数据集的子集进行模型训练,并测量了多个视觉任务的表现变化。
两个结果尤为突出,因为它们指向了相反的方向:
-
去除低 ERank 图像后,超分辨率任务表现提升。 超分辨率模型学习从模糊或降采样的输入中重建精细细节。一张大部分平坦的图像(如墙壁、天空、空桌面)几乎无法为模型提供关于纹理重建的学习信号。在大量此类图像上训练会浪费模型容量去处理近乎 trivial 的样本。剔除 ERank 分布的底部后,剩余的图像更丰富、纹理更多,对于以“幻觉”细节为核心任务的模型来说更具指导意义。
-
去除高 ERank 图像后,OCR 任务表现提升。 这是反直觉的一点。人们通常认为训练文档中包含更多视觉信息有助于模型读取该文档。但对于 OCR 而言,有用的信号(即字形)存在于图像中相对低复杂度的部分:主要是平坦的背景和清晰的深色笔画。在文档语料库中 ERank 得分最高的图像,往往是那些非文本元素主导特征空间的图像:复杂的背景图案、嵌入的照片、大理石纹纸张、密集的水印,或者仅仅是扫描噪声——这正是论文前文指出的噪声与信号模糊性问题。在这些图像上训练会将精力耗费在背景而非字形上,而 ERank 分布的顶部恰好集中了这些杂乱信息。
将这一切联系起来的发现是:基于 ERank 的剪枝对分类、分割或去噪任务没有任何影响。摘要中对此原因的解释非常简洁明了:只有当任务难度由输入的丰富或平淡程度决定时,ERank 才会发挥作用。模型能否识别照片中的物体,或为其绘制准确的掩码,并不取决于整张图像激活了多少特征通道。狗站在花纹繁复的地毯上并不比站在平坦草地上的狗更难分类,仅仅因为地毯的 ERank 得分更高。“复杂度即丰富度”与“任务即难度”是两个不同的维度,而对于上述三个任务,它们并不重合。
这一现象在预训练和微调阶段均成立,这表明它并非某种特定训练机制的伪影,而是任务本身对数据需求的固有属性。
为什么这对构建或选择 OCR 的人很重要
如果你正在为文档模型策划或审核训练语料库,ERank 提供了一种免费且自动化的方法,用于标记那些更可能是背景杂讯而非有用文本信号的数据子集,无需手动标注任何图像,也无需等待人工复杂度评估小组的反馈。这是一个真正可用的过滤器,而非仅仅是研究上的奇思妙想:只需在语料库上运行一次编码器,按 ERank 排序,然后在训练之前仔细审视排名靠前的部分。
它还提供了一个合理的解释,用于说明一种容易察觉但难以精确命名的模式:某些文档类型对 OCR 引擎来说长期更具挑战性,例如大理石纹路的书籍衬页、带有重度水印的表格、印有背景标志的收据,人们往往倾向于将这些统称为“难文档”,却无法量化其原因。ERank 为“为什么难”提供了一个数值:这些页面中的背景正在与文本争夺模型的注意力,而这种竞争在运行 OCR 之前就是可测量的。鉴于中文等汉字符号系统具有字形复杂、版面密集的特性,若该研究仅针对拉丁字母文本,其在处理高密度汉字排版时的适用性仍需额外验证。
还有一个值得观察而非立即采用的应用:一个在多个 OCR 引擎之间路由文档的平台,原则上可以使用 ERank 作为每份文档的信号,将高 ERank 页面(更可能在视觉上杂乱或充满噪声)发送到更强大或更昂贵的引擎,而将干净的低 ERank 页面发送到更便宜、更快的引擎。目前还没有人基于这篇论文构建或验证过这样的管道。这是该结果的自然延伸,而非论文本身的主张。
尚未得到证实的方面
与人类判断的相关系数 r = 0.72 表现尚可,但并非紧密相关。人类认定为“复杂”的内容中,有相当一部分无法通过统计活跃特征方向来捕捉。因此,在将 ERank 视为绝对标准而非一种有用的代理指标之前,这一点值得牢记。
该指标还取决于所使用的冻结编码器。在自然图像上预训练的神经网络,与在文档上预训练或采用完全不同目标训练的模型,所学到的通道集合是不同的。因此,论文中的结果必然与其使用的特定编码器绑定。任何在不同领域复用 ERank 的人,都应预期需要重新验证,而不能假设相同的阈值可以直接迁移。
就 OCR 而言,我最关注的是其对噪声的敏感性。考虑到生产环境中的文档数据(真实扫描件、手机拍摄的收据、传真件等)往往携带大量与内容丰富度无关的采集噪声。如果 ERank 无法完全区分“真正信息丰富的图像”与“噪声更多的图像”,那么被作为高 ERank “杂乱内容”剔除的部分可能仅仅是扫描颗粒噪声,而一些真正复杂、信息密集的文档也可能随之被误删。尽管该论文在 OCR 任务上的整体结果表现稳健——这是最重要的证据——但这并不意味着被过滤器剔除的每一份文档都理应被丢弃。
此外,数据选择的结果来自具有清晰前后对比的研究基准测试。而生产流水线则更为混乱:文档类型混杂、采集质量不一、同一语料库的下游用途多样。对于特定数据集而言,“按 ERank 剔除前 N%” 是否是正确的规则,可能需要单独验证,而非盲目照搬论文中有效的百分位阈值。应将 ERank 视为一种强大且低成本的初筛过滤器,值得在您自己的数据上进行测试,而非将其视为一种固定不变的配方。