Por que as digitalizações que parecem mais ocupadas no seu conjunto de treinamento podem estar prejudicando seu modelo de OCR
Baseado em: ERank in Latent Space as an Image-Complexity and Richness Measure — Maksim Smirnov, Grigory Kononov, Anastasiia Linich, Egor Surkov, Egor Shvetsov
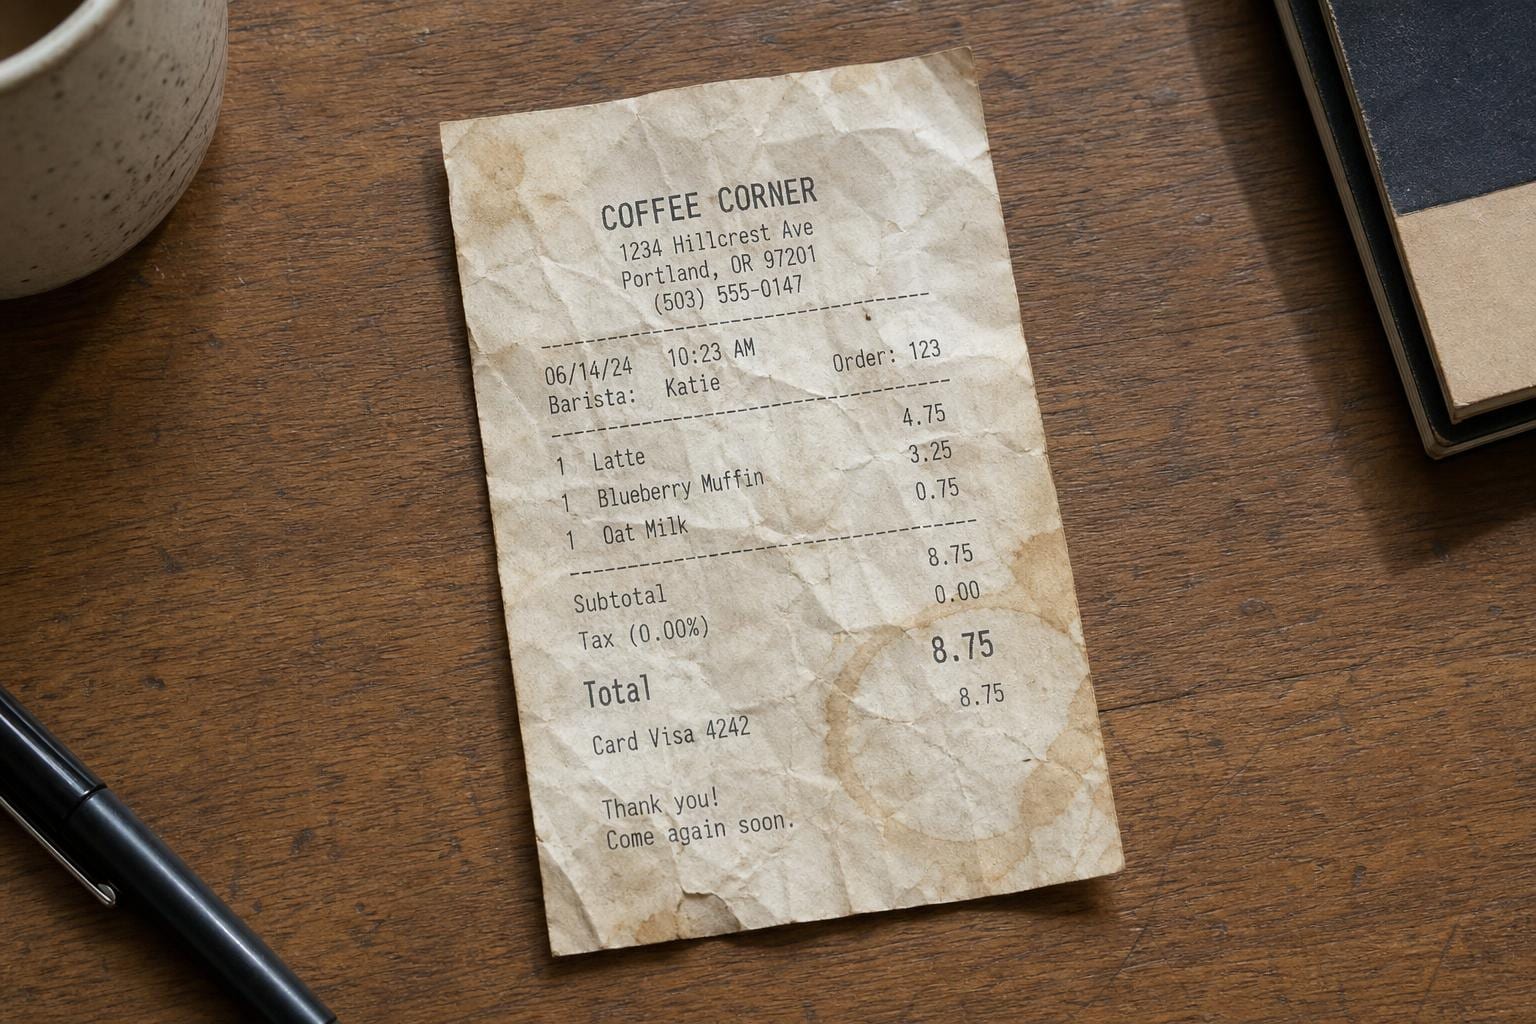
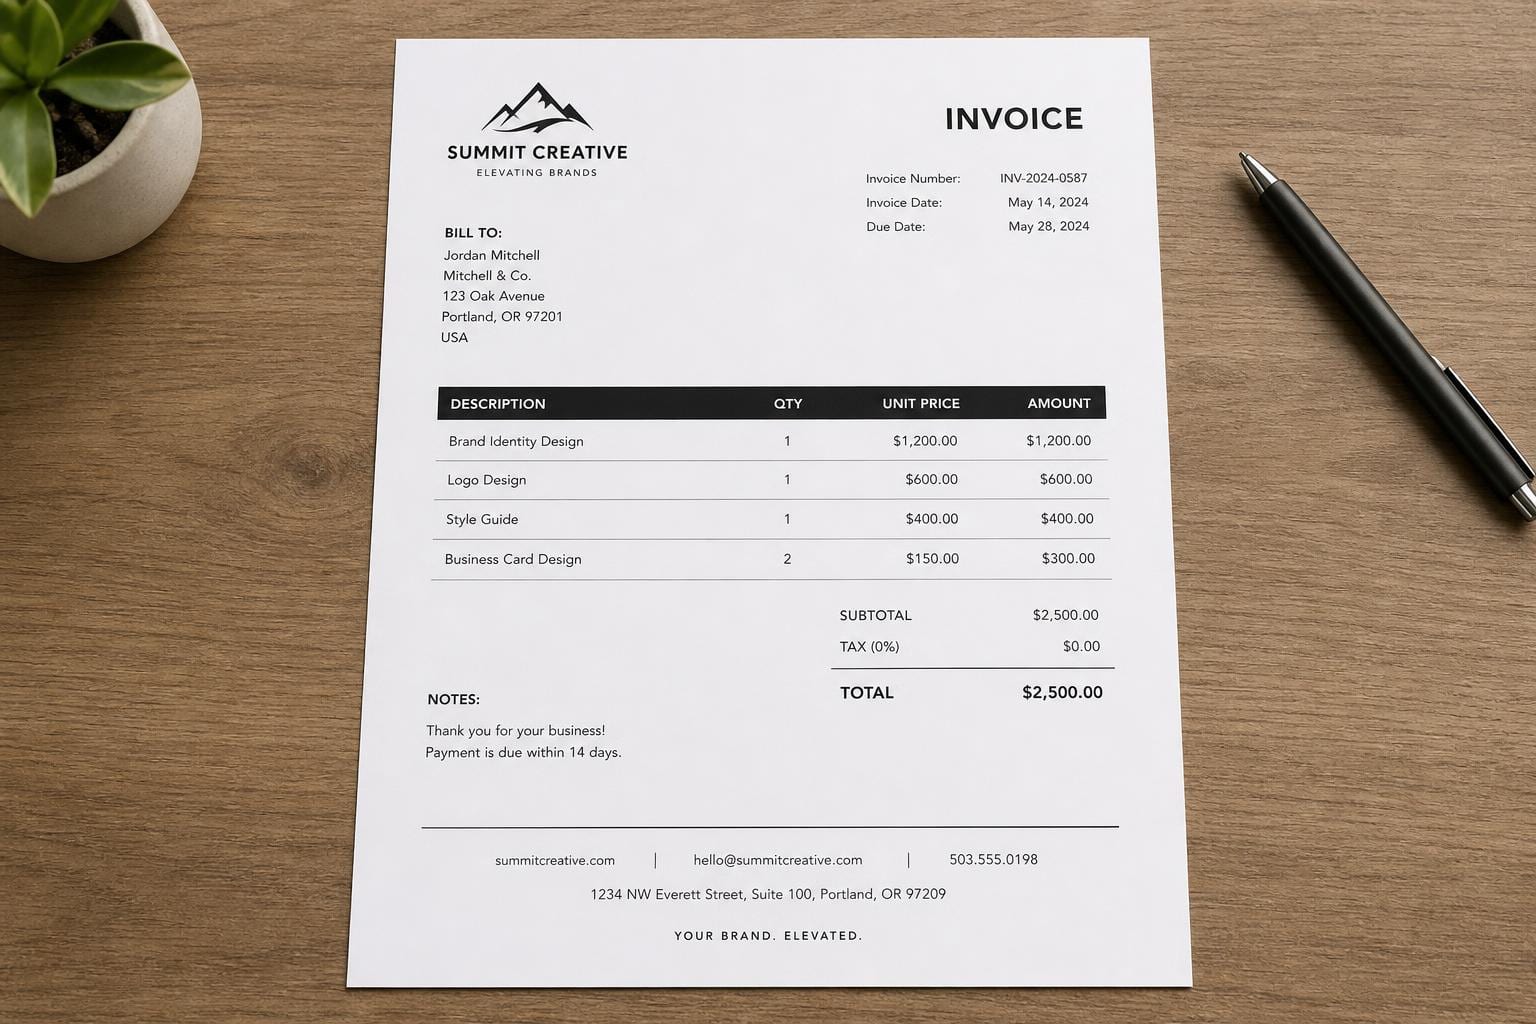
Imagine dois documentos digitalizados na mesma pasta de treinamento. Um é uma fatura limpa: fundo branco, texto preto, um logotipo no canto. O outro é um recibo que passou uma semana na carteira, manchado, amassado, impresso em papel térmico brilhante que reflete a luz. Seu olho consegue perceber que são diferentes. O que um novo artigo argumenta é que você também pode obter um número para essa diferença, calculado em uma única passagem por uma rede neural, sem rótulos e sem treinamento envolvido. E aqui está a parte que deve fazer qualquer pessoa que curadoria de dados de OCR prestar atenção: especificamente para OCR, os documentos que obtêm as pontuações mais altas nesse número são frequentemente os que você deve descartar.
O artigo é chamado "ERank in Latent Space as an Image-Complexity and Richness Measure", de Maksim Smirnov, Grigory Kononov, Anastasiia Linich, Egor Surkov e Egor Shvetsov. É uma ideia curta e útil disfarçada em álgebra linear, e vale a pena entender tanto porque a métrica em si é barata e reutilizável, quanto porque o resultado da seleção de dados vai contra o instinto de que "mais informação é sempre melhores dados de treinamento".
Medir "o quanto está acontecendo" em uma imagem é mais difícil do que parece
Digamos que você queira classificar uma pilha de imagens por complexidade visual, das mais simples às mais agitadas. Você pensaria que isso já estaria resolvido. Não está, não de forma limpa.
As opções baratas são todas proxies para algo diferente. O tamanho do arquivo JPEG (ou a taxa de bits do codec) indica o quão compressível uma imagem é, o que se correlaciona com a complexidade, mas também com a resolução, o ruído e as particularidades de um codec específico. A densidade de bordas, ou seja, quantos pixels um filtro Sobel ou Canny marca como borda, capta texturas, mas trata uma foto de cascalho e uma foto de texto denso como igualmente "complexas", o que não é útil se o que realmente importa é o conteúdo. Métricas de nitidez (geralmente a variância de um filtro Laplaciano) indicam o foco, não a riqueza. Nenhuma delas requer um modelo treinado, o que é seu apelo, e nenhuma delas concorda entre si ou com a forma como uma pessoa classificaria as mesmas imagens.
A opção cara é simplesmente perguntar às pessoas. O IC9600 é um conjunto de dados público construído exatamente para isso: 9.600 imagens com pontuações de complexidade anotadas por humanos. É uma boa verdade fundamental (ground truth), mas você não pode passar um painel humano por cada imagem em um conjunto de treinamento com milhões de amostras, e não deveria precisar disso.
O que falta é algo intermediário: barato como as heurísticas em nível de pixel, mas informado pelo que um modelo treinado realmente "vê" na imagem, da mesma forma implícita que os avaliadores humanos fazem. É essa lacuna que o ERank tenta preencher.
Contando quantas direções uma imagem realmente usa
Aqui está o mecanismo, sem a matemática. Passe uma imagem por um codificador de imagem congelado e já treinado, do tipo usado para classificação ou embeddings, e pare no meio do caminho, em um dos mapas de características internos. Esse mapa de características tem um canal para cada padrão aprendido que a rede detecta: bordas em certos ângulos, contrastes de cor, tipos de textura, o que a rede captou durante seu próprio treinamento. Em cada localização espacial da imagem, cada um desses canais é ativado com algum valor de ativação.
Agora faça uma pergunta simples: em toda a imagem, o quão independentes são esses canais uns dos outros? Se uma parede lisa está passando pela rede, a maioria dos canais vai se mover juntos, porque não há nada local para diferenciá-los, cor predominantemente plana, sem bordas, sem textura. Um punhado de canais explica quase toda a variação. Se um mercado de agricultores ou uma mesa bagunçada está passando pela rede, diferentes regiões ativam combinações radicalmente diferentes de canais, bordas em um patch, gradientes de cor em outro, textura fina em outro lugar, então muitos mais canais estão se comportando independentemente uns dos outros.
Você pode formalizar "quantos canais estão se comportando independentemente" com o posto efetivo da matriz de covariância dos canais. Pegue a covariância entre os canais em toda a imagem, obtenha seus autovalores, normalize-os em uma distribuição de probabilidade e calcule a entropia dessa distribuição. Exponencie a entropia e você obtém um número, ERank, que se comporta como um posto, mas não precisa ser um número inteiro. Uma imagem chata pode ter um ERank de uma dúzia ou mais, entre centenas de canais possíveis. Uma rica e bagunçada pode usar muitas vezes mais do que isso. É uma contagem suave de quantos "botões" independentes a imagem está realmente girando, não um julgamento rotulado, não um tamanho de arquivo, apenas uma propriedade de como a imagem se situa no próprio espaço de características aprendido pela rede.
Esta é a parte inteligente do artigo: não precisa de treinamento, não precisa de rótulos e não precisa de configuração específica para a tarefa. Execute o codificador uma vez, faça um pouco de álgebra linear na saída, pronto.
O número realmente acompanha o que os humanos chamam de complexo?
Razoavelmente bem. Em relação às avaliações humanas no IC9600, o ERank apresenta uma correlação de r = 0,72. Isso não é uma correspondência perfeita — aproximadamente metade da variância nas avaliações humanas não é explicada —, mas é um resultado sólido para uma medida totalmente automática e sem rótulos, sendo comparada com o julgamento humano subjetivo, que é, por si só, um alvo genuinamente ruidoso (as pessoas também não concordam perfeitamente entre si sobre "complexidade").
O ERank também acompanha os heurísticos de baixo custo que visa melhorar: taxa de bits do codec, nitidez e densidade de bordas variam em conjunto com ele. Isso é tranquilizador, embora não surpreendente. Confirma que o ERank não está medindo algo totalmente ortogonal à noção intuitiva de agitação visual. É uma versão melhor fundamentada da mesma ideia, construída a partir da representação aprendida por um modelo, em vez de estatísticas brutas de pixels.
A pegadinha: o ruído também parece complexo
É aqui que o artigo faz algo que eu gosto: ele não apenas relata uma correlação e segue em frente. Ele examina como o ERank se comporta sob ruído, e a resposta honesta é que o ruído o infla. Se você adicionar ruído de pixels aleatórios a uma imagem, você descorrelaciona os canais quase por construção, o estático não respeita bordas ou texturas, então uma imagem ruidosa pode acumular um ERank alto sem carregar mais conteúdo real do que tinha originalmente.
Isso é muito importante para qualquer coisa com formato de documento. Artefatos de digitalização, grão do papel, blocos de compressão JPEG e vazamento de marca d'água são todos ruído neste sentido. Uma página digitalizada com textura de papel visível e uma marca d'água de fundo fraca pode pontuar como "mais rica" do que uma exportação PDF digital nítida do texto idêntico, mesmo que nada sobre o conteúdo real tenha mudado. O ERank não separa limpidamente "esta imagem tem genuinamente mais informação visual" de "esta imagem é apenas mais ruidosa". Essa ambiguidade acaba sendo central para o motivo pelo qual a métrica funciona tão bem como um filtro de dados de OCR, e também é o aspecto a se ter em mente antes de confiar cegamente no número.
A descoberta real: a poda por ERank ajuda algumas tarefas e ativamente não ajuda outras
Esta é a parte com dentes. Os autores usaram o ERank como critério de seleção de dados, o que significa que treinaram modelos em subconjuntos de um conjunto de dados escolhidos ao cortar o topo ou a base da distribuição do ERank, e mediram o que aconteceu em várias tarefas de visão computacional.
Dois resultados se destacam porque apontam em direções opostas:
-
A super-resolução melhorou quando as imagens de baixo ERank foram removidas. Modelos de super-resolução aprendem a reconstruir detalhes finos a partir de uma entrada borrada ou com amostragem reduzida. Uma imagem que é predominantemente plana, como uma parede, o céu ou uma mesa vazia, oferece quase nada ao modelo para aprender sobre a reconstrução de texturas. Treinar com um monte dessas imagens desperdiça capacidade em exemplos quase triviais. Ao cortar a base da distribuição do ERank, o que sobra é mais rico, mais texturizado e mais instrutivo para um modelo cujo trabalho inteiro é alucinar detalhes.
-
O OCR melhorou quando as imagens de alto ERank foram removidas. Este é o resultado contra-intuitivo. Você pensaria que mais informações visuais em um documento de treinamento ajudariam um modelo que lê esse documento. Mas, para o OCR, o sinal útil, os glifos, reside em uma parte de complexidade comparativamente baixa da imagem: fundo predominantemente plano e traços escuros nítidos. As imagens que acumulam as pontuações mais altas de ERank em um corpus de documentos tendem a ser aquelas em que algo além do texto está dominando o espaço de características: padrões de fundo pesados, fotografias incorporadas, papel marmorizado, marca d'água densa ou apenas ruído de digitalização, exatamente a ambiguidade entre ruído e sinal que o artigo destaca anteriormente. Treinar com essas imagens gasta esforço nos fundos em vez dos glifos, e a fatia superior da distribuição do ERank é desproporcionalmente onde esse ruído vive.
E a descoberta que une tudo: a poda por ERank não fez nada por classificação, segmentação ou redução de ruído. A estruturação do resumo para o porquê é o resumo limpo: o ERank ajuda exatamente quando a dificuldade da tarefa é governada pelo quão rico ou simples é a entrada. Se um modelo pode nomear o objeto em uma foto ou desenhar uma máscara precisa ao redor dele, não depende de quantos canais de características a imagem inteira ativa. Um cachorro em um tapete com padrão ocupado não é mais difícil de classificar do que um cachorro na grama simples apenas porque o tapete tem um ERank mais alto. Complexidade-como-riqueza e tarefa-como-difícil são dois eixos diferentes, e para essas três tarefas eles não se alinham.
Isso se manteve tanto no pré-treinamento quanto no ajuste fino, o que sugere que não é algum artefato de um regime de treinamento, mas sim uma propriedade do que as tarefas realmente precisam de seus dados.
Por que isso importa para quem está construindo ou escolhendo OCR
Se você está curando ou auditando um corpus de treinamento para um modelo de documentos, o ERank oferece uma maneira gratuita e automática de sinalizar o subconjunto de seus dados que tem mais probabilidade de ser ruído de fundo do que um sinal de texto útil, sem precisar rotular manualmente uma única imagem ou esperar por um painel humano de complexidade. Isso é um filtro real e utilizável, não apenas uma curiosidade de pesquisa: execute a passagem do codificador uma vez sobre seu corpus, classifique por ERank e examine atentamente a fatia superior antes de treiná-lo.
Ele também oferece uma explicação plausível para um padrão que é fácil de notar, mas difícil de nomear com precisão: alguns tipos de documentos são cronicamente mais difíceis para os motores de OCR, como as páginas de guarda de livros marmoreados, formulários com marca d'água intensa e recibos com logotipos de fundo impressos, e é tentador simplesmente chamar esses de "documentos difíceis" sem uma maneira de quantificar o porquê. O ERank fornece um número para o "porquê": estas são as páginas em que o fundo está competindo com o texto pela atenção do modelo, e essa competição é mensurável antes mesmo de você executar o OCR neles.
Há uma aplicação adicional que vale a pena observar, em vez de adotar imediatamente: uma plataforma que roteia documentos entre vários motores de OCR poderia, em princípio, usar o ERank como um sinal por documento, enviando páginas com alto ERank (mais propensas a serem visualmente poluídas ou ruidosas) para um motor mais robusto ou caro, e páginas limpas com baixo ERank para um motor mais barato e rápido. Ninguém construiu ou validou esse pipeline ainda com base neste artigo. É uma extensão natural do resultado, não uma afirmação feita pelo artigo.
O que ainda não está comprovado
A correlação com o julgamento humano, r = 0,72, é boa, mas não é forte. Uma parcela significativa do que os humanos classificam como "complexo" não é capturada pela contagem de direções de características ativas, e vale a pena lembrar disso antes de tratar o ERank como verdade absoluta, em vez de um proxy útil.
A métrica também depende de qual codificador congelado você utiliza. Uma rede pré-treinada em fotos naturais aprende um conjunto diferente de canais do que uma pré-treinada em documentos ou treinada com um objetivo completamente diferente, e os próprios resultados do artigo estarão vinculados ao codificador que eles usaram. Qualquer pessoa que reutilize o ERank em um domínio diferente deve esperar revalidá-lo, em vez de assumir que os mesmos limiares se transferem.
A sensibilidade ao ruído é o aspecto que eu observaria de mais perto especificamente para OCR, dado o quanto os dados de documentos de produção (digitalizações reais, fotos de recibos tiradas com celular, faxes) carregam ruído de aquisição que não tem nada a ver com a riqueza do conteúdo. Se o ERank não conseguir distinguir totalmente uma "imagem genuinamente mais rica" de uma "imagem mais ruidosa", uma fração do que é descartada como "clutter" de alto ERank pode ser apenas granulação da digitalização, e uma fração de documentos genuinamente complexos e densos em informação pode ser descartada junto. O resultado do OCR do artigo se manteve em agregado, que é a evidência que importa, mas isso não significa que cada documento individual descartado pelo filtro merecesse ser removido.
E os resultados de seleção de dados vêm de benchmarks de pesquisa com comparações limpas de antes/depois. Pipelines de produção são mais caóticos: tipos de documentos misturados, qualidade de aquisição misturada, usos downstream misturados para o mesmo corpus. Se "cortar os top N% por ERank" é a regra certa para um conjunto de dados específico provavelmente precisa de sua própria verificação, não uma cópia cega de qual percentil funcionou no artigo. Trate o ERank como um filtro de primeira passagem forte e barato que vale a pena testar em seus próprios dados, não como uma receita estabelecida.