आपके ट्रेनिंग सेट में सबसे व्यस्त दिखने वाले स्कैन आपके OCR मॉडल को नुकसान क्यों पहुंचा सकते हैं
आधारित शोध-पत्र: ERank in Latent Space as an Image-Complexity and Richness Measure — Maksim Smirnov, Grigory Kononov, Anastasiia Linich, Egor Surkov, Egor Shvetsov
ERank in Latent Space as an Image-Complexity and Richness Measure
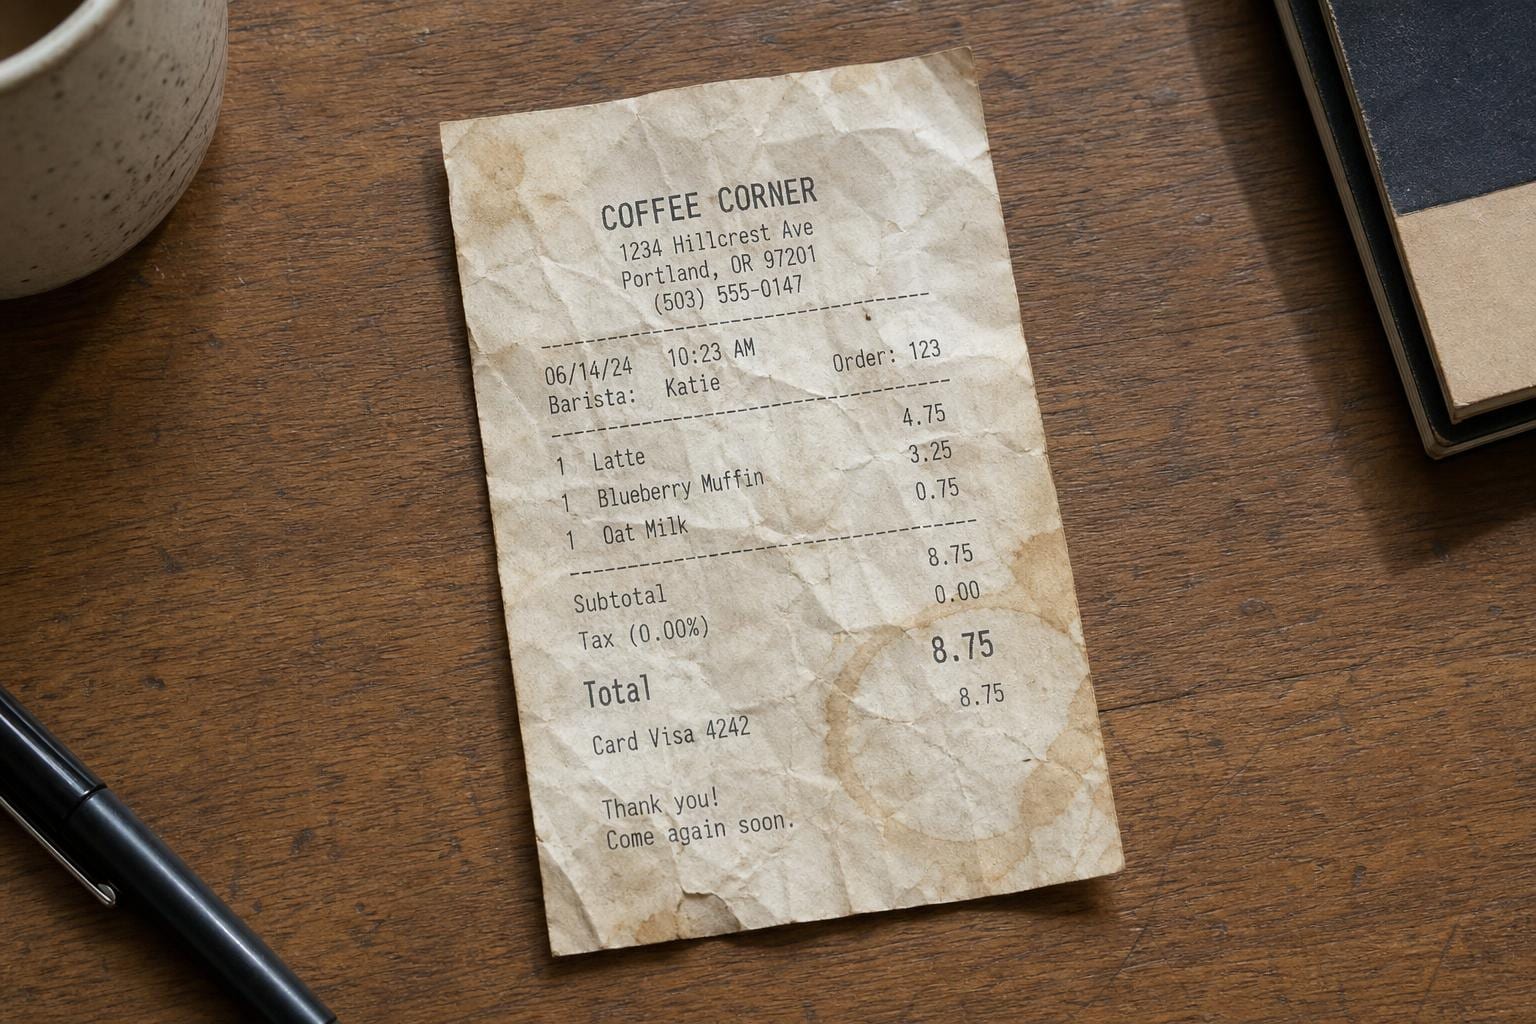
कल्पना कीजिए कि एक ही ट्रेनिंग फोल्डर में दो दस्तावेज़ स्कैन पड़े हैं। एक साफ़ इनवॉइस है: सफ़ेद बैकग्राउंड, काला टेक्स्ट, और कोने में एक लोगो। दूसरा एक रसीद है जो एक हफ़्ते तक वॉलेट में रही है, जिस पर दाग़ हैं, झुर्रियाँ हैं, और यह चमकदार थर्मल पेपर पर छपी है जो रोशनी को पकड़ लेती है। आपकी आँखें बता सकती हैं कि वे अलग हैं। एक नई पेपर का तर्क है कि आप उस अंतर के लिए एक संख्या भी प्राप्त कर सकते हैं, जो न्यूरल नेटवर्क के एकल पास से गणना की जाती है, बिना किसी लेबल या ट्रेनिंग के। और यही वह हिस्सा है जो OCR डेटा को व्यवस्थित करने वाले किसी भी व्यक्ति को चौंका देगा: विशेष रूप से OCR के लिए, जिन दस्तावेज़ों को इस संख्या में सबसे उच्च स्कोर मिलता है, अक्सर वही वे हैं जिन्हें आपको फेंक देना चाहिए।
इस पेपर का शीर्षक "ERank in Latent Space as an Image-Complexity and Richness Measure" है, जिसके लेखक Maksim Smirnov, Grigory Kononov, Anastasiia Linich, Egor Surkov, और Egor Shvetsov हैं। यह एक छोटा, उपयोगी विचार है जिसे कुछ रैखिक बीजगणित (linear algebra) में ढाला गया है, और इसे समझना इसलिए भी महत्वपूर्ण है क्योंकि मेट्रिक स्वयं सस्ता और पुनः उपयोग योग्य है, और क्योंकि डेटा-चयन का परिणाम उस सहज भावना के विपरीत है कि "अधिक जानकारी हमेशा बेहतर ट्रेनिंग डेटा होती है।"
छवि में "कितना हो रहा है" को मापना सुनने में जितना आसान लगता है, उतना नहीं है
मान लीजिए आप दृश्य जटिलता (visual complexity) के आधार पर छवियों के एक ढेर को सादे से व्यस्त तक रैंक करना चाहते हैं। आप सोचेंगे कि यह समस्या पहले से ही हल हो चुकी है। ऐसा नहीं है, कम से कम स्पष्ट रूप से नहीं।
सस्ते विकल्प सब कुछ किसी अन्य चीज़ के लिए प्रॉक्सी (proxy) हैं। JPEG फ़ाइल का आकार (या कोडेक बिटरेट) आपको बताता है कि छवि कितनी संपीड़न योग्य है, जो जटिलता से सहसंबंधित है लेकिन रिज़ॉल्यूशन, शोर (noise) और किसी विशिष्ट कोडेक की इच्छाओं से भी जुड़ा होता है। एज डेंसिटी (edge density), यानी सोबेल या कैनी फ़िल्टर द्वारा कितने पिक्सल्स को एज के रूप में चिह्नित किया गया है, वह टेक्सचर को तो पकड़ लेता है लेकिन यह गलियों की एक तस्वीर और घने पाठ की तस्वीर को समान रूप से "जटिल" मानता है, जो तब उपयोगी नहीं होता जब आपको वास्तव में सामग्री की परवाह हो। तीक्ष्णता मापदंड (आमतौर पर लाप्लासियन फ़िल्टर का प्रसरण) आपको फोकस के बारे में बताते हैं, समृद्धि के बारे में नहीं। इनमें से किसी को भी प्रशिक्षित मॉडल की आवश्यकता नहीं होती, जो उनकी अपील है, और न ही वे एक-दूसरे या किसी व्यक्ति द्वारा उसी छवियों को रैंक करने के तरीके से सहमत होते हैं।
महंगा विकल्प सीधे लोगों से पूछना है। IC9600 एक सार्वजनिक डेटासेट है जो बिल्कुल इसके लिए बनाया गया है: 9,600 छवियाँ जिनमें मानव द्वारा टिप्पणीकृत जटिलता स्कोर हैं। यह एक अच्छा ग्राउंड ट्रुथ है, लेकिन आप लाखों-करोड़ों नमूनों वाले प्रशिक्षण सेट में हर छवि के लिए मानव पैनल को नहीं चला सकते, और आपको ऐसा करने की आवश्यकता भी नहीं होनी चाहिए।
जो कमी है वह बीच का कुछ है: पिक्सल-स्तर के हीयुरिस्टिक्स की तरह सस्ता, लेकिन प्रशिक्षित मॉडल द्वारा छवि में जो वास्तव में "देखा" जाता है, उससे सूचित, ठीक वैसे ही जैसे मानव रेटर्स अंतर्निहित रूप से करते हैं। यही अंतर ERank भरने की कोशिश करता है।
एक छवि वास्तव में कितने दिशाओं का उपयोग करती है, इसकी गिनती
यहाँ गणित को छोड़कर तंत्र दिया गया है। एक जमे हुए, पहले से प्रशिक्षित इमेज एन्कोडर (जो वर्गीकरण या एम्बेडिंग के लिए उपयोग किया जाता है) के माध्यम से एक छवि को चलाएं, और आंतरिक फीचर मैप (internal feature map) में से एक पर रुक जाएं। उस फीचर मैप में नेटवर्क द्वारा पहचाने गए हर सीखे गए पैटर्न के लिए एक चैनल होता है: निश्चित कोणों पर किनारे (edges), रंग विरोधाभास (color contrasts), बनावट के प्रकार (texture types), या जो भी नेटवर्क ने अपने प्रशिक्षण के दौरान उठाया हो। छवि के हर स्थानिक स्थान (spatial location) पर, इन चैनलों में से प्रत्येक किसी सक्रियण मान (activation value) के साथ सक्रिय होता है।
अब एक सरल प्रश्न पूछें: पूरी छवि में, ये चैनल एक-दूसरे से कितने स्वतंत्र हैं? यदि एक खाली दीवार नेटवर्क से गुजर रही है, तो अधिकांश चैनल एक साथ हिलेंगे, क्योंकि उन्हें अलग करने के लिए कोई स्थानीय विशेषता नहीं है—मुख्यतः समतल रंग, कोई किनारे नहीं, कोई बनावट नहीं। कुछ ही चैनल लगभग सभी परिवर्तन को समझाते हैं। यदि एक किसानों का बाज़ार या एक भीड़भाड़ भरा डेस्क नेटवर्क से गुजर रहा है, तो विभिन्न क्षेत्र चैनलों के बहुत अलग-अलग संयोजनों को सक्रिय करते हैं—एक पैच में किनारे, दूसरे में रंग प्रवणता (color gradients), और कहीं और महीन बनावट, इसलिए बहुत अधिक चैनल एक-दूसरे से स्वतंत्र रूप से व्यवहार कर रहे होते हैं।
"कितने चैनल स्वतंत्र रूप से व्यवहार कर रहे हैं" को चैनल सहप्रसरण मैट्रिक्स (channel covariance matrix) के प्रभावी रैंक (effective rank) के साथ औपचारिक रूप दिया जा सकता है। छवि में चैनलों के बीच सहप्रसरण लें, इसके आइगनमान (eigenvalues) प्राप्त करें, उन्हें एक प्रायिकता वितरण में सामान्यीकृत करें, और उस वितरण की एंट्रॉपी (entropy) की गणना करें। एंट्रॉपी का घातांक (exponentiate) लें और आपको एक संख्या, ERank, मिलती है जो एक रैंक की तरह व्यवहार करती है लेकिन इसे एक पूर्ण संख्या होने की आवश्यकता नहीं होती। एक उबाऊ छवि के ERank की स्कोर सैकड़ों संभावित चैनलों में से लगभग एक दर्जन हो सकती है। एक समृद्ध, भीड़भाड़ भरी छवि उससे कई गुना अधिक का उपयोग कर सकती है। यह एक नरम गिनती (soft count) है कि छवि वास्तव में कितने स्वतंत्र "नॉब्स" को घुमा रही है—यह कोई लेबलित निर्णय नहीं है, कोई फ़ाइल आकार नहीं, बल्कि यह एक गुण है कि छवि नेटवर्क के अपने सीखे हुए फीचर स्पेस में कैसे स्थित है।
यह पेपर की चतुराई है: इसमें किसी प्रशिक्षण, लेबल, या कार्य-विशिष्ट सेटअप की आवश्यकता नहीं होती। एन्कोडर को एक बार चलाएं, आउटपुट पर थोड़ा रैखिक बीजगणित (linear algebra) करें, और काम हो गया।
क्या संख्या वास्तव में उन चीज़ों को ट्रैक करती है जिन्हें इंसान जटिल कहते हैं?
काफी हद तक। IC9600 में मानवीय रेटिंग्स के विरुद्ध, ERank का सहसंबंध r = 0.72 है। यह एक पूर्ण मिलान नहीं है, मानवीय रेटिंग्स में लगभग आधी भिन्नता (variance) अस्पष्ट रहती है, लेकिन यह एक पूरी तरह स्वचालित, लेबल-मुक्त माप के लिए एक ठोस परिणाम है, जिसे मानवीय विवेक के विरुद्ध जाँचा गया है, जो स्वयं एक वास्तव में शोरयुक्त लक्ष्य है (लोग "जटिलता" पर एक-दूसरे से पूरी तरह सहमत नहीं होते)।
ERank उन सस्ते हीयुरिस्टिक्स को भी ट्रैक करता है जिनमें इसे सुधार लाना था: कोडेक बिटरेट, तीक्ष्णता (sharpness), और किनारे घनत्व (edge density) सभी इसके साथ बदलते हैं। यह आश्चर्यजनक नहीं बल्कि पुष्टि करने वाला है। यह पुष्टि करता है कि ERank दृश्य व्यस्तता के सहज विचार से पूरी तरह अलगाव रखने वाली कोई चीज़ माप नहीं रहा है। यह उसी विचार की एक बेहतर आधारित संस्करण है, जो कच्चे पिक्सेल सांख्यिकी के बजाय एक मॉडल की सीखी हुई निरूपण (learned representation) से बना है।
पकड़: शोर भी जटिल दिखता है
यहीं पर पेपर कुछ ऐसा करता है जो मुझे पसंद है: यह सिर्फ सहसंबंध (correlation) रिपोर्ट करके आगे नहीं बढ़ता। यह जांचता है कि ERank शोर के तहत कैसे व्यवहार करता है, और ईमानदार जवाब यह है कि शोर इसे बढ़ा देता है। यदि आप किसी छवि में यादृच्छिक पिक्सेल शोर जोड़ते हैं, तो आप चैनलों को लगभग निर्माण के आधार पर असंबंधित (decorrelate) कर देते हैं, स्थैतिक शोर किनारों या बनावट का सम्मान नहीं करता, इसलिए एक शोर वाली छवि बिना किसी अतिरिक्त वास्तविक सामग्री के उच्च ERank प्राप्त कर सकती है।
यह दस्तावेज़-आकार वाली किसी भी चीज़ के लिए बहुत महत्वपूर्ण है। स्कैन आर्टिफैक्ट्स, कागज़ की बनावट, JPEG संपीड़न ब्लॉक, और वॉटरमार्क का रिसना इस अर्थ में सभी शोर हैं। दृश्यमान कागज़ की बनावट और हल्के पृष्ठभूमि वाले वॉटरमार्क के साथ एक स्कैन किया गया पृष्ठ, समान पाठ के स्पष्ट डिजिटल PDF निर्यात की तुलना में "अधिक समृद्ध" स्कोर कर सकता है, भले ही वास्तविक सामग्री में कोई बदलाव न आया हो। ERank इस बात को साफ़ तौर पर अलग नहीं करता कि "इस छवि में वास्तव में अधिक दृश्य जानकारी है" या "यह छवि बस अधिक शोर वाली है"। यह अस्पष्टता इस मेट्रिक के OCR डेटा फ़िल्टर के रूप में इतनी अच्छी तरह काम करने का केंद्रीय कारण है, और यह वह बात भी है जिसे संख्या पर अंधाधुंध भरोसा करने से पहले ध्यान में रखना चाहिए।
वास्तविक निष्कर्ष: ERank द्वारा प्रूनिंग कुछ कार्यों में मदद करता है और दूसरों में सक्रिय रूप से मदद नहीं करता
यह वह हिस्सा है जिसमें असली असर है। लेखकों ने ERank को एक डेटा-चयन मानदंड के रूप में उपयोग किया, जिसका अर्थ है कि उन्होंने ERank वितरण के शीर्ष या निचले हिस्से को काटकर चुने गए डेटासेट के उपसमुच्चयों पर मॉडल प्रशिक्षित किए और कई विज़न कार्यों में क्या हुआ, इसका मापन किया।
दो परिणाम उभरकर सामने आते हैं क्योंकि वे विपरीत दिशाओं की ओर इशारा करते हैं:
-
जब कम-ERank वाली छवियां हटा दी गईं, तो सुपर-रिज़ॉल्यूशन बेहतर हुआ। सुपर-रिज़ॉल्यूशन मॉडल धुंधली या डाउनसैंपल इनपुट से बारीक विवरण पुनर्निर्माण करना सीखते हैं। एक ऐसी छवि जो ज्यादातर समतल हो, जैसे दीवार, आसमान, या खाली टेबलटॉप, मॉडल को टेक्सचर पुनर्निर्माण के बारे में लगभग कुछ भी नहीं सिखाती है। उन छवियों के ढेर पर प्रशिक्षण देने से मॉडल की क्षमता लगभग त्रुटिहीन उदाहरणों पर बर्बाद होती है। ERank वितरण के निचले हिस्से को काटने पर जो बचता है, वह समृद्ध, अधिक टेक्सचर युक्त और अधिक निर्देशात्मक होता है, जिसका पूरा काम विवरणों को हैलुसिनेट करना (पुनर्निर्माण करना) है।
-
जब उच्च-ERank वाली छवियां हटा दी गईं, तो OCR बेहतर हुआ। यह वह परिणाम है जो सहज बुद्धि के विपरीत है। आप सोचेंगे कि प्रशिक्षण दस्तावेज़ में अधिक दृश्य जानकारी उस मॉडल की मदद करेगी जो उस दस्तावेज़ को पढ़ता है। लेकिन OCR के लिए, उपयोगी सिग्नल, अर्थात ग्लिफ्स (glyphs), छवि के तुलनात्मक रूप से कम जटिल हिस्से में मौजूद होते हैं: ज्यादातर समतल पृष्ठभूमि और तेज गहरे स्ट्रोक्स। दस्तावेज़ कॉर्पस में उच्चतम ERank स्कोर प्राप्त करने वाली छवियां अक्सर वे होती हैं जहां टेक्स्ट के अलावा कुछ और फीचर स्पेस पर हावी होता है: भारी पृष्ठभूमि पैटर्न, एम्बेडेड फोटोग्राफ, मारबल्ड पेपर, घना वॉटरमार्किंग, या सिर्फ स्कैन नॉइज़, जो ठीक वही नॉइज़-वर्सस-सिग्नल अस्पष्टता है जो पेपर ने पहले उठाई थी। उन पर प्रशिक्षण देने से ग्लिफ्स के बजाय पृष्ठभूमि पर प्रयास खर्च होता है, और ERank वितरण का शीर्ष हिस्सा असमान रूप से उस क्लटर का घर है।
और वह निष्कर्ष जो इसे जोड़ता है: ERank द्वारा प्रूनिंग से क्लासिफिकेशन, सेगमेंटेशन, या डिनॉइज़िंग में कोई फर्क नहीं पड़ा। सारांश में इसके कारण का फ्रेमिंग साफ सारांश है: ERank तभी मदद करता है जब कार्य की कठिनाई इनपुट की समृद्धि या सादगी द्वारा निर्धारित होती है। क्या एक मॉडल फोटो में वस्तु का नाम बता सकता है, या उसके चारों ओर सटीक मास्क खींच सकता है, यह इस बात पर निर्भर नहीं करता कि पूरी छवि में कितने फीचर चैनल सक्रिय होते हैं। व्यस्त पैटर्न वाले रग पर कुत्ता सादे घास पर कुत्ते की तुलना में क्लासिफाई करने में अधिक कठिन नहीं है, सिर्फ इसलिए कि रग का ERank स्कोर अधिक है। जटिलता-जैसे-समृद्धि और कार्य-जैसे-कठिन दो अलग-अलग अक्ष हैं, और उन तीन कार्यों के लिए वे एक लाइन में नहीं आते।
यह प्रीट्रेनिंग और फाइनट्यूनिंग दोनों में बना रहा, जो यह सुझाव देता है कि यह किसी एक प्रशिक्षण विधि का कोई आर्टिफैक्ट नहीं है, बल्कि यह कार्यों के डेटा से वास्तव में क्या चाहिए, इसकी एक विशेषता है।
OCR बनाने या चुनने वाले किसी के लिए यह क्यों मायने रखता है
अगर आप किसी डॉक्यूमेंट मॉडल के लिए ट्रेनिंग कॉर्पस को क्यूरेट या ऑडिट कर रहे हैं, तो ERank आपको एक फ्री, ऑटोमैटिक तरीका देता है जिससे आप अपने डेटा के उस सबसेट को फ्लैग कर सकते हैं जो उपयोगी टेक्स्ट सिग्नल की बजाय बैकग्राउंड कलटर होने की अधिक संभावना रखता है, बिना एक भी इमेज को हैंड-लेबल किए या किसी ह्यूमन कॉम्प्लेक्सिटी पैनल का इंतज़ार किए। यह कोई रिसर्च क्यूरियोसिटी नहीं, बल्कि एक असली, यूज़ेबल फ़िल्टर है: अपने कॉर्पस पर एन्कोडर पास एक बार चलाएं, ERank के हिसाब से सॉर्ट करें, और उस पर ट्रेन करने से पहले टॉप स्लाइस को गौर से देखें।
यह उस पैटर्न के लिए एक संभावित व्याख्या भी प्रदान करता है जिसे नोटिस करना आसान है लेकिन सटीक नाम देना मुश्किल: कुछ डॉक्यूमेंट टाइप्स क्रॉनिकली OCR इंजनों के लिए कठिन होते हैं, जैसे मैबल्ड बुक एंडपेपर्स, हेवी वॉटरमार्किंग वाले फॉर्म्स, या प्रिंटेड बैकग्राउंड लोगो वाले रसीदें, और इन्हें सिर्फ "हार्ड डॉक्यूमेंट्स" कहना आसान है बिना यह मापे कि क्यों। ERank आपको "क्यों" के लिए एक नंबर देता है: ये वो पेज हैं जहाँ बैकग्राउंड मॉडल की एटेंशन के लिए टेक्स्ट के साथ प्रतिस्पर्धा कर रहा है, और यह प्रतिस्पर्धा आप उन्हें OCR से गुज़ारने से पहले ही माप सकते हैं।
एक और एप्लिकेशन है जिसे अपनाने की बजाय नज़र रखना चाहिए: एक प्लेटफ़ॉर्म जो डॉक्यूमेंट्स को मल्टीपल OCR इंजनों के बीच राउट करता है, वह सिद्धांत रूप में ERank को एक पर-डॉक्यूमेंट सिग्नल के रूप में इस्तेमाल कर सकता है, हाई-ERank पेज (जो विजुअली क्लटर या नॉइज़ होने की अधिक संभावना रखते हैं) को एक अधिक रॉबस्ट या महंगे इंजन पर भेजकर, और क्लीन लो-ERank पेज को एक सस्ते, तेज़ इंजन पर। इस पेपर के आधार पर अभी तक किसी ने उस पाइपलाइन को बिल्ड या वैलिडेट नहीं किया है। यह परिणाम का एक नेचुरल एक्सटेंशन है, पेपर का दावा नहीं। हिंदी जैसे देवनागरी स्क्रिप्ट में भी यही सच है — मजबूत इंग्लिश OCR का मतलब यह नहीं कि देवनागरी OCR भी उतना ही अच्छा होगा, क्योंकि देवनागरी में स्टैक्ड कॉन्जंक्ट्स, मेट्रा और शिरोरेखा जैसे विजुअल क्लटर अक्सर मॉडल के लिए अलग चुनौती पेश करते हैं।
अभी भी क्या असिद्ध है
मानवीय निर्णय के साथ सहसंबंध, r = 0.72, अच्छा है लेकिन कसकर बंधा हुआ नहीं है। मानव द्वारा "जटिल" कहा जाने वाले एक महत्वपूर्ण हिस्से को सक्रिय फीचर दिशाओं की गिनती द्वारा नहीं पकड़ा जाता है, और ERank को एक उपयोगी प्रॉक्सी के बजाय ग्राउंड ट्रूथ के रूप में मानने से पहले इसे याद रखना महत्वपूर्ण है।
यह मेट्रिक इस बात पर भी निर्भर करता है कि आप इसे किस फ्रोज़न एन्कोडर के माध्यम से चलाते हैं। प्राकृतिक तस्वीरों पर प्री-ट्रेन नेटवर्क, दस्तावेज़ों पर प्री-ट्रेन नेटवर्क या पूरी तरह अलग उद्देश्य के साथ प्रशिक्षित नेटवर्क की तुलना में अलग सेट के चैनल्स सीखता है, और पेपर के अपने परिणाम उन एन्कोडर से जुड़े होंगे जिन्हें उन्होंने उपयोग किया था। किसी भी ऐसे व्यक्ति को जो ERank को एक अलग डोमेन पर दोबारा उपयोग कर रहा है, इसकी पुन: सत्यापन (re-validate) करने की उम्मीद करनी चाहिए और यह मानने के बजाय कि समान थ्रेशोल्ड ट्रांसफर होते हैं।
OCR के लिए विशेष रूप से, मैं नॉइज संवेदनशीलता को सबसे करीब से देखूंगा, यह देखते हुए कि उत्पादन दस्तावेज़ डेटा (वास्तविक स्कैन, रसीदों की फोन तस्वीरें, फैक्स) अधिग्रहण नॉइज (acquisition noise) ले जाता है जिसका सामग्री की समृद्धि से कोई लेना-देना नहीं है। यदि ERank "वास्तव में समृद्ध छवि" और "नॉइजी छवि" के बीच पूरी तरह से अंतर नहीं कर सकता है, तो उच्च-ERank "क्लटर" के रूप में काट दिए जाने वाले कुछ हिस्से बस स्कैन ग्रेन हो सकते हैं, और वास्तव में जटिल, सूचना-घने दस्तावेज़ों का कुछ हिस्सा उसके साथ ही फेंक दिया जा सकता है। पेपर का OCR परिणाम कुल मिलाकर टिका रहा, जो कि वह सबूत है जो मायने रखता है, लेकिन इसका मतलब यह नहीं है कि फिल्टर द्वारा फेंके गए हर एक व्यक्तिगत दस्तावेज़ को जाने की जरूरत थी।
और डेटा-चयन परिणाम शोध बेंचमार्क से आते हैं जिनमें साफ पहले/बाद की तुलनाएं हैं। उत्पादन पाइपलाइनें अधिक गंदी हैं: मिश्रित दस्तावेज़ प्रकार, मिश्रित अधिग्रहण गुणवत्ता, एक ही कॉर्पस के लिए मिश्रित डाउनस्ट्रीम उपयोग। क्या "ERank द्वारा शीर्ष N% काटें" किसी विशिष्ट डेटासेट के लिए सही नियम है, शायद इसकी अपनी जांच की आवश्यकता होती है, न कि पेपर में काम करने वाले किसी भी प्रतिशत की अंधाधुंध नकल। ERank को एक मजबूत, सस्ती फर्स्ट-पास फिल्टर के रूप में मानें जो अपने डेटा पर परीक्षण के लायक है, न कि कोई निश्चित रेसिपी।