TextMonkey: 視覚言語モデルが直前に読んだ行を指し示すように教える
元論文: TextMonkey: An OCR-Free Large Multimodal Model for Understanding Document — Yuliang Liu, Biao Yang, Qiang Liu, Zhang Li, Zhiyin Ma, Shuo Zhang, Xiang Bai
根拠を可視化する:TextMonkeyのアプローチ
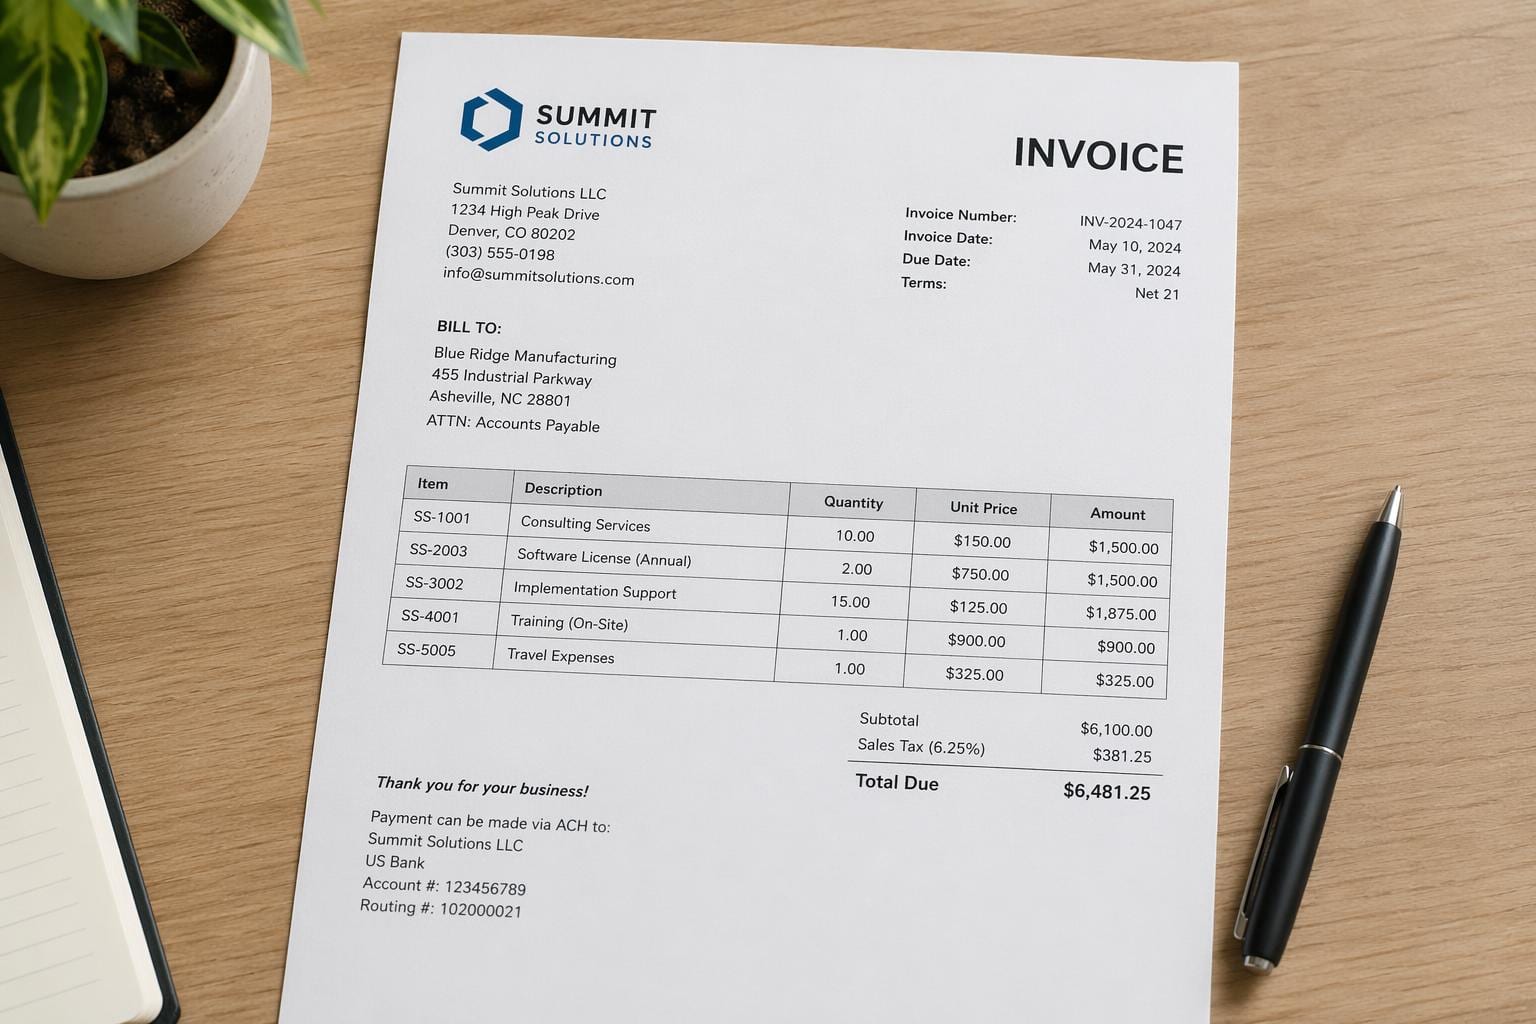
多くのドキュメントAIツールに「この請求書の合計金額は?」と尋ねると、ある数字が返ってきます。しかし、その数字が正しいかを確認する方法はなく、モデルが4行目を読み取ったのか、あるいは誤って7行目の小計を拾ったのかを知る術はありません。ユーザーはただ、その結果を信じるしかないのです。
華中科技大学が2024年に発表した論文「TextMonkey」は、より実用的なアプローチを提案しています。このモデルは質問に答えるだけでなく、回答の根拠となった正確なテキスト箇所をボックスで囲んで提示します。特定の単語を探させれば、単に「ここにあります」と答えるのではなく、その座標を返します。一見すると小さな機能に見えるかもしれません。しかしこれは、モデルがどう動作すべきかという構造的な設計思想に基づいたものであり、この論文で最も興味深い点と言えます。
従来の手法:まずOCR、次に理解
長年、AIでドキュメントを「読む」ということは、2段階のパイプラインを意味していました。ステップ1では、OCRエンジン(Tesseractやより高度なツール)がピクセルをテキスト文字列に変換します。ステップ2では、言語モデルがその文字列を読み取り、それに基づいた質問に回答します。
問題は、ステップ1がボトルネックとなり、元の画像の記憶が保持されないことです。OCRが請求書を単なる文字の列に変換した時点で、レイアウトや表構造、どの行がヘッダーであるかを示すフォントサイズ、そして人間が「この数字は太字で枠に囲まれているから、おそらく合計金額だろう」と判断するための視覚的なコンテキストが失われてしまいます。もしOCRエンジンが文字を誤認したり、行を飛ばしたりしても、言語モデルは何かが失われたことに気づきません。ただ不正確な入力に基づいて、自信満々に回答するだけです。
TextMonkeyは、このステップ1をスキップする新しい「OCR-free」モデルのファミリーに属しています。このモデルはドキュメント画像を直接読み取り、テキスト、構造、そして回答を一度に生成します。これは、私たちがレシートをパッと見て、すべての文字を意識的に書き写すことなく合計金額を把握する仕組みと同じです。2024年においてこれは新しいアイデアではありませんが、TextMonkeyは解像度、効率、そして真に新しい機能である「ポインティング(指し示し)」能力において、このアプローチをさらに進化させています。
なぜドキュメント画像は一般的なビジョンモデルで機能しないのか
ビジョン言語モデルの多くは、ビーチにいる犬や料理の皿、街中の風景といった「写真」を対象に構築され、調整されてきました。しかし、ドキュメントはそれらとは全く異なる性質を持っています。
写真は224x224ピクセルまで縮小されても、それが犬であることは判別できます。しかし、文字が密集した財務書類のページを224x224まで縮小すると、判読不能な塊になってしまいます。標準的なビジョンエンコーダーは特定の解像度帯向けに設計されていますが、ドキュメントには全く異なるアプローチが必要です。つまり「高解像度」です。なぜなら、フォームの入力項目の意味はわずか数文字の小さな文字に依存していることが多く、また情報は特定の目立つ領域に集中しているのではなく、ページ全体に均等に分散しているからです。
入力解像度を上げることは明白な解決策に見えますが、別の問題を引き起こします。Vision Transformerは、画像を小さなパッチに分割し、それらの間のアテンションを計算することで処理します。解像度が高くなるとパッチ数が大幅に増加し、各パッチが自身の近傍しか「見ない」場合、モデルは領域をまたがる要素を追跡できなくなります。例えば、幅の広いドキュメントの左端から右端まで伸びる表の行などがこれにあたります。この問題に対処せずに単に解像度を上げるだけでは、長距離の相関関係を見落とすか、あるいは計算コストが許容できないほど増大することになります。
TextMonkeyが実際にページを読み取る仕組み
本論文で提案されているアプローチは、相互に連携するいくつかの要素で構成されています。
Shifted Window Attention(シフトウィンドウ・アテンション)。 高解像度の画像をそのまま一つの巨大なアテンション計算で処理するとコストが高すぎますし、かといって互いに通信できない独立した非重複ウィンドウに分割すると、ウィンドウをまたいだ情報が失われてしまいます。そこでTextMonkeyは、Swin Transformerのビジョンアーキテクチャからある手法を借用しました。まず画像をローカルウィンドウで処理し、次のレイヤーでウィンドウの境界をずらす(シフトさせる)ことで、前回分割されていた領域を今回はグループ化して処理します。これを数レイヤー繰り返すことで、フルグローバルアテンションのコストを支払うことなく、実質的に画像全体に情報を伝播させることができます。また、著者は重要ながら見落とされがちな詳細を付け加えています。このシフトアテンション機構をゼロ初期化している点です。つまり、学習開始時点では寄与度をゼロにし、徐々に高めていくことで、不完全なクロスウィンドウ機構をいきなり導入してモデルが発散するリスクを避け、初期学習の安定性を確保しています。
冗長なトークンの削減。 パッチレベルで高解像度のドキュメント画像を処理すると膨大な数のトークンが生成されますが、その多くは冗長です。例えば、広い空白の余白や、数十個のパッチにわたって繰り返される同じ背景テクスチャなどがこれにあたります。TextMonkeyは類似度ベースのフィルタを使用して、これら情報量の少ないトークンを特定し、モデルの負荷が高い処理に回る前に削除します。注目すべき発見は、これが単なる高速化のテクニックではない点です。論文では、冗長なトークンをトリミングすることで、高速化だけでなくパフォーマンス自体も向上したと報告されており、一部の「余分な」トークンがシグナルではなくノイズとして作用していたことが示唆されています。
学習タスクとしてのText spottingとgrounding。 これが「指し示す」動作を実現している部分です。モデルを自由形式のテキストで質問に答えるためだけに学習させるのではなく、text spotting(特定の場所にあるテキストを見つけて書き起こす)とgrounding(フレーズが与えられたときにそのバウンディングボックスを返す)も同時に学習させています。重要なのは、位置情報をモデルの回答自体に組み込んでいる点です。これにより、TextMonkeyが「合計金額はいくらか」という問いに答える際、その回答をどこから読み取ったかの座標を一緒に提示できます。これにより、不透明な回答が検証可能な回答へと変わります。
ファインチューニングによるスクリーンショットの理解。 また、ターゲットを絞ったファインチューニングを通じて、UIスクリーンショット(アプリのインターフェースやウェブページ)を解析する能力も習得しています。これにより、ドキュメント読み取りスキルを、密なテキスト段落ではなく、疎でレイアウト重視の、アイコンやボタン主導という全く異なる視覚ドメインへと拡張しています。
数値とその実際的な意味
TextMonkeyは、3つのカテゴリーに分かれた計12のベンチマークで評価されました。
- シーンテキスト中心のタスク(街中の看板や製品ラベルなど、現実世界の写真からテキストを読み取る):STVQA, TextVQA, OCRVQA。改善率:5.2%。
- ドキュメント指向のタスク(フォーム、インフォグラフィック、チャート、表などの構造化ドキュメント):DocVQA, InfoVQA, ChartVQA, DeepForm, Kleister Charity, WikiTableQuestions。改善率:6.9%。
- 重要情報の抽出(請求書から「ベンダー名」や「請求額」を抽出するなど、半構造化ドキュメントから特定のフィールドを抽出する):FUNSD, SROIE, POIE。改善率:2.8%。
最も大きな伸び(6.9%)を見せたドキュメント指向のカテゴリーは、論文の主張とも一致しています。高密度なフォームや表は、従来のモデルが低解像度で情報を失いやすかった領域であるため、shifted-windowによる解像度処理とトークンフィルタリングが最も効果を発揮したと考えられます。
また、シーンテキストのスポット(クリーンなスキャンではなく、自然な写真の中に散在するテキストを見つけて読み取る)は10.9%向上し、論文内で最大の数値となりました。これは、ローカライゼーションを後付けにするのではなく、スポットおよびグラウンディングタスクを明示的に学習させた直接的な成果であると言えます。
29のOCR関連サブタスクで構成される包括的なスイートであるOCRBenchにおいて、TextMonkeyは561点を記録し、当時のドキュメント理解向けオープンソース大規模マルチモーダルモデルを上回りました。この分野のOCRBenchの数値は変動が激しく、1〜2年で塗り替えられるため、561点という数値は永続的なランキングではなく「2024年3月時点でのstate of the art」として捉えるべきです。しかし、従来のオープンモデルとの相対的な差は、アーキテクチャの選択がどのような成果をもたらしたかを示す有益な指標となります。
まだ不十分な点
論文内では制限事項について深く触れられていませんが、明確に指摘しておくべき欠点がいくつかあります。
まず、トークンのフィルタリング工程は、冗長性を判断するために「類似度」に依存しており、これはあくまでヒューリスティックな手法です。そのため、出現頻度は低いが重要な意味を持つトークン(例えば、ページ内で一度しか現れず、他のどの要素とも「似ていない」小さなスタンプやかすれた透かしなど)が、誤って破棄されてしまう可能性があります。論文では正味のパフォーマンス向上が報告されていますが、それはベンチマーク全体の平均値であり、個別の困難なケースにおける動作を保証するものではありません。
また、グラウンディング(根拠付け)の精度は、基盤となる読み取り精度に依存します。モデルが数字を誤認した場合、描画されるバウンディングボックスは、自信満々に「間違った根拠」を指し示すことになります。グラウンディングによって得られるのは「検証可能性」であり、「正解であること」ではありません。「私を信じてください」という状態よりは格段に改善されていますが、それが正解の証明になるわけではありません。
さらに、ここでのベンチマークは依然として英語圏の言語と、主に欧米のドキュメント形式に偏っています。論文の要旨を見る限り、多言語ドキュメントや手書き文字の多いフォーム、あるいは実世界のバックログに現れるような乱雑なスキャンデータ(傾き、低コントラスト、コーヒーのシミなど)でのテストは示唆されていません。クリーンなベンチマークでの性能と、乱雑な実世界での性能には相関関係はありますが、同一ではありません。
OCRの構築や導入を検討している方にとって重要な理由
製品に組み込むドキュメントAIエンジンを選ぶ際、注目すべきは単純なベンチマークの数値よりも、ここでの「グラウンディング(根拠付け)」能力です。「合計は$482.19です」と出力するだけのモデルでは、誤りがあった際にそれを検知する方法がありません。一方で、数値と共にバウンディングボックス(境界枠)を出力できるモデルであれば、人間がハイライトされた箇所を一目で確認して承認・却下できるUIを構築でき、文書全体を読み直す手間を省けます。金銭、契約、コンプライアンスに関わるワークフローにおいて、この差は「スポットチェックが可能なOCR」か、「盲目的に信頼せざるを得ないOCR」かという決定的な違いになります。
また、これは「OCRで抽出してからパースする」という従来のパイプラインから、「一度のパスで読み取りと理解を同時に行う」単一モデルへの大きな転換を示すデータポイントでもあります。私たちが追跡している多くのモデルでこの傾向が見られ、OCRによるテキスト抽出とドキュメント理解を別々のツールで行う前提でインフラを構築してきた方々にとって、設計思想の変更を迫られることになります。実際、このハンドオフ(受け渡し)を省いたモデルがドキュメント重視のベンチマークで勝利しており、その理由は単純です。OCR文字列から読み取りモデルへ渡される過程で、情報の欠落が起きないからです。なお、本手法は主に英語圏のデータに基づいているため、日本語特有の漢字の複雑さや縦書きレイアウトへの対応については十分に検証されていません。
実用面では、トークン効率の視点も重要です。大規模な推論を実行する場合、冗長なトークンを削減しながら同時に精度を向上させる手法は非常に稀であり、注目に値します。通常、効率性と品質の向上は同時に訪れることは少ないですが、今回のケースではそれが実現しています。