スキャナーではなくエンジニアのように図面を読むAI
元論文: Drawing-Recode: Annotation Grounding for Parametric CAD Code Generation from Raster 2D CAD Drawings — Mingi Kim, Yongjun Kim, Hyungki Kim
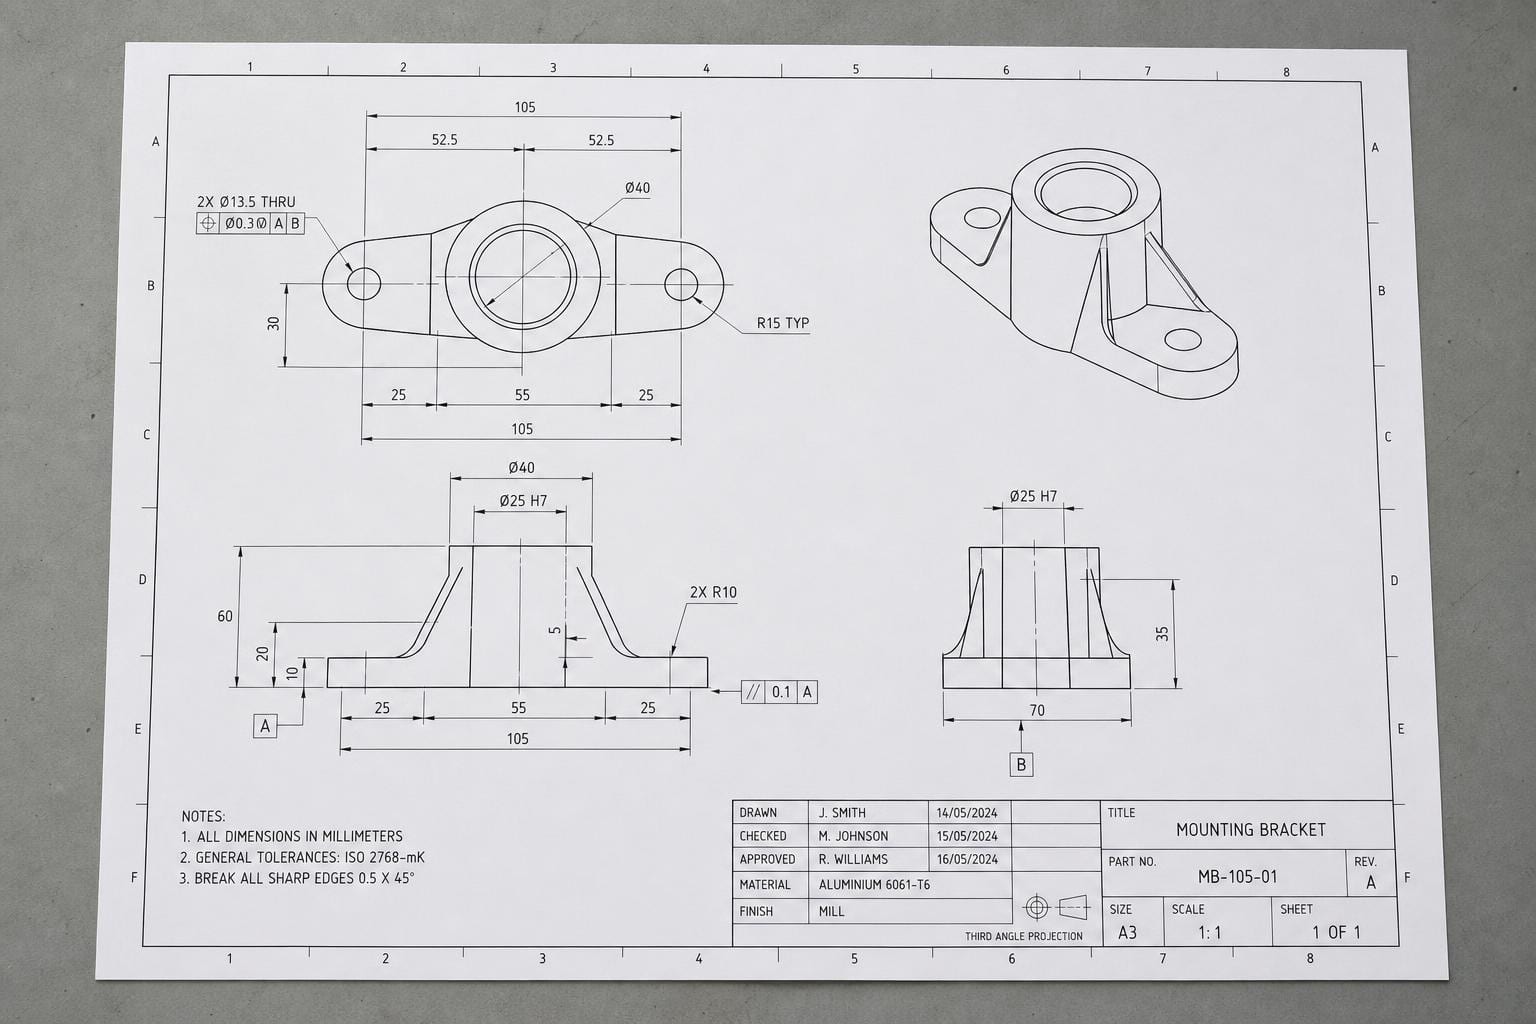
製造現場のどこかで、もう注文できない部品の図面がぎっしり詰まったファイルキャビネットがあります。1994年のブラケット。手書きの寸法。コピーを繰り返して線がぼやけています。元々の部品を作っていた会社は消滅しました。図面を描いたエンジニアは10年前に退職しました。しかし、顧客はまだその特定のブラケットを必要としています。そして、唯一の記録は一枚の紙です。
その部品を最新のCNC機械や3Dプリンターで製造するには、誰かがその図面を「生きた」パラメトリック3Dモデルに戻す必要があります。つまり、部品の画像ではなく、コンピュータがサイズ変更、編集、加工できる一連の指示です。今日、それはCAD技術者が座って、紙から各寸法を読み取り、ソフトウェアに再入力して、すべてを手動で再描画することを意味します。それは遅く、高価で、まさに良いAIシステムが支援できるべきタスクの典型です。
ミンギ・キム、ヨンジュン・キム、ヒョンギ・キムの研究者による新しい論文「Drawing-Recode」は、そのパイプラインを自動化しようとしています。スキャンされた2D図面を入力し、動作するCADコードを出力します。それが興味深いのは、単にこれを試みていることだけではありません。著者が真のボトルネックとして特定する具体的な問題であり、それは多くのOCR関連システムが静かに無視しているものです。
数字を読み取るのと、それが何を測定しているかを理解することの間のギャップ
ここで重要な区別から始めよう:ラスターとベクトル。ベクトルCADファイル(例えばDXFやSolidWorksのネイティブファイル)は、幾何学データを構造化されたデータとして保存する:この線は点Aから点Bまで伸びており、この円はこの半径を持っている。一方、ラスター画像は単なるピクセルの集合だ。スキャンされた図面、ブループリントの写真、中身が実際には画像であるPDF、これらすべてはラスターである。これらには全く構造化された情報がない。人間の目には線やテキストのように見える偶然の色の点の集合に過ぎない。
ラスターCAD図面からテキストを読み取ることは、ほぼ解決された問題だ。OCRは「Ø25」や「50.5」のような寸法記号を含むテキストを、ある程度正確にページから抽出できる。しかし、それがDrawing-Recodeの本質的な課題ではない。
より難しい問題はこれだ:ページから「50.5」という数字を読み取った後、それが何を指しているのか? CAD図面はラベル付きフィールドのフォームではない。それは特定の辺、穴、表面を指す寸法線と数字の散りばめられた部品画像だ。長方形の近くにある「50.5」は、おそらくその幅を記述しているが、対角線や穴の間隔、あるいは拡張線がたまたま交差する3行離れた何かを記述しているかもしれない。このリンクを誤ると、わずかにずれた部品が得られるわけではない。構造的に誤った部品が得られる。なぜなら、パラメトリックCADモデルは操作のシーケンス(この長方形を描画し、この距離だけ押し出し、この穴を切り取る)であり、各ステップは数字が正しい幾何学に結びついていることに依存しているからである。
この論文の枠組みは、以前のシステムはベクトル図面のみで動作する(すでにこの構造が組み込まれているため、解決すべき問題がない)か、特定の種類の図面や業界用に構築された狭い範囲のものであり、いずれも注釈が記述している幾何学と明示的に接続していないということだ。それらはテキスト認識と幾何学認識を別々の作業として扱い、接続が下流で自動的に整理されることを期待する。しかし、それは通常起こらない。
Drawing-Recodeが数値を測定対象の線に結びつける仕組み
このアーキテクチャにはいくつかの明確な構成要素があり、その中で特に興味深いのは中央部分です。
まず、画像エンコーダがラスター形式の図面を解析し、幾何学的な特徴を抽出します。具体的には、ページ上の線、曲線、形状の豊富な内部表現を、テキストとは独立して取得します。別ルートでは、テキスト認識モジュールが注釈を読み取ります。図面に散在する寸法数値、許容誤差、ラベルなどが対象です。ここまでは標準的なドキュメントAIの手法で、2つの専門的なリーダーが並行して動作しています。
実際の貢献は、その後の処理にあります。Drawing-Recodeはクロスアテンション(相互注意機構)を用いて、ある特徴セットが別のセットを「参照」し、関連するものを決定する仕組みで、認識された各注釈を、それが記述している特定の幾何学的特徴へと接続します。これは、モデルが独自の延長線を描くことを学習していると考えられます。例えば「50.5」というテキストを与えられた場合、その数値が最も妥当に測定しているエッジを幾何学的表現の中から検索し、人間が寸法線に沿って数値から部品の輪郭へと視線を追うのと同じように動作します。
この接続を近似ではなく確実なものにするために、著者らは「注釈グラウンディング損失(Annotation Grounding Loss, AGL)」と呼ばれる要素を追加しています。機械学習における「損失」とは、モデルの出力が誤った場合に訓練中に課されるペナルチーであり、モデルが改善するためのシグナルです。通常の訓練セットアップでは、最終的なCADコードの出力が誤った場合にのみモデルにペナルティを課すことが多いです。AGLは、最終出力に至る前に、注釈と幾何学の間のリンクが誤っている場合に、追加かつ明示的なペナルティを課します。これは意図的な設計選択です。良いコード生成の副産物として正しいグラウンディングが自然に現れることを期待するのではなく、モデルがグラウンディング自体を独立して正しく行うように訓練するのです。
幾何学情報、認識されたテキスト、およびそれらを結びつけるグラウンディングされたリンクが1つの特徴セットに統合されると、それが大規模言語モデル(LLM)に供給されます。ChatGPTなどのツールを支えるモデルと同じファミリーですが、ここでは文章ではなくコードを生成するように適応されています。出力は画像や座標のセットではありません。著者らが「構造化パラメトリックCADコード(Structured Parametric CAD Code, SPCC)」形式と呼ぶCADコードです。「このプロファイルをスケッチし、12mm押し出し、ここに6mmの穴を開ける」といった操作のシーケンスであり、CADプログラムがこれを実行することで、単なる静的な形状ではなく、完全に編集可能な実際の3Dモデルを再構築できます。
発見されたこと、そして実世界での利用において実際に重要な部分
本論文では、Drawing-Recodeがラスター図面から正しいパラメトリックCADシーケンスを復元する際に、既存のベースライン手法を上回る性能を示したと報告されています。これは当然のことです。論文で提示される新しい手法は、それ以前の手法を凌駕する必要があります。そうでなければ、論文として成立しません。
より示唆に富むのは、2つ目の主張です。すなわち、このシステムは実際の産業環境に似たスキャンされた図面においても堅牢性を維持するという点です。これは「デモ」と「ツール」の違いを意味するため、じっくりと検討する価値があります。クリーンで高解像度のCADレンダリングは容易なケースです。現実世界の図面、つまりファイリングキャビネットの中に眠っているようなものは、コピーのさらにコピーであり、色あせ、わずかな回転、コーヒーの輪じみ、消しゴムや鉛筆の痕跡があり、AIはそれらを回避して処理する必要があります。完璧な入力のみで良好に動作するシステムは、実際に誰も抱えていない問題を解決しているに過ぎません。著者は劣化したスキャンに対して特に設計し、テストを行ったことで、ラボ環境でのクリーンなケースが本来の目的ではないことを理解していたことが伺えます。
ただし、抄録には具体的な数値、精度のパーセンテージ、正確なベースライン比較、データセットのサイズなどが明示されていないため、「上回る」「堅牢性を維持する」といった表現は、直接引用できるスコアボードではなく、実験によって裏付けられた方向性の主張として捉えるべきです。この研究を基に開発を進めるかどうかを判断する際、特定のベンチマークの数値よりも、メカニズム(クロスアテンションによる明示的なグラウンディングと専用の損失関数)こそが転用可能なアイデアとなります。
OCRの構築・選択においてなぜ重要なのか
CADに限定せず、ドキュメントAI全体(まさにOpenOCRの専門分野)に目を向けると、重要な教訓が得られる。
現実世界のドキュメント処理の多くは「テキストを読み取る」ことではなく、「どのテキストがどの要素に属するかを特定する」ことである。請求書の明細行は、正しいSKUと合計額とリンクする必要がある。医療用フォームのチェックボックスは、3行上のラベルではなく、隣接するラベルとリンクする必要がある。財務諸表の脚注マーカーは、注釈対象の番号とリンクする必要がある。これらのケースすべてにおいて、従来のOCRは文字は取得できるが、関係性の取得では完全に失敗する。実際の価値が生まれるのは、まさにこの関係性の中にあることが多い。
Drawing-Recodeは、大きなモデルが偶然学習することを期待するのではなく、意図的にこの関係性の問題を解決するための明確なケーススタディである。 接地(グラウンディング)専用の損失関数、2つのモーダルを構造的に接続することを強いるクロスアテンションといった明示的な設計選択は、CAD図面を扱わない場合でも覚えておくべき点である。注釈、ラベル、相互参照(単なる連続テキストではない)を伴うタスクにおいて、OCRまたはドキュメントAIエンジンを評価する際は、ベンダーに、そのシステムがこれらのリンクを明示的にモデル化しているか、それともテキストと幾何学情報を別々に抽出してユーザーに結合を委ねているかを問い合わせてほしい。この2つのアプローチの間のギャップが、通常、精度問題が発生する場所である。
日本語(漢字と仮名)は縦書きで表記されることが多く、これは多くのOCR/VLMモデルにとって最も困難なケースの一つである。もし対象の論文やモデルが英語のみを対象としており、縦書きテキストを無視している場合、それは日本語読者にとって漢字や縦書きレイアウトがカバーされていないことを意味する。
OpenOCRユーザーにとって特に、注目すべきカテゴリが示唆されている。部品デジタル化のような狭く深いタスク用に構築されたエンジンは、汎用OCRエンジンがより大きなトレーニング予算を持っていたとしても、そのタスクにおいて汎用OCRを上回る傾向がある。工学アーカイブのデジタル化を行う場合、適切な対応は、汎用OCRエンジンを実行してどの数値がどの線に属するかを推測するためのカスタムグルーコードを書くことではない。リンクがモデルの一部であり、後処理で付け加えられたものではない、Drawing-Recodeのアプローチに近いものを見つけるか構築することである。
まだ課題が残っている部分
いくつかの課題が目立ちます。その一部は論文の枠組みで明示的に言及されているもの、もう一部は記述されたアプローチ自体に内在するものです。
対象範囲は、個々の部品に対する3Dパラメトリックシーケンスを生成する2D図面であり、完全なアセンブリ(組立)ではありません。実際の製造アーカイブには単一部品の図面だけでなく、複数の部品、サブ参照、およびクロスシート呼び出し(「シート3の詳細を参照」など)を含む組立図面が含まれます。抄録には、Drawing-Recodeがこのより広範なケースを既に処理できることを示唆する記述はありません。
また、LLMベースのコード生成に伴う標準的なリスクも存在します。流暢で構造的に有効な出力が、寸法的に正確な出力と同じであるとは限りません。生成されたSPCCシーケンスは見た目にも正しく、正しい方向に正しい形状を押し出すように見えても、誤読された数値やわずかに間違ったグラウンディング(空間的対応付け)の判断に基づいて構築されている可能性があります。ブログ記事としては興味深い点ですが、機械に取り付けられる製造部品にとっては、機能する代替品と非常に高価なミスとの違いを意味します。抄録には、生成されたコードを実際の公差に対してチェックする下流の検証ステップに関する記述はなく、無人で生産部品に適用する前に必要となるようなガードレール(安全装置)です。
そして、ほとんどの専門的な認識モデルと同様に、トレーニングデータの品質が性能の上限となります。CAD固有の注釈規約の読取りに特化したこのモデルは、おそらくCAD固有のデータでトレーニングされているため、そのトレーニング分布外の図面スタイル、記号規約、または業界における性能は、論文が回答を主張していない未解決の問いです。
これらの課題は、核心的なアイデアを損なうものではありません。テキスト認識と形状認識をたまたま近接して実行される2つのタスクとして扱うのではなく、注釈を幾何学形状に明示的にグラウンディングすることは正しい直感であり、ドキュメントAI分野全体がより頻繁に採用すべきアプローチです。