TextMonkey: Ensinando um Modelo de Visão-Linguagem a Apontar para a Linha que Acabou de Ler
Baseado em: TextMonkey: An OCR-Free Large Multimodal Model for Understanding Document — Yuliang Liu, Biao Yang, Qiang Liu, Zhang Li, Zhiyin Ma, Shuo Zhang, Xiang Bai
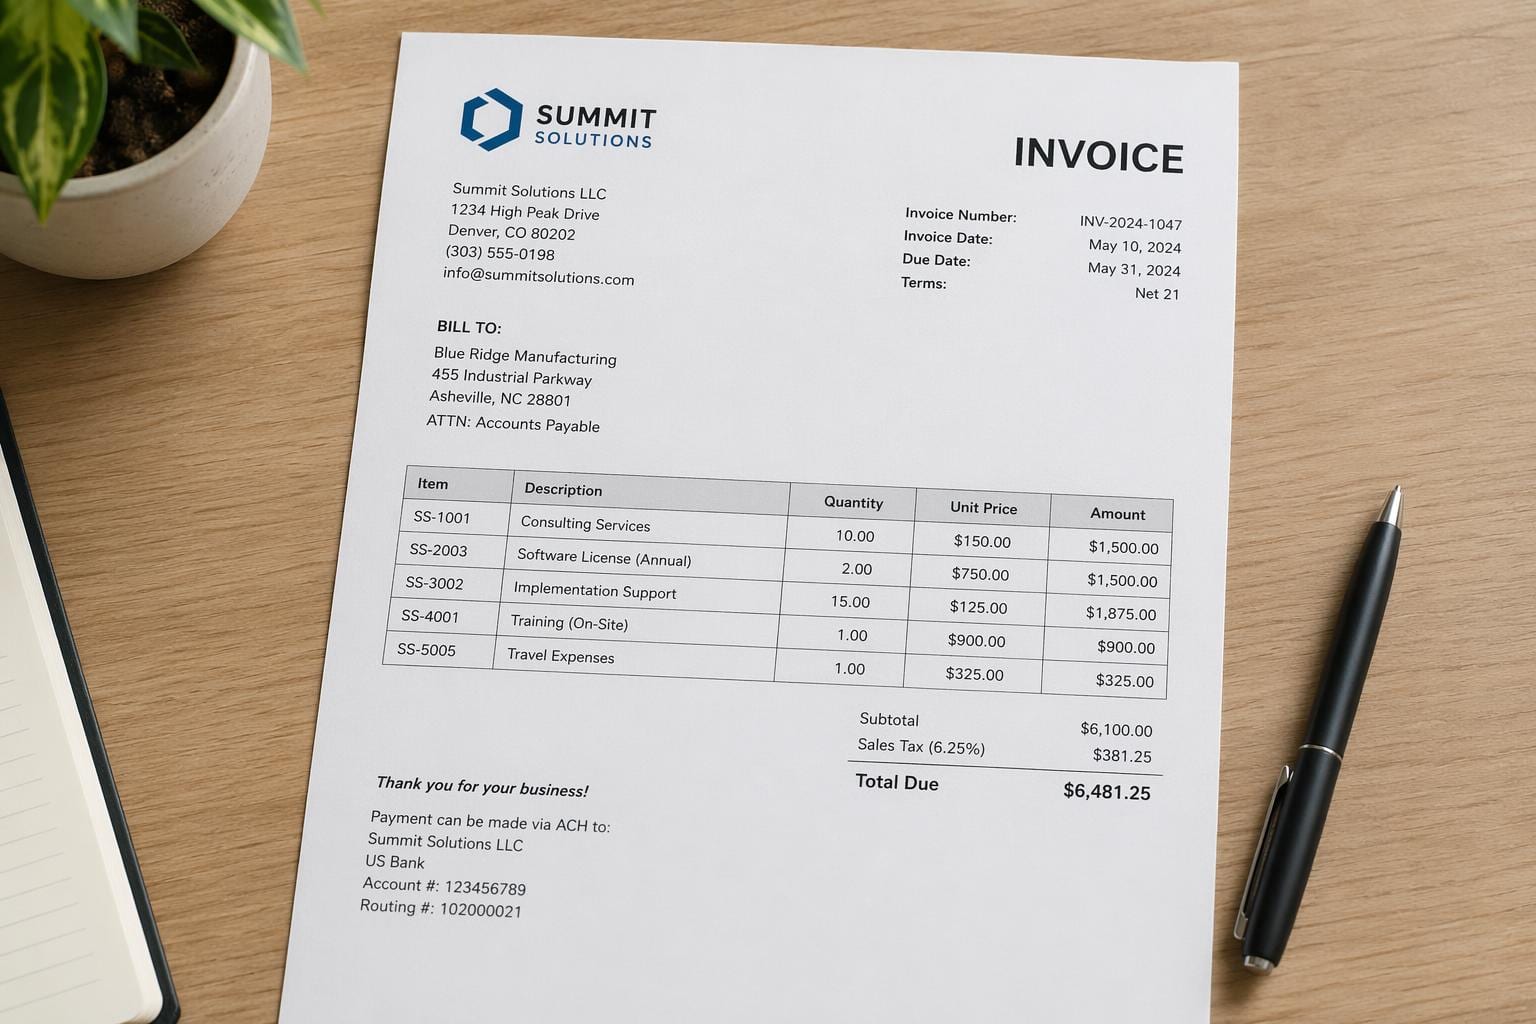
Pergunte à maioria das ferramentas de IA para documentos "qual é o total nesta fatura?" e você receberá um número. Não há como verificar, nem saber se o modelo leu a linha 4 ou pegou acidentalmente um subtotal da linha 7. Você só precisa confiar.
TextMonkey, um artigo de 2024 da Universidade de Ciência e Tecnologia de Huazhong, faz algo mais útil: responde à pergunta e desenha uma caixa ao redor do texto exato que usou para chegar lá. Peça para encontrar uma palavra, e ele não diz apenas "sim, está aqui" — ele fornece as coordenadas. Isso parece um recurso pequeno. Na verdade, é uma aposta estrutural sobre como esses modelos devem funcionar, e é a parte mais interessante do artigo.
O jeito antigo: OCR primeiro, entender depois
Por anos, "ler" um documento com IA significava um pipeline de duas etapas. Na primeira etapa, um mecanismo de OCR (Tesseract, ou algo mais sofisticado) converte os pixels em strings de texto. Na segunda etapa, um modelo de linguagem lê essas strings e responde perguntas sobre elas.
O problema é que a primeira etapa é um gargalo sem memória da imagem original. Assim que o OCR transforma sua fatura em uma string de caracteres, o modelo já perdeu o layout, a estrutura da tabela, o tamanho da fonte que indicava qual linha era o cabeçalho e o contexto visual que dizia a um leitor humano "esse número está em negrito e dentro de uma caixa, provavelmente é o total". Se o mecanismo de OCR ler um caractere incorretamente ou perder uma linha, o modelo de linguagem nunca sabe que algo foi perdido. Ele apenas responde com confiança com base em uma entrada ruim.
TextMonkey pertence a uma família mais nova de modelos "livres de OCR" que pulam a primeira etapa. O modelo olha diretamente para a imagem do documento e gera texto, estrutura e respostas de uma só vez, da mesma forma que você daria uma olhada em um recibo e saberia o total sem transcrever conscientemente cada caractere primeiro. Essa não é uma ideia nova em 2024, mas o TextMonkey leva isso mais longe em resolução, eficiência e — a parte genuinamente nova — a capacidade de apontar.
Por que imagens de documentos quebram modelos de visão comuns
Os modelos de visão e linguagem foram construídos e ajustados principalmente para fotos: um cachorro na praia, um prato de comida, uma cena de rua. Documentos são uma besta diferente.
Uma foto pode sobreviver sendo comprimida para 224x224 pixels; você ainda consegue dizer que é um cachorro. Uma página de texto financeiro denso comprimida para 224x224 se transforma em uma massa ilegível. Os codificadores de visão padrão foram construídos para um regime de resolução, e os documentos precisam de um completamente diferente: alta resolução, porque o significado de um campo de formulário muitas vezes depende de alguns caracteres pequenos, e informações que estão espalhadas uniformemente pela página em vez de agrupadas em uma região saliente.
Aumentar a resolução de entrada é a solução óbvia, mas isso quebra coisas em outros lugares. Os transformers de visão processam uma imagem dividindo-a em pequenos patches e computando atenção entre eles. Em resoluções mais altas, há muito mais patches, e se cada patch apenas "vê" sua própria vizinhança, o modelo perde o controle de coisas que se estendem por regiões, como uma linha de tabela que vai da borda esquerda à borda direita de um documento largo. Apenas aumentar a resolução sem abordar isso ou perde relacionamentos de longo alcance ou fica proibitivamente caro.
Como o TextMonkey realmente lê uma página
A abordagem do artigo se divide em algumas partes que trabalham em conjunto.
Atenção com Janelas Deslocadas. Em vez de processar toda a imagem de alta resolução como um único cálculo gigante de atenção (caro) ou dividi-la em janelas isoladas e não sobrepostas que não podem se comunicar entre si (perde informações entre janelas), o TextMonkey empresta um truque da arquitetura de visão Swin Transformer: processa a imagem em janelas locais e, em seguida, desloca os limites das janelas na camada seguinte, de modo que as regiões que estavam previamente divididas são agrupadas desta vez. Ao longo de várias camadas, a informação se propaga efetivamente por toda a imagem sem nunca incorrer no custo da atenção global completa. Os autores adicionam um detalhe que importa mais do que parece: eles inicializam com zeros este mecanismo de atenção deslocada, o que significa que, no início do treinamento, ele não contribui com nada e aumenta gradualmente. Isso mantém o treinamento inicial estável, em vez de jogar um mecanismo entre-janelas parcialmente treinado na mistura e esperar que o modelo não diverja.
Eliminação de tokens redundantes. Imagens de documentos de alta resolução, no nível de patch, produzem muitos tokens, e uma grande parte deles é redundante. Pense em uma grande margem em branco ou na mesma textura de fundo repetida em dezenas de patches. O TextMonkey usa um filtro baseado em similaridade para identificar esses tokens de baixa informação e descartá-los antes que eles atinjam as partes caras do modelo. O achado digno de nota: isso não é apenas um truque de velocidade. O artigo relata que a remoção de tokens redundantes realmente melhorou o desempenho, além de tornar o modelo mais rápido, o que sugere que alguns desses tokens "extras" estavam atuando como ruído em vez de sinal.
Detecção de texto e ancoragem como tarefas de treinamento. Esta é a parte que produz o comportamento de apontar. Em vez de treinar o modelo apenas para responder perguntas em texto livre, os autores também o treinam para fazer detecção de texto (encontrar e transcrever texto em locais específicos) e ancoragem (dada uma frase, retornar sua caixa delimitadora). Crucialmente, eles incorporam informações posicionais nas próprias respostas do modelo, de modo que, quando o TextMonkey responde "qual é o total", a resposta pode incluir as coordenadas de onde leu aquela resposta. Isso transforma uma resposta opaca em uma verificável.
Compreensão de capturas de tela por meio de ajuste fino. O modelo também adquire a capacidade de analisar capturas de tela de interfaces de usuário (interfaces de aplicativos, páginas da web) por meio de ajuste fino direcionado, estendendo as mesmas habilidades de leitura de documentos para um domínio visual bastante diferente: esparsos, com layouts pesados, impulsionados por ícones e botões, em vez de parágrafos densos de texto.
Os números e o que eles realmente significam
TextMonkey foi avaliado em 12 benchmarks divididos em três categorias:
- Tarefas centradas em texto de cena (leitura de texto em fotos do mundo real — placas de rua, rótulos de produtos): STVQA, TextVQA, OCRVQA. Melhoria: 5,2%.
- Tarefas orientadas a documentos (documentos estruturados — formulários, infográficos, gráficos, tabelas): DocVQA, InfoVQA, ChartVQA, DeepForm, Kleister Charity, WikiTableQuestions. Melhoria: 6,9%.
- Extração de informações-chave (extração de campos específicos de documentos semi-estruturados — pense em extrair "nome do fornecedor" e "valor devido" de uma fatura): FUNSD, SROIE, POIE. Melhoria: 2,8%.
A categoria orientada a documentos, que apresentou o maior salto (6,9%), está alinhada com a própria abordagem do artigo: é aqui que o tratamento de resolução com janelas deslocadas e o filtro de tokens devem fazer mais diferença, já que formulários densos e tabelas são exatamente onde os modelos anteriores perdiam informações em baixa resolução.
A detecção de texto em cena (encontrar e ler texto disperso em uma foto natural, não em uma digitalização limpa) melhorou em 10,9%, o maior número isolado do artigo. Isso é plausivelmente o retorno direto do treinamento explícito do modelo em tarefas de detecção e ancoragem, em vez de tratar a localização como uma consideração secundária.
No OCRBench, um conjunto abrangente de 29 subtarefas relacionadas a OCR, o TextMonkey obteve 561 pontos, à frente dos grandes modelos multimodais de código aberto anteriores construídos para compreensão de documentos na época. Os números do OCRBench mudam rapidamente neste campo e ficam ultrapassados em um ou dois anos, então considere 561 como "estado da arte em março de 2024" em vez de um ranking permanente, mas a lacuna relativa em relação aos modelos anteriores ainda é informativa sobre o que as escolhas arquiteturais proporcionaram.
Onde isso ainda fica aquém
O artigo não se detém nas limitações, mas algumas lacunas valem a pena ser nomeadas abertamente.
A etapa de filtragem de tokens depende da similaridade para decidir o que é redundante, o que é uma heurística. É plausível que isso ocasionalmente descarte um token de baixa frequência, mas significativo, como um pequeno carimbo ou uma marca d'água tênue que aparece apenas uma vez e não parece "similar" a nada mais na página. O artigo relata ganhos líquidos de desempenho, mas isso é uma média entre benchmarks, não uma garantia contra um caso específico difícil.
A precisão do grounding é tão boa quanto a leitura subjacente. Se o modelo ler incorretamente um dígito, a caixa delimitadora que ele desenha apontará confiantemente para a evidência errada. O grounding lhe dá verificabilidade, não correção. É uma melhoria real em relação ao "confie em mim", mas não é prova.
E os benchmarks aqui ainda são principalmente em inglês, principalmente formatos de documentos ocidentais. Nada no resumo do artigo sugere testes em documentos multilíngues, formulários com muita escrita à mão ou as digitalizações mais bagunçadas que aparecem em backlogs do mundo real (inclinadas, baixo contraste, manchadas de café). O desempenho limpo dos benchmarks e o desempenho bagunçado do mundo real são correlacionados, não idênticos.
Por que isso importa para quem constrói ou compra OCR
Se você está escolhendo um motor de IA de documentos para um produto, a capacidade de grounding (ancoragem) é o aspecto a que deve prestar atenção, mais do que os números brutos dos benchmarks. Um modelo que só consegue retornar "o total é $482,19" não oferece nenhuma maneira de detectar quando ele está errado. Um modelo que retorna o número junto com uma caixa delimitadora (bounding box) permite construir uma interface onde um revisor humano vê a região destacada e pode confirmar ou rejeitar a informação de relance, em vez de ter que reler todo o documento. Para qualquer fluxo de trabalho que envolva dinheiro, contratos ou conformidade, essa diferença é a diferença entre "OCR que você pode verificar aleatoriamente" e "OCR que você precisa confiar cegamente".
Isso também é um dado importante na mudança mais ampla, que se afasta dos pipelines de "OCR e depois análise" em direção a modelos únicos que leem e compreendem em uma única passagem. Essa mudança está aparecendo em muitos dos modelos que acompanhamos, e altera o cálculo para qualquer pessoa que construiu infraestrutura assumindo que a extração de texto por OCR e a compreensão de documentos são etapas separadas, realizadas por ferramentas distintas. Cada vez mais, elas não são, e os modelos que pulam essa transferência estão vencendo nos benchmarks pesados em documentos por um motivo simples: nada se perde na tradução entre a string do OCR e o modelo que a lê.
O ângulo da eficiência de tokens também importa na prática. Se você está executando inferência em larga escala, uma técnica que reduz tokens redundantes e melhora a precisão ao mesmo tempo é rara o suficiente para ser notada: ganhos de eficiência e qualidade geralmente não chegam juntos, e aqui eles chegaram.