لماذا كانت أفضل أداة لتحويل PDF إلى رياضيات قبل Nougat تصيب المعادلات بنسبة أقل من 10% من المرات
استنادًا إلى: Nougat: Neural Optical Understanding for Academic Documents — Lukas Blecher, Guillem Cucurull, Thomas Scialom, Robert Stojnic
تحدي استخراج المعادلات من ملفات PDF
جرب هذا الأمر في وقت ما: افتح ملف PDF لورقة بحثية في الفيزياء، وانسخ معادلة منها، ثم ألصقها في ملف نصي. ما ستحصل عليه ليس معادلة، بل فوضى مبعثرة من الرموز، أحياناً تكون بترتيب خاطئ، وأحياناً يختفي منها خط الكسر أو علامة المجموع تماماً. لقد صُمم تنسيق PDF لوصف مكان وضع الحبر على الصفحة، لا لشرح معنى هذا الحبر. هذا الأمر جيد للقراءة، لكنه كارثي عند محاولة إعادة استخدام المحتوى.
قرر فريق في Meta AI (وهم Lukas Blecher و Guillem Cucurull و Thomas Scialom و Robert Stojnic) مواجهة هذه المشكلة مباشرة عبر نموذج أطلقوا عليه اسم Nougat، وهو اختصار لـ Neural Optical Understanding for Academic Documents. والنتائج التي أعلنوا عنها كانت مذهلة: ففي مجموعة اختبار من أوراق arXiv، حققت أقوى أداة موجودة لاستخراج الرياضيات من ملفات PDF إجابات صحيحة في حوالي 9.7% من الحالات فقط، وفقاً لمقياس F1 score. بينما حقق Nougat نسبة 76.5%. هذا ليس مجرد تحسين بسيط، بل هو الفرق بين أداة "غير صالحة لأي شيء سوى الفقرات النصية البسيطة" وأداة "جيدة بما يكفي للبناء عليها".
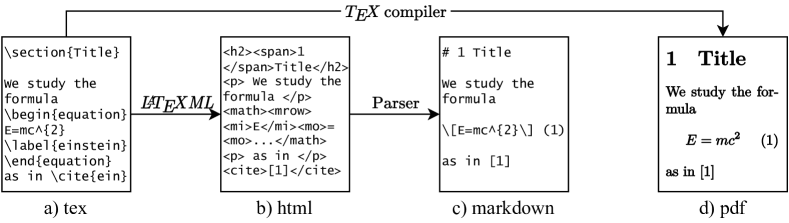
شكل من ورقة Nougat: Neural Optical Understanding for Academic Documents (Blecher et al., arXiv:2308.13418)، مرخصة بموجب CC BY-SA 4.0.
لماذا لا يحتوي ملف الـ PDF فعلياً على النص الذي تعتقد أنه يحتويه
هذا هو الجزء الذي يسبب الارتباك للكثيرين: تبدو صفحة الـ PDF عادةً وكأنها تحتوي على نص، وأحياناً يمكنك حتى تحديد هذا النص ونسخه. لكن ما يتم تخزينه فعلياً هو مجموعة من التعليمات مثل "ارسم رمز (glyph) حرف sigma الصغير عند الإحداثيات (412, 88)". لا يوجد مفهوم يشير إلى أن "هذا الـ sigma هو جزء من عملية summation تمتد عبر ثلاثة أسطر" أو أن "هذه خلية جدول في العمود الثاني". فترتيب القراءة، والبنية، والمعنى، يتم تحويلها جميعاً إلى مجرد كومة من الأشكال الموزعة في مواقع محددة.
بالنسبة لفقرة عادية من النثر الإنجليزي، لا يشكل هذا الأمر مشكلة كبيرة؛ إذ يمكن لأدوات استخراج النصوص من الـ PDF وأدوات OCR الحالية تجميع هذه الرموز مرة أخرى في جمل مقروءة بشكل جيد بما يكفي. لكن الأوراق البحثية الأكاديمية مليئة بعناصر لا تصمد أمام عملية "التسطيح" هذه: مثل الكسور المتداخلة (nested fractions)، والمصفوفات (matrices)، والمعادلات متعددة الأسطر، والجداول ذات الخلايا المدمجة، والخوارزميات التي يحمل فيهاتنسيق الإزاحة (indentation) معنىً دلالياً. إذا طلبت من نظام OCR قياسي أن يعيد لك معادلة LaTeX صالحة من ورقة رياضيات ممسوحة ضوئياً، فغالباً ما ستحصل على نتائج غير مفهومة.
هذه هي الفجوة تحديداً التي يحاول Nougat سدّها: ليس مجرد "قراءة الكلمات الموجودة على الصفحة"، فهذه مشكلة تم حلها بالفعل، بل "إعادة بناء التنسيق (markup) الفعلي الذي كان سيكتبه البشر لإنتاج هذه الصفحة".
لا خطوة OCR، لا صناديق إحاطة (bounding boxes)، مجرد صورة صفحة في المدخلات وتنسيق markup في المخرجات
إن خيار التصميم الذي يجعل Nougat مثيراً للاهتمام هو ما "لا يفعله". فمعظم مسارات معالجة وفهم المستندات تُبنى من عدة مراحل متصلة ببعضها: تحديد أماكن الكتل النصية، ثم تشغيل OCR على كل كتلة، وتحديد الجداول بشكل منفصل، وتشغيل برنامج للتعرف على الصيغ الرياضية لكل ما يبدو كمعادلة، ثم محاولة تجميع كل ذلك مجدداً في مستند متماسك. كل مرحلة من هذه المراحل تقدم أخطاءها الخاصة، وهذه الأخطاء تتراكم وتتضاعف.
يتجاوز Nougat كل ذلك؛ فهو عبارة عن نموذج Visual Transformer واحد يأخذ صورة rasterized لصفحة PDF (يتم رندرتها بدقة 96 DPI، وتغيير حجمها لتناسب صندوقاً ثابتاً بأبعاد 896×672 بكسل) ويخرج تدفقاً من رموز markup مباشرة، رمزاً تلو الآخر، بنفس الطريقة التي يكتب بها النموذج اللغوي النص. ومن الناحية التقنية، يدمج النموذج بين Swin Transformer، وهو نموذج رؤية يعالج الصورة في رقع (patches) هرمية، وبين decoder يعتمد على mBART يقوم بتوليد تسلسل المخرجات مع استخدام cross-attention للرجوع إلى ميزات الصورة أثناء الكتابة. لا يوجد وحدة منفصلة للكشف عن الرياضيات ولا مرحلة لتحليل التخطيط (layout-analysis). ببساطة، ينظر النموذج إلى الصفحة بأكملها ويكتب ما يراه بتنسيق markup خفيف يمكنه التعبير عن العناوين، والنصوص العريضة والمائلة، والخوارزميات، وصيغ LaTeX الرياضية (سواء المضمنة inline أو المستقلة display)، وجداول LaTeX.
تم إصدار حجمين من النموذج: نموذج أساسي (base) بـ 350 مليون parameter مع 10 طبقات decoder، ونموذج أصغر بـ 250 مليون parameter مع 4 طبقات. وكلاهما يقع ضمن نطاق "يمكنك تشغيله على GPU واحد بمواصفات معقولة"، وليس ضمن نطاق النماذج العملاقة (frontier-scale) التي يقصدها الناس عادةً عندما يصفون النموذج بأنه "ضخم" هذه الأيام.
كان عليهم بناء بيانات التدريب قبل بناء النموذج
ربما لم يكن الجزء الأصعب حقاً في هذا المشروع هو البنية الهندسية (architecture)، بل كان إيجاد طريقة للحصول على ملايين الأمثلة التي تجمع بين "صورة الصفحة وعلامات التنسيق (markup) الدقيقة التي أنتجتها"، لأن هذا الربط غير متوفر في أي مكان كمجموعة بيانات جاهزة.
كانت حيلتهم تكمن في أن أوراق arXiv تُقدم بمصدر LaTeX الأصلي، وليس فقط بصيغة PDF النهائية. لذا، قام الفريق بأخذ مصدر LaTeX وتحويله إلى HTML باستخدام أداة تسمى LaTeXML، ثم تحويل هذا الـ HTML إلى تنسيق markup خفيف خاص بهم؛ وبذلك حصلوا على "الحقيقة الأرضية" (ground-truth) لعلامات التنسيق. بعد ذلك، قاموا بتحويل المصدر نفسه إلى PDF وتحويل الصفحات إلى صور (rasterized). وهكذا حصلوا على زوج متطابق: صورة دقيقة، وتنسيق دقيق، دون الحاجة إلى أي تسمية يدوية (manual labeling).
أنتجت هذه العملية معظم بيانات التدريب الخاصة بهم: 7.5 مليون صفحة من 1.7 مليون مقال من arXiv تتوفر لها مصادر LaTeX صالحة. وأضافوا إليها 536,000 صفحة من PubMed Central، تم تحليلها من XML بدلاً من LaTeX، و447,000 صفحة من Industry Documents Library، وهي مستندات ممسوحة ضوئياً بالفعل وليست ملفات PDF رقمية الأصل، وذلك لمنح النموذج بعض التعرض لضجيج الماسحات الضوئية الحقيقي. الإجمالي: حوالي 8.2 مليون زوج من (صفحة-تنسيق). هذا هو الجزء غير "البراق" في الورقة البحثية، ولكنه يظل الجزء الذي جعل بقية العمل ممكناً؛ فالبنية الذكية المدربة على بيانات سيئة تخسر عادةً أمام بنية تقليدية مدربة على كم هائل من الأمثلة المزدوجة بدقة.
النتائج: أداء قوي في النصوص العادية، جيد في الرياضيات، ولا يزال متعثراً في الجداول
في مجموعة اختبار arXiv، بلغت مسافة التعديل (edit distance) الإجمالية لنموذج Nougat حوالي 0.071 (وهي تقريباً عدد عمليات الإدراج والحذف والاستبدال على مستوى الحروف المطلوبة لتحويل مخرجات النموذج إلى الإجابة الصحيحة، حيث تشير القيمة الأقل إلى أداء أفضل)، مع وصول قيمة F1 الإجمالية إلى 93.1% ودرجة BLEU إلى 89.1. وعند تحليل النتائج حسب نوع المحتوى، تصبح الصورة أكثر إثارة للاهتمام:
- النصوص العادية (Plain text): مسافة التعديل 0.058، وF1 بنسبة 95.7%. يمكن القول إن هذه المشكلة قد حُلّت تقريباً.
- الرياضيات (Math): مسافة التعديل 0.128، وF1 بنسبة 76.5%، وBLEU بنسبة 56.9. المهمة هنا أصعب بكثير، لكن النتائج قابلة للاستخدام، وتمثل قفزة هائلة مقارنة بالبدائل الأخرى.
- الجداول (Tables): مسافة التعديل 0.211، وF1 بنسبة 78.0%، وBLEU بنسبة 69.7. هذه هي الفئة الأضعف، وهو ما يظهر بوضوح في التطبيق العملي؛ حيث لا تزال الخلايا المدمجة والتنسيقات غير المنتظمة تسبب ارتباكاً للنموذج.
وللمقارنة، فإن استخراج النصوص مباشرة من طبقة PDF المدمجة (في حال وجودها أصلاً) أعطى مسافة تعديل بلغت 0.255، وهي نتيجة أسوأ من درجة Nougat في الرياضيات وأسوأ بنحو أربع مرات من درجته في النصوص العادية. أما أداة GROBID، المستخدمة على نطاق واسع لتحليل ملفات PDF العلمية، فحتى عند تعزيزها بإضافة LaTeX-OCR مخصصة للمعادلات، لم تصل نسبة F1 في الرياضيات إلا إلى 9.7%. هذه المقارنة هي النتيجة الأبرز في الورقة البحثية بأكملها: لقد كانت عملية تحويل الرياضيات إلى LaTeX قابل للاستخدام معطلة تقريباً في هذا القطاع، وهذا النموذج هو أحد أول النهج التي أحدثت تغييراً ملموساً في هذا الصدد.
عندما يعلق النموذج في حلقة تكرارية
الجزء الأكثر شفافية في الورقة البحثية هو تحليل الإخفاقات، وأبرز نمط للفشل هو ما سيتعرف عليه فوراً أي شخص تعامل مع التوليد ذاتي الانحدار (autoregressive generation): وهو "انهيار التكرار" (repetition collapse). ففي حوالي 1.5% من مجموعة الاختبار، يعلق النموذج في توقع الجملة أو الرمز أو السطر نفسه مراراً وتكراراً، ويرفض الانتقال لما بعده. يحدث هذا غالباً في الصفحات التي تخرج عن نطاق توزيع بيانات التدريب (out of distribution): مثل الصفحات الفارغة غالباً، أو الصفحات ذات التنسيقات غير المعتادة، أو المستندات الممسوحة ضوئياً التي تحتوي على ضجيج (noise) كثيف.
كان حل الفريق عبارة عن حيلة "للكشف والاستعادة" تُطبق وقت الاستنتاج (inference time)، بالإضافة إلى استراتيجية لتعزيز البيانات (data augmentation) أثناء التدريب، حيث يتم تعريض النموذج عمداً لأمثلة تكرارية ومتحللة ليتعلم كيفية الخروج من هذه الحلقات. أدى هذا المزيج إلى خفض معدل التكرار بنسبة 32%. وهو تحسن حقيقي، ولكنه أيضاً اعتراف بأن المشكلة لم تُحل بالكامل. إذا كنت تقيم أداة كهذه لاستخدامها في بيئة إنتاجية، فإن "تعلق النموذج أحياناً بترديد السطر نفسه للأبد" هو بالضبط نوع الفشل الذي تود معرفته مسبقاً، لأنه فشل صامت: لا شيء يتوقف عن العمل، بل تحصل ببساطة على مخرجات عديمة الفائدة تبدو في ظاهرها منطقية.
هناك قيود أخرى تجدر معرفتها: يعالج النموذج صفحة واحدة في كل مرة دون ذاكرة للصفحات الأخرى، لذا قد يصبح الترقيم في المراجع والاقتباسات المرجعية بين الأقسام غير متسق عبر المستندات متعددة الصفحات. كما تم تدريبه بالكامل تقريباً على نصوص إنجليزية، مما يجعل المستندات المكتوبة بنصوص غير لاتينية تؤدي إلى فشله تماماً بدلاً من تراجع أدائه تدريجياً. وتؤدي المستندات الورقية الممسوحة ضوئياً أداءً أسوأ بشكل ملحوظ من ملفات PDF التي تم تنسيقها رقمياً منذ البداية، وهو أمر منطقي بالنظر إلى مدى اعتماد بيانات التدريب على صفحات arXiv النظيفة والرقمية أصلاً. وأخيراً، النموذج بطيء: فعلى وحدة معالجة الرسوميات NVIDIA A10G، استغرق معالجة ست صفحات بالتوازي حوالي 19.5 ثانية لكل دفعة (batch)، بمعدل 1,400 token تقريباً لكل صفحة. في المقابل، يعالج GROBID حوالي 10.6 ملف PDF في الثانية. هذه ليست منافسة متقاربة؛ إذ يضحي Nougat بالكثير من السرعة في سبيل الدقة في الحالات الصعبة.
لماذا يهم هذا الأمر عند بناء أو اختيار مسار عمل لـ OCR
إذا كانت مستنداتك عبارة عن عقود أو فواتير أو نماذج، فإن كل ما سبق لا يهمك بشكل مباشر؛ فقد تم تدريب Nougat بشكل حصري تقريباً على الأوراق البحثية الأكاديمية، وهذا واضح تماماً: فتنسيقات المجلات متعددة الأعمدة، والكتابة اليدوية، والمستندات التجارية تقع خارج نطاق ما صُمم من أجله.
أما إذا كنت تتعامل مع ملفات PDF علمية أو تقنية حيث تحمل المعادلات والجداول وعلامات التنسيق الهيكلية (structured markup) معنىً جوهرياً، فإن الدرس المستفاد من هذه الورقة يتجاوز نموذج Nougat نفسه. إنه إثبات عملي على أن نماذج "الصورة إلى تنسيق" (image-to-markup) المتكاملة (end-to-end) يمكنها التفوق على مسارات العمل المجمعة من OCR مضافاً إليه كاشف للتنسيق (layout detection) ومعرف منفصل للمعادلات، على الأقل بالنسبة للمحتوى التقني المنظم. إن الفجوة بين 9.7% و 76.5% في التعرف على الرياضيات ليست مجرد فرق بسيط بين نهجين متواضعين، بل هي الفرق بين أداة لا يمكنك الوثوق بها أبداً في ورقة بحثية، وأداة يمكنك فعلياً بناء منتج تجاري عليها.
الخلاصة العملية لأي شخص يقيم محركات OCR هي أن "التعامل الجيد مع النصوص" و"التعامل الجيد مع الرياضيات والجداول" هما قدرتان مختلفتان تماماً، وكثير من الموردين سيذكرون لك بكل سرور رقم دقة إجمالي يخفي فجوة هائلة بين الاثنين. وإذا كانت مستنداتك كثيفة المعادلات، فاسأل تحديداً عن أداء المعادلات والجداول، وليس فقط دقة النصوص العامة. كما يجب الانتباه إلى أنماط الفشل مثل "انهيار التكرار" (repetition collapse)؛ فالنموذج الذي يدخل أحياناً في حلقة تكرار لا نهائية عند مواجهة صفحة سيئة يمثل نوعاً من المخاطر يختلف عن النموذج الذي يكون أقل دقة بقليل في المتوسط. وهذا النوع من المشكلات لا يظهر إلا عندما تختبر النموذج على مستنداتك الواقعية والغريبة بدلاً من الاعتماد على مجموعة بيانات قياسية (benchmark set) نظيفة. وتزداد هذه التحديات تعقيداً عند التعامل مع النصوص العربية، نظراً لطبيعة الخط المتصل (cursive) والحروف المتغيرة حسب موقعها في الكلمة، مما يجعل عمليات الـ OCR أكثر صعوبة.