GOT-OCR2.0: نموذج بـ 580 مليون Parameter يقرأ النصوص، والمعادلات، والنوتات الموسيقية، والمخططات
استنادًا إلى: General OCR Theory: Towards OCR-2.0 via a Unified End-to-end Model — Haoran Wei, Chenglong Liu, Jinyue Chen, Jia Wang, Lingyu Kong, Yanming Xu, Zheng Ge, Liang Zhao, Jianjian Sun, Yuang Peng, Chunrui Han, Xiangyu Zhang
سد الفجوة في التعرف الضوئي على الحروف
إذا أدخلت صورة لورقة عمل كيمياء مكتوبة بخط اليد في معظم أدوات OCR، فستحصل على مجموعة من الحروف اللاتينية غير المفهومة في المواضع التي يجب أن تكون فيها الهياكل الجزيئية. وإذا أدخلت صفحة من نوتة موسيقية، فلن تحصل على شيء على الإطلاق، لأن البرمجيات لا تعتبر النوتة الموسيقية "نصاً". هذه هي الفجوة التي سعى مجموعة من الباحثين من StepFun وجامعة الأكاديمية الصينية للعلوم إلى سدها من خلال نموذج يسمى GOT، وهو اختصار لـ General OCR Theory. ويزعم الباحثون أن نموذجاً واحداً يحتوي على 580-million-parameter يمكنه قراءة النصوص العادية، والرياضيات، والصيغ الكيميائية، والجداول، والمخططات، والنوتات الموسيقية، وحتى الأشكال الهندسية، وإخراج كل منها بتنسيق يمكنك استخدامه فعلياً، سواء كان markdown أو LaTeX أو SMILES notation، أو أي تنسيق مناسب.
هذا نطاق واسع جداً بالنسبة لنموذج أصغر من الكثير من روبوتات الدردشة مفتوحة الأوزان (open-weight chatbots). لذا، يستحق الأمر البحث في كيفية تحقيق ذلك، وما إذا كان هذا الادعاء صامداً عند التجربة.
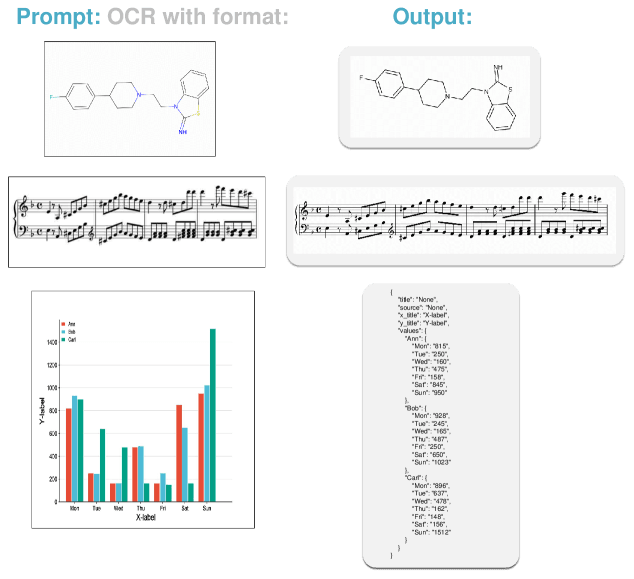
شكل من ورقة General OCR Theory: Towards OCR-2.0 via a Unified End-to-end Model (Wei et al., arXiv:2409.01704)، مرخص بموجب CC BY-SA 4.0.
لماذا لم يعد مجرد "تشغيل الـ OCR" كافياً
تعتمد تقنيات OCR التي اعتاد عليها معظمنا، مثل Tesseract أو برامج الماسحات الضوئية الملحقة بطابعات المكاتب، على تقسيم المستند إلى مراحل: تحديد أماكن وجود النص، ثم قص تلك المناطق، ثم التعرف على الحروف في كل قصاصة، وأخيراً تجميع النتائج وفقاً لترتيب القراءة. تطلق الورقة البحثية على هذا الأسلوب اسم OCR-1.0، وقد كان كافياً لعقود من الزمن للتعامل مع النصوص الإنجليزية المطبوعة على خلفية بيضاء.
لكن هذا النظام ينهار في اللحظة التي يتوقف فيها "النص" عن كونه مجرد جمل بسيطة. فالجدول ليس مجرد نص، بل هو نص يتضمن علاقات بين الصفوف والأعمدة تضيع بمجرد تحويله إلى تدفق من الحروف. كما أن مخططات الهياكل الكيميائية تشفر روابط وأشكال حلقات لا يوجد لها تمثيل على مستوى الحروف على الإطلاق. أما النوتات الموسيقية فهي رموز تعبر عن طبقة الصوت ومدته، مرتبة بطريقة لا يمكن لأي ترتيب قراءة سطر بسطر أن يستوعبها. إن خطوط المعالجة متعددة المراحل المصممة للغة الإنجليزية (سطراً بسطر) لا تتكيف جيداً مع هذه الحالات؛ مما أدى إلى ظهور نظام تعرف مخصص لكل نوع من المحتوى. وبناءً على ذلك، تجد الشركة التي تحتاج إلى رقمنة الفواتير والكتب المدرسية والأوراق العلمية نفسها مضطرة لتشغيل ثلاثة أنظمة متخصصة ومنفصلة، لكل منها مشكلاته الخاصة، وفترات تأخير (latency)، وتكاليف دمج مختلفة.
أما البديل الأحدث فهو دمج OCR في نموذج لغوي كبير متعدد الوسائط مثل GPT-4V، والتعامل مع العملية برمتها كطلب "وصف لما يوجد في هذه الصورة". هذا الحل يعمل بشكل عام، ولكن نماذج الرؤية واللغة العامة لم يتم تدريبها بهدف الوصول إلى دقة OCR، لذا فهي تميل إلى "الهلوسة" (hallucinate) عند التعامل مع النصوص الكثيفة، وتتعثر في المستندات الطويلة جداً، وتستهلك قدرات حوسبة لكل صفحة أكبر بكثير مما يحتاجه نظام تعرف مصمم لهذا الغرض.
وهنا يأتي طرح GOT كمسار وسط: فهو مصمم خصيصاً للقراءة، ولكنه موحد عبر جميع أنواع المحتوى، ويعمل بنظام "من الطرف إلى الطرف" (end-to-end) بدلاً من كونه سلسلة من الوحدات المدربة بشكل منفصل.
كيف يعمل GOT فعلياً: عين صغيرة وقارئ أكبر
من الناحية المعمارية، يتميز GOT ببساطة منعشة: مشفر صور (image encoder) يغذي مفكك نصوص (text decoder). لا توجد مرحلة كشف (detection)، ولا مرحلة تعرّف منفصلة، ولا محلل لاحق (downstream parser) لربط الأجزاء ببعضها. مجرد عملية تمرير أمامية واحدة (forward pass)؛ تدخل الصورة، ويخرج النص.
يعد المشفر هو الجزء الأكثر إثارة للاهتمام؛ فهو عبارة عن vision transformer يحتوي على حوالي 80 مليون معامل (parameter)، تم تهيئته بناءً على نموذج Segment Anything Model من Meta. يقوم المشفر باستقبال صورة بدقة 1024x1024 وضغطها إلى 256 رمزاً (tokens) فقط قبل تسليمها إلى مفكك النصوص. وتعتبر هذه نسبة ضغط عالية جداً بالنظر إلى كثافة المعلومات في صفحة كاملة من كتاب ممسوح ضوئياً مثلاً. الرهان الذي يراهن عليه المؤلفون هو أن صورة المستند، مهما بلغت تعقيداتها البصرية، لا تحتاج إلى تمثيل بمليارات البكسلات بمجرد تحديد الأشكال الجوهرية اللازمة لقراءتها. وبالمقارنة، سيفشل أي مشفر رؤية تقليدي مخصص لفهم المشاهد (scene-understanding) إذا حاول ضغط صورة لشارع مزدحم إلى هذا العدد القليل من الرموز دون فقدان العناصر الموجودة فيها. يبدو أن المستندات قابلة للضغط بشكل أنظف من مشاهد الشوارع.
أما مفكك النصوص، فهو نموذج لغوي يحتوي على حوالي 500 مليون معامل مبني على Qwen، ومزود بنافذة سياق (context window) طويلة لتمكينه من استيعاب صفحة كاملة من النص المستخرج دون أن يفقد تتبع الفقرة الأولى عند وصوله إلى الفقرة الأخيرة.
تتم عملية التدريب على ثلاث مراحل. أولاً، يتم تدريب المشفر مسبقاً مع مفكك نصوص صغير ومؤقت لتعليمه كيفية رؤية الأشياء التي تتخذ شكل النصوص. بعد ذلك، يتم دمج مفكك النصوص الحقيقي وتدريب الاثنين معاً على مجموعة متنوعة وواسعة من المستندات. وأخيراً، يتم ضبط النظام بالكامل (fine-tuned) لكل مهمة على حدة، باستخدام مطالبات (prompts) مختلفة لتغيير السلوك؛ سواء كان ذلك لاستخراج نص بسيط، أو جداول بتنسيق markdown، أو صيغ LaTeX للمعادلات، أو سلاسل SMILES للجزيئات. تعمل المطالبة هنا بمثابة "مفتاح وضع التشغيل": نفس الأوزان، ولكن بتعليمات مختلفة وتنسيق مخرجات مختلف.
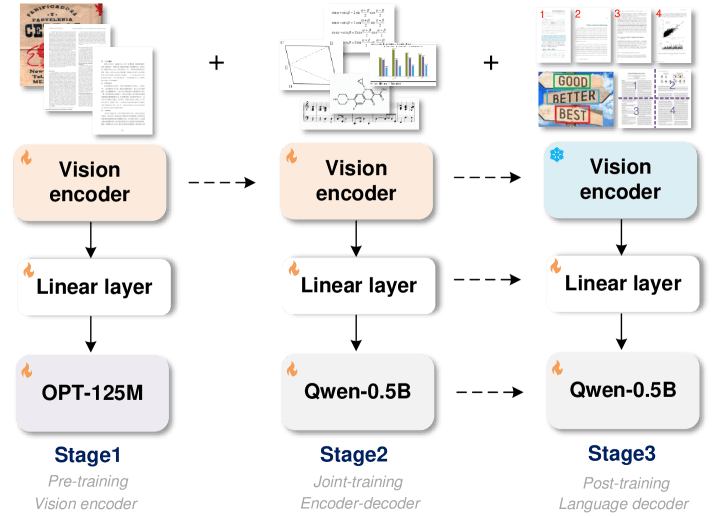
شكل من General OCR Theory: Towards OCR-2.0 via a Unified End-to-end Model (هاوران وي وآخرون، arXiv:2409.01704)، مرخص بموجب CC BY-SA 4.0.
قراءة إيصال شراء مقابل قراءة كتاب كيمياء
هناك تفصيل أعجبني: يدعم GOT ما يسميه المؤلفون "التعرف الضوئي التفاعلي على الحروف" (interactive OCR). حيث يمكنك تحديد منطقة معينة عبر الإحداثيات أو اللون، وتطلب من النموذج قراءة هذا الجزء فقط. قد تبدو هذه ميزة بسيطة، لكنها تشكل الفرق بين "استخراج كل شيء والأمل في أن يحدد محلل التنسيق (layout parser) الحدود بشكل صحيح" وبين "إخبار النموذج بما تريده بالضبط والحصول عليه فقط". وأي شخص حاول استخراج بند واحد من فاتورة مزدحمة يعرف مدى تكرار إشارة الاستخراج القائم على التنسيق إلى المربع الخطأ.
كما يتعامل النموذج مع المستندات التي لا يمكن استيعابها بنظرة واحدة؛ حيث يتم تفعيل "الدقة الديناميكية" (Dynamic resolution) للصور ذات الأحجام الكبيرة، مثل الملصقات والرسومات الهندسية، أو أي شيء كبير جداً بحيث لا يمكن تقليل حجمه دون فقدان وضوح القراءة، وذلك عن طريق تقسيم الصورة إلى مربعات (tiling) ومعالجة كل جزء على حدة قبل دمج النتائج. أما خاصية الـ OCR متعدد الصفحات، فتتيح لك إدخال عدة صفحات في وقت واحد والحصول على مخرج واحد متناسق، بدلاً من تجميع مخرجات كل صفحة يدوياً والأمل في ألا تؤدي فواصل الصفحات إلى تقسيم الجملة الواحدة.
لم يتطلب أي من هذا نظريات جديدة غريبة، بل تطلب بيانات تدريب لم يكلف أحد نفسه عناء بنائها: مستندات اصطناعية تم إنشاؤها بواسطة LaTeX و HTML للرياضيات والجداول، وصور نصوص من المشاهد الحقيقية (scene-text) للافتات الشوارع وملصقات المنتجات، بالإضافة إلى نوتات موسيقية ومخططات جزيئية مولدة ومقترنة بحقيقتها الرمزية (symbolic ground truth). إن بناء مجموعة تدريب متطابقة للمخططات الكيميائية والنوتات الموسيقية هو عمل شاق وغير جذاب، ومن المرجح أن يكون هو "المفتاح الحقيقي" للنجاح هنا أكثر من أي خدعة معمارية منفردة.
ماذا تقول النتائج، وأين يجب أن نبقى متشككين
فيما يخص معايير قياس OCR القياسية، تشير الورقة البحثية إلى تفوق GOT على نماذج الرؤية واللغة (vision-language models) العامة والأكبر حجماً، بما في ذلك أنظمة تحتوي على عدة مليارات من المعلمات (parameters)، رغم أن GOT يمتلك 580 مليون معلمة فقط. هذه نتيجة حقيقية تستحق الاهتمام: نموذج متخصص بجزء بسيط من المعلمات يتفوق على "العمالقة" العامين في المهمة المحددة المتمثلة في قراءة المستندات بدقة. وهذا يتماشى مع درس تعلمه مجال OCR مراراً وتكراراً: النموذج الذي يتم تدريبه بشكل شامل (end-to-end) لمهمة ضيقة ومحددة بدقة يميل إلى التفوق على نموذج أكبر بكثير يجيد كل شيء باستثناء تلك المهمة.
أما بالنسبة للمخرجات المنسقة، مثل الجداول بصيغة markdown، والمعادلات بصيغة LaTeX، والجزيئات بصيغة SMILES، تفيد الورقة بأن GOT صمد بشكل جيد أمام الأدوات المخصصة أحادية الغرض والمصممة خصيصاً لواحدة من هذه المهام. إن القدرة على معالجة كل هذه الأنواع من خلال نموذج واحد، دون الحاجة إلى موجه (router) يقرر أي متخصص يتم استدعاؤه، هي الادعاء الرئيسي هنا، وأرقام القياس تدعم ذلك في الحالات التي تم اختبارها.
لكن هناك نقاط كانت الورقة صريحة بشأنها، وهي نقاط تستحق التنبيه لكل من يفكر في اعتماد هذا النموذج في بيئة إنتاجية: الأداء في الاختبارات على مجموعات بيانات منقحة لا يضمن بالضرورة نفس النتائج مع المستندات "الفوضوية" التي تظهر في العالم الحقيقي، مثل الإيصالات الملطخة بالقهوة، أو النماذج المرسلة عبر الفاكس، أو الصور الملتقطة بزاوية مائلة تحت إضاءة سيئة. كما أن نتائج النموذج في نصوص المشاهد (scene-text) كانت أضعف من نتائجه في صور المستندات، وهو ما يتوافق مع نمط شائع في مجال OCR بشكل عام: مسوحات المستندات النظيفة والمضاءة جيداً هي الحالة السهلة، بينما تظل صور النصوص في العالم المادي هي الحالة الصعبة التي تتحسن ببطء عاماً بعد عام. وأخيراً، فإن النموذج المبني حول مجموعة ثابتة من تنسيقات المخرجات (markdown, LaTeX, SMILES, kern notation للموسيقى) سيحتاج إلى إعادة تدريب أو ضبط دقيق (fine-tuning) لإضافة نوع محتوى جديد؛ فهو نموذج موحد، لكنه ليس قابلاً للتوسع بشكل غير محدود تلقائياً.
لماذا يهم هذا الأمر سواء كنت تبني نظام OCR أو تشتريه
إذا كنت بصدد تقييم محركات OCR لمنتج فعلي، فإن الاستنتاج العملي ليس مجرد أن "GOT هو المحرك الأفضل"، بل فيما يثبته GOT حول توجه هذا المجال: وهو أن النماذج المتكاملة (end-to-end) والمصممة لغرض محدد يمكنها مضاهاة أو حتى التفوق على الأنظمة العامة الأكبر حجماً في فهم المستندات، وبجزء بسيط من تكلفة الحوسبة. وهذا يؤثر بشكل مباشر على تكلفة الصفحة الواحدة وزمن الاستجابة (latency)، وكلاهما يمثلان بنود تكلفة حقيقية إذا كنت تعالج آلاف المستندات يومياً.
كما يؤكد هذا الأمر حقيقة تستحق التذكر عند المقارنة بين المحركات: وهي أن "OCR" ليس مهمة واحدة بسيطة. فالأداة التي تتفوق في قراءة الفواتير المطبوعة باللغة الإنجليزية قد تكون متواضعة الأداء في التعامل مع النماذج المكتوبة بخط اليد، أو الجداول، أو التدوينات العلمية، وغالباً ما تظهر هذه الفجوة فقط عندما تختبر نوع المستندات الذي تحتاجه فعلياً. وتبرز هذه التحديات بشكل أكبر في النصوص العربية نظراً لطبيعة الخط المتصل، وتغير أشكال الحروف حسب موقعها في الكلمة، مما يزيد من تعقيد عملية التعرف الضوئي. لذا، فإن نهج GOT الموحد في التعامل مع النصوص والجداول والمعادلات والتدوينات المتخصصة يعد تذكيراً مفيداً بضرورة اختبار أي محرك OCR، بما في ذلك هذا المحرك، مقابل المستندات الفعلية التي تتعامل معها شركتك، وليس فقط بناءً على معايير قياس عامة؛ فالموديل الذي يتصدر قائمة التصنيف في النصوص المطبوعة قد يفشل تماماً في التعامل مع إيصالاتك الخاصة أو عقودك الممسوحة ضوئياً.
ومن الناحية العملية: إذا كانت سلسلة معالجة البيانات لديك تحتاج إلى التعامل مع مستندات ذات محتوى مختلط (نصوص عادية، جداول، ومعادلات من حين لآخر)، فإن نموذجاً موحداً واحداً مثل GOT يكون أبسط من الناحية الهيكلية في التكامل، بدلاً من تجميع محرك OCR للنصوص، ومستخرج للجداول، ومعرّف للمعادلات عبر ثلاث واجهات برمجة تطبيقات (APIs) مختلفة وثلاثة أنماط مختلفة من احتمالات الفشل. فكلما قلت الأجزاء المتحركة، قلت نقاط الضعف التي قد تؤدي إلى تعطل نظام الإنتاج.