GOT-OCR2.0: Um Modelo de 580M de Parâmetros Que Lê Texto, Fórmulas, Partituras e Gráficos
Baseado em: General OCR Theory: Towards OCR-2.0 via a Unified End-to-end Model — Haoran Wei, Chenglong Liu, Jinyue Chen, Jia Wang, Lingyu Kong, Yanming Xu, Zheng Ge, Liang Zhao, Jianjian Sun, Yuang Peng, Chunrui Han, Xiangyu Zhang
Superando as limitações do OCR tradicional
Se você inserir a foto de uma folha de exercícios de química escrita à mão na maioria das ferramentas de OCR, obterá um amontoado de caracteres latinos incompreensíveis onde deveriam estar as estruturas moleculares. Se inserir uma página de partitura musical, não obterá nada, pois, para o software, partituras não são "texto". Essa é a lacuna que um grupo de pesquisadores da StepFun e da University of Chinese Academy of Sciences buscou preencher com um modelo chamado GOT, abreviação de General OCR Theory. A promessa deles: um único modelo de 580 milhões de parâmetros capaz de ler texto simples, matemática, fórmulas químicas, tabelas, gráficos, partituras e até formas geométricas, exportando cada um em um formato utilizável — seja markdown, LaTeX, notação SMILES ou o que for mais adequado.
É um escopo bastante amplo para algo menor do que muitos chatbots de pesos abertos. Vale a pena investigar como isso funciona e se a promessa se sustenta.
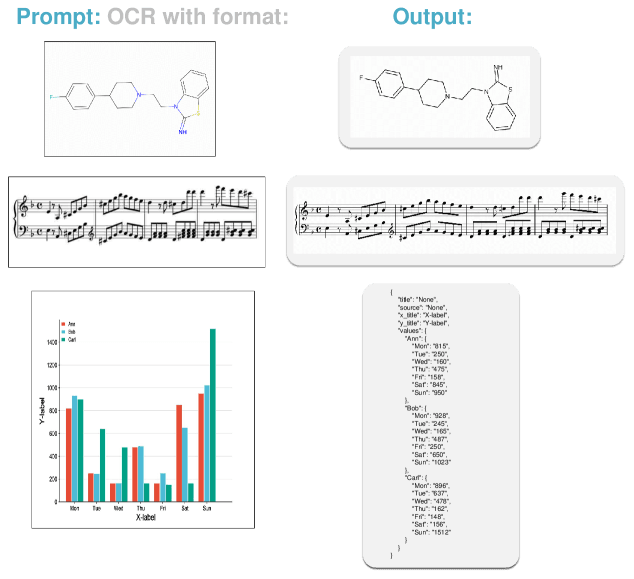
Figura de General OCR Theory: Towards OCR-2.0 via a Unified End-to-end Model (Wei et al., arXiv:2409.01704), licenciada sob CC BY-SA 4.0.
Por que "apenas rodar o OCR" deixou de ser suficiente
O OCR com o qual a maioria de nós cresceu — pense no Tesseract ou nos softwares de scanner que vêm com impressoras de escritório — funciona dividindo um documento em etapas: detectar onde o texto está, recortar essas regiões, reconhecer os caracteres em cada recorte e, então, costurar os resultados na ordem de leitura. O artigo chama isso de OCR-1.0, e isso foi suficiente para textos em inglês digitados em fundo branco por décadas.
No entanto, esse modelo falha no momento em que "texto" deixa de significar frases simples. Uma tabela não é apenas texto; ela possui relações de linhas e colunas que se perdem no instante em que você a achata em um fluxo de caracteres. Um diagrama de estrutura química codifica ligações e formas de anéis que não possuem representação em nível de caractere. Partituras musicais são símbolos com altura e duração, organizados de uma forma que nenhuma ordem de leitura linha por linha consegue capturar. Pipelines de múltiplas etapas, construídos para o inglês linha por linha, não se adaptam bem a isso. Cada tipo de conteúdo acabou tendo seu próprio sistema de reconhecimento sob medida; assim, uma empresa que precisa digitalizar faturas, livros didáticos e artigos científicos acaba operando três sistemas especializados distintos, cada um com seus próprios bugs, latência e custos de integração.
A alternativa mais recente é acoplar o OCR a um modelo de linguagem multimodal robusto, como o GPT-4V, tratando tudo como "descreva o que está nesta imagem". Isso funciona de maneira geral, mas modelos de visão e linguagem de propósito geral não foram treinados com a precisão de OCR como alvo. Por isso, eles tendem a alucinar em textos densos, travar em documentos muito longos e custar muito mais processamento por página do que um reconhecedor dedicado exigiria.
A proposta do GOT é um caminho intermediário: construído especificamente para a leitura, mas unificado entre diferentes tipos de conteúdo, e operando de ponta a ponta (end-to-end) em vez de ser uma cadeia de módulos treinados separadamente.
Como o GOT realmente funciona: um olho pequeno e um leitor maior
Arquiteturalmente, o GOT é refrescantemente simples: um encoder de imagem alimenta um decoder de texto. Sem etapa de detecção, sem etapa de reconhecimento separada, sem um parser posterior para costurar as partes. Um único forward pass: imagem entra, texto sai.
O encoder é a parte mais interessante. Trata-se de um vision transformer de aproximadamente 80 milhões de parâmetros, inicializado a partir do Segment Anything Model da Meta, que recebe uma imagem de 1024x1024 e a comprime em apenas 256 tokens antes de passá-los ao decoder. Essa é uma taxa de compressão alta para a densidade de informações de, por exemplo, a página completa de um livro escaneado. A aposta dos autores é que a imagem de um documento, por mais complexa que seja visualmente, não precisa de uma representação equivalente a bilhões de pixels assim que as formas essenciais para a leitura são identificadas. Compare isso com o quanto um encoder de visão típico para compreensão de cenas ficaria defasado ao tentar comprimir a foto de uma rua movimentada em tão poucos tokens sem perder os objetos nela contidos. Documentos, aparentemente, comprimem de forma mais limpa do que cenas urbanas.
O decoder é um modelo de linguagem de aproximadamente 500 milhões de parâmetros baseado no Qwen, dotado de uma janela de contexto longa para que possa reter uma página inteira de texto extraído sem perder o fio do primeiro parágrafo ao chegar ao último.
O treinamento ocorre em três etapas. Primeiro, o encoder é pré-treinado junto a um decoder pequeno e descartável, apenas para ensiná-lo a reconhecer formas semelhantes a texto. Em seguida, o decoder real é acoplado e ambos são treinados juntos em um mix amplo de documentos. Por fim, todo o sistema passa por um fine-tuning por tarefa, utilizando diferentes prompts para alternar o comportamento: extração de texto simples, tabelas formatadas em markdown, LaTeX para fórmulas ou strings SMILES para moléculas. O prompt funciona efetivamente como a chave de modo: mesmos pesos, instruções diferentes, formato de saída diferente.
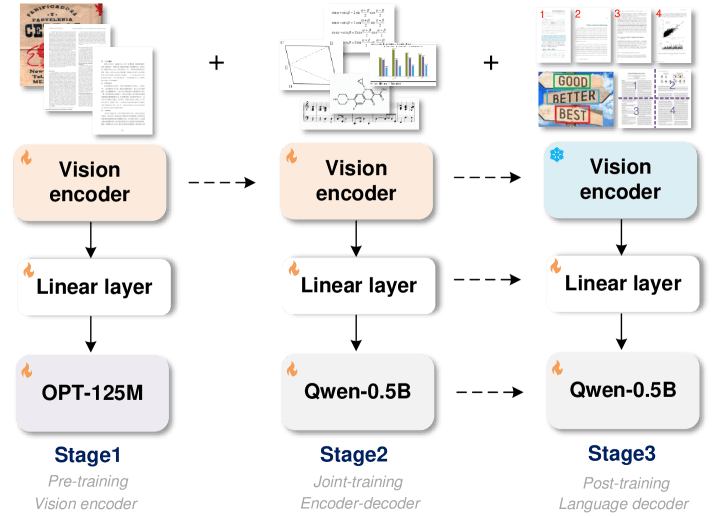
Figura de General OCR Theory: Towards OCR-2.0 via a Unified End-to-end Model (Haoran Wei et al., arXiv:2409.01704), licenciada sob CC BY-SA 4.0.
Ler um recibo versus ler um livro de química
Um detalhe que eu gosto: o GOT suporta o que os autores chamam de OCR interativo. Você pode apontar para uma região por coordenadas, ou por cor, e pedir ao modelo para ler apenas aquela parte. Isso parece um recurso pequeno, mas é a diferença entre "extrair tudo e torcer para que o layout parser acerte os limites" e "dizer ao modelo exatamente o que você quer e receber apenas aquilo de volta". Qualquer pessoa que já tenha tentado extrair um único item de uma fatura poluída sabe com que frequência a extração baseada em layout aponta para a caixa errada.
O modelo também lida com documentos que não cabem em um único olhar. A resolução dinâmica entra em ação para imagens superdimensionadas, pôsteres, desenhos de engenharia ou qualquer coisa grande demais para sofrer downsample sem perder a legibilidade, dividindo a imagem em blocos (tiling) e processando as partes separadamente antes de mesclar os resultados. Além disso, o OCR de múltiplas páginas permite inserir várias páginas de uma vez e obter uma saída coerente, em vez de você mesmo ter que colar as saídas de cada página e torcer para que as quebras de página não cortem uma frase ao meio.
Nada disso exigiu teorias exóticas e novas. Exigiu dados de treinamento que ninguém tinha se dado ao trabalho de construir: documentos sintéticos renderizados a partir de LaTeX e HTML para matemática e tabelas, imagens de scene-text para placas de rua e rótulos de produtos, além de partituras e diagramas moleculares gerados e pareados com sua ground truth simbólica. Construir um conjunto de treinamento correspondente para diagramas de química e partituras é um trabalho ingrato, e é plausivelmente o verdadeiro "estalo" aqui, mais do que qualquer truque arquitetural isolado.
O que os resultados revelam e onde manter o ceticismo
Nos benchmarks padrão de OCR, o artigo relata que o GOT supera modelos de visão-linguagem generalistas maiores, incluindo sistemas com vários bilhões de parâmetros, apesar de o GOT possuir apenas 580 milhões. Este é um resultado real e digno de atenção: um modelo especialista com uma fração dos parâmetros superando "pesos-pesados" generalistas na tarefa específica de ler documentos com precisão. Isso corrobora algo que a área de OCR tem aprendido repetidamente: um modelo treinado de ponta a ponta para uma tarefa estreita e bem definida tende a vencer um modelo muito maior que é bom em tudo, exceto naquela tarefa.
Em relação a saídas formatadas — tabelas mantidas como markdown, fórmulas em LaTeX e moléculas em SMILES — o artigo relata que o GOT se sai bem frente a ferramentas dedicadas de propósito único, construídas exatamente para uma dessas tarefas. A capacidade de lidar com todas elas em um único modelo, sem a necessidade de um roteador para decidir qual especialista chamar, é a principal promessa, e os números dos benchmarks a sustentam nos casos testados.
O que o artigo admite honestamente, e que vale a pena destacar para quem considera a implementação em produção: o desempenho em benchmarks com conjuntos de teste curados não garante o mesmo resultado em documentos genuinamente caóticos do mundo real — recibos manchados de café, formulários enviados por fax ou fotos tiradas em ângulo sob iluminação precária. Os próprios resultados de scene-text do artigo são inferiores aos de document-image, o que segue um padrão observado em todo o campo de OCR: digitalizações de documentos limpas e bem iluminadas são o caso fácil, enquanto fotos de texto no mundo físico são o caso difícil que apresenta melhorias lentas, ano após ano. Além disso, um modelo construído em torno de um conjunto fixo de formatos de saída (markdown, LaTeX, SMILES, notação kern para música) precisará de retreinamento ou fine-tuning para adicionar um novo tipo de conteúdo. Ele é unificado, mas não infinitamente extensível de forma nativa.
Por que isso é importante se você está desenvolvendo ou adquirindo OCR
Se você está avaliando engines de OCR para um produto real, a conclusão prática não é que "o GOT é a melhor engine", mas sim o que o GOT demonstra sobre a direção em que a área está caminhando: modelos end-to-end, construídos para propósitos específicos, podem igualar ou superar sistemas de propósito geral muito maiores na compreensão de documentos, com uma fração do custo computacional. Isso impacta diretamente o custo por página e a latência, ambos itens reais de despesa se você processa milhares de documentos por dia.
Isso também valida algo importante de se lembrar ao comparar engines: "OCR" não é uma tarefa única. Uma ferramenta excelente para faturas digitadas em inglês pode ser medíocre em formulários manuscritos, tabelas ou notações científicas, e essa lacuna geralmente só aparece quando você testa o tipo específico de documento de que realmente precisa. A abordagem unificada do GOT para texto, tabelas, fórmulas e notações especializadas é um lembrete útil para testar qualquer engine de OCR, inclusive esta, com os documentos reais que sua empresa manipula, e não apenas com um benchmark genérico. Um modelo que lidera um ranking de texto impresso ainda pode falhar nos seus recibos específicos ou nos seus contratos digitalizados.
E, na prática: se o seu pipeline precisa lidar com documentos de conteúdo misto — texto simples, tabelas e a fórmula ocasional —, um modelo unificado como o GOT é arquiteturalmente mais simples de integrar do que costurar uma engine de OCR de texto, um extrator de tabelas e um reconhecedor de fórmulas com três APIs diferentes e três modos de falha distintos. Menos peças móveis geralmente significam menos pontos de quebra em um pipeline de produção.