GOT-OCR2.0:テキスト、数式、楽譜、チャートを読み取る580Mパラメータモデル
元論文: General OCR Theory: Towards OCR-2.0 via a Unified End-to-end Model — Haoran Wei, Chenglong Liu, Jinyue Chen, Jia Wang, Lingyu Kong, Yanming Xu, Zheng Ge, Liang Zhao, Jianjian Sun, Yuang Peng, Chunrui Han, Xiangyu Zhang
OCRの限界を突破する:General OCR Theory (GOT)
手書きの化学ワークシートの写真を一般的なOCRツールに読み込ませると、分子構造があるべき場所に意味不明なラテン文字が並んだだけの結果になるでしょう。また、楽譜のページを読み込ませても、ソフトウェアにとって楽譜は「テキスト」ではないため、何も出力されません。StepFunと中国科学院大学の研究チームは、このギャップを埋めるために「GOT(General OCR Theory)」と呼ばれるモデルを開発しました。彼らが主張するのは、わずか580-million-parameterのモデルひとつで、プレーンテキスト、数式、化学式、表、チャート、楽譜、さらには幾何学図形までを読み取り、markdownやLaTeX、SMILES notationなど、用途に応じた適切なフォーマットで出力できるということです。
多くのオープンウェイトのチャットボットよりも小規模なモデルでありながら、カバー範囲は非常に広範です。どのようにしてこれを実現したのか、そして実際に機能するのかを詳しく掘り下げてみましょう。
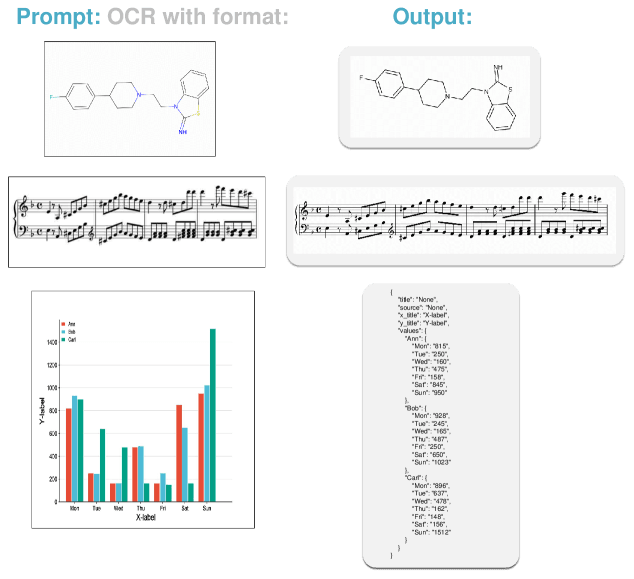
図は General OCR Theory: Towards OCR-2.0 via a Unified End-to-end Model (Wei et al., arXiv:2409.01704) より引用。ライセンスは CC BY-SA 4.0。
「単にOCRにかければいい」では不十分になった理由
Tesseractやオフィス用プリンターに付属しているスキャナーソフトなど、私たちが慣れ親しんできたOCRは、ドキュメントをいくつかの段階に分けて処理します。まずテキストが存在する場所を検出し、その領域を切り出し、切り出した各部分の文字を認識し、最後にそれらの結果を読書順に繋ぎ合わせるという流れです。論文ではこれをOCR-1.0と呼んでおり、白い背景にタイピングされた英語テキストであれば、数十年にわたり十分な性能を発揮してきました。
しかし、「テキスト」が単なる文章ではなくなった瞬間、この手法は破綻します。例えば表は単なるテキストではなく、行と列の関係性を持っており、文字のストリームとして平坦化してしまった瞬間にその構造は失われます。化学構造式は結合や環状構造をエンコードしていますが、これらは文字レベルの表現が全く存在しません。楽譜は音高や音長を持つ記号であり、行ごとの読書順では捉えきれない形式で配置されています。行単位の英語向けに構築された多段階パイプラインは、こうした多様な形式に柔軟に対応できません。結果として、コンテンツの種類ごとに専用の認識システムを構築することになり、請求書、教科書、学術論文をデジタル化したい企業は、それぞれにバグやレイテンシ、統合コストを抱えた3つの別々の専門システムを運用せざるを得なくなりました。
より最近の代替案は、GPT-4Vのような大規模マルチモーダル言語モデルにOCR機能を組み込み、全体を「この画像に何が書いてあるか説明せよ」というタスクとして扱う方法です。これは汎用的な意味では機能しますが、汎用的なVision-LanguageモデルはOCRレベルの精度を目標に訓練されていないため、高密度なテキストでハルシネーションを起こしたり、非常に長いドキュメントで処理が停滞したりする傾向があります。また、専用の認識器に比べて1ページあたりの計算コストがはるかに高くなります。
GOTが提案するのはその中間道です。すなわち、「読み取り」に特化しつつ、コンテンツの種類を問わず統合されており、個別に訓練されたモジュールの連鎖ではなくエンドツーエンドで動作するアプローチです。
GOTの仕組み:小さな「眼」と大きな「読解器」
GOTのアーキテクチャは驚くほどシンプルです。画像エンコーダーがテキストデコーダーに情報を送るという構成になっています。検出ステージや個別の認識ステージはなく、後段でそれらを繋ぎ合わせるパーサーも存在しません。1回のフォワードパスで、画像を入力すればテキストが出力されます。
より興味深いのはエンコーダー側です。これはMetaのSegment Anything Modelで初期化された、約8,000万パラメータのVision Transformerです。1024x1024の画像を取り込み、デコーダーに渡す前にわずか256個のトークンまで圧縮します。スキャンした本の1ページ分のような情報密度に対して、これは非常に高い圧縮率です。著者らが賭けているのは、「ドキュメント画像は、視覚的にどれほど複雑であっても、読み取りに必要な形状さえ抽出できれば、数十億ピクセル分もの表現力は必要ない」ということでしょう。これは、賑やかな街角の写真などを同様に少数のトークンに圧縮しようとして、中の物体を消失させてしまう一般的なシーン理解用エンコーダーとは対照的です。どうやらドキュメントは、街中の風景よりも効率的に圧縮できるようです。
デコーダーはQwenをベースにした約5億パラメータの言語モデルで、長いコンテキストウィンドウを備えています。これにより、抽出したテキストが1ページ分に及んでも、最後の段落に到達するまでに最初の段落の内容を見失うことがありません。
学習は3つのステージで行われます。まず、エンコーダーに「テキストのような形状」を認識させるため、使い捨ての小さなデコーダーと共に事前学習を行います。次に、本番用のデコーダーを結合し、多種多様なドキュメントを用いて両者を同時に学習させます。最後に、タスクごとのファインチューニングを行います。ここではプロンプトを使い分けることで、プレーンテキストの抽出、Markdown形式の表、数式用のLaTeX、分子構造用のSMILES文字列といった動作の切り替えを行います。つまり、プロンプトが実質的なモードスイッチとなっており、同じ重みを用いながら、指示を変えることで出力形式を制御しているのです。
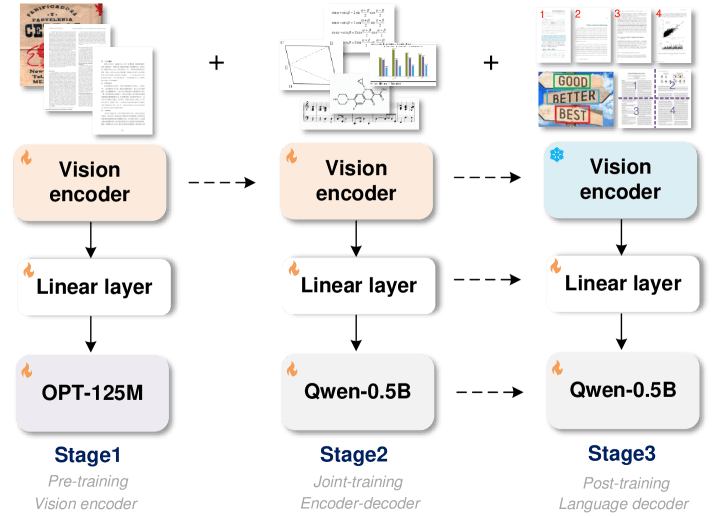
General OCR Theory: Towards OCR-2.0 via a Unified End-to-end Model(Haoran Wei 他、arXiv:2409.01704)の図、CC BY-SA 4.0 ライセンス。
レシートの読み取りと化学教科書の読み取りの違い
私が気に入っている点の一つに、著者らが「インタラクティブOCR」と呼ぶ機能への対応があります。座標や色で特定の領域を指定し、モデルにその部分だけを読み取るよう指示できるのです。これは些細な機能に聞こえるかもしれませんが、「すべてを抽出してレイアウト解析が正しく境界を判定してくれることを願う」のと、「モデルに欲しいものを正確に伝え、それだけを受け取る」のとでは大きな差があります。乱雑な請求書からたった一行の項目を抽出しようとして、レイアウトベースの抽出が誤ったボックスを指してしまうもどかしさを経験したことがある人なら、この価値がわかるはずです。
また、このモデルは一目で収まらないサイズのドキュメントにも対応しています。巨大な画像やポスター、設計図など、単純にダウンサンプリングすると可読性が失われるものに対しては「ダイナミック解像度」が機能します。これは画像をタイル状に分割して個別に処理し、後で結果を統合する仕組みです。さらに、マルチページOCRによって、複数ページを一度に入力して一貫した出力を得ることができます。ページごとの出力を自分で繋ぎ合わせ、ページ区切りで文章が途切れていないか祈る必要はありません。
これらの実現に、何か特殊な新理論が必要だったわけではありません。必要だったのは、これまで誰も手間をかけて構築してこなかった学習データです。数式や表のためのLaTeXおよびHTMLからレンダリングされた合成ドキュメント、道路標識や製品ラベルなどのシーンテキスト画像、そしてシンボリックな正解データとペアになった楽譜や分子構造図の生成データです。化学図表や楽譜の整合性のあるトレーニングセットを構築することは地味な作業ですが、おそらくこここそが、個別のアーキテクチャ上の工夫よりも大きなブレイクスルーとなった要因でしょう。
結果が示すこと、そして慎重に検討すべき点
標準的なOCRベンチマークにおいて、本論文はGOTが数億から数十億のパラメータを持つ大規模な汎用視覚言語モデルを上回ったと報告しています。GOTのパラメータ数は580 millionであるため、これは非常に注目すべき結果です。つまり、ドキュメントを正確に読み取るという特定のタスクにおいては、パラメータ数がごく一部の特化型モデルが、汎用的な重量級モデルを凌駕したということです。これはOCR分野で繰り返し証明されてきた、「狭く明確に定義されたタスクのためにエンドツーエンドで学習させたモデルは、それ以外のあらゆることに長けていてもそのタスクに特化していない巨大なモデルに勝ちやすい」という傾向と一致しています。
フォーマット済みの出力(Markdown形式のテーブル、LaTeX形式の数式、SMILES形式の分子構造など)に関しても、GOTはそれぞれのタスク専用に構築された単一目的のツールと同等の性能を維持していると報告されています。ルーターを介してどの専門ツールを呼び出すか判断させることなく、単一のモデルですべてを処理できる点こそが本論文の最大の主張であり、テストされたケースにおけるベンチマーク数値がそれを裏付けています。
一方で、論文内で正直に触れられており、実運用を検討する際に留意すべき点があります。それは、精選されたテストセットでのベンチマーク性能が、現実世界に存在する「本当に乱雑なドキュメント」での性能を保証するものではないということです。コーヒーのシミがついた領収書や、ファックスで送られたフォーム、悪い照明の下で斜めに撮影された写真などがそれに当たります。実際、本論文のscene-text(自然風景中のテキスト)の結果はドキュメント画像の結果よりも弱く、これはOCR分野全般に見られるパターンと一致しています。つまり、クリーンで照明の適切なドキュメントスキャンは「容易なケース」であり、物理世界で撮影されたテキスト写真は、年々緩やかに改善はしているものの依然として「困難なケース」であるということです。また、Markdown、LaTeX、SMILES、音楽のKern表記といった固定された出力フォーマットに基づいて構築されているため、新しいコンテンツタイプを追加するには再学習やファインチューニングが必要になります。本モデルは「統合」されてはいますが、箱から出してすぐに「無限に拡張可能」というわけではありません。
OCRを開発・導入する際にこれが重要である理由
実際の製品に向けてOCRエンジンの評価を行う場合、実用的な教訓は「GOTが最高のエンジンである」ということではなく、GOTが示した「分野の方向性」にあります。つまり、特定の目的のために構築されたエンドツーエンドのモデルは、はるかに大規模な汎用システムと同等かそれ以上の文書理解能力を、わずかな計算コストで実現できるということです。これは、1日あたり数千枚の文書を処理する場合、コスト(ページ単価)とレイテンシという現実的なコスト項目に直結します。
また、エンジンの比較において忘れてはならない重要な点も裏付けられました。「OCR」とは単一のタスクではないということです。タイピングされた英語の請求書に優れたツールであっても、手書きのフォームや表、科学記号などの処理は平凡である場合があり、その差は実際に必要とする特定の文書タイプでテストして初めて明らかになります。GOTがテキスト、表、数式、特殊記法に対して統合的なアプローチを取っていることは、あらゆるOCRエンジン(本モデルを含む)を、単なる汎用ベンチマークではなく、自社が実際に扱う文書でテストすべきであるという重要な示唆を与えてくれます。なお、本モデルは英語圏の視点に基づいているため、日本語特有の漢字や縦書きレイアウトへの対応については十分に検証されていません。印刷されたテキストのリーダーボードで1位のモデルであっても、特定の領収書やスキャンされた契約書では機能しない可能性があるからです。
さらに実務的な面では、もしパイプラインで「プレーンテキスト + 表 + 時折現れる数式」といった混在コンテンツを扱う必要がある場合、GOTのような単一の統合モデルは、テキストOCR、表抽出、数式認識という3つの異なるAPIと3つの異なる失敗モードを持つツールを繋ぎ合わせるよりも、アーキテクチャ的にシンプルに統合できます。構成要素が少ないことは、通常、本番環境のパイプラインにおける故障箇所の減少を意味します。