GOT-OCR2.0: Un modelo de 580M de parámetros que lee texto, fórmulas, partituras y gráficos
Basado en: General OCR Theory: Towards OCR-2.0 via a Unified End-to-end Model — Haoran Wei, Chenglong Liu, Jinyue Chen, Jia Wang, Lingyu Kong, Yanming Xu, Zheng Ge, Liang Zhao, Jianjian Sun, Yuang Peng, Chunrui Han, Xiangyu Zhang
Cerrando la brecha del OCR general
Si introduces la foto de una hoja de química escrita a mano en la mayoría de las herramientas de OCR, obtendrás un muro de caracteres latinos incoherentes donde deberían estar las estructuras moleculares. Si introduces una página de partituras, no obtendrás nada, ya que, para el software, la música no es "texto". Esa es la brecha que un grupo de investigadores de StepFun y la University of Chinese Academy of Sciences se propuso cerrar con un modelo llamado GOT, abreviatura de General OCR Theory. Su afirmación: un único modelo de 580 million parameters puede leer texto plano, matemáticas y fórmulas químicas, tablas, gráficos, partituras e incluso formas geométricas, y exportar cada uno en un formato útil: markdown, LaTeX, notación SMILES, o lo que sea más adecuado.
Es un alcance muy amplio para algo más pequeño que muchos chatbots de open-weight. Vale la pena analizar cómo lo logra y si realmente cumple lo prometido.
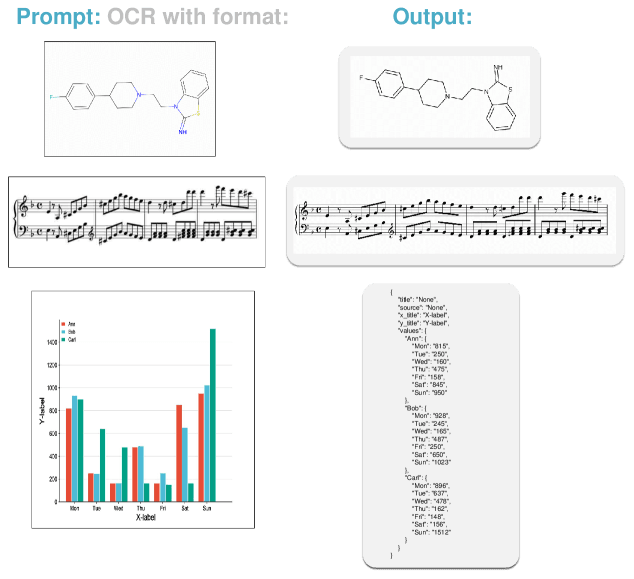
Figura de General OCR Theory: Towards OCR-2.0 via a Unified End-to-end Model (Wei et al., arXiv:2409.01704), bajo licencia CC BY-SA 4.0.
Por qué "simplemente pasarle un OCR" dejó de ser suficiente
El OCR con el que la mayoría crecimos —pensemos en Tesseract o en el software de escaneo que viene con una impresora de oficina— funciona dividiendo un documento en etapas: detectar dónde se encuentra el texto, recortar esas regiones, reconocer los caracteres en cada recorte y, finalmente, ensamblar los resultados en el orden de lectura. El artículo denomina a esto OCR-1.0, y ha sido suficiente para texto mecanografiado en inglés sobre fondo blanco durante décadas.
Sin embargo, este sistema falla en el momento en que el "texto" deja de ser simplemente frases sencillas. Una tabla no es solo texto; es texto con relaciones de filas y columnas que se pierden en el instante en que se aplana en un flujo de caracteres. Un diagrama de estructura química codifica enlaces y formas de anillos que no tienen ninguna representación a nivel de caracteres. Una partitura musical consiste en símbolos con tono y duración, organizados de una manera que ningún orden de lectura línea por línea puede capturar. Los flujos de trabajo multietapa diseñados para el inglés línea por línea no se adaptan bien a esto. Como resultado, cada tipo de contenido ha terminado con su propio sistema de reconocimiento a medida; así, una empresa que necesita digitalizar facturas, libros de texto y artículos científicos termina ejecutando tres sistemas especializados independientes, cada uno con sus propios errores, latencia y costos de integración.
La alternativa más reciente es acoplar el OCR a un modelo de lenguaje multimodal grande como GPT-4V, tratando todo el proceso como un "describe lo que hay en esta imagen". Esto funciona de manera general, pero los modelos de visión y lenguaje de propósito general no fueron entrenados con la precisión del OCR como objetivo, por lo que tienden a alucinar en textos densos, se saturan con documentos muy largos y consumen mucho más cómputo por página de lo que requeriría un reconocedor diseñado específicamente para ello.
La propuesta de GOT es un camino intermedio: diseñado específicamente para la lectura, pero unificado para todos los tipos de contenido y basado en un enfoque end-to-end en lugar de una cadena de módulos entrenados por separado.
Cómo funciona GOT realmente: un ojo pequeño y un lector más grande
Arquitectónicamente, GOT es refrescantemente sencillo: un codificador de imágenes alimenta a un decodificador de texto. Sin etapa de detección, sin etapa de reconocimiento separada y sin un analizador posterior que ensamble las piezas. Una sola pasada hacia adelante: entra la imagen, sale el texto.
El codificador es la parte más interesante. Se trata de un vision transformer de aproximadamente 80 millones de parámetros, inicializado a partir del Segment Anything Model de Meta, que toma una imagen de 1024x1024 y la comprime en solo 256 tokens antes de entregarlos al decodificador. Es una tasa de compresión muy alta para la densidad de información de, por ejemplo, la página completa de un libro escaneado. La apuesta de los autores es que una imagen de documento, por muy compleja que sea visualmente, no necesita una representación de miles de millones de píxeles una vez que se han identificado las formas relevantes para su lectura. Esto contrasta con lo mucho que fallaría un codificador de visión típico de comprensión de escenas si intentara comprimir la foto de una calle transitada en tan pocos tokens sin perder los objetos presentes. Aparentemente, los documentos se comprimen de forma más eficiente que las escenas urbanas.
El decodificador es un modelo de lenguaje de aproximadamente 500 millones de parámetros basado en Qwen, dotado de una ventana de contexto amplia para que pueda retener una página entera de texto extraído sin perder el hilo del primer párrafo al llegar al último.
El entrenamiento se realiza en tres etapas. Primero, el codificador se preentrena junto a un decodificador pequeño y desechable, solo para enseñarle a reconocer formas similares al texto. Luego, se acopla el decodificador real y ambos se entrenan conjuntamente con una mezcla diversa de documentos. Finalmente, todo el sistema se ajusta mediante fine-tuning según la tarea, utilizando diferentes prompts para cambiar el comportamiento: extracción de texto plano, tablas en formato markdown, LaTeX para fórmulas o cadenas SMILES para moléculas. El prompt actúa efectivamente como un interruptor de modo: mismos pesos, diferentes instrucciones, diferente formato de salida.
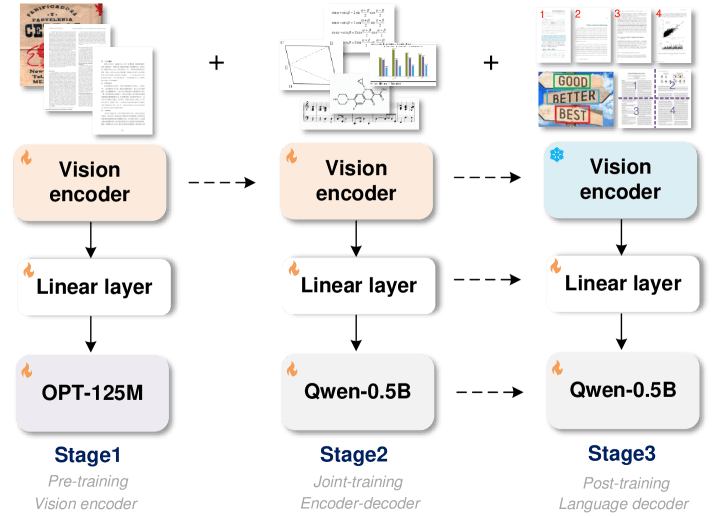
Figura de General OCR Theory: Towards OCR-2.0 via a Unified End-to-end Model (Haoran Wei et al., arXiv:2409.01704), con licencia CC BY-SA 4.0.
Leer un recibo frente a leer un libro de texto de química
Un detalle que me gusta: GOT es compatible con lo que los autores llaman OCR interactivo. Puedes señalar una región mediante coordenadas o colores y pedirle al modelo que lea solo esa parte. Parece una funcionalidad menor, pero es la diferencia entre "extraer todo y esperar que el analizador de diseño identifique correctamente los límites" y "decirle al modelo exactamente qué quieres y recibir solo eso". Cualquiera que haya intentado extraer una sola línea de una factura saturada sabe con qué frecuencia la extracción basada en el diseño señala el cuadro equivocado.
El modelo también gestiona documentos que no se pueden procesar de un solo vistazo. Para imágenes sobredimensionadas, pósteres, planos de ingeniería o cualquier elemento demasiado grande para reducir su resolución sin perder legibilidad, entra en juego la resolución dinámica, que divide la imagen en teselas y procesa las piezas por separado antes de fusionar los resultados. Además, el OCR multipágina permite introducir varias páginas a la vez y obtener una salida coherente, en lugar de tener que pegar manualmente los resultados de cada página esperando que los saltos de página no corten una frase por la mitad.
Nada de esto requirió una teoría nueva y exótica. Lo que requirió fueron datos de entrenamiento que nadie se había molestado en construir: documentos sintéticos renderizados desde LaTeX y HTML para matemáticas y tablas, imágenes de texto en escenas para señales callejeras y etiquetas de productos, y partituras musicales y diagramas moleculares generados junto con su verdad fundamental simbólica. Crear un conjunto de entrenamiento emparejado para diagramas de química y partituras es un trabajo poco glamuroso, y es muy probable que sea la verdadera clave aquí, más que cualquier truco arquitectónico individual.
Qué dicen los resultados y dónde mantener el escepticismo
En los benchmarks estándar de OCR, el artículo reporta que GOT supera a modelos de visión-lenguaje generalistas mucho más grandes, incluyendo sistemas con varios miles de millones de parámetros, a pesar de que GOT solo cuenta con 580 millones. Este es un resultado real que merece ser tomado en serio: un modelo especialista con una fracción de los parámetros supera a los pesos pesados generalistas en la tarea específica de leer documentos con precisión. Esto coincide con una lección aprendida repetidamente en el campo del OCR: un modelo entrenado de extremo a extremo para una tarea estrecha y bien definida tiende a vencer a un modelo mucho más grande que es bueno en todo, excepto en esa tarea.
En cuanto a las salidas formateadas —tablas mantenidas como markdown, fórmulas en LaTeX y moléculas en SMILES—, el artículo indica que GOT se desempeña bien frente a herramientas dedicadas de propósito único creadas exactamente para una de esas tareas. La capacidad de gestionar todas ellas desde un solo modelo, sin un router que decida a qué especialista llamar, es la afirmación principal, y las cifras de los benchmarks lo respaldan en los casos probados.
Lo que el artículo admite con honestidad, y lo que es importante señalar para cualquiera que considere implementarlo en producción, es que el rendimiento en benchmarks sobre conjuntos de prueba curados no garantiza el mismo éxito con los documentos genuinamente desordenados del mundo real: recibos manchados de café, formularios enviados por fax o fotos tomadas en ángulo y con mala iluminación. Los propios resultados de scene-text del artículo son más débiles que los de document-image, lo cual sigue un patrón general en el campo del OCR: los escaneos de documentos limpios y bien iluminados son el caso sencillo, mientras que las fotos de texto en el mundo físico son el caso difícil que mejora lentamente año tras año. Además, un modelo construido en torno a un conjunto fijo de formatos de salida (markdown, LaTeX, SMILES, notación Kern para música) requerirá un reentrenamiento o fine-tuning para añadir un nuevo tipo de contenido. Es un sistema unificado, pero no es infinitamente extensible de fábrica.
Por qué es importante si estás desarrollando o adquiriendo OCR
Si estás evaluando motores de OCR para un producto real, la conclusión práctica no es que "GOT es el mejor motor", sino lo que GOT demuestra sobre la dirección que está tomando el campo: los modelos end-to-end diseñados específicamente para un propósito pueden igualar o superar a sistemas de propósito general mucho más grandes en la comprensión de documentos, con una fracción del coste computacional. Esto impacta directamente en el coste por página y en la latencia, ambos factores críticos si procesas miles de documentos al día.
También valida algo fundamental a recordar al comparar motores: el "OCR" no es una sola tarea. Una herramienta que sea excelente con facturas mecanografiadas en inglés puede ser mediocre con formularios manuscritos, tablas o notación científica; a menudo, esa brecha solo se hace evidente cuando pruebas el tipo de documento específico que realmente necesitas. El enfoque unificado de GOT para texto, tablas, fórmulas y notación especializada es un recordatorio útil de que cualquier motor de OCR, incluido este, debe probarse con los documentos reales que maneja tu negocio y no solo con un benchmark genérico. Un modelo que lidere un ranking de texto impreso puede fallar estrepitosamente con tus recibos o tus contratos escaneados en particular.
Y en términos prácticos: si tu pipeline necesita gestionar documentos con contenido mixto (texto plano, tablas y alguna fórmula ocasional), un único modelo unificado como GOT es arquitectónicamente más sencillo de integrar que intentar ensamblar un motor de OCR de texto, un extractor de tablas y un reconocedor de fórmulas con tres APIs diferentes y tres modos de fallo distintos. Menos piezas móviles suelen significar menos puntos de ruptura en un pipeline de producción.