GOT-OCR2.0: एक 580M-Parameter मॉडल जो टेक्स्ट, फॉर्मूला, शीट म्यूजिक और चार्ट्स पढ़ता है
आधारित शोध-पत्र: General OCR Theory: Towards OCR-2.0 via a Unified End-to-end Model — Haoran Wei, Chenglong Liu, Jinyue Chen, Jia Wang, Lingyu Kong, Yanming Xu, Zheng Ge, Liang Zhao, Jianjian Sun, Yuang Peng, Chunrui Han, Xiangyu Zhang
OCR की सीमाओं को पार करना
यदि आप किसी हस्तलिखित केमिस्ट्री वर्कशीट की फोटो को अधिकांश OCR टूल्स में डालेंगे, तो आपको मॉलिक्यूलर स्ट्रक्चर्स की जगह अजीबोगरीब लैटिन अक्षरों का ढेर दिखाई देगा। यदि आप इसमें शीट म्यूजिक का एक पेज डालेंगे, तो आपको कुछ भी हासिल नहीं होगा, क्योंकि सॉफ्टवेयर की नजर में शीट म्यूजिक "टेक्स्ट" नहीं है। इसी अंतर को पाटने के लिए StepFun और University of Chinese Academy of Sciences के शोधकर्ताओं के एक समूह ने GOT (General OCR Theory का संक्षिप्त रूप) नामक एक मॉडल विकसित किया है। उनका दावा है कि यह 580-million-parameter वाला एक अकेला मॉडल प्लेन टेक्स्ट, गणित और केमिकल फॉर्मूला, टेबल, चार्ट, शीट म्यूजिक और यहाँ तक कि ज्योमेट्रिक शेप्स को भी पढ़ सकता है, और प्रत्येक को ऐसे फॉर्मेट में आउटपुट कर सकता है जिसे आप वास्तव में इस्तेमाल कर सकें—चाहे वह markdown हो, LaTeX हो, SMILES notation हो, या जो भी उपयुक्त हो।
कई ओपन-वेट चैटबॉट्स की तुलना में छोटा होने के बावजूद यह मॉडल बहुत व्यापक क्षमताएं रखता है। यह गहराई से जानने लायक है कि यह कैसे काम करता है और क्या यह वास्तव में प्रभावी है।
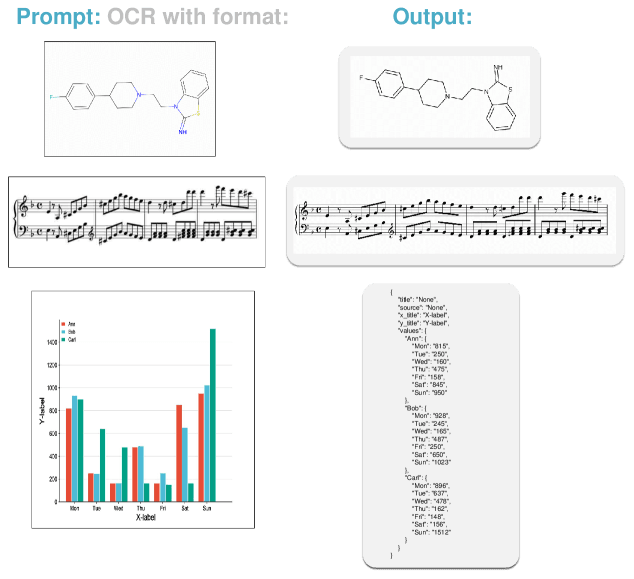
Figure from General OCR Theory: Towards OCR-2.0 via a Unified End-to-end Model (Wei et al., arXiv:2409.01704), licensed CC BY-SA 4.0.
"बस OCR चला दें" यह तरीका पर्याप्त क्यों नहीं रहा
हम में से अधिकांश लोग जिस OCR के साथ बड़े हुए हैं—जैसे Tesseract, या ऑफिस प्रिंटर के साथ आने वाला स्कैनर सॉफ्टवेयर—वह दस्तावेज़ को अलग-अलग चरणों में विभाजित करके काम करता है: पहले यह पता लगाना कि टेक्स्ट कहाँ है, उन क्षेत्रों को क्रॉप करना, प्रत्येक क्रॉप में अक्षरों को पहचानना, और फिर परिणामों को पढ़ने के क्रम (reading order) में वापस जोड़ना। पेपर इसे OCR-1.0 कहता है, और दशकों से सफेद बैकग्राउंड पर टाइप किए गए अंग्रेजी टेक्स्ट के लिए यह पर्याप्त रहा है।
लेकिन जैसे ही "टेक्स्ट" का मतलब साधारण वाक्यों से आगे बढ़ता है, यह तरीका विफल हो जाता है। एक टेबल सिर्फ टेक्स्ट नहीं है; इसमें पंक्तियों (rows) और कॉलमों के बीच ऐसे संबंध होते हैं जो अक्षरों की एक सीधी स्ट्रीम में बदलते ही खो जाते हैं। एक केमिकल स्ट्रक्चर डायग्राम में बॉन्ड्स और रिंग शेप्स होते हैं जिनका अक्षर-स्तर पर कोई प्रतिनिधित्व ही नहीं होता। शीट म्यूजिक में पिच और ड्यूरेशन वाले सिम्बल्स होते हैं, जिन्हें लाइन-दर-लाइन रीडिंग ऑर्डर के जरिए नहीं समझा जा सकता। लाइन-दर-लाइन अंग्रेजी के लिए बनाए गए मल्टी-स्टेज पाइपलाइन्स इन चीजों के लिए लचीले नहीं होते। नतीजा यह हुआ कि हर तरह के कंटेंट के लिए एक अलग विशेष रिकग्निशन सिस्टम बनाना पड़ा। इसलिए, जिस कंपनी को इनवॉइस, टेक्स्टबुक और साइंटिफिक पेपर्स को डिजिटाइज़ करना होता है, उसे तीन अलग-अलग स्पेशलाइज्ड सिस्टम चलाने पड़ते हैं, जिनमें से प्रत्येक के अपने बग्स, लेटेंसी और इंटीग्रेशन कॉस्ट होते हैं।
हालिया विकल्प यह है कि OCR को GPT-4V जैसे बड़े मल्टीमोडल लैंग्वेज मॉडल के साथ जोड़ दिया जाए और पूरे काम को "इस इमेज में क्या है, उसका वर्णन करें" की तरह ट्रीट किया जाए। यह सामान्य तौर पर तो काम करता है, लेकिन जनरल-पर्पस विजन-लैंग्वेज मॉडल्स को OCR प्रिसिजन (precision) के लक्ष्य के साथ ट्रेन नहीं किया गया था। इसलिए, वे घने टेक्स्ट (dense text) पर अक्सर 'हैलुसिनेट' करते हैं, बहुत लंबे दस्तावेज़ों में अटक जाते हैं, और एक पर्पस-बिल्ट रिकग्नाइज़र की तुलना में प्रति पेज बहुत अधिक कंप्यूट कॉस्ट लेते हैं।
GOT का प्रस्ताव एक बीच का रास्ता है: यह पढ़ने के लिए विशेष रूप से बनाया गया है, लेकिन सभी कंटेंट टाइप्स के लिए एकीकृत (unified) है, और अलग-अलग ट्रेन किए गए मॉड्यूल्स की चेन के बजाय एक एंड-टू-एंड सिस्टम है।
GOT वास्तव में कैसे काम करता है: एक छोटी आँख और एक बड़ा रीडर
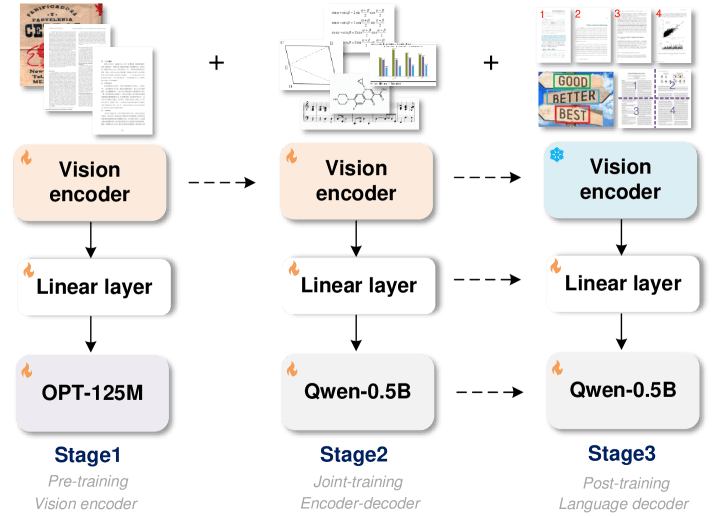
आर्किटेक्चर के लिहाज़ से GOT काफी सरल है: एक image encoder एक text decoder को डेटा फीड करता है। इसमें कोई detection stage नहीं है, कोई अलग recognition stage नहीं है, और न ही चीज़ों को जोड़ने के लिए कोई downstream parser है। बस एक forward pass—इमेज अंदर जाती है और टेक्स्ट बाहर आता है।
इसका encoder वाला हिस्सा अधिक दिलचस्प है। यह लगभग 80-million-parameter वाला एक vision transformer है, जिसे Meta के Segment Anything Model से initialize किया गया है। यह 1024x1024 की इमेज लेता है और उसे decoder को सौंपने से पहले केवल 256 tokens में compress कर देता है। एक स्कैन की हुई किताब के पूरे पेज जैसी सूचनाओं के घनत्व (density) को देखते हुए यह एक बहुत उच्च compression ratio है। लेखकों का यह मानना है कि एक दस्तावेज़ की इमेज, चाहे वह दिखने में कितनी भी जटिल क्यों न हो, उसे पढ़ने के लिए ज़रूरी आकृतियों (shapes) को पहचानने के बाद अरबों पिक्सेल के representation की आवश्यकता नहीं होती। इसकी तुलना एक सामान्य scene-understanding vision encoder से करें, जो किसी भीड़भाड़ वाली सड़क की फोटो को बिना ऑब्जेक्ट्स खोए इतने कम tokens में compress करने में विफल रहेगा। स्पष्ट है कि दस्तावेज़, सड़क के दृश्यों की तुलना में अधिक सफाई से compress हो जाते हैं।
इसका decoder लगभग 500-million-parameter वाला एक language model है जो Qwen पर आधारित है। इसे एक long context window दी गई है ताकि यह निकाले गए टेक्स्ट के पूरे पेज को याद रख सके और आखिरी पैराग्राफ तक पहुँचते-पहुँचते पहले पैराग्राफ को न भूले।
Training तीन चरणों में होती है। पहले, encoder को एक छोटे, अस्थायी (throwaway) decoder के साथ pretrain किया जाता है ताकि वह टेक्स्ट जैसी आकृतियों को पहचानना सीख सके। इसके बाद, असली decoder को जोड़ा जाता है और दोनों को दस्तावेज़ों के एक व्यापक मिश्रण (broad mix) पर एक साथ train किया जाता है। अंत में, पूरे सिस्टम को अलग-अलग tasks के लिए fine-tune किया जाता है, जहाँ व्यवहार बदलने के लिए अलग-अलग prompts का उपयोग किया जाता है—जैसे plain text extraction, markdown-formatted tables, फॉर्मूला के लिए LaTeX, या मॉलिक्यूल्स के लिए SMILES strings। यहाँ prompt प्रभावी रूप से एक 'मोड स्विच' की तरह काम करता है: weights वही रहते हैं, लेकिन निर्देश और आउटपुट फॉर्मेट बदल जाते हैं।
General OCR Theory: Towards OCR-2.0 via a Unified End-to-end Model (Haoran Wei et al., arXiv:2409.01704) से लिया गया चित्र, CC BY-SA 4.0 लाइसेंस के तहत।
रसीद पढ़ने और केमिस्ट्री की पाठ्यपुस्तक पढ़ने में अंतर
एक विवरण जो मुझे पसंद आया: GOT उस चीज़ को सपोर्ट करता है जिसे लेखक 'interactive OCR' कहते हैं। आप कोऑर्डिनेट्स (coordinates) या रंग के ज़रिए किसी खास क्षेत्र की ओर इशारा कर सकते हैं और मॉडल से केवल उसी हिस्से को पढ़ने के लिए कह सकते हैं। यह सुनने में एक छोटा फीचर लग सकता है, लेकिन "सब कुछ एक्सट्रैक्ट करें और उम्मीद करें कि layout parser सीमाओं को सही से पहचान ले" और "मॉडल को सटीक रूप से बताएं कि आपको क्या चाहिए और केवल वही प्राप्त करें" के बीच यही बुनियादी अंतर है। जिसने भी किसी अव्यवस्थित इनवॉइस (invoice) से एक सिंगल लाइन आइटम निकालने की कोशिश की है, वह जानता है कि layout-based extraction कितनी बार गलत बॉक्स की ओर इशारा करता है।
यह मॉडल उन दस्तावेज़ों को भी संभाल लेता है जो एक बार में पूरी तरह नहीं दिखते। बहुत बड़ी इमेज, पोस्टर्स, इंजीनियरिंग ड्राइंग्स या ऐसी किसी भी चीज़ के लिए जिसे स्पष्टता खोए बिना downsample नहीं किया जा सकता, 'Dynamic resolution' काम आता है। यह इमेज को टाइल्स (tiling) में बाँट देता है और परिणामों को मर्ज करने से पहले अलग-अलग हिस्सों को प्रोसेस करता है। साथ ही, multi-page OCR आपको एक साथ कई पेज फीड करने और एक सुसंगत (coherent) आउटपुट प्राप्त करने की सुविधा देता है, ताकि आपको खुद हर पेज के आउटपुट को जोड़ने की ज़रूरत न पड़े और इस बात का डर न रहे कि पेज ब्रेक किसी वाक्य को बीच से काट देगा।
इनमें से किसी के लिए भी किसी नई या जटिल थ्योरी की ज़रूरत नहीं थी। इसके लिए ऐसे ट्रेनिंग डेटा की ज़रूरत थी जिसे बनाने की कोशिश किसी ने नहीं की थी: गणित और टेबल के लिए LaTeX और HTML से रेंडर किए गए synthetic documents, स्ट्रीट साइन्स और प्रोडक्ट लेबल्स के लिए scene-text images, और उनके symbolic ground truth के साथ जनरेट किए गए sheet music और molecular diagrams। केमिस्ट्री डायग्राम और sheet music के लिए एक मैचिंग ट्रेनिंग सेट तैयार करना एक उबाऊ काम है, और संभवतः यही वह असली 'unlock' है, न कि कोई सिंगल आर्किटेक्चरल ट्रिक।
परिणाम क्या बताते हैं, और कहाँ सतर्क रहना है
स्टैंडर्ड OCR benchmarks पर, यह पेपर रिपोर्ट करता है कि GOT ने कई बिलियन parameters वाले बड़े general-purpose vision-language models को पीछे छोड़ दिया है, जबकि GOT का वजन केवल 580 million है। यह एक ऐसा परिणाम है जिसे गंभीरता से लिया जाना चाहिए: एक specialist model, जिसके parameters बहुत कम हैं, दस्तावेज़ों को सटीक रूप से पढ़ने के विशिष्ट कार्य में generalist heavyweights से बेहतर प्रदर्शन कर रहा है। यह उस बात की पुष्टि करता है जो OCR क्षेत्र ने बार-बार सीखा है: एक narrow और well-defined task के लिए end-to-end प्रशिक्षित मॉडल अक्सर उस बहुत बड़े मॉडल को हरा देता है जो उस विशिष्ट कार्य को छोड़कर बाकी सबमें माहिर हो।
फॉर्मेटेड आउटपुट्स के मामले में—जहाँ tables को markdown, formulas को LaTeX और molecules को SMILES के रूप में रखा गया है—पेपर बताता है कि GOT उन समर्पित single-purpose tools के मुकाबले अच्छी टक्कर देता है जो विशेष रूप से इनमें से किसी एक कार्य के लिए बनाए गए थे। बिना किसी router के (जो यह तय करे कि किस specialist को कॉल करना है), एक ही मॉडल से इन सभी को हैंडल करना इस शोध का मुख्य दावा है, और टेस्ट किए गए मामलों में benchmark numbers इसका समर्थन करते हैं।
पेपर जिस बात को लेकर ईमानदार है, और जो किसी भी व्यक्ति के लिए production में इसे इस्तेमाल करने से पहले ध्यान देने योग्य है: curated test sets पर benchmark performance इस बात की गारंटी नहीं देता कि यह वास्तविक दुनिया के उन बेहद अव्यवस्थित दस्तावेज़ों पर भी वैसा ही काम करेगा, जैसे कॉफी के दाग वाली रसीदें, fax किए गए फॉर्म, या खराब रोशनी में किसी एंगल से ली गई तस्वीरें। पेपर के अपने scene-text परिणाम, document-image परिणामों की तुलना में कमजोर हैं, जो सामान्य तौर पर OCR क्षेत्र में देखे जाने वाले पैटर्न के अनुरूप है: साफ और अच्छी रोशनी वाले document scans आसान होते हैं, जबकि भौतिक दुनिया में टेक्स्ट की तस्वीरें एक कठिन चुनौती हैं जिसमें साल-दर-साल धीरे-धीरे सुधार हो रहा है। इसके अलावा, एक मॉडल जो markdown, LaTeX, SMILES और संगीत के लिए kern notation जैसे निश्चित आउटपुट फॉर्मेट्स पर आधारित है, उसे किसी नए कंटेंट टाइप को जोड़ने के लिए retraining या fine-tuning की आवश्यकता होगी। यह unified तो है, लेकिन out of the box अनंत रूप से extensible नहीं है।
यदि आप OCR बना रहे हैं या खरीद रहे हैं, तो यह क्यों महत्वपूर्ण है
यदि आप किसी वास्तविक प्रोडक्ट के लिए OCR engines का मूल्यांकन कर रहे हैं, तो व्यावहारिक निष्कर्ष यह नहीं है कि "GOT सबसे अच्छा इंजन है," बल्कि यह है कि GOT यह दर्शाता है कि यह क्षेत्र किस दिशा में जा रहा है: purpose-built, end-to-end models दस्तावेज़ों की समझ (document understanding) के मामले में बहुत बड़े general-purpose systems के बराबर या उनसे बेहतर प्रदर्शन कर सकते हैं, और वह भी बहुत कम compute cost पर। यह सीधे तौर पर cost-per-page और latency को प्रभावित करता है, जो कि तब बहुत महत्वपूर्ण हो जाता है जब आप प्रतिदिन हज़ारों दस्तावेज़ों को प्रोसेस कर रहे हों।
यह इंजनों की तुलना करते समय एक ज़रूरी बात की पुष्टि भी करता है: "OCR" कोई एक सिंगल टास्क नहीं है। एक टूल जो typed English invoices के लिए बेहतरीन है, वह handwritten forms, tables या scientific notation के मामले में औसत हो सकता है, और यह अंतर अक्सर तभी सामने आता है जब आप उस विशिष्ट document type का परीक्षण करते हैं जिसकी आपको वास्तव में आवश्यकता है। यहाँ यह ध्यान रखना ज़रूरी है कि English OCR में मज़बूत प्रदर्शन का मतलब यह नहीं है कि Devanagari OCR भी उतना ही सटीक होगा। text, tables, formulas और specialized notation के प्रति GOT का unified approach एक उपयोगी रिमाइंडर है कि किसी भी OCR engine का परीक्षण (इस मॉडल सहित) केवल generic benchmarks पर नहीं, बल्कि उन वास्तविक दस्तावेज़ों पर करें जिन्हें आपका बिज़नेस हैंडल करता है। एक मॉडल जो printed text के leaderboard पर टॉप कर रहा है, वह आपकी विशिष्ट receipts या scanned contracts पर फेल हो सकता है।
और व्यावहारिक रूप से: यदि आपके pipeline को mixed content वाले दस्तावेज़ों (plain text + tables + occasional formula) को संभालना है, तो GOT जैसा एक single unified model आर्किटेक्चर के लिहाज़ से integrate करना कहीं ज़्यादा सरल है, बजाय इसके कि आप एक text OCR engine, एक table extractor और एक formula recognizer को तीन अलग-अलग APIs और तीन अलग-अलग failure modes के साथ जोड़ें। जितने कम moving parts होंगे, production pipeline के टूटने की संभावना उतनी ही कम होगी।