GOT-OCR2.0:一个能够阅读文本、公式、乐谱和图表的 580M 参数模型
参考论文: General OCR Theory: Towards OCR-2.0 via a Unified End-to-end Model — Haoran Wei, Chenglong Liu, Jinyue Chen, Jia Wang, Lingyu Kong, Yanming Xu, Zheng Ge, Liang Zhao, Jianjian Sun, Yuang Peng, Chunrui Han, Xiangyu Zhang
突破 OCR 的局限
如果你将一张手写的化学练习册照片输入到大多数 OCR 工具中,在原本应该是分子结构的地方,你可能会看到一堆乱码的拉丁字符。如果你输入一张乐谱,结果可能完全是空白,因为在软件看来,乐谱根本不是“文本”。正是为了填补这一空白,来自 StepFun(阶跃星辰)和中国科学院大学的研究团队开发了一个名为 GOT(General OCR Theory 的缩写)的模型。他们声称:一个仅有 580 million 参数的模型,就能读取纯文本、数学和化学公式、表格、图表、乐谱,甚至几何图形,并能以你真正可用的格式(如 markdown、LaTeX、SMILES 符号等)输出。
对于一个规模比许多开源权重聊天机器人还要小的模型来说,这个覆盖范围极其广泛。因此,深入探讨它是如何实现这一点,以及其实际效果如何,是非常有价值的。
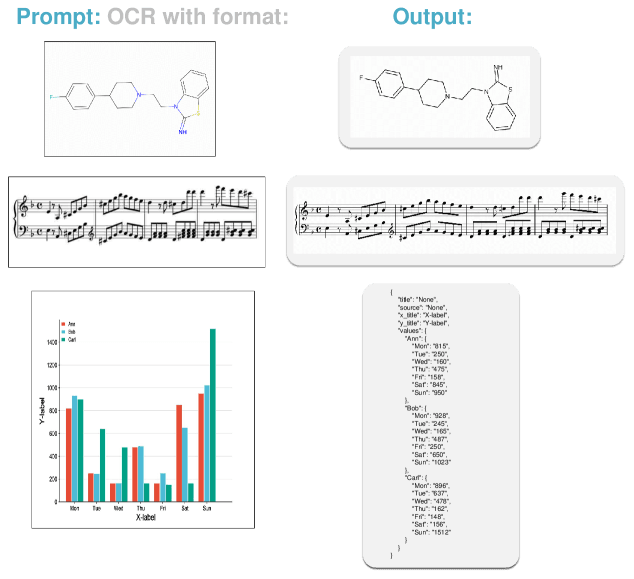
图源自 General OCR Theory: Towards OCR-2.0 via a Unified End-to-end Model (Wei et al., arXiv:2409.01704),采用 CC BY-SA 4.0 许可。
为什么“直接运行 OCR”不再足够
我们大多数人接触过的 OCR(例如 Tesseract 或办公打印机自带的扫描软件)其工作原理是将文档分解为多个阶段:检测文本位置 $\rightarrow$ 裁剪区域 $\rightarrow$ 识别每个裁剪区域中的字符 $\rightarrow$ 将结果重新拼接成阅读顺序。论文将这种方式称为 OCR-1.0。几十年来,对于白色背景上的打印英文文本,这种方法一直足够好用。
但一旦“文本”不再仅仅指简单的句子,这种方法就失效了。表格不仅仅是文本,它还包含行与列的关系,而一旦将其扁平化为字符流,这些关系就会丢失。化学结构图编码了化学键和环状结构,这些在字符层面根本没有对应的表示。乐谱包含音高和时值的符号,其排列方式是任何逐行阅读顺序都无法捕捉的。为逐行英文设计的多阶段流水线难以适应这些需求。结果,每种内容类型最终都演化出了一套定制的识别系统。因此,一家需要数字化发票、教科书和科学论文的公司必须运行三个独立的专业系统,而每个系统都有自己的 Bug、延迟和集成成本。
较新的替代方案是将 OCR 挂载到像 GPT-4V 这样的大型多模态语言模型上,将整个过程视为“描述这张图片里有什么”。这种方法在通用层面有效,但通用视觉语言模型在训练时并非以 OCR 级的精度为目标,因此它们在处理密集文本时容易产生幻觉,在处理超长文档时会陷入困境,且每页所需的计算成本远高于专用识别器。
GOT 的切入点是一条中间路线:专为阅读而构建,但在不同内容类型之间实现了统一,并且采用端到端架构,而非由一系列独立训练的模块串联而成。
GOT 的实际工作原理:小眼睛与大阅读器
在架构上,GOT 简洁得令人耳目一新:一个图像编码器(image encoder)直接馈送给一个文本解码器(text decoder)。没有检测阶段,没有独立的识别阶段,也没有用于将各部分拼接在一起的下游解析器。一次前向传播,图像输入,文本输出。
编码器是其中更有趣的部分。它是一个参数量约为 80 million 的 vision transformer,初始化自 Meta 的 Segment Anything Model。它将一张 1024x1024 的图像压缩至仅 256 个 token,然后将其交给解码器。对于像扫描书籍全页这样信息密度极高的内容来说,这是一个极高的压缩比。作者的假设是:只要提取出对回读至关重要的形状,文档图像无论视觉上多么复杂,都不需要数十亿像素级别的表示。相比之下,典型的场景理解视觉编码器如果尝试将一张繁忙街道的照片压缩到这么少的 token 而不丢失其中的物体,效果会差得多。显然,文档比街道场景更容易被高效压缩。
解码器是一个基于 Qwen 的参数量约为 500 million 的语言模型,它拥有较长的上下文窗口,因此可以容纳整个页面的提取文本,而不会在读到最后一段时忘记第一段的内容。
训练分为三个阶段。首先,编码器与一个小型且临时的解码器一起进行预训练,仅为了教会它识别“文本形状”的物体。接着,正式的解码器被接入,两者在广泛的混合文档数据集上共同训练。最后,整个系统针对具体任务进行微调,通过不同的 prompt 来切换行为:纯文本提取、markdown 格式表格、用于公式的 LaTeX,以及用于分子的 SMILES 字符串。Prompt 实际上起到了模式开关的作用:权重相同,但指令不同,输出格式也随之改变。
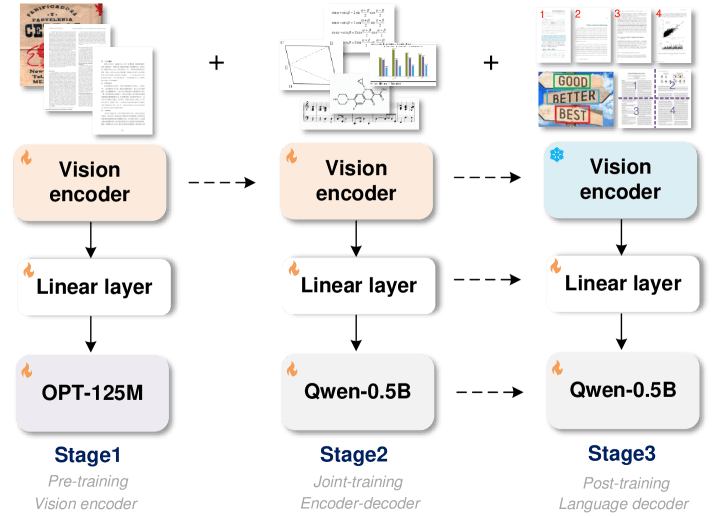
图片来自 General OCR Theory: Towards OCR-2.0 via a Unified End-to-end Model(Haoran Wei 等,arXiv:2409.01704),采用 CC BY-SA 4.0 许可。
读取收据与阅读化学教科书的区别
我非常喜欢的一个细节是:GOT 支持作者所称的“交互式 OCR”。你可以通过坐标或颜色指定一个区域,并要求模型仅读取该部分。这听起来像是个小功能,但它决定了你是选择“提取所有内容并寄希望于布局解析器能正确识别边界”,还是“精确告诉模型你想要什么并仅获取该结果”。任何尝试从杂乱的发票中提取单行项目的人都知道,基于布局的提取方法经常会指向错误的文本框。
该模型还能处理无法一眼看完的文档。对于超大图像、海报、工程图纸以及任何在下采样后会丧失可读性的内容,模型会启动动态分辨率机制,通过将图像分块处理,最后再合并结果。此外,多页 OCR 允许你一次性输入多个页面并获得一个连贯的输出,而不需要你自己将每页的输出拼接起来,并祈祷分页符没有将句子截断。
这一切并非依赖于某种新颖的理论,而是依赖于此前无人潜心构建的训练数据:用于数学和表格的 LaTeX 和 HTML 渲染合成文档,用于路牌和产品标签的场景文本图像,以及与符号真值(ground truth)配对的生成乐谱和分子结构图。为化学图表和乐谱构建匹配的训练集是一项枯燥的工作,但这很可能才是真正的突破口,而非任何单一的架构技巧。
结果分析与审慎思考
在标准 OCR 基准测试中,论文报告称 GOT 击败了规模更大的通用视觉语言模型(包括一些拥有数十亿参数的系统),而 GOT 本身仅有 5.8 亿参数。这是一个值得关注的真实结果:一个参数量仅为对方一小部分的专业化模型,在准确读取文档这一特定任务上,表现优于通用型“巨头”。这印证了 OCR 领域反复验证的一个规律:针对狭窄且定义明确的任务进行端到端训练的模型,往往能击败那些虽然全能但并非专精于该任务的大模型。
在格式化输出方面(如将表格保留为 markdown,公式保留为 LaTeX,分子式保留为 SMILES),论文指出 GOT 的表现足以媲美那些专门为单一任务构建的专用工具。其核心主张在于:无需路由机制来决定调用哪个专家模型,仅凭一个模型即可处理所有这些格式,且基准测试数据在测试用例中支撑了这一结论。
论文中坦诚的部分,也是任何考虑将其投入生产环境的人员需要注意的:在精选测试集上的基准性能,并不保证其在真实世界中面对极其混乱的文档时依然有效——例如沾有咖啡渍的收据、传真表单,或是光线不足且拍摄角度倾斜的照片。论文自身的 scene-text 结果弱于 document-image 结果,这符合 OCR 领域的普遍规律:清晰、光线充足的文档扫描件是简单情况,而物理世界中的文本照片则是难点,且每年的进步速度较为缓慢。此外,一个基于固定输出格式(markdown, LaTeX, SMILES, 音乐 kern 记谱法)构建的模型,若要增加新的内容类型,将需要重新训练或进行微调。它是统一的,但并非开箱即用的无限可扩展。
为什么这对构建或购买 OCR 至关重要
如果你正在为实际产品评估 OCR 引擎,其实践意义并不在于“GOT 是最好的引擎”,而在于 GOT 展示了该领域的发展趋势:专为特定目的构建的端到端模型,在文档理解能力上可以媲美甚至超越规模大得多的通用系统,而计算成本却仅为后者的一小部分。对于每天处理数千份文档的企业来说,这直接影响到单页处理成本和响应延迟,而这两者都是真实的成本支出项。
这也验证了在对比引擎时值得记住的一点:“OCR”并非单一的任务。一个擅长处理英文打印发票的工具,在处理手写表单、表格或科学计数法时可能表现平平,而且这种差距通常只有在你测试实际需要的特定文档类型时才会显现。由于汉字等表意文字数量庞大且布局密集,通用模型在处理中文复杂排版时往往面临更大挑战。GOT 对文本、表格、公式及专业符号的统一处理方式提醒我们:在测试任何 OCR 引擎(包括 GOT)时,应针对业务实际处理的文档进行测试,而非仅仅依赖通用基准测试。一个在打印文本排行榜上名列前茅的模型,在面对你特定的收据或扫描合同时依然可能失效。
从实践角度来看:如果你的工作流需要处理包含混合内容(如纯文本、表格以及偶尔出现的公式)的文档,那么像 GOT 这样单一的统一模型,在架构集成上比将文本 OCR 引擎、表格提取器和公式识别器通过三个不同的 API 拼接在一起要简单得多,因为后者意味着三种不同的失效模式。组件越少,生产流水线出现故障的可能性通常就越低。