KOSMOS-2.5 من Microsoft: نموذج OCR واحد، ومهمتان مختلفتان تماماً
استنادًا إلى: KOSMOS-2.5: A Multimodal Literate Model — Tengchao Lv, Yupan Huang, Jingye Chen, Yuzhong Zhao, Yilin Jia, Lei Cui, Shuming Ma, Yaoyao Chang, Shaohan Huang, Wenhui Wang, Li Dong, Weiyao Luo, Shaoxiang Wu, Guoxin Wang, Cha Zhang, Furu Wei
رؤيتان مختلفتان لنفس المستند
تخيل شخصين ينظران إلى نفس الفاتورة الممسوحة ضوئياً. الأول كاتب محكمة، يقوم بنسخ كل كلمة وتدوين موقعها الدقيق على الصفحة، وصولاً إلى مستوى البكسل. أما الآخر فهو محرر، يعيد بناء المستند من الصفر في شكل markdown نظيف: يحدد هذا كجدول، وهذا كعنوان، وهذا كمجموع مكتوب بخط عريض. المدخلات واحدة، لكن شكل المخرجات مختلف تماماً، وكذلك الغرض من استخدامها لاحقاً.
تختار معظم أنظمة OCR إحدى هاتين المهمتين وتتخصص فيها. لكن نموذج KOSMOS-2.5 من Microsoft، والذي وُصف في ورقة بحثية صدرت في سبتمبر 2023 عن قسم الأبحاث في الشركة، قد تم تدريبه للقيام بكليهما باستخدام نفس النموذج الذي يحتوي على 1.3-billion-parameter، حيث ينتقل بين المهمتين بمجرد تغيير الـ prompt. هذا هو جوهر الفكرة، وهي فكرة أكثر إثارة مما تبدو عليه للوهلة الأولى، لأن هاتين المهمتين عادة ما تدفعان النموذج في اتجاهين متضادين.
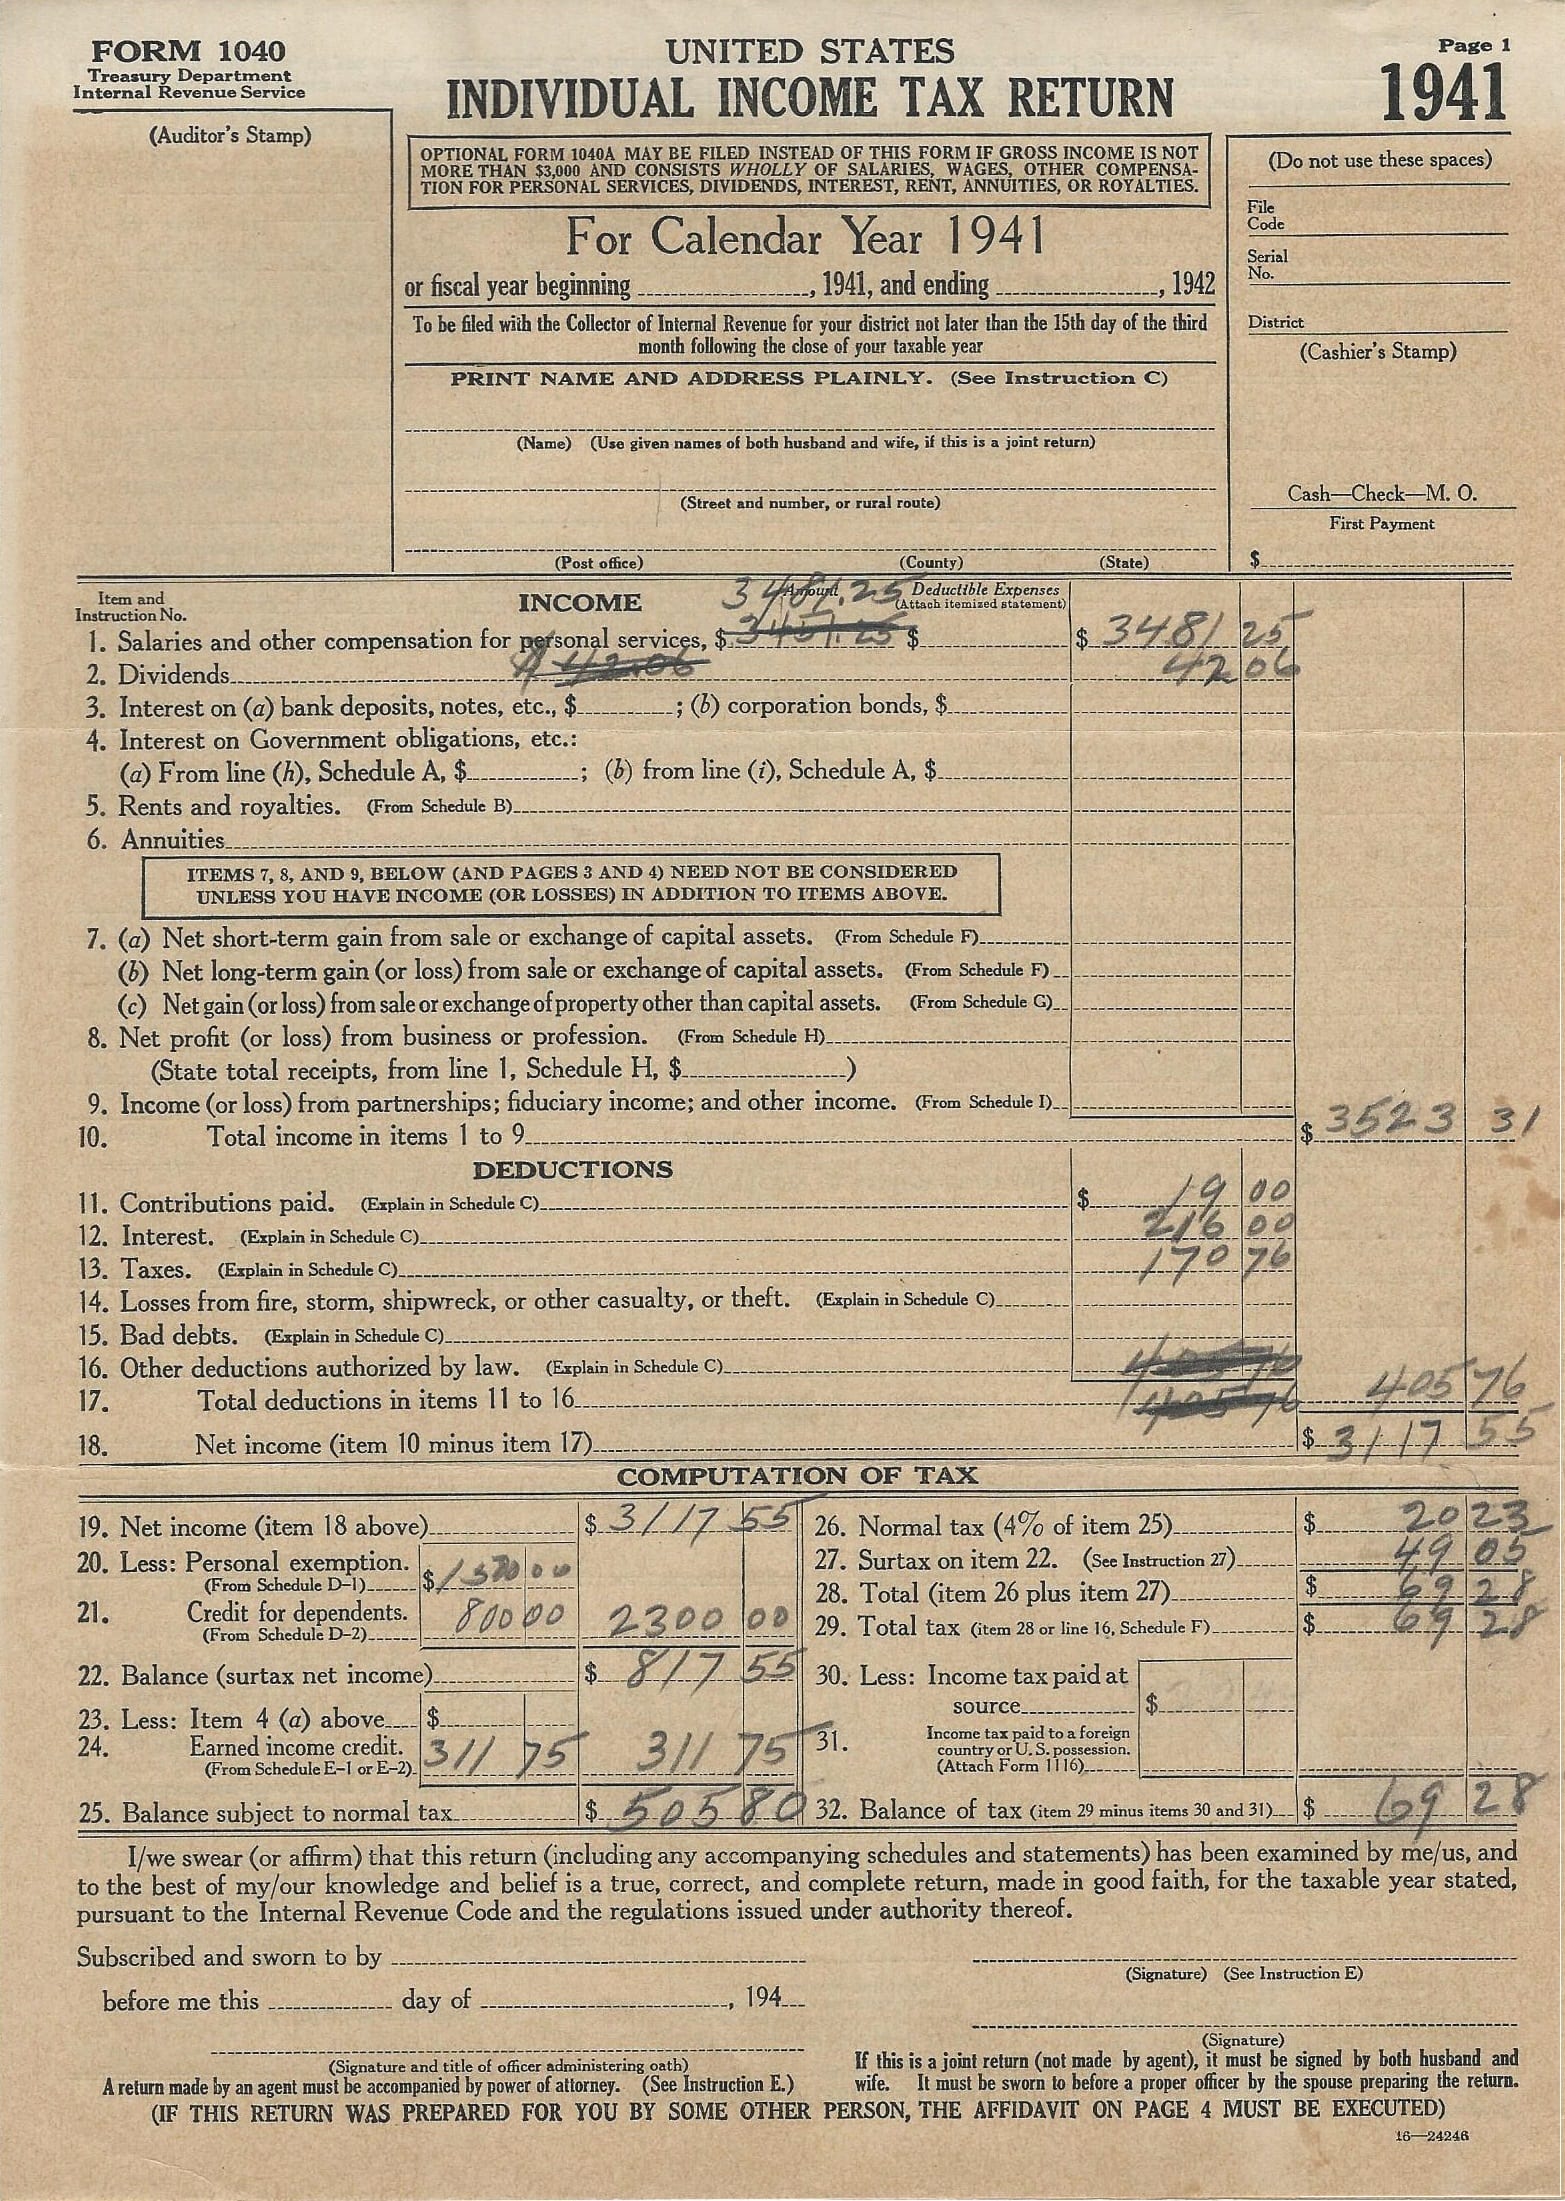
نموذج IRS Form 1040 للإقرار الضريبي الفردي في الولايات المتحدة، عام 1941؛ ملكية عامة (عمل حكومي أمريكي)، عبر Wikimedia Commons.

المهمتان اللتان لا تشترك فيهما أنظمة OCR عادةً
تمنحك أنظمة OCR التقليدية نصاً بالإضافة إلى إحداثيات: "كلمة 'Total' تقع عند البكسل (412, 88)". هذا هو بالضبط ما تحتاجه إذا كنت تقوم بإنشاء ملف PDF قابل للبحث، أو تحجب حقولاً حساسة، أو تغذي محللاً لتخطيط الصفحات (layout parser). إنها عملية دقيقة ومكانية، لكنها لا تفهم البنية؛ فهي لا تدرك ما إذا كانت كتلة النص تمثل صفاً في جدول، أو تعليقاً توضيحياً، أو حاشية سفلية.
أما توليد Markdown من الصور (Image-to-markdown generation) فيتبع نهجاً معاكساً؛ حيث تقوم بتزويد النظام بلقطة شاشة لمستند، فتحصل في المقابل على ## Section Header وعمودين في جدول | Column | Column | وسطر إجمالي بنص **bold**. هذا النهج يلتقط البنية والنمط، وهو بالضبط ما تريده عند نقل مستند إلى LLM، أو فهرس بحث، أو ويكي. لكنه عادةً ما يتجاهل مواقع البكسل الدقيقة، لأن لغة markdown لا تمتلك نظام إحداثيات.
يتعامل KOSMOS-2.5 مع هاتين المهمتين كنوعين مختلفين من المهارة الأساسية ذاتها، وهي "القراءة الآلية للصور كثيفة النصوص"، حيث يتم تدريب نموذج واحد للقيام بأي منهما بناءً على الأمر (prompt). فإذا طلبت منه OCR، ستحصل على كتل نصية مرتبطة بمواقع مكانية، وإذا طلبت منه markdown، ستحصل على مخرجات مهيكلة ومنسقة. ومن الناحية التقنية، يستخدم النموذج نفس الأوزان (weights) ونفس وحدة فك التشفير (decoder) المشتركة، ويتم توجيهه فقط بناءً على رمز المهمة (task token) الذي يتم تزويده به.
كيف يتعلم النموذج اللغوي رؤية الصفحة
يعتمد KOSMOS-2.5 على وصفة مألوفة من منهجية نماذج الرؤية واللغة (vision-language models): حيث يقوم vision encoder بتحليل الصورة، ثم يقوم resampler بضغط تلك البيانات إلى عدد محدود من الـ tokens، بينما يتولى decoder-only autoregressive transformer توليد المخرجات token تلو الآخر، تماماً كما تولد نماذج GPT النصوص. أما نقطة الاختلاف هنا فهي طبيعة المخرجات المطلوبة؛ فبدلاً من مجرد كتابة وصف مثل "صورة لمستند"، تم تدريب النموذج على إخراج نصوص مرتبطة بإحداثيات (coordinate-tagged text spans) أو بصيغة markdown، وذلك بناءً على الأمر (prompt) المعطى له.
والمقصود بـ Autoregressive هنا هو أن النموذج يتوقع الـ token التالي بناءً على كل ما قام بتوليده سابقاً، وهو النهج القياسي لكل من النصوص، وبشكل متزايد، مخرجات المستندات المهيكلة. وما يميز هذا الأسلوب عن مسارات OCR التقليدية هو أن النموذج لا يقوم بخطوة كشف منفصلة (لتحديد مناطق النص) ثم خطوة تعرّف منفصلة (لقراءة ما في كل منطقة)، بل ينفذ العمليتين معاً في عملية توليد مستمرة واحدة، وهو أمر يشبه طريقة كتابة النموذج اللغوي الكبير لفقرة نصية أكثر من طريقة مسح محرك OCR كلاسيكي للصفحة.
أما "النظام الغذائي" للتدريب فهو الجزء الذي يفسر الأداء فعلياً: 357.4 مليون صفحة مستند، تم جمعها من مصادر متنوعة تشمل مستندات ممسوحة ضوئياً، وصفحات مُصيرة عبر الويب (web-rendered pages)، وأنواعاً أخرى من الصور كثيفة النصوص. يمثل هذا corpus ضخماً حقاً لهذا النوع من التدريب المسبق المتخصص، وهو السبب في قدرة النموذج على التعامل مع أنواع من المستندات تتجاوز بكثير الصفحات المطبوعة والنظيفة. إن حجم بيانات التدريب، أكثر من الذكاء في التصميم المعماري، يظل هو الإجابة التقليدية ولكن الحقيقية حول سبب قدرة هذه النماذج على التعميم (generalize).
تقييم النموذج: معياران جديدان لم يسبق وجودهما
تكمن إحدى المساهمات غير المقدرة حق قدرها في هذه الورقة البحثية في الجانب الإجرائي لا المعماري؛ حيث قام المؤلفون ببناء معيارين جديدين للتقييم، وهما OCREval و MarkdownEval، وذلك تحديداً لأن معايير OCR الحالية لم تكن تختبر الجوانب التي تهمهم. فإذا كنت تدعي أن النموذج يجيد الـ spatial OCR وتوليد الـ markdown، فأنت بحاجة إلى مجموعات تقييم تقيس كلا الأمرين فعلياً، ويبدو أن هذه المجموعات لم تكن موجودة بنطاق مفيد قبل ذلك.
وفي هذه المعايير، يقدم KOSMOS-2.5 أداءً مقارباً لـ GPT-4o، النموذج متعدد الوسائط الرائد من OpenAI، في مهام التعرف على النصوص على مستوى المستند (document-level text recognition) وتحويل الصور إلى markdown. وهذا ادعاء لافت لنظام أصغر بنحو مرتبتين عشريتين (two orders of magnitude) مما يُعتقد أن حجم GPT-4o عليه. لا يعني هذا أن KOSMOS-2.5 يتفوق على GPT-4o في جميع الجوانب، والورقة البحثية لا تدعي ذلك، بل تعني أنه في المهام المحددة والدقيقة المتمثلة في قراءة صور المستندات وتحويلها إلى نصوص مهيكلة، استطاع نموذج أصغر بكثير ومصمم لهذا الغرض أن يقلص معظم الفجوة مع هذا العملاق متعدد الأغراض.
هذا نمط يستحق استيعابه عند اختيار أدوات OCR: النماذج متعددة الوسائط العامة هي نماذج شاملة ومبهرة، ولكن نموذجاً أصغر تم تدريبه خصيصاً على مئات الملايين من صفحات المستندات يمكنه مضاهاة أدائها في مهمة قراءة المستندات تحديداً، وبجزء بسيط من تكلفة الحوسبة لكل استدعاء.
نسخة الدردشة: نفس العقل، ولكن بضبط دقيق للإجابة على الأسئلة
لم يتوقف البحث عند مجرد النسخ النصي الخام؛ بل قام المؤلفون بإجراء عملية ضبط دقيق (fine-tuning) لنموذج KOSMOS-2.5 لإنتاج نسخة مطورة تسمى KOSMOS-2.5-CHAT. تهدف هذه النسخة إلى فهم المستندات بدلاً من مجرد نسخها، مما يعني قدرتها على الإجابة عن أسئلة تتعلق بصورة المستند بدلاً من الاكتفاء بقراءتها.
وعند تقييمه عبر تسعة معايير مرجعية للإجابة على الأسئلة البصرية الغنية بالنصوص (visual question-answering benchmarks) — مثل "ما هو المجموع الكلي في هذا الإيصال؟" أو "من وقع هذا النموذج؟" — أظهر KOSMOS-2.5-CHAT أداءً يضاهي النماذج العامة الرائدة الأخرى التي تفوقه حجماً بنحو خمس مرات، حيث يمتلك 1.3 billion parameters مقابل 7 billion parameters. هذا هو الادعاء الرئيسي للورقة البحثية فيما يخص الكفاءة، وهو يتماشى مع الفكرة العامة: أن التخصص في بيانات المستندات يمنحك قدراً كبيراً من القدرات التي كان سيتطلب توفيرها عادةً زيادة ضخمة في عدد المعلمات (parameters).
بالنسبة لأي شخص يبني منتجاً يعتمد على نموذج كهذا، فإن ادعاء الكفاءة هذا أهم من مجرد أرقام الدقة الخام. فنموذج بحجم 1.3B أرخص بكثير من حيث تكلفة التشغيل، وأسرع في التنفيذ، وأسهل في إجراء عمليات الضبط الدقيق الإضافية مقارنة بنموذج 7B. وإذا كان هذا النموذج يمنحك 90% من أداء النموذج الأكبر في مهام الـ document-QA، فإن ذلك يمثل قراراً استراتيجياً في البنية التحتية، وليس مجرد ملاحظة بحثية هامشية.
أين تكمن نقاط الضعف: القيود الواقعية
توضح الورقة البحثية بكل شفافية أن هذه المشكلة لم تُحل بشكل نهائي بعد. وهناك عدة نقاط يجدر الانتباه إليها لكل من يفكر في الاعتماد على هذا النوع من النماذج:
- على الرغم من ضخامة مجموعة بيانات التدريب التي شملت 357.4 مليون صفحة، إلا أنها تظل شريحة مختارة من أنواع المستندات. لذا، فإن تخطيطات الصفحات التي لم يسبق للنموذج رؤيتها بكثرة أثناء التدريب، أو النصوص المكتوبة برموز غير شائعة، أو الخطوط ذات التنسيقات الفنية المبالغ فيها، أو الجداول شديدة الكثافة، أو الكتابة اليدوية، ستؤدي بشكل متوقع إلى تراجع جودة مخرجات الـ OCR المكانية وعملية إعادة بناء الـ markdown.
- تتطلب عملية توليد الـ Markdown نوعاً من التقدير الشخصي للهيكل التنظيمي؛ فقد يختلف شخصان عند النظر إلى تخطيط معقد (مثل الجداول المتداخلة، أو الأوراق البحثية متعددة الأعمدة، أو النماذج ذات الحقول غير المنتظمة) حول التمثيل "الصحيح" بصيغة markdown. هذا الغموض يجعل تفسير نتائج MarkdownEval أكثر صعوبة مقارنة بمقاييس معدل خطأ الحروف (character-error-rate) المباشرة.
- كون النموذج قابلاً للمقارنة مع GPT-4o في هذه الاختبارات المحددة لا يعني أنه يماثله في كل شيء. فنموذج GPT-4o يتعامل مع نطاق أوسع بكثير من مهام الاستنتاج والتحليل المتعلقة بالصور، بينما تم بناء KOSMOS-2.5 خصيصاً لقراءة وهيكلة الصور كثيفة النصوص.
- كما هو الحال في معظم اختبارات النماذج المنفردة، يعتمد الأداء في العالم الحقيقي بشكل كبير على مدى قرب مستنداتك من توزيع بيانات التدريب. فصورة إيصال تم مسحه ضوئياً بواسطة هاتف في إضاءة سيئة تختلف تماماً عن ملف PDF مصدّر بدقة، وأرقام الاختبارات الواردة في الورقة البحثية لن تخبرك بأي من الحالتين أنت تتعامل.
لماذا يهم هذا الأمر كل من يقوم ببناء مسارات معالجة المستندات (Document Pipelines)
إذا كنت تعمل على تطوير منتج يهدف إلى تحويل صور المستندات إلى نصوص قابلة للاستخدام، فإن KOSMOS-2.5 يمثل نقطة بيانات مفيدة من جانبين.
أولاً، هو دليل على أن التعرف الضوئي على الحروف المكاني (Spatial OCR) واستخراج النصوص بتنسيق markdown المنظم لا يجب أن يكونا نظامين منفصلين يتم دمجهما قسراً. إذ يمكن لنموذج واحد، إذا تم تدريبه بالطريقة الصحيحة، أن يلبي كلا الاحتياجين، مما يبسط العمليات الهندسية من جانبك: استدعاء واحد للنموذج بدلاً من إجراء عملية OCR ثم عملية منفصلة لإعادة بناء التنسيق (Layout-reconstruction). وتبرز أهمية هذا التكامل بشكل خاص عند التعامل مع اللغة العربية، حيث تزيد طبيعة الخط المتصل (Cursive) وتغير أشكال الحروف حسب موقعها في الكلمة من تعقيد عمليات الـ OCR.
ثانياً، ومن الناحية العملية، يعزز هذا النموذج حقيقة تستحق التذكر عند مقارنة محركات OCR: الحجم الأكبر ليس دائماً هو العامل الحاسم. فقد تمكن نموذج بـ 1.3B parameter، تم تدريبه على مئات الملايين من صفحات المستندات، من سد معظم الفجوة مع GPT-4o في قراءة المستندات، وتساوى مع النماذج العامة ذات الـ 7B في الإجابة على الأسئلة المتعلقة بالمستندات (Document Q&A). فإذا كانت حالة الاستخدام الخاصة بك هي تحديداً "استخراج نصوص منظمة من المستندات"، فإن نموذجاً مصمماً خصيصاً لهذه المهمة يمكن أن يتفوق على نموذج أكبر وأكثر عمومية من حيث تكلفة الحوسبة مقابل الأداء، وهو بالضبط نوع المقايضة التي تستحق الاختبار بدلاً من الافتراض.
الخلاصة العملية ليست "استخدم KOSMOS-2.5 تحديداً"، بل هي أنه عند اختيار محرك OCR أو محرك لتحليل المستندات، لا ينبغي أن يكون السؤال الوحيد هو مدى حجم النموذج أو عدد الاختبارات القياسية (Benchmarks) التي يتصدرها. بل السؤال الأهم هو: هل تم تدريب النموذج فعلياً على مستندات تشبه مستنداتك؟ وهل يخرج البيانات بالشكل الذي يحتاجه مسار المعالجة لديك — سواء كانت إحداثيات (Coordinates)، أو markdown، أو أي شيء آخر تماماً — دون إجبارك على إضافة نظام ثانٍ فوقه لتحقيق ذلك.