Microsoft 的 KOSMOS-2.5:一个 OCR 模型,两种截然不同的任务
参考论文: KOSMOS-2.5: A Multimodal Literate Model — Tengchao Lv, Yupan Huang, Jingye Chen, Yuzhong Zhao, Yilin Jia, Lei Cui, Shuming Ma, Yaoyao Chang, Shaohan Huang, Wenhui Wang, Li Dong, Weiyao Luo, Shaoxiang Wu, Guoxin Wang, Cha Zhang, Furu Wei
两种截然不同的 OCR 任务
想象两个人盯着同一张扫描的发票。一个人是法庭记录员,负责转录每一个词,并精确记录其在页面上的位置,精确到像素级。另一个人则是编辑,将文档重新构建为简洁的 markdown 格式:这里是一个表格,这里是一个标题,这里是一个加粗的总计。输入相同,但输出形式完全不同,下游用途也截然不同。
大多数 OCR 系统会选择其中一项工作并进行专业化。微软的 KOSMOS-2.5(在该公司研究部门 2023 年 9 月的一篇论文中有所描述)则通过同一个 1.3-billion-parameter 模型被训练来同时完成这两项任务,仅需通过不同的 prompt 即可在两者之间切换。这就是该模型的核心卖点,而且它比初听起来更有趣,因为这两项任务通常会将模型推向相反的方向。
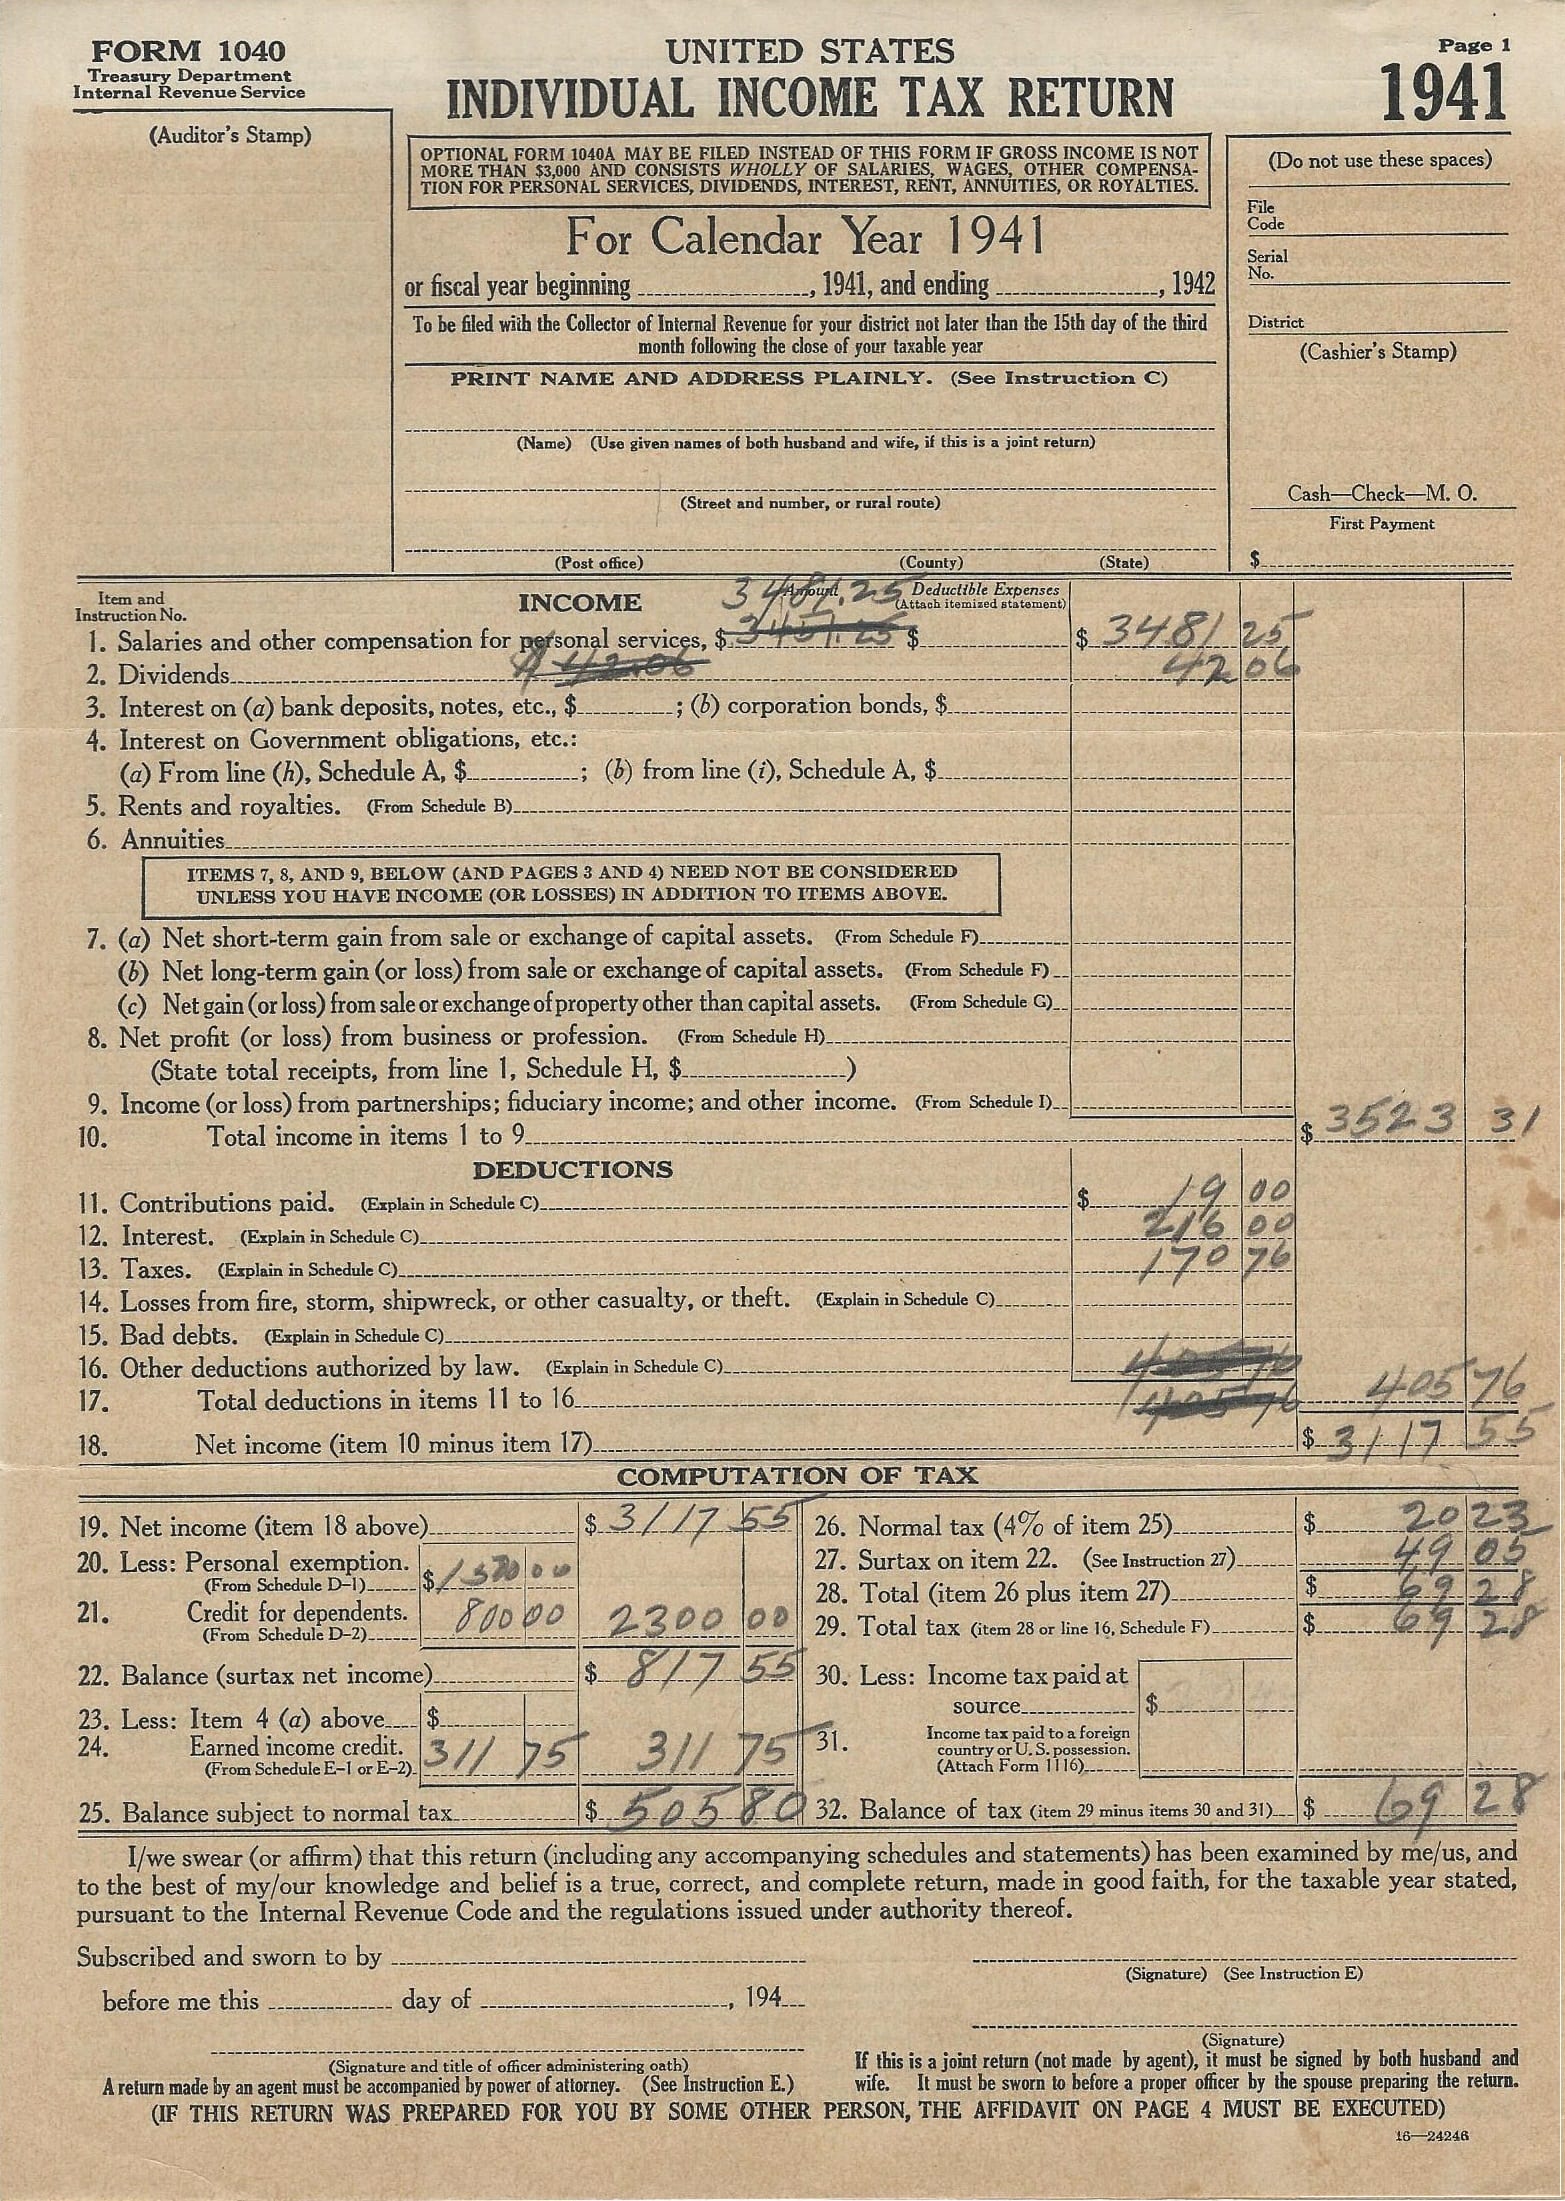
美国 IRS Form 1040 个人所得税申报表,1941 年;公有领域(美国政府作品),经由 Wikimedia Commons 提供。

OCR 系统通常不兼顾的两项任务
传统的 OCR 为你提供文本及其坐标,例如:“单词 'Total' 位于像素点 (412, 88)”。如果你在构建可搜索的 PDF、脱敏敏感字段或为下游布局解析器提供数据,这就是你所需要的。这种方式精确且具备空间感,但它不理解结构——它无法分辨一段文本究竟是表格的一行、一个标题还是一个脚注。
而“图像转 Markdown”生成则采取了完全不同的逻辑。你输入一份文档的截图,得到的是 ## Section Header、| Column | Column | 格式的表格以及 **bold** 加粗的总计行。它捕捉的是结构和样式,这正是将文档输入到 LLM、搜索索引或 Wiki 时所需要的。但它通常会舍弃精确的像素位置,因为 Markdown 并没有坐标系统。
KOSMOS-2.5 将这两者视为同一项底层能力——“文本密集型图像的机器阅读”——的不同表现形式,并训练一个模型通过 prompt 来执行其中任何一项任务。要求它进行 OCR,你将获得具有空间定位的文本块;要求它生成 markdown,你将获得结构化且带有样式的输出。在底层,它们使用相同的权重和共享的 decoder,仅由你输入的任务 token 来引导方向。
语言模型如何学习“阅读”页面
KOSMOS-2.5 采用了视觉语言模型中非常经典的架构方案:由一个 vision encoder 观察图像,一个 resampler 将其压缩为可处理的 token 数量,最后由一个 decoder-only 的自回归 transformer 逐个 token 地生成输出,其方式与 GPT 模型生成文本完全一致。而这里的巧妙之处在于它被要求生成的内容:它不再仅仅是生成像“一张文档照片”这样的描述,而是根据给定的 prompt,被训练为输出带有坐标标记的文本片段或 markdown 语法。
这里的“自回归”是指模型基于目前已生成的所有内容来预测下一个 token,这是目前语言模型以及结构化文档输出的标准方法。这与传统的 OCR 流程不同之处在于,该模型不需要运行独立的检测步骤(寻找文本区域)然后再运行独立的识别步骤(读取每个区域的内容)。它在一次连续的生成过程中同时完成这两项任务,这更像是一个大语言模型在写段落,而不是传统 OCR 引擎在扫描页面。
而真正决定性能的是其训练数据:3.574 亿页文档页面,来源涵盖了扫描文档、网页渲染页面以及其他文本密集型图像。对于这类专门的预训练来说,这是一个规模极其庞大的语料库,这也是该模型能够处理远超纯净打印页面的各种文档类型的原因。相比于架构上的精巧,训练数据的规模往往才是这些模型具备泛化能力那个虽然枯燥但却真实的原因。
模型评级:两个前所未有的新基准
这篇论文中一个被低估的贡献不在于架构,而在于流程:作者构建了两个全新的基准测试 OCREval 和 MarkdownEval,原因在于现有的 OCR 基准无法测试他们关注的核心指标。如果你声称一个模型能够出色地完成空间 OCR 和 Markdown 生成,你就需要能够实际衡量这两项能力的评估集,而显然在此之前,并没有这种规模且可用的评估集。
在这些基准测试中,KOSMOS-2.5 在文档级文本识别和图像转 Markdown 生成方面的表现与 OpenAI 的旗舰多模态模型 GPT-4o 相当。对于一个规模可能比 GPT-4o 小约两个数量级的模型来说,这是一个非常显著的结论。这并不意味着 KOSMOS-2.5 在所有方面都击败了 GPT-4o,论文也没有这样主张。它的意思是,在“读取文档图像并将其转换为结构化文本”这一狭窄且定义明确的任务上,一个规模小得多的专用模型已经弥补了与通用巨头之间的大部分差距。
如果你正在选择 OCR 工具,这是一个值得内化的规律:通用多模态模型是令人印象深刻的全才,但在专门针对数亿页文档页面训练的小模型,在文档读取这一特定任务上可以与它们相媲美,而单次调用的计算成本仅为前者的一小部分。
聊天版本:相同的“大脑”,针对问答进行了微调
该论文并未止步于原始的文本转录。作者将 KOSMOS-2.5 微调成了一个名为 KOSMOS-2.5-CHAT 的变体,其目标是实现文档理解而非纯粹的转录。这意味着它能够回答关于文档图像的问题,而不仅仅是将内容读出来。
在九个富文本的视觉问答(VQA)基准测试中(例如“这张收据的总额是多少”或“谁签署了这份表格”),KOSMOS-2.5-CHAT 的表现与其他最先进的通用模型相当,而后者规模大约是它的五倍(1.3 billion 参数对比 7 billion 参数)。这是该论文在效率方面的主要主张,也符合其核心主题:针对文档数据的专业化训练,可以提供大量原本需要通过增加参数量才能获得的能力。
对于任何基于此类模型构建产品的人来说,这种效率提升比单纯的准确率数字更为重要。与 7B 模型相比,1.3B 模型的部署成本大幅降低,运行速度更快,且更容易进行进一步微调。如果它能达到大模型在文档问答性能上的 90%,那么这将成为一个实际的基础设施决策,而不仅仅是一个研究注脚。
实际失效的场景:坦诚的局限性
论文坦率地指出,这个问题尚未被完全解决。对于考虑基于此类模型进行开发的人员,有几点值得关注:
- 尽管 357.4 million 页的训练语料库规模庞大,但它仍然是文档类型的精选子集。对于模型在训练期间较少接触的文档布局、不常见的脚本、高度风格化的字体、极其密集的表格以及手写体,其空间 OCR 输出和 markdown 重建质量预计都会有所下降。
- Markdown 的生成涉及对结构的主观判断。面对复杂的布局(如嵌套表格、多栏学术论文、字段位置不规则的表单),两个人类观察者可能会对“正确”的 markdown 表示方式产生分歧。这种模糊性使得 MarkdownEval 分数的解读比简单的字符错误率(character-error-rate)指标更困难。
- 在这些特定基准测试中与 GPT-4o 相当,并不意味着在所有方面都相当。GPT-4o 能处理围绕图像的更广泛的推理任务;而 KOSMOS-2.5 是专门为读取和结构化文本密集型图像而设计的。
- 与大多数单模型基准测试一样,实际性能在很大程度上取决于你的文档与训练分布的接近程度。在光线不足的情况下用手机扫描的收据,与干净的 PDF 导出文件完全是两回事,而论文中的基准测试数据无法告诉你具体面对的是哪一种情况。
为什么这对构建文档流水线的开发者至关重要
如果你正在开发一款需要将文档图像转换为可用文本的产品,KOSMOS-2.5 在两个方面提供了极具参考价值的启示。
首先,它证明了空间 OCR 和结构化 markdown 提取不必是两个强行拼接的独立系统。一个经过正确训练的单一模型可以同时满足这两个需求,从而简化你的工程实现:只需一次模型调用,而不再需要先进行 OCR 扫描,再进行单独的布局重建。对于处理汉字等复杂且密集的表意文字脚本,这种端到端的整合能更有效地捕捉紧凑的布局信息。
其次,从更实际的角度来看,它提醒我们在对比 OCR 引擎时,模型规模并非决定性因素。一个在数亿页文档上训练的 1.3B 参数模型,在文档阅读能力上已大幅缩小与 GPT-4o 的差距,并在文档问答方面与 7B 的通用模型持平。如果你的具体需求是“从文档中提取结构化文本”,那么一个专为该任务打造的模型,在单位计算成本上的表现可能优于规模大得多的通用模型。这种权衡值得实际测试,而非凭经验假设。
实际的启示并非是“必须使用 KOSMOS-2.5”,而是在选择 OCR 或文档解析引擎时,不应只关注模型规模或基准测试排名。关键在于:该模型是否在与你业务场景相似的文档上进行过训练?它输出的数据格式(无论是坐标、markdown 还是其他形式)是否直接符合你流水线的需求,而无需你为了获得最终结果而被迫在上方叠加第二个系统。