Microsoft का KOSMOS-2.5: एक OCR Model, दो बिल्कुल अलग काम
आधारित शोध-पत्र: KOSMOS-2.5: A Multimodal Literate Model — Tengchao Lv, Yupan Huang, Jingye Chen, Yuzhong Zhao, Yilin Jia, Lei Cui, Shuming Ma, Yaoyao Chang, Shaohan Huang, Wenhui Wang, Li Dong, Weiyao Luo, Shaoxiang Wu, Guoxin Wang, Cha Zhang, Furu Wei
दो अलग-अलग दृष्टिकोण
कल्पना कीजिए कि दो लोग एक ही स्कैन किए हुए इनवॉइस (invoice) को देख रहे हैं। उनमें से एक कोर्ट रिपोर्टर है, जो हर शब्द को ट्रांसक्राइब कर रहा है और पिक्सेल-दर-पिक्सेल यह नोट कर रहा है कि वह शब्द पेज पर ठीक कहाँ स्थित है। दूसरा एक एडिटर है, जो उस दस्तावेज़ को क्लीन markdown के रूप में फिर से तैयार कर रहा है: यह एक टेबल है, यह एक हेडर है, और यह बोल्ड किया हुआ टोटल है। इनपुट एक ही है, लेकिन आउटपुट का स्वरूप और उसका आगे का उपयोग पूरी तरह से अलग है।
ज़्यादातर OCR सिस्टम इनमें से किसी एक काम को चुनते हैं और उसी में माहिर होते हैं। Microsoft का KOSMOS-2.5, जिसका वर्णन कंपनी के रिसर्च डिवीजन के सितंबर 2023 के एक पेपर में किया गया है, को एक ही 1.3-billion-parameter मॉडल से ये दोनों काम करने के लिए ट्रेन किया गया है, और यह केवल एक अलग प्रॉम्प्ट (prompt) के ज़रिए इनके बीच स्विच कर सकता है। यही इसकी मुख्य विशेषता है, और यह सुनने में जितना सरल लगता है, उससे कहीं अधिक दिलचस्प है, क्योंकि ये दो कार्य आमतौर पर एक मॉडल को विपरीत दिशाओं में खींचते हैं।
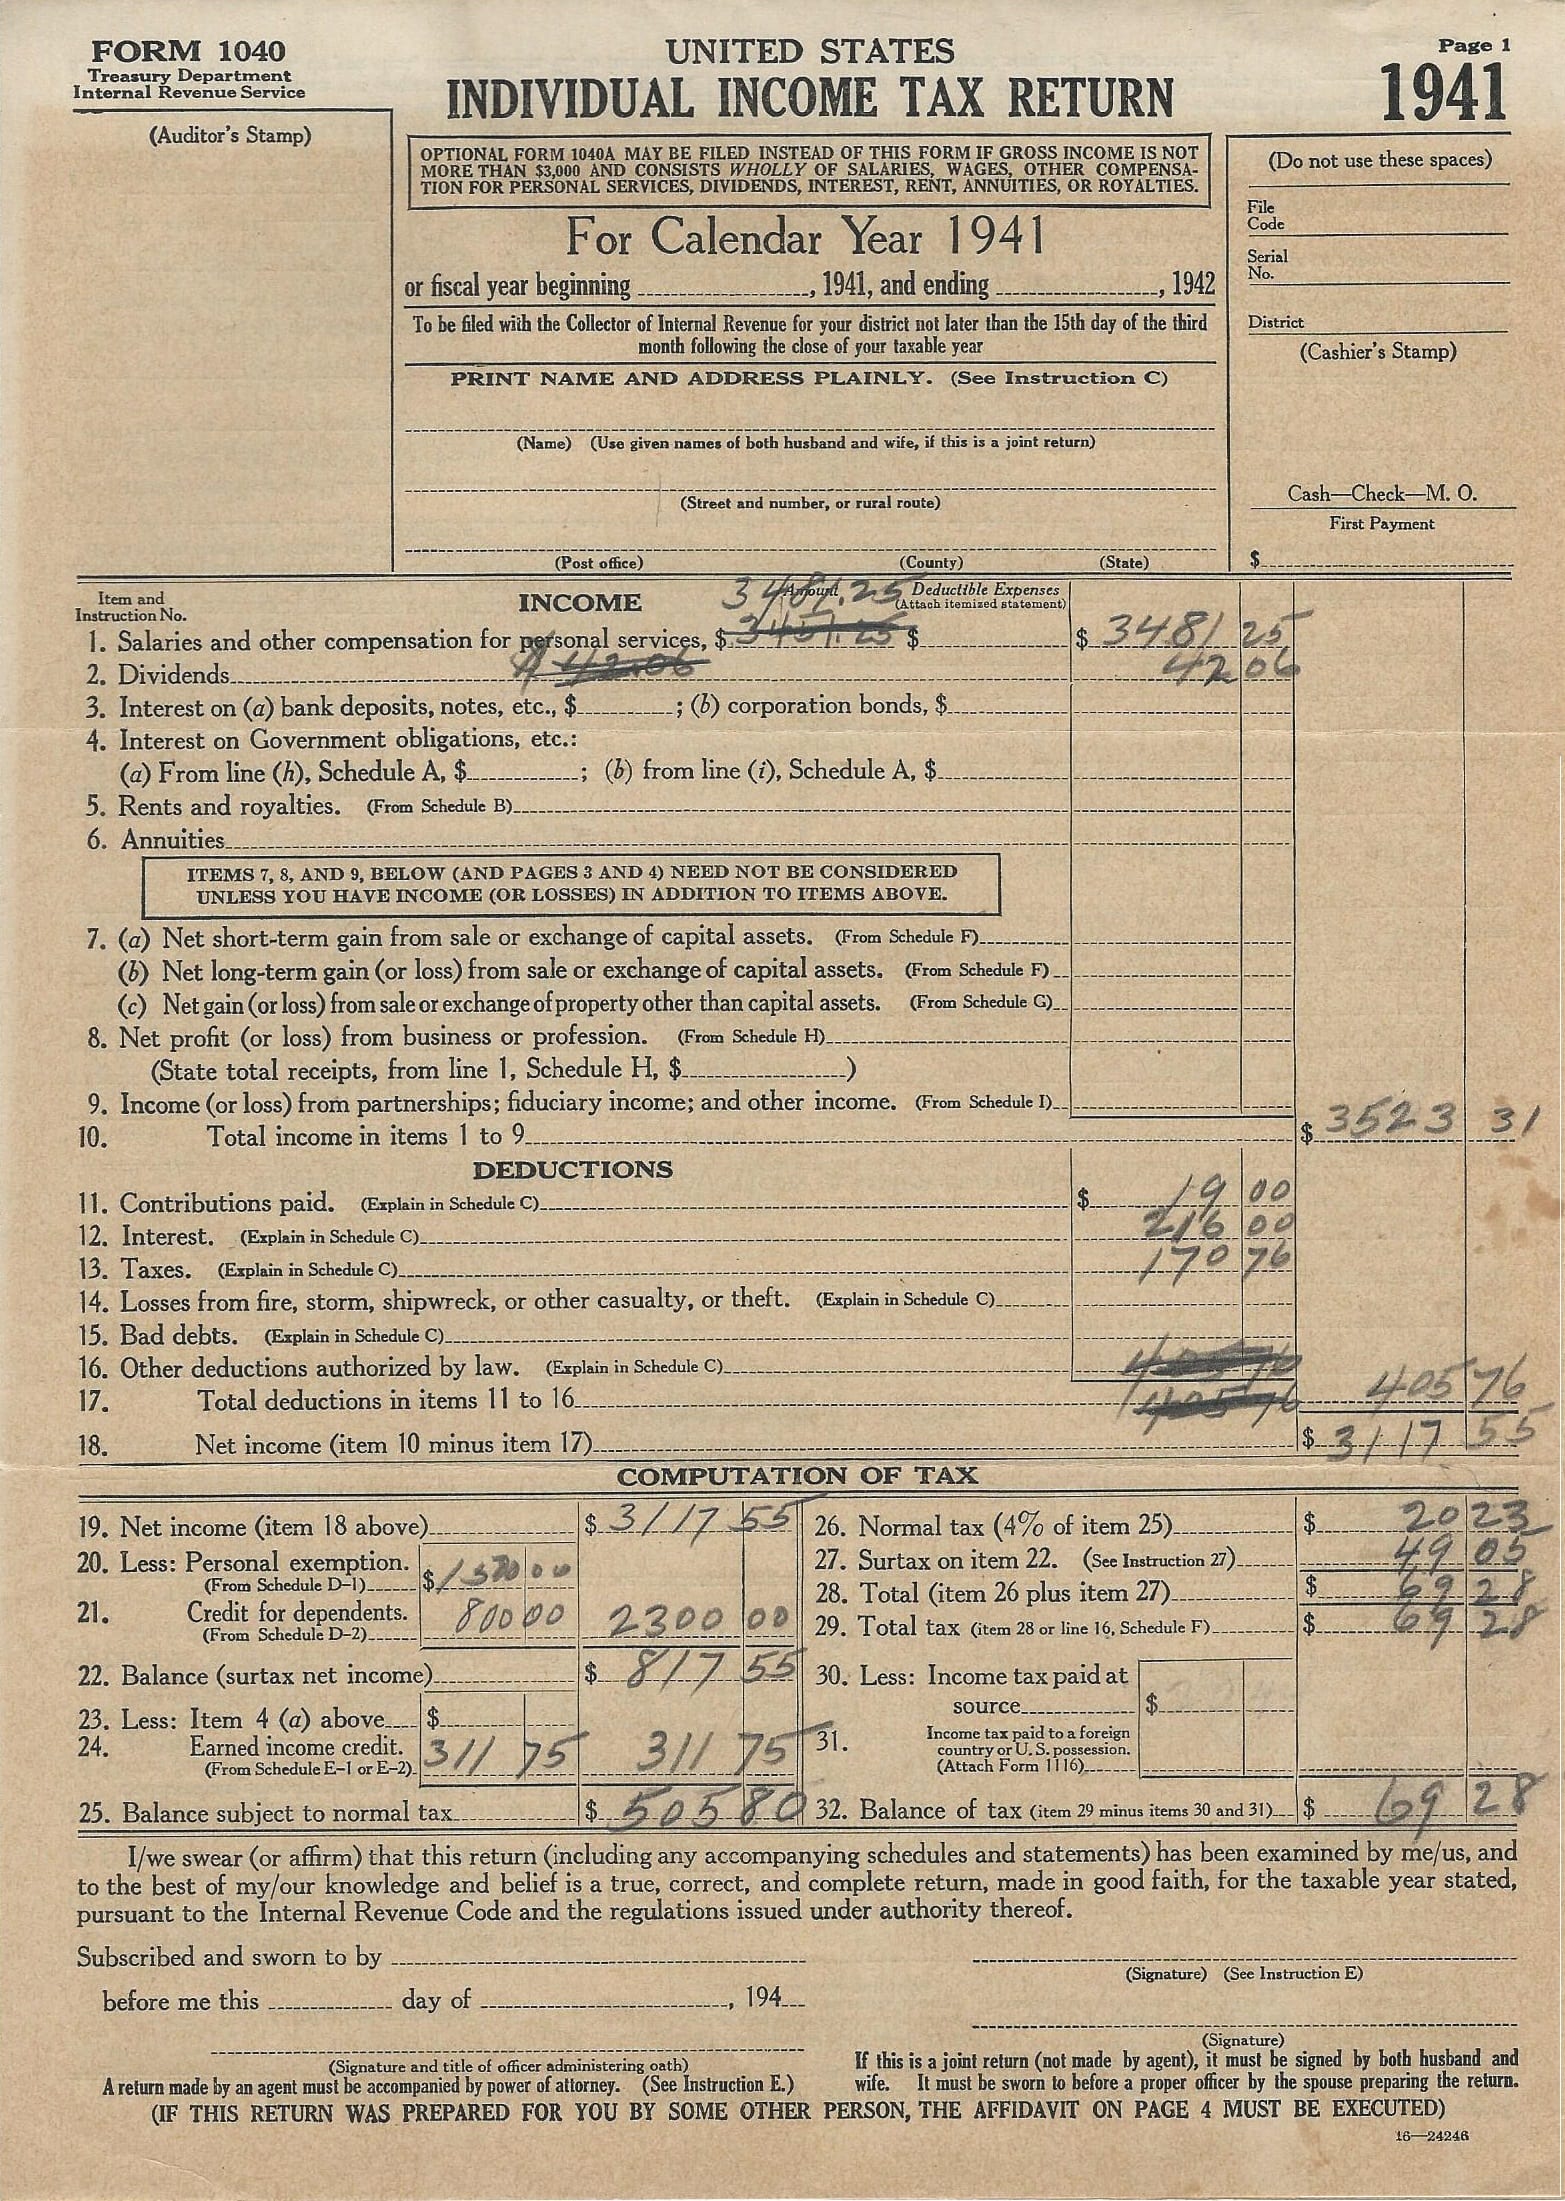
U.S. IRS Form 1040 individual income tax return, 1941; public domain (U.S. Government work), via Wikimedia Commons.

वे दो काम जो OCR सिस्टम आमतौर पर एक साथ नहीं करते
पारंपरिक OCR आपको टेक्स्ट के साथ उसके कोऑर्डिनेट्स (coordinates) देता है: "शब्द 'Total' पिक्सेल (412, 88) पर स्थित है।" अगर आप एक सर्च करने योग्य PDF बना रहे हैं, संवेदनशील फ़ील्ड्स को हटा रहे हैं, या किसी डाउनस्ट्रीम लेआउट पार्सर (layout parser) का उपयोग कर रहे हैं, तो आपको इसी की ज़रूरत होती है। यह सटीक और स्थानिक (spatial) होता है, लेकिन यह स्ट्रक्चर को नहीं समझता। इसे यह नहीं पता होता कि टेक्स्ट का एक ब्लॉक टेबल की रो (row) है, कोई कैप्शन है या फिर कोई फुटनोट।
Image-to-markdown जनरेशन इसके बिल्कुल विपरीत है। आप किसी डॉक्यूमेंट का स्क्रीनशॉट देते हैं और बदले में आपको ## Section Header, एक | Column | Column | टेबल, और एक **bold** टोटल लाइन मिलती है। यह स्ट्रक्चर और स्टाइल को कैप्चर करता है, जो कि तब बहुत काम आता है जब आप किसी डॉक्यूमेंट को LLM, सर्च इंडेक्स या विकी (wiki) में भेज रहे हों। लेकिन इसमें आमतौर पर सटीक पिक्सेल पोजीशन हटा दी जाती हैं, क्योंकि markdown में कोई कोऑर्डिनेट सिस्टम नहीं होता।
KOSMOS-2.5 इन दोनों को एक ही बुनियादी कौशल, "machine reading of text-intensive images" के दो अलग-अलग रूप मानता है, और एक ही मॉडल को प्रॉम्प्ट (prompt) के आधार पर दोनों काम करने के लिए ट्रेन करता है। यदि आप इससे OCR मांगते हैं, तो आपको spatially grounded टेक्स्ट ब्लॉक्स मिलते हैं। यदि आप markdown मांगते हैं, तो आपको स्ट्रक्चर्ड और स्टाइल वाला आउटपुट मिलता है। अंदरूनी तौर पर यह वही वेट्स (weights) और वही साझा डिकोडर (shared decoder) है, जिसे बस टास्क टोकन (task token) के ज़रिए निर्देशित किया जाता है।
एक लैंग्वेज मॉडल पेज को देखना कैसे सीखता है
KOSMOS-2.5 को विजन-लैंग्वेज मॉडल के एक जाने-पहचाने तरीके (recipe) पर बनाया गया है: एक vision encoder इमेज को देखता है, एक resampler उसे टोकन की एक सीमित संख्या में कंप्रेस करता है, और एक decoder-only autoregressive transformer एक-एक करके आउटपुट टोकन जेनरेट करता है, ठीक उसी तरह जैसे GPT मॉडल्स टेक्स्ट जेनरेट करते हैं। यहाँ नया मोड़ यह है कि मॉडल से क्या जेनरेट करने के लिए कहा जाता है। सिर्फ "एक दस्तावेज़ की फोटो" जैसा कैप्शन देने के बजाय, इसे प्रॉम्प्ट के आधार पर या तो coordinate-tagged text spans या markdown syntax आउटपुट करने के लिए ट्रेन किया गया है।
यहाँ Autoregressive का सीधा सा मतलब है कि मॉडल अब तक जेनरेट किए गए सभी डेटा के आधार पर अगले टोकन की भविष्यवाणी (predict) करता है। यह तरीका लैंग्वेज और अब स्ट्रक्चर्ड डॉक्यूमेंट आउटपुट, दोनों के लिए स्टैंडर्ड बन चुका है। इसे एक साधारण OCR पाइपलाइन से अलग बनाने वाली बात यह है कि मॉडल कोई अलग डिटेक्शन स्टेप (टेक्स्ट रीजन ढूंढना) और फिर अलग रिकग्निशन स्टेप (हर रीजन में क्या लिखा है उसे पढ़ना) नहीं चलाता। यह दोनों काम एक ही continuous generation pass में करता है, जो एक क्लासिक OCR इंजन द्वारा पेज स्कैन करने के बजाय, एक लार्ज लैंग्वेज मॉडल द्वारा पैराग्राफ लिखने के तरीके के अधिक करीब है।
इसकी ट्रेनिंग डाइट ही असल में इसके परफॉरमेंस का कारण है: 357.4 मिलियन डॉक्यूमेंट पेज, जिन्हें स्कैन किए गए दस्तावेज़ों, वेब-रेंडर्ड पेजों और अन्य टेक्स्ट-डेंस इमेज प्रकारों के मिश्रण से लिया गया है। इस तरह की स्पेशलाइज्ड प्रीट्रेनिंग के लिए यह वास्तव में एक बहुत बड़ा कॉर्पस (corpus) है, और यही कारण है कि यह मॉडल साफ-सुथरे प्रिंटेड पेजों से कहीं अधिक विविध प्रकार के डॉक्यूमेंट्स को संभाल सकता है। आर्किटेक्चरल चतुराई के बजाय, ट्रेनिंग डेटा का पैमाना (scale) ही वह साधारण लेकिन सटीक जवाब है कि ये मॉडल्स इतनी अच्छी तरह से generalize कैसे कर पाते हैं।
मॉडल का मूल्यांकन: दो नए बेंचमार्क जो पहले किसी के पास नहीं थे
इस पेपर का एक ऐसा योगदान जिसकी पर्याप्त सराहना नहीं की गई है, वह आर्किटेक्चरल होने के बजाय प्रक्रियात्मक (procedural) है: लेखकों ने दो नए बेंचमार्क, OCREval और MarkdownEval बनाए, क्योंकि मौजूदा OCR बेंचमार्क उन पहलुओं का परीक्षण नहीं कर रहे थे जो उनके लिए महत्वपूर्ण थे। यदि आप यह दावा कर रहे हैं कि कोई मॉडल spatial OCR और markdown generation को अच्छी तरह से करता है, तो आपको ऐसे मूल्यांकन सेट (evaluation sets) की आवश्यकता होती है जो वास्तव में इन दोनों को माप सकें, और स्पष्ट रूप से इस पेपर से पहले उपयोगी पैमाने पर ऐसे सेट मौजूद नहीं थे।
इन बेंचमार्क पर, KOSMOS-2.5 दस्तावेज़-स्तर की text recognition और image-to-markdown generation में OpenAI के फ्लैगशिप मल्टीमॉडल मॉडल GPT-4o के समान प्रदर्शन करता है। यह एक उल्लेखनीय दावा है, क्योंकि KOSMOS-2.5 आकार में GPT-4o के अनुमानित आकार से लगभग दो orders of magnitude छोटा है। इसका मतलब यह नहीं है कि KOSMOS-2.5 हर मामले में GPT-4o को मात देता है, और पेपर ऐसा दावा नहीं कर रहा है। इसका अर्थ यह है कि दस्तावेज़ छवियों को पढ़ने और उन्हें structured text में बदलने जैसे सीमित और स्पष्ट कार्यों में, एक छोटा और विशेष उद्देश्य के लिए बनाया गया मॉडल, एक सामान्य-उद्देश्य वाले विशाल मॉडल के साथ अंतर को काफी हद तक कम कर देता है।
यदि आप OCR टूलिंग का चयन कर रहे हैं, तो यह एक ऐसा पैटर्न है जिसे समझना ज़रूरी है: सामान्य-उद्देश्य वाले मल्टीमॉडल मॉडल प्रभावशाली generalists होते हैं, लेकिन करोड़ों दस्तावेज़ पृष्ठों पर विशेष रूप से प्रशिक्षित एक छोटा मॉडल, दस्तावेज़ पढ़ने के विशिष्ट कार्य में उनके बराबर प्रदर्शन कर सकता है, और वह भी प्रति कॉल कंप्यूट लागत के एक छोटे से हिस्से पर।
चैट वर्ज़न: वही क्षमता, लेकिन सवालों के लिए फाइन-ट्यून किया गया
यह पेपर केवल रॉ ट्रांसक्रिप्शन (raw transcription) तक ही सीमित नहीं है। लेखकों ने KOSMOS-2.5 को फाइन-ट्यून करके एक वेरिएंट तैयार किया है जिसे KOSMOS-2.5-CHAT कहा जाता है। इसका उद्देश्य शुद्ध ट्रांसक्रिप्शन के बजाय डॉक्यूमेंट अंडरस्टैंडिंग (document understanding) है, जिसका अर्थ है कि यह किसी डॉक्यूमेंट इमेज को केवल पढ़ने के बजाय उससे जुड़े सवालों के जवाब दे सकता है।
नौ टेक्स्ट-रिच विजुअल क्वेश्चन-आंसरिंग बेंचमार्क्स (जैसे "इस रसीद का कुल योग क्या है" या "इस फॉर्म पर किसने हस्ताक्षर किए हैं") पर मूल्यांकन करने पर, KOSMOS-2.5-CHAT का प्रदर्शन अन्य स्टेट-ऑफ-द-आर्ट जनरलिस्ट मॉडल्स के समान ही पाया गया, जो आकार में लगभग पांच गुना बड़े हैं (7 बिलियन के मुकाबले 1.3 बिलियन पैरामीटर्स)। यह इस पेपर का मुख्य दक्षता दावा (efficiency claim) है, और यह एक व्यापक थीम के अनुरूप है: डॉक्यूमेंट डेटा पर स्पेशलाइजेशन आपको वह क्षमता प्रदान करता है जिसे अन्यथा केवल पैरामीटर्स की संख्या बढ़ाकर हासिल किया जाता।
किसी भी व्यक्ति के लिए जो इस तरह के मॉडल पर आधारित प्रोडक्ट बना रहा है, यह दक्षता दावा रॉ एक्यूरेसी नंबर से कहीं अधिक महत्वपूर्ण है। 7B मॉडल की तुलना में 1.3B मॉडल को सर्व करना काफी सस्ता है, यह चलाने में तेज़ है और इसे आगे फाइन-ट्यून करना आसान है। यदि यह आपको बड़े मॉडल के डॉक्यूमेंट-QA प्रदर्शन का 90% परिणाम देता है, तो यह केवल एक रिसर्च फुटनोट नहीं, बल्कि इंफ्रास्ट्रक्चर से जुड़ा एक वास्तविक निर्णय है।
यह वास्तव में कहाँ विफल होता है: ईमानदार सीमाएँ
पेपर में स्पष्ट रूप से स्वीकार किया गया है कि यह समस्या पूरी तरह से हल नहीं हुई है। जो कोई भी इस तरह के मॉडल पर काम करने पर विचार कर रहा है, उसके लिए कुछ बातें ध्यान देने योग्य हैं:
- 357.4-million-page का ट्रेनिंग कॉर्पस, हालांकि बड़ा है, फिर भी यह दस्तावेज़ प्रकारों का एक चुनिंदा हिस्सा है। ऐसे दस्तावेज़ लेआउट जिन्हें मॉडल ने ट्रेनिंग के दौरान ज्यादा नहीं देखा है, असामान्य लिपियाँ (scripts), अत्यधिक स्टाइल वाले फोंट्स, बहुत घने टेबल्स और हस्तलेखन (handwriting), स्वाभाविक रूप से spatial OCR आउटपुट और markdown reconstruction दोनों की गुणवत्ता को कम कर देंगे।
- Markdown जनरेशन में स्ट्रक्चर के बारे में एक निर्णय लेना शामिल होता है। एक जटिल लेआउट (जैसे nested tables, मल्टी-कॉलम अकादमिक पेपर, या अनियमित फील्ड प्लेसमेंट वाले फॉर्म) को देखने वाले दो इंसान भी इस बात पर असहमत हो सकते हैं कि इसका "सही" markdown प्रतिनिधित्व क्या होना चाहिए। यह अस्पष्टता MarkdownEval स्कोर्स को एक साधारण character-error-rate मेट्रिक की तुलना में समझना अधिक कठिन बना देती है।
- इन विशिष्ट बेंचमार्क्स पर GPT-4o के बराबर होने का मतलब यह नहीं है कि यह हर चीज़ में उसके बराबर है। GPT-4o किसी इमेज से जुड़े रीजनिंग टास्क की एक बहुत विस्तृत श्रृंखला को संभालता है; जबकि KOSMOS-2.5 को विशेष रूप से टेक्स्ट-डेंस इमेजेस को पढ़ने और स्ट्रक्चर करने के लिए बनाया गया है।
- अधिकांश सिंगल-मॉडल बेंचमार्क्स की तरह, वास्तविक दुनिया में प्रदर्शन इस बात पर बहुत निर्भर करता है कि आपके दस्तावेज़ ट्रेनिंग डिस्ट्रीब्यूशन के कितने करीब हैं। खराब रोशनी में फोन से स्कैन की गई रसीद, एक क्लीन PDF एक्सपोर्ट से बिल्कुल अलग होती है, और पेपर के बेंचमार्क नंबर आपको यह नहीं बताएंगे कि आप इनमें से किस स्थिति का सामना कर रहे हैं।
डॉक्यूमेंट पाइपलाइन्स बनाने वालों के लिए यह क्यों महत्वपूर्ण है
अगर आप ऐसा प्रोडक्ट बना रहे हैं जिसे डॉक्यूमेंट इमेजेस को इस्तेमाल करने योग्य टेक्स्ट में बदलना है, तो KOSMOS-2.5 दो मोर्चों पर एक उपयोगी डेटा पॉइंट है।
पहला, यह इस बात का सबूत है कि spatial OCR और structured markdown extraction को दो अलग-अलग सिस्टम्स के रूप में जोड़ने की ज़रूरत नहीं है। सही तरीके से ट्रेन किया गया एक सिंगल मॉडल दोनों ज़रूरतों को पूरा कर सकता है, जिससे आपकी इंजीनियरिंग आसान हो जाती है: अब आपको OCR पास और अलग से layout-reconstruction पास के बजाय सिर्फ एक मॉडल कॉल की ज़रूरत होगी।
दूसरा, और अधिक व्यावहारिक रूप से, यह एक ऐसी बात की पुष्टि करता है जिसे OCR इंजन की तुलना करते समय याद रखना ज़रूरी है: बड़ा मॉडल हमेशा निर्णायक कारक नहीं होता। करोड़ों डॉक्यूमेंट पेजेस पर ट्रेन किए गए 1.3B-parameter मॉडल ने डॉक्यूमेंट रीडिंग में GPT-4o के साथ अंतर को काफी कम कर दिया, और डॉक्यूमेंट Q&A में 7B generalist मॉडल्स की बराबरी की। हालांकि इंग्लिश OCR में मज़बूत प्रदर्शन का मतलब यह नहीं है कि Devanagari OCR भी उतना ही सटीक होगा, क्योंकि भारतीय लिपियों की जटिलता अलग होती है। अगर आपका यूज़ केस विशेष रूप से "डॉक्यूमेंट्स से structured text निकालना" है, तो ठीक उसी काम के लिए बनाया गया मॉडल, कंप्यूट कॉस्ट के हिसाब से एक बहुत बड़े और जनरल मॉडल से बेहतर प्रदर्शन कर सकता है—और यह एक ऐसा ट्रेड-ऑफ है जिसे मान लेने के बजाय टेस्ट करना ज़्यादा सही है।
इसका व्यावहारिक निष्कर्ष यह नहीं है कि "विशेष रूप से KOSMOS-2.5 का उपयोग करें।" बल्कि यह है कि जब आप OCR या डॉक्यूमेंट-पार्सिंग इंजन चुन रहे हों, तो सवाल सिर्फ यह नहीं होना चाहिए कि मॉडल कितना बड़ा है या उसने कितने बेंचमार्क्स टॉप किए हैं। सवाल यह होना चाहिए कि क्या मॉडल को वास्तव में उन डॉक्यूमेंट्स पर ट्रेन किया गया है जो आपके डेटा जैसे दिखते हैं, और क्या यह उसी शेप में डेटा आउटपुट करता है जिसकी आपकी पाइपलाइन को ज़रूरत है—चाहे वह coordinates हों, markdown हो, या कुछ और—ताकि आपको वहां तक पहुँचने के लिए ऊपर से कोई दूसरा सिस्टम न जोड़ना पड़े।