KOSMOS-2.5 de Microsoft: Un modelo de OCR, dos tareas muy diferentes
Basado en: KOSMOS-2.5: A Multimodal Literate Model — Tengchao Lv, Yupan Huang, Jingye Chen, Yuzhong Zhao, Yilin Jia, Lei Cui, Shuming Ma, Yaoyao Chang, Shaohan Huang, Wenhui Wang, Li Dong, Weiyao Luo, Shaoxiang Wu, Guoxin Wang, Cha Zhang, Furu Wei
Dos tareas, un solo modelo
Imagine a dos personas observando la misma factura escaneada. Una es un taquígrafo judicial que transcribe cada palabra y anota exactamente dónde se ubica en la página, hasta el último píxel. La otra es un editor que reconstruye el documento desde cero en un markdown limpio: esto es una tabla, esto es un encabezado, esto es un total en negrita. Misma entrada, pero una estructura de salida y un uso posterior completamente diferentes.
La mayoría de los sistemas de OCR eligen uno de esos roles y se especializan en él. El modelo KOSMOS-2.5 de Microsoft, descrito en un artículo de septiembre de 2023 de la división de investigación de la compañía, está entrenado para realizar ambas tareas desde el mismo modelo de 1.3-billion-parameter, alternando entre ellas simplemente mediante un prompt diferente. Esa es la propuesta central, y es más interesante de lo que parece a primera vista, ya que esas dos tareas suelen llevar al modelo en direcciones opuestas.
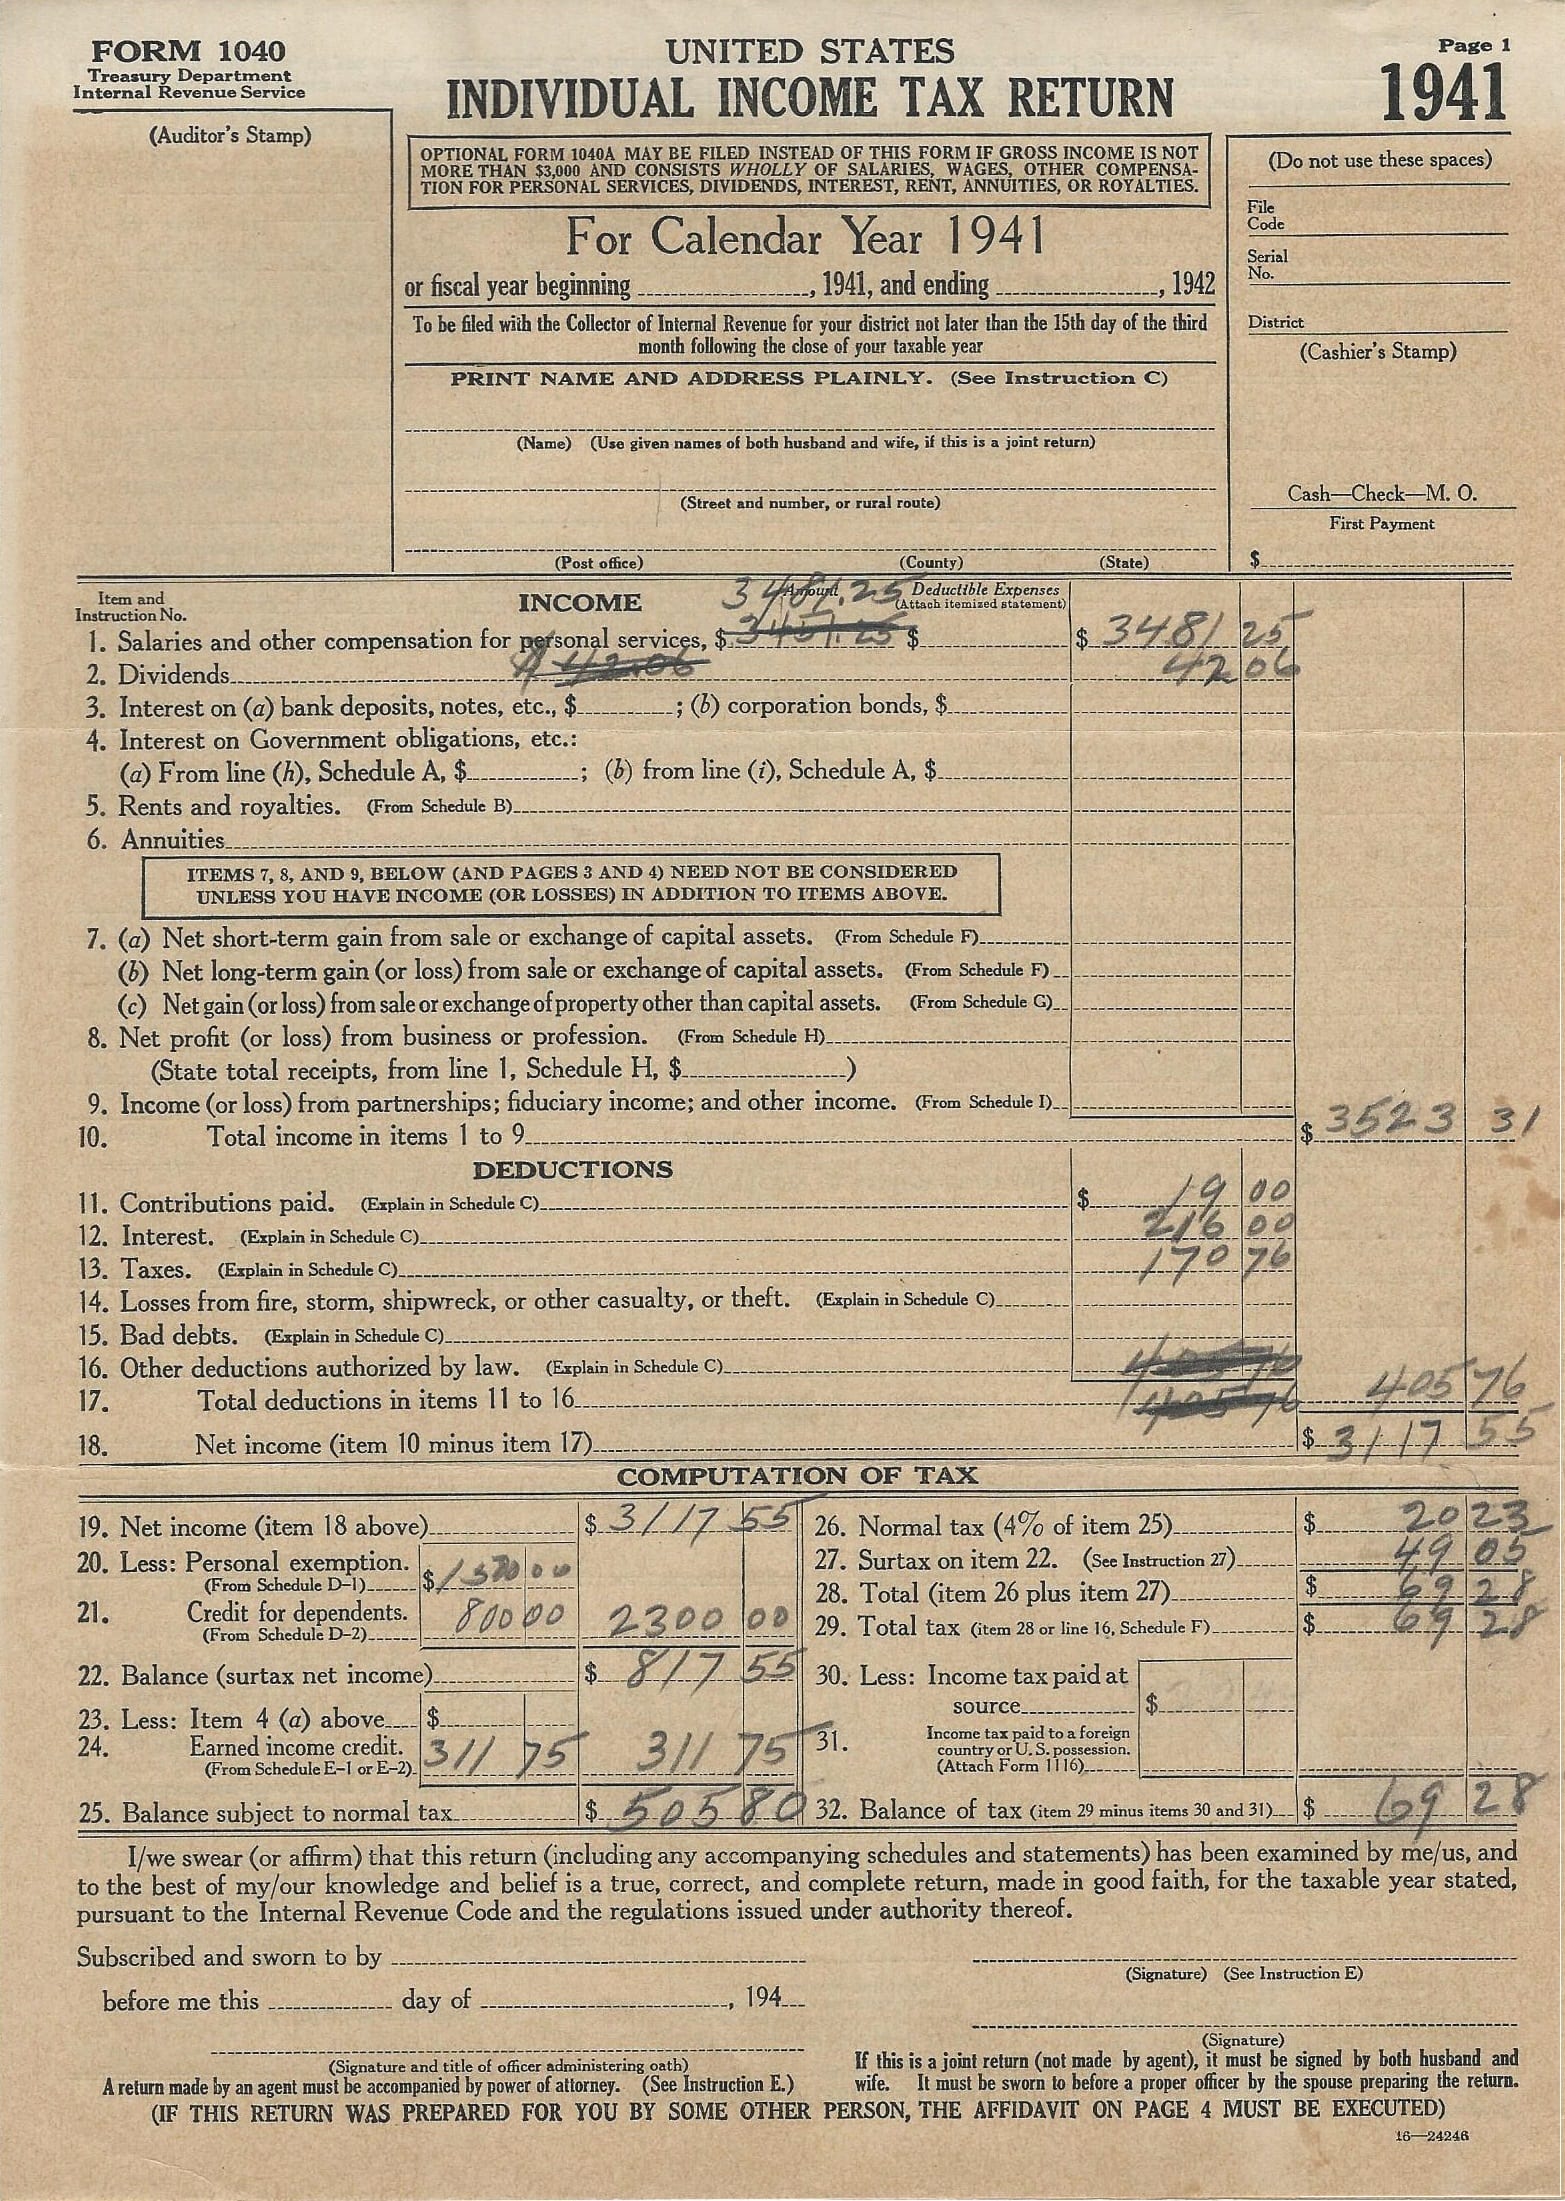
U.S. IRS Form 1040 individual income tax return, 1941; public domain (U.S. Government work), via Wikimedia Commons.

Las dos tareas que los sistemas de OCR no suelen compartir
El OCR tradicional te entrega el texto junto con sus coordenadas: "la palabra 'Total' se encuentra en el píxel (412, 88)". Esto es lo que necesitas si estás creando un PDF con búsqueda de texto, anonimizando campos sensibles o alimentando un analizador de diseño (layout parser) posterior. Es preciso y espacial, pero no comprende la estructura; no sabe si un bloque de texto es la fila de una tabla, un pie de foto o una nota al pie.
La generación de imagen a markdown sigue el instinto opuesto. Introduces la captura de pantalla de un documento y obtienes un ## Section Header, una tabla | Column | Column | o una línea de total en **negrita**. Esto captura la estructura y el estilo, que es exactamente lo que buscas si vas a enviar un documento a un LLM, a un índice de búsqueda o a una wiki. Sin embargo, generalmente descarta las posiciones exactas de los píxeles, ya que el markdown no posee un sistema de coordenadas.
KOSMOS-2.5 trata estas funciones como dos variantes de una misma habilidad fundamental, la "lectura automática de imágenes con alta densidad de texto", y entrena un único modelo para realizar cualquiera de las dos, seleccionada mediante un prompt. Si le pides OCR, obtienes bloques de texto con base espacial. Si le pides markdown, obtienes una salida estructurada y con estilo. Internamente, se utilizan los mismos pesos y el mismo decodificador compartido, simplemente guiados por el token de tarea que se le proporcione.
Cómo un modelo de lenguaje aprende a ver una página
KOSMOS-2.5 se basa en una receta familiar del manual de modelos de visión y lenguaje: un vision encoder analiza la imagen, un resampler la comprime en un número manejable de tokens y un transformer autoregresivo decoder-only genera la salida token por token, de la misma manera que los modelos GPT generan texto. El giro está en lo que se le pide generar. En lugar de limitarse a describir "una foto de un documento", está entrenado para producir fragmentos de texto etiquetados con coordenadas o sintaxis markdown, dependiendo del prompt recibido.
En este contexto, autoregresivo significa simplemente que el modelo predice el siguiente token basándose en todo lo que ha generado hasta el momento, el enfoque estándar tanto para el lenguaje como, cada vez más, para la salida de documentos estructurados. Lo que diferencia esto de un pipeline de OCR convencional es que el modelo no ejecuta un paso de detección independiente (buscar regiones de texto) y luego un paso de reconocimiento separado (leer lo que hay en cada región). Realiza ambos procesos en una única pasada de generación continua, lo cual se asemeja más a cómo un large language model escribe un párrafo que a cómo un motor de OCR clásico escanea una página.
La "dieta" de entrenamiento es la parte que realmente explica el rendimiento: 357.4 millones de páginas de documentos, extraídas de una mezcla de fuentes que abarcan documentos escaneados, páginas renderizadas de la web y otros tipos de imágenes con alta densidad de texto. Se trata de un corpus genuinamente masivo para este tipo de pretraining especializado, y es la razón por la cual el modelo puede manejar tipos de documentos que van mucho más allá de las páginas impresas y limpias. La escala de los datos de entrenamiento, más que la ingeniosidad arquitectónica, suele ser la respuesta aburrida pero cierta de por qué estos modelos generalizan.
Evaluando el modelo: dos nuevos benchmarks inéditos
Una contribución subestimada de este artículo es más procedimental que arquitectónica: los autores crearon dos nuevos benchmarks, OCREval y MarkdownEval, específicamente porque los benchmarks de OCR existentes no evaluaban los aspectos que a ellos les interesaban. Si se afirma que un modelo domina el OCR espacial y la generación de markdown, es necesario contar con conjuntos de evaluación que midan ambos factores, y aparentemente estos no existían a una escala útil hasta ahora.
En dichos benchmarks, KOSMOS-2.5 rinde de manera comparable a GPT-4o, el modelo multimodal insignia de OpenAI, tanto en el reconocimiento de texto a nivel de documento como en la generación de image-to-markdown. Esta es una afirmación notable para un modelo que es, aproximadamente, dos órdenes de magnitud más pequeño de lo que se cree que es GPT-4o. Esto no significa que KOSMOS-2.5 supere a GPT-4o en todos los aspectos, y el artículo no pretende sostener eso. Significa que, en las tareas específicas y bien definidas de leer imágenes de documentos y convertirlas en texto estructurado, un modelo mucho más pequeño y diseñado para tal fin logra cerrar la mayor parte de la brecha con un gigante de propósito general.
Este es un patrón que conviene interiorizar al elegir herramientas de OCR: los modelos multimodales de propósito general son generalistas impresionantes, pero un modelo más pequeño entrenado específicamente con cientos de millones de páginas de documentos puede igualarlos en la tarea concreta de lectura de documentos, a una fracción del coste computacional por llamada.
La versión de chat: el mismo cerebro, optimizado para preguntas
El artículo no se limita a la transcripción bruta. Los autores realizan un fine-tuning de KOSMOS-2.5 para crear una variante llamada KOSMOS-2.5-CHAT, orientada a la comprensión de documentos en lugar de la transcripción pura; esto significa que puede responder preguntas sobre la imagen de un documento en vez de simplemente leerlo.
Al evaluarlo en nueve benchmarks de visual question-answering ricos en texto —con preguntas del tipo "¿cuál es el total de este recibo?" o "¿quién firmó este formulario?"—, KOSMOS-2.5-CHAT rinde de manera comparable a otros modelos generalistas state-of-the-art que son aproximadamente cinco veces más grandes: 1.3 billion parameters frente a 7 billion. Esta es la principal afirmación de eficiencia del artículo y coincide con el tema general: la especialización en datos de documentos aporta gran parte de la capacidad que, de otro modo, tendría que proporcionar el conteo bruto de parámetros.
Para cualquiera que esté desarrollando un producto basado en un modelo como este, esa eficiencia es más importante que la cifra de precisión bruta. Un modelo de 1.3B es drásticamente más barato de desplegar, más rápido de ejecutar y más sencillo de seguir optimizando que uno de 7B. Si ofrece el 90% del rendimiento en document-QA del modelo más grande, estamos ante una decisión de infraestructura real y no solo ante una nota al pie de una investigación.
Dónde falla realmente: las limitaciones honestas
El artículo es claro al admitir que este no es un problema resuelto. Hay algunos puntos que vale la pena señalar para cualquiera que esté evaluando si construir sobre este tipo de modelo:
- El corpus de entrenamiento de 357.4 millones de páginas, aunque es extenso, sigue siendo una selección curada de tipos de documentos. Los diseños de página que el modelo no haya visto frecuentemente durante el entrenamiento, las escrituras inusuales, las fuentes muy estilizadas, las tablas extremadamente densas o la escritura a mano degradarán, previsiblemente, tanto la salida del OCR espacial como la reconstrucción en markdown.
- La generación de Markdown implica un juicio subjetivo sobre la estructura. Dos personas que observen un diseño complejo (tablas anidadas, artículos académicos de varias columnas, formularios con campos colocados irregularmente) podrían discrepar sobre cuál es la representación en markdown "correcta". Esa ambigüedad hace que las puntuaciones de MarkdownEval sean más difíciles de interpretar que una métrica directa de tasa de error de caracteres (character-error-rate).
- Ser comparable a GPT-4o en estos benchmarks específicos no significa ser comparable en todo. GPT-4o maneja un rango mucho más amplio de tareas de razonamiento sobre una imagen; KOSMOS-2.5 está diseñado específicamente para leer y estructurar imágenes con alta densidad de texto.
- Como ocurre con la mayoría de los benchmarks de un solo modelo, el rendimiento en el mundo real depende en gran medida de qué tan cercanos estén sus documentos a la distribución de entrenamiento. Un recibo escaneado con un teléfono y mala iluminación es un escenario muy distinto a la exportación de un PDF limpio, y las cifras del benchmark del artículo no le indicarán con cuál de los dos está tratando.
Por qué es importante para cualquiera que desarrolle pipelines de documentos
Si estás creando un producto que debe convertir imágenes de documentos en texto utilizable, KOSMOS-2.5 es un punto de referencia útil en dos aspectos.
Primero, es la prueba de que el OCR espacial y la extracción de markdown estructurado no tienen que ser dos sistemas separados ensamblados a la fuerza. Un único modelo, entrenado correctamente, puede cubrir ambas necesidades, lo que simplifica la ingeniería en tu lado: una sola llamada al modelo en lugar de una pasada de OCR seguida de una pasada independiente de reconstrucción de diseño.
Segundo, y de manera más práctica, refuerza algo que conviene recordar al comparar motores de OCR: el tamaño no siempre es el factor decisivo. Un modelo de 1.3B parámetros entrenado con cientos de millones de páginas de documentos logró cerrar la mayor parte de la brecha con GPT-4o en lectura de documentos, e igualó a modelos generalistas de 7B en Q&A de documentos. Si tu caso de uso es específicamente "extraer texto estructurado de documentos", un modelo diseñado exactamente para esa tarea puede superar a un modelo mucho más grande y general por cada dólar de cómputo; este es precisamente el tipo de compromiso que vale la pena probar en lugar de dar por sentado.
La conclusión práctica no es "usa específicamente KOSMOS-2.5". Es que, al elegir un motor de OCR o de análisis de documentos, la pregunta no es solo qué tan grande es el modelo o en cuántos benchmarks lidera. La pregunta es si el modelo fue realmente entrenado con documentos similares a los tuyos y si genera el formato de datos que tu pipeline necesita —coordenadas, markdown o cualquier otra cosa— sin obligarte a añadir un segundo sistema encima para lograrlo.