KOSMOS-2.5 da Microsoft: Um Modelo de OCR, Dois Trabalhos Muito Diferentes
Baseado em: KOSMOS-2.5: A Multimodal Literate Model — Tengchao Lv, Yupan Huang, Jingye Chen, Yuzhong Zhao, Yilin Jia, Lei Cui, Shuming Ma, Yaoyao Chang, Shaohan Huang, Wenhui Wang, Li Dong, Weiyao Luo, Shaoxiang Wu, Guoxin Wang, Cha Zhang, Furu Wei
Uma abordagem, múltiplos resultados
Imagine duas pessoas analisando a mesma fatura digitalizada. Uma é um escrivão judicial, transcrevendo cada palavra e anotando exatamente onde ela está na página, pixel por pixel. A outra é um editor, reconstruindo o documento do zero como um markdown limpo: isto é uma tabela, isto é um cabeçalho, isto é um total em negrito. A mesma entrada, mas formatos de saída completamente diferentes e finalidades distintas.
A maioria dos sistemas de OCR escolhe uma dessas funções e se especializa. O KOSMOS-2.5 da Microsoft, descrito em um artigo de setembro de 2023 da divisão de pesquisa da empresa, foi treinado para realizar ambas as tarefas a partir do mesmo modelo de 1.3-billion-parameter, alternando entre elas apenas com a mudança do prompt. Essa é a proposta central, e ela é mais interessante do que parece à primeira vista, pois essas duas tarefas geralmente puxam o modelo em direções opostas.
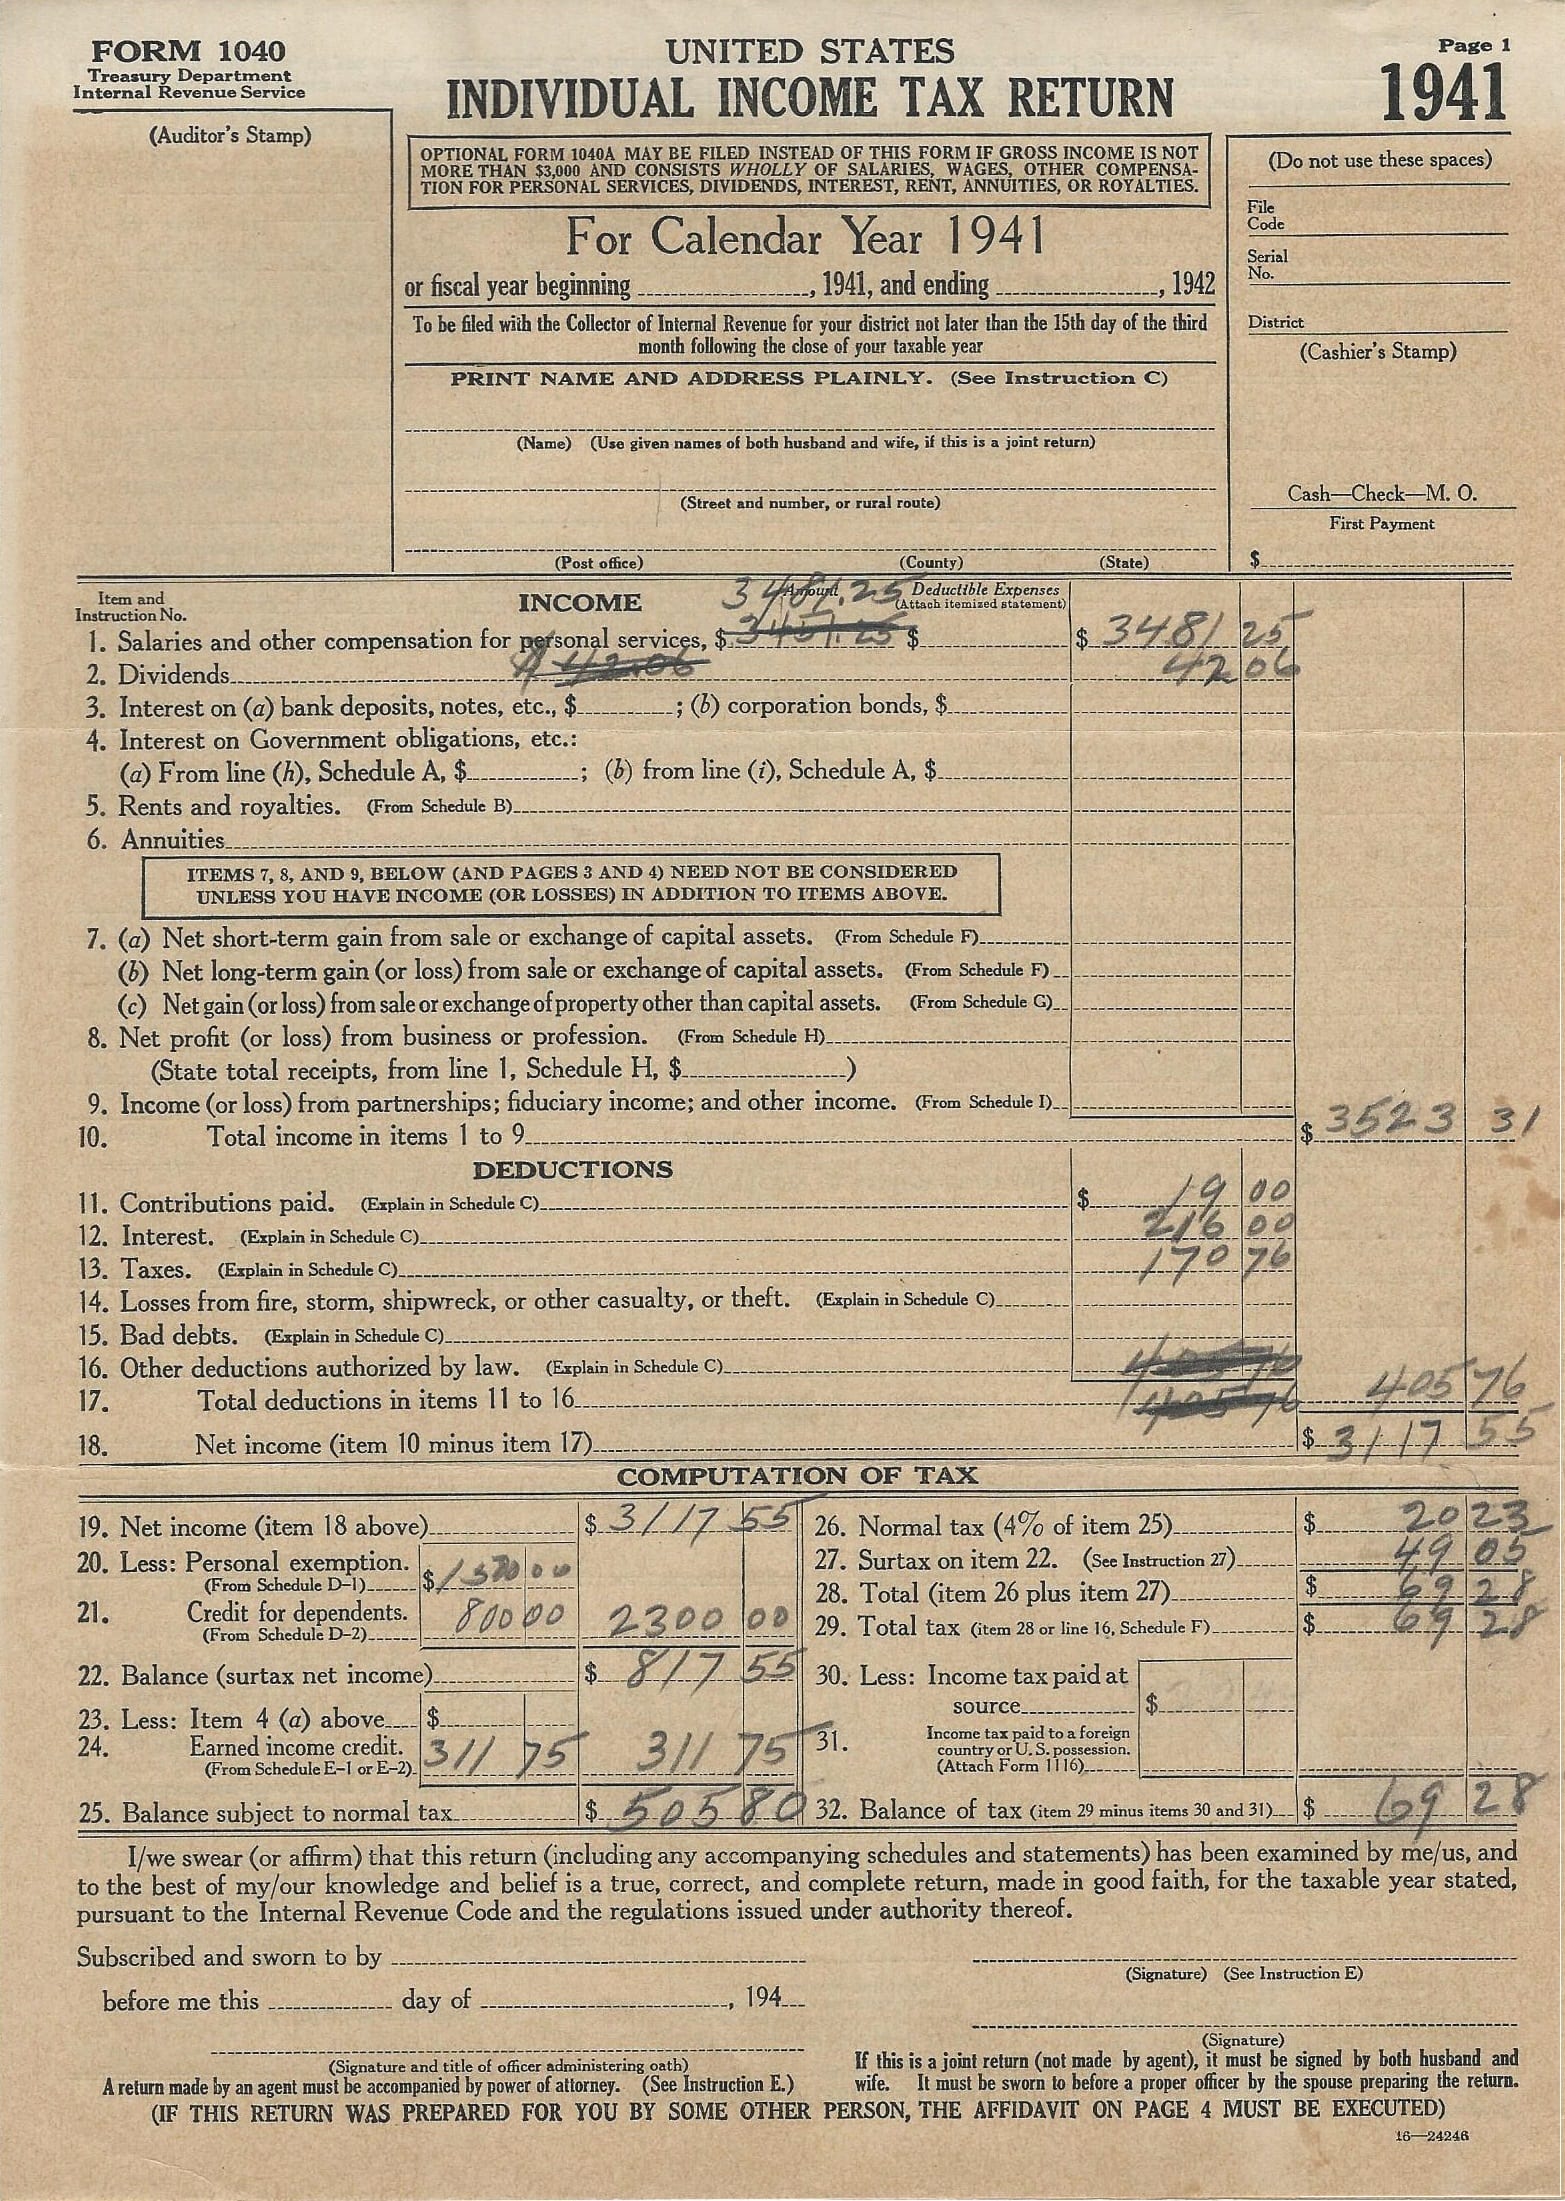
U.S. IRS Form 1040 individual income tax return, 1941; public domain (U.S. Government work), via Wikimedia Commons.

As duas funções que os sistemas de OCR geralmente não compartilham
O OCR tradicional fornece o texto acompanhado de coordenadas: "a palavra 'Total' está no pixel (412, 88)". É disso que você precisa ao criar um PDF pesquisável, redigir campos sensíveis ou alimentar um parser de layout posterior. É preciso e espacial, mas não compreende a estrutura. Ele não sabe se um bloco de texto é a linha de uma tabela, uma legenda ou uma nota de rodapé.
A geração de imagem para markdown segue o instinto oposto. Você insere a captura de tela de um documento e recebe um ## Section Header, uma tabela | Column | Column | ou uma linha de total em **negrito**. Isso captura a estrutura e o estilo, que é exatamente o que se deseja ao enviar um documento para um LLM, um índice de busca ou uma wiki. No entanto, geralmente descartam-se as posições exatas dos pixels, pois o markdown não possui um sistema de coordenadas.
O KOSMOS-2.5 trata essas funções como duas variações da mesma habilidade fundamental, a "leitura automatizada de imagens com alta densidade de texto", e treina um único modelo para realizar ambas, selecionadas via prompt. Peça OCR e você obterá blocos de texto com fundamentação espacial. Peça markdown e receberá uma saída estruturada e estilizada. Por baixo do capô, são os mesmos pesos e o mesmo decoder compartilhado, apenas direcionados pelo token de tarefa que você fornece.
Como um modelo de linguagem aprende a enxergar uma página
O KOSMOS-2.5 é construído com base em uma receita familiar do manual de modelos de visão-linguagem: um vision encoder analisa a imagem, um resampler a comprime em um número gerenciável de tokens e um transformer autoregressivo decoder-only gera a saída um token por vez, da mesma forma que os modelos GPT geram texto. O diferencial está no que ele é solicitado a gerar. Em vez de apenas legendar "uma foto de um documento", ele é treinado para produzir trechos de texto com tags de coordenadas ou sintaxe markdown, dependendo do prompt fornecido.
Neste contexto, autoregressivo significa apenas que o modelo prevê o próximo token com base em tudo o que gerou até agora, a abordagem padrão tanto para linguagem quanto, cada vez mais, para a saída de documentos estruturados. O que diferencia isso de um pipeline de OCR comum é que o modelo não executa uma etapa de detecção separada (encontrar regiões de texto) e depois uma etapa de reconhecimento separada (ler o que está em cada região). Ele faz ambos em uma única passagem de geração contínua, o que se assemelha mais à forma como um large language model escreve um parágrafo do que à maneira como um motor de OCR clássico escaneia uma página.
A "dieta" de treinamento é a parte que realmente explica o desempenho: 357,4 milhões de páginas de documentos, extraídas de um mix de fontes que abrangem documentos digitalizados, páginas renderizadas da web e outros tipos de imagens com alta densidade de texto. Esse é um corpus genuinamente vasto para esse tipo de pretraining especializado, e é a razão pela qual o modelo consegue lidar com tipos de documentos que vão muito além de páginas impressas e limpas. A escala dos dados de treinamento, mais do que a engenhosidade arquitetural, tende a ser a resposta tediosa, porém verdadeira, para o motivo pelo qual esses modelos generalizam.
Avaliando o modelo: dois novos benchmarks inéditos
Uma contribuição subestimada deste artigo é mais procedimental do que arquitetural: os autores criaram dois novos benchmarks, OCREval e MarkdownEval, especificamente porque os benchmarks de OCR existentes não testavam o que era relevante para eles. Se você afirma que um modelo realiza bem o OCR espacial e a geração de markdown, precisa de conjuntos de avaliação que realmente meçam ambos, e aparentemente eles não existiam em uma escala útil até então.
Nesses benchmarks, o KOSMOS-2.5 apresenta um desempenho comparável ao GPT-4o, o modelo multimodal carro-chefe da OpenAI, no reconhecimento de texto em nível de documento e na geração de image-to-markdown. Essa é uma afirmação notável para um modelo aproximadamente duas ordens de magnitude menor do que se acredita que o GPT-4o seja. Isso não significa que o KOSMOS-2.5 supere o GPT-4o em todos os aspectos, e o artigo não afirma isso. Significa que, nas tarefas específicas e bem definidas de ler imagens de documentos e convertê-las em texto estruturado, um modelo muito menor e construído para esse propósito reduz a maior parte da distância em relação a um gigante de propósito geral.
Este é um padrão importante de se internalizar ao escolher ferramentas de OCR: modelos multimodais de propósito geral são generalistas impressionantes, mas um modelo menor, treinado especificamente em centenas de milhões de páginas de documentos, pode igualá-los especificamente na tarefa de leitura de documentos, com uma fração do custo computacional por chamada.
A versão de chat: o mesmo cérebro, ajustado para perguntas
O artigo não se limita à transcrição bruta. Os autores realizaram o fine-tuning do KOSMOS-2.5 para criar uma variante chamada KOSMOS-2.5-CHAT, focada na compreensão de documentos em vez de apenas transcrição; ou seja, ele consegue responder a perguntas sobre a imagem de um documento, em vez de apenas lê-lo.
Avaliado em nove benchmarks de visual question-answering ricos em texto — com perguntas como "qual o valor total deste recibo" ou "quem assinou este formulário" —, o KOSMOS-2.5-CHAT apresenta um desempenho comparável a outros modelos generalistas de última geração que são aproximadamente cinco vezes maiores: 1,3 bilhão de parâmetros contra 7 bilhões. Essa é a principal reivindicação de eficiência do artigo e está alinhada ao tema central: a especialização em dados de documentos proporciona grande parte da capacidade que, de outra forma, teria de ser suprida por uma contagem bruta de parâmetros.
Para quem está desenvolvendo um produto baseado em um modelo como este, essa eficiência importa mais do que o número bruto de precisão. Um modelo de 1.3B é drasticamente mais barato de hospedar, mais rápido de executar e mais fácil de refinar do que um de 7B. Se ele entrega 90% do desempenho de document-QA do modelo maior, isso se torna uma decisão real de infraestrutura, e não apenas uma nota de rodapé de pesquisa.
Onde isso realmente falha: as limitações reais
O artigo é transparente ao admitir que este não é um problema totalmente resolvido. Alguns pontos importantes para quem está avaliando se deve construir soluções baseadas nesse tipo de modelo:
- O corpus de treinamento de 357,4 milhões de páginas, embora vasto, ainda é uma fatia selecionada de tipos de documentos. Layouts que o modelo não encontrou com frequência durante o treinamento, scripts incomuns, fontes excessivamente estilizadas, tabelas extremamente densas ou caligrafia, previsivelmente degradarão tanto a saída do OCR espacial quanto a reconstrução em markdown.
- A geração de Markdown envolve um julgamento sobre a estrutura. Dois humanos analisando um layout complexo (tabelas aninhadas, artigos acadêmicos com múltiplas colunas, formulários com campos irregulares) podem discordar sobre a representação "correta" em markdown. Essa ambiguidade torna as pontuações do MarkdownEval mais difíceis de interpretar do que uma métrica direta de taxa de erro de caracteres (character-error-rate).
- Ser comparável ao GPT-4o nestes benchmarks específicos não significa ser comparável em tudo. O GPT-4o lida com uma gama muito mais ampla de tarefas de raciocínio sobre uma imagem; o KOSMOS-2.5 foi projetado especificamente para ler e estruturar imagens com alta densidade de texto.
- Como acontece na maioria dos benchmarks de modelo único, o desempenho no mundo real depende fortemente de quão próximos seus documentos estão da distribuição de treinamento. Um recibo escaneado por um celular com iluminação ruim é algo completamente diferente de um PDF exportado com nitidez, e os números do benchmark do artigo não dirão com qual desses cenários você está lidando.
Por que isso é importante para quem constrói pipelines de documentos
Se você está desenvolvendo um produto que precisa transformar imagens de documentos em texto utilizável, o KOSMOS-2.5 é um ponto de referência útil em duas frentes.
Primeiro, ele prova que o OCR espacial e a extração de markdown estruturado não precisam ser dois sistemas distintos acoplados. Um único modelo, treinado da maneira correta, pode atender a ambas as necessidades, o que simplifica a engenharia do seu lado: uma única chamada de modelo em vez de uma etapa de OCR seguida por uma etapa separada de reconstrução de layout.
Segundo, e de forma mais prática, isso reforça algo fundamental ao comparar engines de OCR: tamanho nem sempre é o fator decisivo. Um modelo de 1.3B de parâmetros, treinado em centenas de milhões de páginas de documentos, reduziu a maior parte da distância em relação ao GPT-4o na leitura de documentos e se equiparou a modelos generalistas de 7B em Q&A de documentos. Se o seu caso de uso é especificamente "extrair texto estruturado de documentos", um modelo construído exatamente para essa função pode superar um modelo muito maior e mais geral por dólar de computação — e esse é precisamente o tipo de trade-off que vale a pena testar em vez de presumir.
A lição prática não é "use especificamente o KOSMOS-2.5". É que, ao escolher um engine de OCR ou de parsing de documentos, a pergunta a ser feita não é apenas qual o tamanho do modelo ou em quantos benchmarks ele lidera. A questão é se o modelo foi realmente treinado em documentos semelhantes aos seus e se ele entrega o formato de dados que seu pipeline necessita — coordenadas, markdown ou algo inteiramente diferente — sem forçá-lo a acoplar um segundo sistema para alcançar esse resultado.