MicrosoftのKOSMOS-2.5:1つのOCRモデルで、全く異なる2つのタスクをこなす
元論文: KOSMOS-2.5: A Multimodal Literate Model — Tengchao Lv, Yupan Huang, Jingye Chen, Yuzhong Zhao, Yilin Jia, Lei Cui, Shuming Ma, Yaoyao Chang, Shaohan Huang, Wenhui Wang, Li Dong, Weiyao Luo, Shaoxiang Wu, Guoxin Wang, Cha Zhang, Furu Wei
2つの異なるアプローチ
2人の人間が、同じスキャン済みの請求書をじっと見つめているところを想像してください。一人は法廷速記士で、すべての単語を書き起こし、それがページのどこに位置しているかをピクセル単位で正確に記録しています。もう一人は編集者で、ドキュメントをクリーンなmarkdownとしてゼロから再構築しています。「ここはテーブル」「ここはヘッダー」「ここは太字の合計金額」という具合に。入力は同じですが、出力の形式も、その後の活用方法も全く異なります。
ほとんどのOCRシステムは、これら2つの役割のうちどちらか一方を選択し、それに特化しています。しかし、Microsoftのリサーチ部門が2023年9月の論文で発表したKOSMOS-2.5は、1.3-billion-parameterの単一モデルでこの両方をこなすようトレーニングされており、プロンプトを変えるだけで簡単に切り替えることができます。これがこのモデルの最大の売りです。一見シンプルに聞こえるかもしれませんが、実は非常に興味深い点です。なぜなら、これら2つのタスクは通常、モデルを正反対の方向へと導く性質を持っているからです。
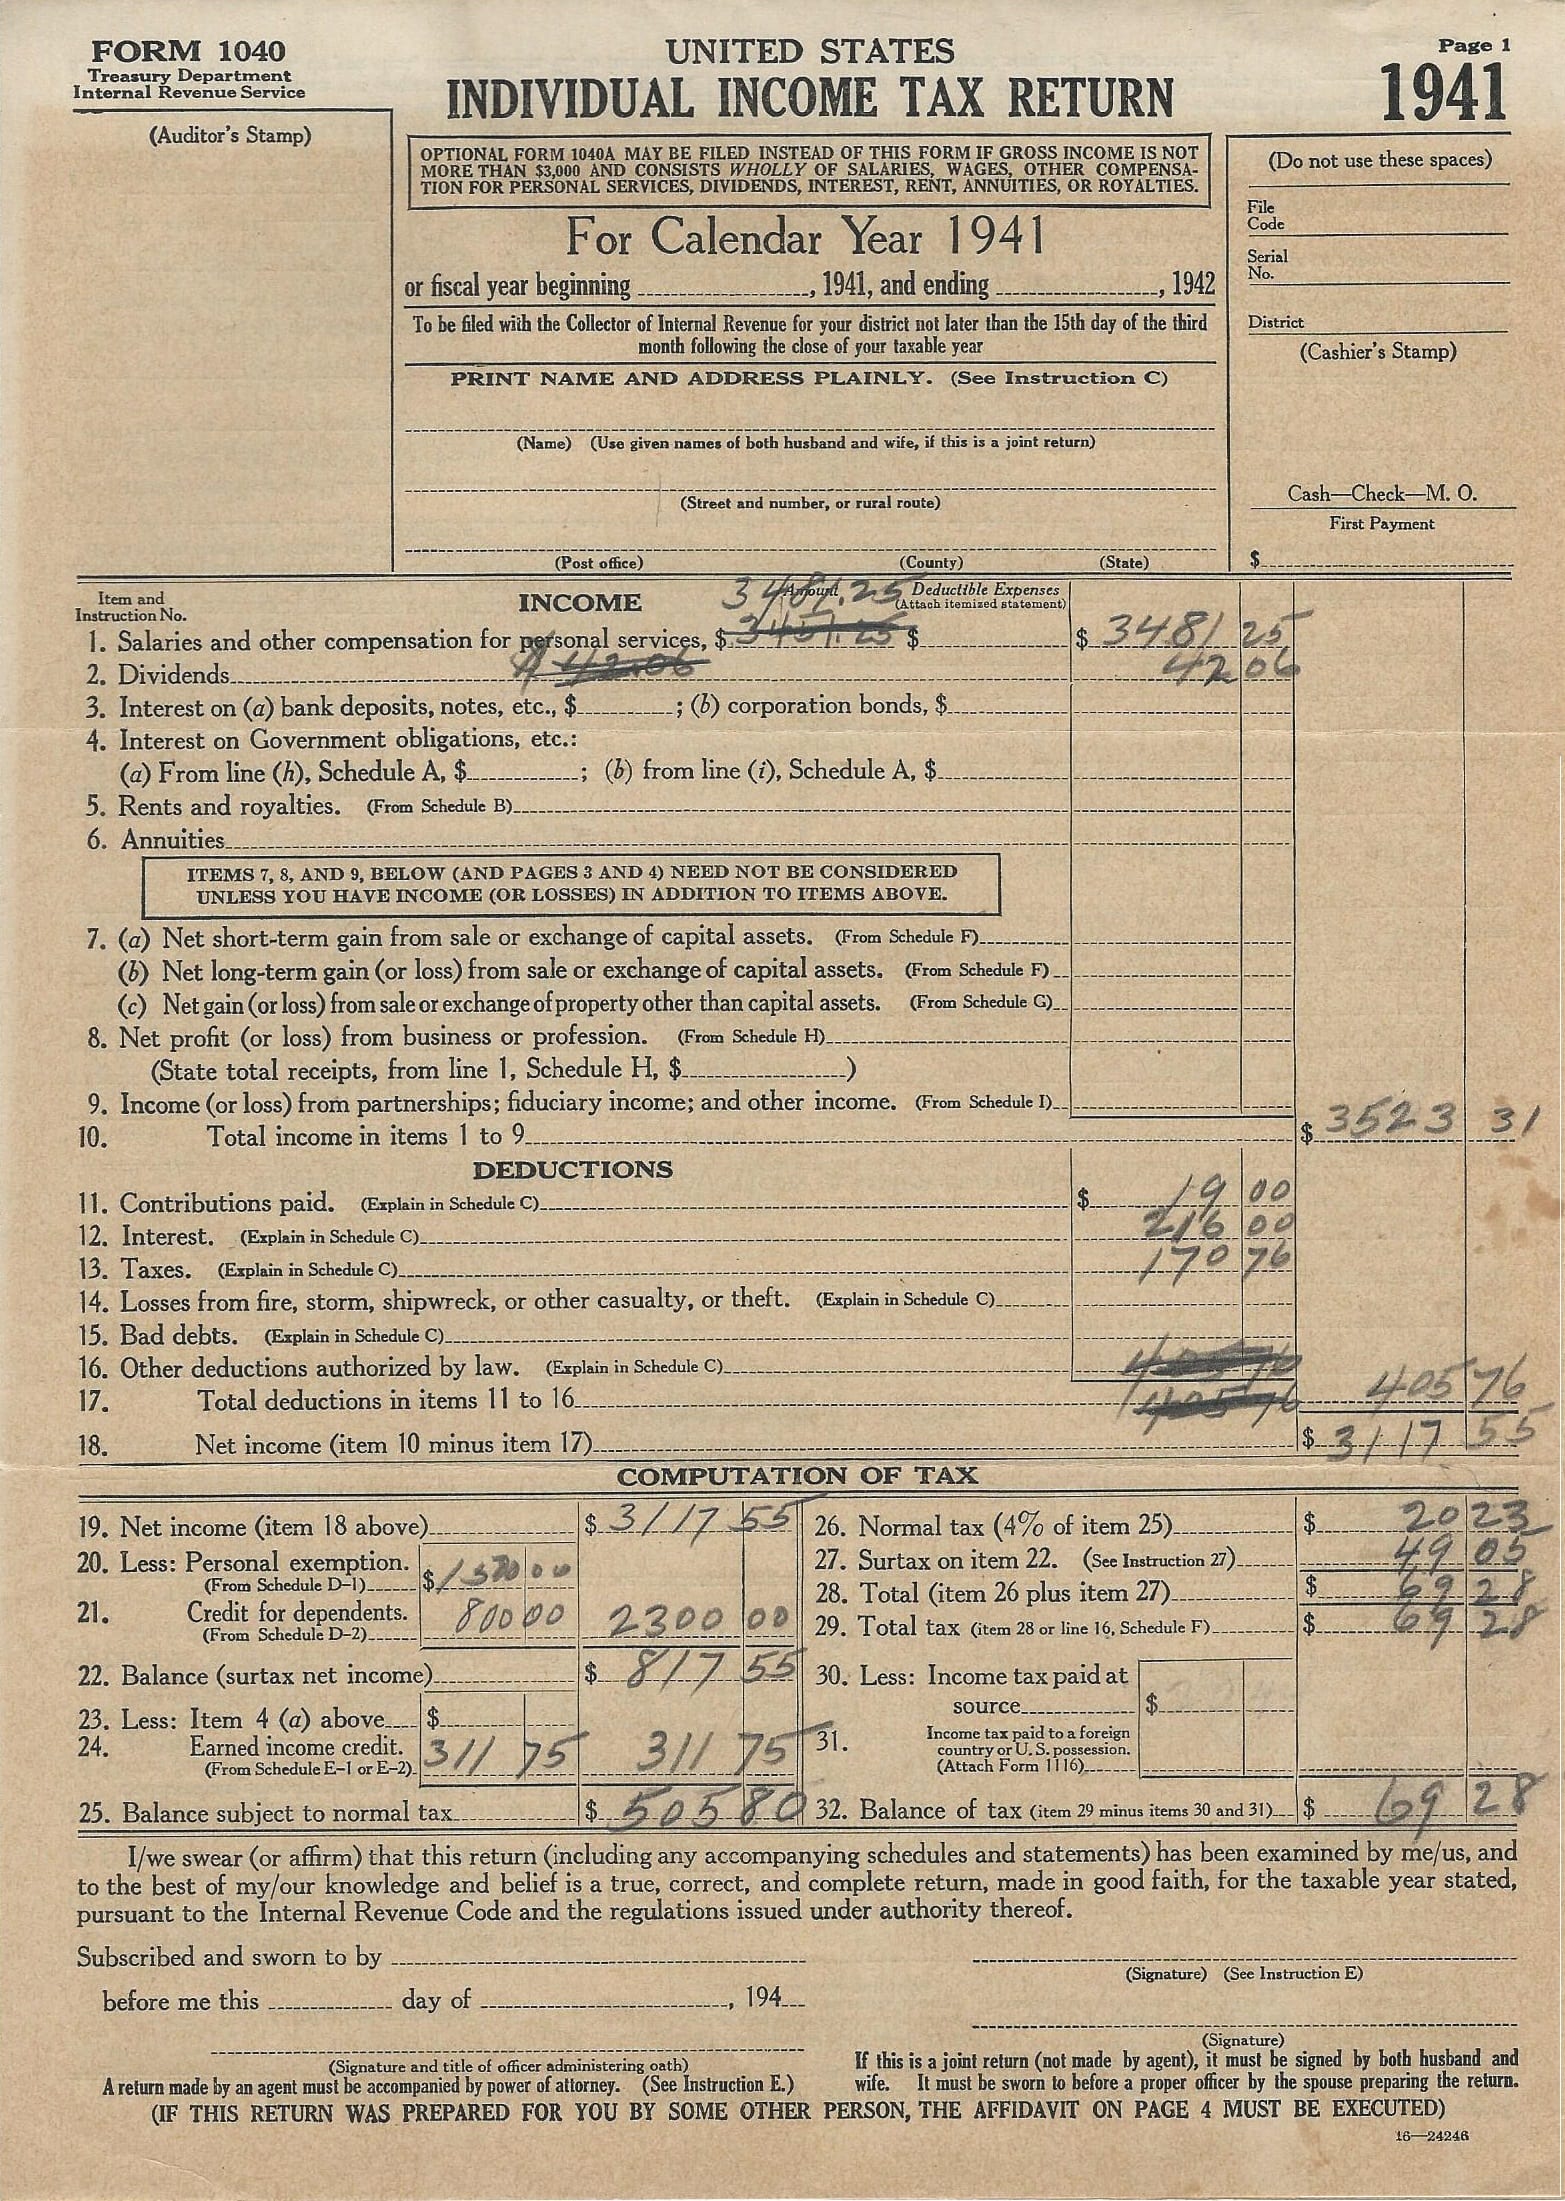
U.S. IRS Form 1040 individual income tax return, 1941; public domain (U.S. Government work), via Wikimedia Commons.

OCRシステムが通常は切り分けている2つの役割
従来のOCRが提供するのは、「テキスト」と「座標」です。例えば、「'Total' という単語はピクセル (412, 88) に位置している」といった情報です。検索可能なPDFの作成や、機密情報のマスキング、あるいは後続のレイアウト解析エンジンへの入力には、この形式が必要です。正確で空間的な情報を提供しますが、構造までは理解していません。あるテキストブロックが表の行なのか、キャプションなのか、あるいは脚注なのかを判別することはできないのです。
一方で、Image-to-markdown(画像からマークダウンへの変換)は正反対のアプローチです。ドキュメントのスクリーンショットを入力すると、## Section Header や | Column | Column | という表、**bold** で強調された合計行などが返ってきます。これは構造とスタイルを捉える手法であり、ドキュメントをLLMや検索インデックス、Wikiに投入したい場合に最適です。しかし、マークダウンには座標系が存在しないため、通常は正確なピクセル位置の情報は破棄されます。
KOSMOS-2.5は、これらを「テキスト集約的な画像のマシンリーディング」という同一スキルの2つのバリエーションとして捉え、プロンプトによってどちらかを選択できる単一のモデルとして学習させています。OCRを要求すれば空間的に根拠付けられたテキストブロックが返され、マークダウンを要求すれば構造化されスタイルが適用された出力が得られます。内部的には同じ重みと共有デコーダーを使用しており、入力するタスクトークンによって制御されているだけなのです。
言語モデルがいかにしてページを「見る」ことを学ぶか
KOSMOS-2.5は、ビジョン言語モデルの定石とも言える構成に基づいています。まずvision encoderが画像を読み取り、resamplerがそれを扱いやすい数のトークンに圧縮し、そしてdecoder-only autoregressive transformerが、GPTモデルがテキストを生成するのと同様に、1トークンずつ出力を生成します。ここでのユニークな点は、「何を生成させるか」にあります。単に「ドキュメントの写真」というキャプションを付けるのではなく、与えられたプロンプトに応じて、座標タグ付きのテキストスパンまたはmarkdown構文を出力するようにトレーニングされています。
ここでの「Autoregressive(自己回帰)」とは、モデルがそれまでに生成したすべての内容に基づいて次のトークンを予測することを意味しており、これは言語生成だけでなく、構造化されたドキュメント出力においても標準的なアプローチとなっています。従来のOCRパイプラインと異なるのは、モデルが「テキスト領域の検出」と「各領域の内容の認識」という個別のステップを実行しない点です。これらを1回の連続的な生成パスで同時に行うため、その動作は古典的なOCRエンジンがページをスキャンするよりも、大規模言語モデルが段落を書き上げるプロセスに近いと言えます。
そして、その性能の根拠となるのがトレーニングデータです。スキャンされた文書、ウェブレンダリングページ、その他のテキスト密度の高い画像など、多様なソースから収集された3億5,740万ページものドキュメントページが使用されました。この種の特化型事前学習としては極めて大規模なコーパスであり、だからこそ、このモデルは単なる綺麗な印刷ページを遥かに超えた多様なドキュメント形式を処理できるのです。こうしたモデルが汎化性能を持つ理由は、アーキテクチャの巧妙さよりも、トレーニングデータの規模にあるというのが、地味ながらも真実である傾向にあります。
モデルの評価:誰も持っていなかった2つの新しいベンチマーク
この論文における過小評価されがちな貢献は、アーキテクチャ面ではなくプロセス面にあります。著者らは、既存のOCRベンチマークでは重視したい項目がテストされていなかったため、OCREvalとMarkdownEvalという2つの新しいベンチマークを構築しました。モデルが空間的なOCRとMarkdown生成に優れていると主張するのであれば、その両方を実際に測定できる評価セットが必要ですが、どうやらこれまで実用的な規模でそのようなものは存在していなかったようです。
これらのベンチマークにおいて、KOSMOS-2.5はドキュメントレベルのテキスト認識および画像からMarkdownへの生成において、OpenAIのフラッグシップ・マルチモーダルモデルであるGPT-4oに匹敵する性能を示しています。GPT-4oの推定サイズよりおよそ2桁小さいモデルにとって、これは注目すべき主張です。もちろん、KOSMOS-2.5があらゆる面でGPT-4oを上回るという意味ではなく、論文でもそうは主張していません。つまり、「ドキュメント画像を読み取り、構造化テキストに変換する」という限定的で明確に定義されたタスクにおいては、特定の目的のために構築されたはるかに小さなモデルが、汎用的な巨大モデルとの差をほぼ埋められることを意味しています。
OCRツールを選択する際、このパターンを念頭に置く価値があります。汎用マルチモーダルモデルは優れたジェネラリストですが、数億ページものドキュメントで特化してトレーニングされた小規模モデルであれば、1コールあたりの計算コストを大幅に抑えつつ、ドキュメント読み取りという特定のタスクにおいて同等の性能を発揮できるということです。
チャット版:同じ「脳」を質問回答用にファインチューニング
本論文は単なる文字起こしにとどまりません。著者らはKOSMOS-2.5をさらにファインチューニングし、純粋な文字起こしではなくドキュメント理解に特化した「KOSMOS-2.5-CHAT」というバリアントを開発しました。これにより、ドキュメント画像を単に読み上げるだけでなく、その内容に関する質問に答えることが可能になります。
「このレシートの合計金額はいくらか」「このフォームに署名したのは誰か」といった、テキスト主体の視覚的質問回答(VQA)に関する9つのベンチマークで評価した結果、KOSMOS-2.5-CHATは、約5倍の規模(7 billionパラメータ)を持つ他の最先端汎用モデルと同等の性能を示しました(KOSMOS-2.5-CHATは1.3 billionパラメータ)。これが本論文が主張する効率性の核心であり、「ドキュメントデータに特化させることで、本来なら膨大なパラメータ数で補うはずの能力を十分に獲得できる」という広範なテーマと一致しています。
このようなモデルをベースに製品を構築する開発者にとって、この効率性の主張は単なる正解率の数値よりも重要です。1.3Bのモデルは、7Bのモデルに比べて推論コストが劇的に低く、実行速度が速く、さらなるファインチューニングも容易です。もし巨大なモデルのドキュメントQA性能の90%を達成できるのであれば、それは単なる研究上の注釈ではなく、インフラ設計における極めて重要な判断基準となります。
実際の限界点:正直な制約について
論文内でも、この問題が完全に解決されたわけではないことが率直に述べられています。この種のモデルの採用を検討される方にとって、注意すべき点がいくつかあります。
- 3億5,740万ページというトレーニングコーパスは膨大ですが、それでもドキュメント形式としては精選された一部に過ぎません。トレーニング中にあまり学習しなかったドキュメントレイアウト、珍しい文字体系、過度に装飾されたフォント、極めて高密度な表、あるいは手書き文字などが含まれる場合、空間的なOCR出力とmarkdown再構成の両方の精度が低下することは予想されます。
- Markdownの生成には、構造に関する「判断」が伴います。複雑なレイアウト(入れ子構造の表、多段組みの学術論文、不規則なフィールド配置のフォームなど)を2人の人間が見たとき、どちらのmarkdown表現が「正解」かについて意見が分かれる可能性があります。このような曖昧さがあるため、MarkdownEvalのスコアは、単純な文字誤り率(character-error-rate)のような指標よりも解釈が困難です。
- 特定のベンチマークでGPT-4oと同等であることは、あらゆる面で同等であることを意味しません。GPT-4oは画像に関するより広範な推論タスクを処理できますが、KOSMOS-2.5は特に「テキスト密度の高い画像の読み取りと構造化」に特化して構築されています。
- 多くの単一モデルによるベンチマークと同様に、実世界でのパフォーマンスは、対象となるドキュメントがトレーニングデータの分布にどれだけ近いかに大きく依存します。暗い場所でスマートフォンでスキャンしたレシートは、クリーンなPDFエクスポートとは全く別物であり、論文のベンチマーク数値だけでは、どちらのケースに直面しているかを判断することはできません。
ドキュメントパイプラインを構築するすべての人にとって重要な理由
ドキュメント画像を実用的なテキストに変換する製品を開発している場合、KOSMOS-2.5は2つの側面から有用な知見を与えてくれます。
第一に、空間的なOCRと構造化されたmarkdown抽出を、無理に継ぎ接ぎした2つの別個のシステムにする必要はないという証明です。適切にトレーニングされた単一のモデルであれば、両方のニーズを満たすことができ、エンジニアリングを大幅に簡素化できます。つまり、「OCR処理」と「レイアウト再構成処理」を個別に走らせるのではなく、1回のモデル呼び出しで完結させることが可能です。
第二に、より実用的な視点として、OCRエンジンを比較する際に「モデルの規模が大きければ常に正解とは限らない」という点を再認識させてくれます。数億ページものドキュメントで学習した1.3Bパラメータのモデルが、ドキュメント読み取りにおいてGPT-4oとの差をほぼ埋め、ドキュメントQ&Aでは7Bの汎用モデルに匹敵しました。もしユースケースが「ドキュメントから構造化テキストを抽出すること」に特化しているなら、その仕事のために構築されたモデルの方が、計算コストあたりのパフォーマンスで遥かに巨大な汎用モデルを上回る可能性があります。これは、単に想定するのではなく、実際に検証すべきトレードオフです。
ただし、本論文は英語圏のデータ中心であるため、日本語特有の縦書きレイアウトや複雑な漢字の認識については十分にカバーされていない点に注意が必要です。
ここから得られる実用的な教訓は、「必ずしもKOSMOS-2.5を使え」ということではありません。OCRやドキュメント解析エンジンを選ぶ際、問うべきは「モデルのサイズ」や「ベンチマークの順位」だけではないということです。重要なのは、そのモデルが「あなたの扱うドキュメントに似たデータで実際に学習されているか」、そして「座標やmarkdownなど、パイプラインが必要とするデータ形式を、後付けのシステムなしで直接出力できるか」という点なのです。