Por qué la mejor herramienta de PDF a matemáticas antes de Nougat acertaba las ecuaciones menos del 10% de las veces
Basado en: Nougat: Neural Optical Understanding for Academic Documents — Lukas Blecher, Guillem Cucurull, Thomas Scialom, Robert Stojnic
Prueba esto alguna vez: abre un PDF de un artículo de física, copia una ecuación y pégala en un archivo de texto. Lo que obtienes no es una ecuación. Es un desorden disperso de símbolos, a veces en el orden incorrecto, a veces sin la barra de fracción o el signo de sumatoria. El formato PDF fue diseñado para describir dónde va la tinta en una página, no qué significa esa tinta. Eso está bien para leer. Es un desastre para reutilizar.
Un equipo de Meta AI (Lukas Blecher, Guillem Cucurull, Thomas Scialom y Robert Stojnic) decidió atacar este problema de frente con un modelo llamado Nougat, sigla de Neural Optical Understanding for Academic Documents. El resultado que reportan es contundente: en un conjunto de prueba de artículos de arXiv, la herramienta existente más potente para extraer matemáticas de PDFs obtuvo la respuesta correcta en fórmulas aproximadamente el 9.7% de las veces, medido por la puntuación F1. Nougat alcanzó el 76.5%. Esa no es una pequeña mejora. Es la diferencia entre "inutilizable para cualquier cosa excepto párrafos simples" y "suficientemente bueno para construir sobre ello".
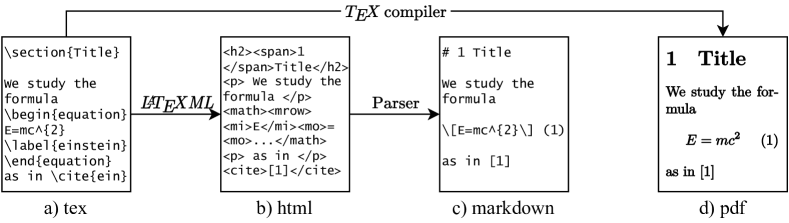
Figura de Nougat: Neural Optical Understanding for Academic Documents (Blecher et al., arXiv:2308.13418), con licencia CC BY-SA 4.0.
Por qué un PDF no contiene realmente el texto que crees que contiene
Aquí está la parte que suele confundir a la gente: una página de PDF generalmente parece tener texto, y a veces incluso puedes seleccionar y copiar ese texto. Pero lo que realmente se almacena es un conjunto de instrucciones como "dibuja el glifo de la sigma minúscula en las coordenadas (412, 88)". No existe el concepto de "esta sigma es parte de una sumatoria que abarca tres líneas" o "esta es una celda de tabla en la segunda columna". El orden de lectura, la estructura y el significado se aplanan todos en un montón de formas posicionadas.
Para un párrafo normal de prosa en inglés, esto en su mayoría no importa. Las herramientas existentes de extracción de texto y OCR de PDF pueden unir los glifos de nuevo en oraciones legibles lo suficientemente bien. Pero los artículos académicos están llenos de cosas que no sobreviven a ese aplanamiento: fracciones anidadas, matrices, ecuaciones de varias líneas, tablas con celdas fusionadas, algoritmos con sangría que lleva significado. Pide a una tubería OCR estándar que te devuelva una ecuación LaTeX funcional de un artículo de matemáticas escaneado, y generalmente obtendrás basura.
Este es el hueco específico que Nougat intenta llenar: no "leer las palabras en la página", que es un problema resuelto, sino "reconstruir el marcado real que un humano habría escrito para producir esta página".
Sin paso de OCR, sin cajas delimitadoras, solo una imagen de página de entrada y marcado de salida
La decisión de diseño que hace interesante a Nougat es lo que no hace. La mayoría de las tuberías de comprensión de documentos están construidas a partir de varias etapas ensambladas: detectar dónde están los bloques de texto, ejecutar OCR en cada bloque, detectar tablas por separado, ejecutar un reconocedor de fórmulas en cualquier cosa que parezca matemáticas, y luego intentar unir todo eso de nuevo en un documento coherente. Cada etapa introduce sus propios errores, y esos errores se acumulan.
Nougat omite todo eso. Es un único modelo Visual Transformer que toma una imagen rasterizada de una página PDF (renderizada a 96 DPI, redimensionada para ajustarse a una caja fija de 896×672 píxeles) y genera una secuencia de tokens de marcado directamente, uno a la vez, de la misma manera que un modelo de lenguaje escribe texto un token tras otro. En el fondo, combina un Swin Transformer, un modelo de visión que procesa una imagen en parches jerárquicos, con un decodificador basado en mBART que genera la secuencia de salida y realiza atención cruzada hacia las características de la imagen mientras escribe. No hay un módulo separado de detección de matemáticas ni una etapa de análisis de diseño. El modelo simplemente observa toda la página y escribe lo que ve, en un formato de marcado ligero que puede expresar encabezados, texto en negrita y cursiva, algoritmos, matemáticas LaTeX en línea y en display, y tablas LaTeX.
Se lanzaron dos tamaños: un modelo base de 350 millones de parámetros con 10 capas de decodificador, y uno más pequeño de 250 millones de parámetros con 4 capas. Ambos caen en el rango de "puedes ejecutar esto en una sola GPU razonable", no en el territorio de escala fronteriza que la gente suele significar cuando dice "modelo grande" hoy en día.
Tuvieron que construir los datos de entrenamiento antes de poder construir el modelo
La parte verdaderamente difícil de este proyecto probablemente no fue la arquitectura. Fue encontrar una manera de obtener millones de ejemplos de "imagen de página emparejada con el marcado exacto que la produjo", porque ese emparejamiento no existe en ningún lugar como un conjunto de datos listo para usar.
Su truco: los artículos de arXiv se envían con su código fuente LaTeX original, no solo con el PDF renderizado. Así que el equipo tomó el código fuente LaTeX, lo convirtió a HTML usando una herramienta llamada LaTeXML, y luego convirtió ese HTML a su propio formato de marcado ligero. Ahora tenían el marcado de verdad absoluta (ground truth). Luego renderizaron ese mismo código fuente a un PDF y rasterizaron las páginas a imágenes. Ahora tenían un par emparejado: imagen exacta, marcado exacto, sin necesidad de etiquetado manual.
Esto produjo la mayor parte de sus datos de entrenamiento: 7.5 millones de páginas de 1.7 millones de artículos de arXiv con código fuente LaTeX utilizable. Añadieron 536,000 páginas de PubMed Central, analizadas desde XML en lugar de LaTeX, y 447,000 páginas de la Industry Documents Library, que son documentos escaneados reales en lugar de PDFs nacidos digitalmente, para darle al modelo algo de exposición al ruido real de los escáneres. Total: aproximadamente 8.2 millones de pares página-marcado. Esa es la parte poco glamorosa del artículo, y es probablemente la parte que hizo posible el resto. Una arquitectura ingeniosa entrenada con datos malos generalmente pierde contra una arquitectura aburrida entrenada con una enorme pila de ejemplos correctamente emparejados.
Los resultados: sólido en texto plano, fiable en matemáticas, aún inestable en tablas
En su conjunto de prueba de arXiv, la distancia de edición global de Nougat (aproximadamente, cuántas inserciones, eliminaciones y sustituciones a nivel de carácter se necesitan para convertir la salida del modelo en la respuesta correcta, donde menor es mejor) fue de 0.071, con una F1 global del 93.1% y una puntuación BLEU de 89.1. Si desglosamos los datos por tipo de contenido, el panorama se vuelve más interesante:
- Texto plano: distancia de edición 0.058, F1 95.7%. Esto está casi resuelto.
- Matemáticas: distancia de edición 0.128, F1 76.5%, BLEU 56.9. Mucho más difícil, pero usable, y un salto masivo respecto a las alternativas.
- Tablas: distancia de edición 0.211, F1 78.0%, BLEU 69.7. La categoría más débil, y se nota en la práctica: las celdas fusionadas y los diseños irregulares aún lo confunden.
Para comparar, extraer texto directamente de la capa incrustada del PDF (cuando esta existe) dio una distancia de edición de 0.255, peor que la puntuación de matemáticas de Nougat y casi cuatro veces peor que la de texto plano de Nougat. Y GROBID, una herramienta ampliamente utilizada para analizar PDFs científicos, incluso cuando se potencia con un complemento dedicado de LaTeX-OCR para fórmulas, solo alcanzó un F1 del 9.7% en matemáticas. Esa comparación es el resultado principal de todo el artículo: convertir matemáticas en LaTeX usable ha estado casi roto en toda la industria, y este es uno de los primeros enfoques que mueve la aguja de manera significativa.
Cuando el modelo se atasca en un bucle
La parte más honesta del artículo es el análisis de fallos, y el modo de fallo más destacado es uno que cualquiera que haya trabajado con generación autorregresiva reconocerá de inmediato: colapso por repetición. En aproximadamente el 1,5 % del conjunto de prueba, el modelo se atasca prediciendo la misma oración, símbolo o línea una y otra vez, negándose a avanzar. Esto suele ocurrir en páginas que están fuera de la distribución de los datos de entrenamiento: principalmente páginas en blanco, páginas con diseños inusuales o documentos escaneados con mucho ruido.
La solución del equipo es un truco de detección y recuperación aplicado en tiempo de inferencia, junto con una estrategia de aumento de datos durante el entrenamiento que expone deliberadamente al modelo a ejemplos repetitivos y degenerados para que aprenda a salir de los bucles. Esa combinación redujo la tasa de repetición en un 32 %. Es una mejora real y, al mismo tiempo, una admisión de que el problema no está completamente resuelto. Si estás evaluando una herramienta como esta para su uso en producción, "a veces se atasca canturreando la misma línea para siempre" es exactamente el tipo de modo de fallo que quieres conocer de antemano, porque es silencioso: nada se bloquea, simplemente obtienes una salida basura que parece superficialmente plausible.
Otras limitaciones que vale la pena conocer: el modelo procesa una página a la vez sin memoria de otras páginas, por lo que la numeración en las bibliografías y las referencias cruzadas entre secciones pueden resultar inconsistentes en un documento de varias páginas. Fue entrenado casi por completo con texto en inglés, y los documentos en scripts no latinos provocan que falle por completo en lugar de degradarse de manera elegante. Los documentos de papel escaneados funcionan notablemente peor que los PDFs que fueron compuestos digitalmente desde el principio, lo cual tiene sentido dado que gran parte de los datos de entrenamiento se inclinaba hacia páginas limpias y nativas digitales de arXiv. Y es lento: en una GPU NVIDIA A10G, procesar seis páginas en paralelo tomó aproximadamente 19,5 segundos por lote, unos 1.400 tokens por página. GROBID, en cambio, procesa aproximadamente 10,6 PDFs por segundo. Eso no es una carrera muy cercana. Nougat sacrifica mucha velocidad a cambio de precisión en los casos difíciles.
Por qué importa si estás construyendo o eligiendo una pipeline de OCR
Si tus documentos son contratos, facturas o formularios, nada de esto es directamente relevante para ti. Nougat fue entrenado casi exclusivamente con artículos académicos, y eso se nota: diseños de revistas con múltiples columnas, escritura a mano y documentos empresariales están fuera de lo para lo que fue diseñado.
Pero si estás trabajando con PDFs científicos o técnicos donde las fórmulas, tablas y la estructura realmente tienen significado, la lección de este artículo se generaliza más allá de Nougat mismo. Es una demostración práctica de que los modelos de extremo a extremo de imagen a marcado pueden superar las pipelines ensambladas a partir de OCR más detección de diseño más un reconocedor de fórmulas separado, al menos para contenido técnico estructurado. La brecha del 9.7% versus 76.5% en el reconocimiento de matemáticas no es una diferencia de redondeo entre dos enfoques mediocres. Es la diferencia entre una herramienta en la que nunca confiarías con un artículo de investigación y una en la que podrías realmente construir un producto.
La conclusión práctica para cualquiera que esté evaluando motores de OCR: "maneja bien el texto" y "maneja bien las matemáticas y tablas" son capacidades genuinamente diferentes, y muchos proveedores te darán felizmente un número de precisión general que oculta una gran brecha entre ambas. Si tus documentos están densos con ecuaciones, pregunta específicamente sobre el rendimiento de fórmulas y tablas, no solo sobre la precisión general del texto. Y mantén un ojo en los modos de fallo como el colapso por repetición. Un modelo que ocasionalmente se repite infinitamente en una página defectuosa representa un tipo de riesgo diferente al de uno que simplemente es un poco menos preciso en promedio, y es el tipo de problema que solo aparece una vez que has probado contra tus propios documentos extraños del mundo real en lugar de un conjunto de referencia limpio.