Por que a melhor ferramenta de PDF para matemática antes do Nougat acertava equações em menos de 10% das vezes
Baseado em: Nougat: Neural Optical Understanding for Academic Documents — Lukas Blecher, Guillem Cucurull, Thomas Scialom, Robert Stojnic
Tente isso alguma vez: abra um PDF de um artigo de física, copie uma equação dele e cole em um arquivo de texto. O que você obtém não é uma equação. É uma bagunça dispersa de símbolos, às vezes na ordem errada, às vezes faltando a barra de fração ou o sinal de somatório por completo. O formato PDF foi construído para descrever onde a tinta vai na página, não o que essa tinta significa. Isso é bom para leitura. É um desastre para reutilização.
Uma equipe da Meta AI (Lukas Blecher, Guillem Cucurull, Thomas Scialom e Robert Stojnic) decidiu atacar isso de frente com um modelo chamado Nougat, sigla para Neural Optical Understanding for Academic Documents. O resultado que eles relatam é marcante: em um conjunto de teste de artigos do arXiv, a ferramenta existente mais forte para extrair matemática de PDFs acertou a resposta em fórmulas cerca de 9,7% das vezes, medida pela pontuação F1. O Nougat atingiu 76,5%. Isso não é uma pequena melhoria. É a diferença entre "inutilizável para qualquer coisa além de parágrafos simples" e "bom o suficiente para construir sobre".
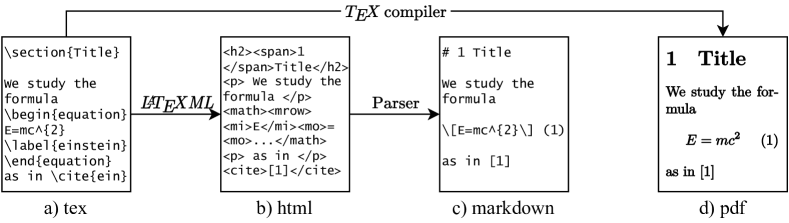
Figura de Nougat: Neural Optical Understanding for Academic Documents (Blecher et al., arXiv:2308.13418), licenciada sob CC BY-SA 4.0.
Por que um PDF não contém realmente o texto que você acha que contém
Aqui está o ponto que confunde as pessoas: uma página de PDF geralmente parece ter texto nela, e às vezes você até pode selecionar e copiar esse texto. Mas o que está realmente armazenado é um conjunto de instruções como "desenhe o glifo para o sigma minúsculo nas coordenadas (412, 88)". Não há o conceito de "este sigma faz parte de uma soma que se estende por três linhas" ou "esta é uma célula de tabela na segunda coluna". A ordem de leitura, a estrutura e o significado são todos achatados em uma pilha de formas posicionadas.
Para um parágrafo normal de prosa em inglês, isso geralmente não importa. As ferramentas existentes de extração de texto de PDF e OCR podem remontar os glifos em frases legíveis suficientemente bem. Mas os artigos acadêmicos estão cheios de coisas que não sobrevivem a esse achatamento: frações aninhadas, matrizes, equações de várias linhas, tabelas com células mescladas, algoritmos com indentação que carrega significado. Peça a um pipeline OCR padrão que lhe devolva uma equação LaTeX funcional de um artigo de matemática escaneado, e você geralmente obterá lixo.
Este é o buraco específico que o Nougat tenta preencher: não "ler as palavras na página", que é um problema resolvido, mas "reconstruir a marcação real que um humano teria escrito para produzir esta página".
Na etapa de OCR, sem caixas delimitadoras, apenas uma imagem de página como entrada e marcação como saída
A escolha de design que torna o Nougat interessante é o que ele não faz. A maioria dos fluxos de trabalho para compreensão de documentos é construída a partir de vários estágios acoplados: detectar onde estão os blocos de texto, executar OCR em cada bloco, detectar tabelas separadamente, executar um reconhecedor de fórmulas em qualquer coisa que pareça matemática e, em seguida, tentar juntar tudo isso novamente em um documento coerente. Cada estágio introduz seus próprios erros, e esses erros se acumulam.
O Nougat ignora tudo isso. É um único modelo Visual Transformer que recebe uma imagem rasterizada de uma página de PDF (renderizada a 96 DPI, redimensionada para caber em uma caixa fixa de 896×672 pixels) e produz um fluxo de tokens de marcação diretamente, um de cada vez, da mesma forma que um modelo de linguagem escreve texto, um token após o outro. Por baixo dos panos, ele combina um Swin Transformer, um modelo de visão que processa uma imagem em patches hierárquicos, com um decodificador baseado no mBART que gera a sequência de saída e faz cross-attention de volta para os recursos da imagem enquanto escreve. Não há módulo separado para detecção de matemática nem estágio de análise de layout. O modelo apenas observa a página inteira e registra o que vê, em um formato de marcação leve que pode expressar títulos, texto em negrito e itálico, algoritmos, matemática LaTeX inline e em display, e tabelas LaTeX.
Dois tamanhos foram lançados: um modelo base com 350 milhões de parâmetros e 10 camadas de decodificador, e um menor com 250 milhões de parâmetros e 4 camadas. Ambos se enquadram na categoria de "você pode executar isso em uma única GPU razoável", e não no território de escala de fronteira que as pessoas geralmente querem dizer quando falam em modelo "grande" nos dias de hoje.
Eles tiveram que construir os dados de treinamento antes de poder construir o modelo
A parte genuinamente difícil deste projeto provavelmente não foi a arquitetura. Foi encontrar uma maneira de obter milhões de exemplos de "imagem de página pareada com a marcação exata que a produziu", pois esse pareamento não existe em lugar nenhum como um conjunto de dados pronto.
O truque deles: os artigos do arXiv são submetidos com sua fonte LaTeX original, não apenas o PDF renderizado. Então, a equipe pegou a fonte LaTeX, converteu-a para HTML usando uma ferramenta chamada LaTeXML e, em seguida, converteu esse HTML para seu próprio formato de marcação leve. Agora eles tinham a marcação de verdade (ground-truth). Depois, renderizaram a mesma fonte para um PDF e rasterizaram as páginas em imagens. Agora eles tinham um par correspondente: imagem exata, marcação exata, sem necessidade de rotulagem manual.
Isso produziu a maior parte de seus dados de treinamento: 7,5 milhões de páginas de 1,7 milhão de artigos do arXiv com fonte LaTeX utilizável. Eles adicionaram 536.000 páginas do PubMed Central, analisadas a partir de XML em vez de LaTeX, e 447.000 páginas da Industry Documents Library, que são documentos digitalizados reais em vez de PDFs nativos digitais, para dar ao modelo alguma exposição ao ruído real de scanners. Total: cerca de 8,2 milhões de pares página-marcador. Essa é a parte pouco glamorosa do artigo, e é, sem dúvida, a parte que tornou o resto possível. Uma arquitetura inteligente treinada com dados ruins geralmente perde para uma arquitetura chata treinada em uma enorme pilha de exemplos corretamente pareados.
Os resultados: forte em texto puro, sólido em matemática, ainda instável em tabelas
No conjunto de testes do arXiv, a distância de edição geral do Nougat (basicamente, quantas inserções, exclusões e substituições em nível de caractere são necessárias para transformar a saída do modelo na resposta correta, sendo menor melhor) foi de 0,071, com um F1 geral de 93,1% e uma pontuação BLEU de 89,1. Ao detalhar por tipo de conteúdo, o cenário se torna mais interessante:
- Texto puro: distância de edição 0,058, F1 95,7%. Isso está quase resolvido.
- Matemática: distância de edição 0,128, F1 76,5%, BLEU 56,9. Muito mais difícil, mas utilizável, e um salto massivo em relação às alternativas.
- Tabelas: distância de edição 0,211, F1 78,0%, BLEU 69,7. A categoria mais fraca, e isso se reflete na prática: células mescladas e layouts irregulares ainda o confundem.
Para comparação, extrair texto diretamente da camada embutida do PDF (quando ela existe) resultou em uma distância de edição de 0,255, pior que a pontuação de matemática do Nougat e quase quatro vezes pior que a pontuação de texto puro do Nougat. E o GROBID, uma ferramenta amplamente utilizada para analisar PDFs científicos, mesmo quando aprimorada com um complemento dedicado de LaTeX-OCR para fórmulas, atingiu apenas 9,7% de F1 em matemática. Essa comparação é o resultado principal de todo o artigo: transformar matemática em LaTeX utilizável tem sido, silenciosamente, quase ineficaz em toda a indústria, e esta é uma das primeiras abordagens a mover significativamente o ponteiro.
Quando o modelo fica preso em um loop
A parte mais honesta do artigo é a análise de falhas, e o modo de falha mais notável é aquele que qualquer pessoa que já trabalhou com geração autoregressiva reconhecerá imediatamente: colapso por repetição. Em cerca de 1,5% do conjunto de teste, o modelo fica preso prevendo a mesma frase, símbolo ou linha repetidamente, recusando-se a avançar. Isso tende a acontecer em páginas que estão fora da distribuição dos dados de treinamento: principalmente páginas em branco, páginas com layouts incomuns ou documentos digitalizados com muito ruído.
A correção da equipe é um truque de detecção e recuperação aplicado durante a inferência, além de uma estratégia de aumento de dados durante o treinamento que expõe deliberadamente o modelo a exemplos repetitivos e degenerados para que ele aprenda a sair dos loops. Essa combinação reduziu a taxa de repetição em 32%. É uma melhoria real, e também uma admissão de que o problema não está totalmente resolvido. Se você está avaliando uma ferramenta como essa para uso em produção, "ocasionalmente fica preso cantando a mesma linha para sempre" é exatamente o tipo de modo de falha que você quer saber antecipadamente, porque é silencioso: nada trava, você apenas obtém uma saída inútil que parece superficialmente plausível.
Outras limitações importantes: o modelo processa uma página de cada vez, sem memória de outras páginas, então a numeração em bibliografias e referências cruzadas entre seções podem acabar inconsistentes em um documento de várias páginas. Ele foi treinado quase inteiramente com texto em inglês, e documentos em scripts não latinos fazem com que ele falhe completamente em vez de degradar-se suavemente. Documentos de papel digitalizados performam visivelmente pior do que PDFs que foram tipografados digitalmente desde o início, o que faz sentido considerando quanto dos dados de treinamento se inclinou para páginas limpas e nativamente digitais do arXiv. E ele é lento: em uma GPU NVIDIA A10G, processar seis páginas em paralelo levou cerca de 19,5 segundos por lote, aproximadamente 1.400 tokens por página. O GROBID, por outro lado, processa cerca de 10,6 PDFs por segundo. Essa não é uma corrida acirrada. O Nougat troca muita velocidade por precisão nos casos difíceis.
Por que isso importa se você está construindo ou escolhendo um pipeline de OCR
Se seus documentos são contratos, faturas ou formulários, nada disso é diretamente relevante para você. O Nougat foi treinado quase exclusivamente em artigos acadêmicos, e isso transparece: layouts de revistas com múltiplas colunas, manuscritos e documentos empresariais estão fora do escopo para o qual ele foi construído.
Mas se você lida com PDFs científicos ou técnicos onde fórmulas, tabelas e marcação estruturada realmente carregam significado, a lição deste artigo se generaliza além do próprio Nougat. É uma demonstração prática de que modelos end-to-end de imagem para marcação podem superar pipelines montados a partir de OCR mais detecção de layout mais um reconhecedor de fórmulas separado, pelo menos para conteúdo técnico estruturado. A diferença de 9,7% versus 76,5% no reconhecimento de matemática não é uma diferença de arredondamento entre duas abordagens medíocres. É a diferença entre uma ferramenta na qual você nunca confiaria para um artigo de pesquisa e uma na qual você poderia realmente construir um produto.
A conclusão prática para quem está avaliando motores de OCR: "lida bem com texto" e "lida bem com matemática e tabelas" são capacidades genuinamente diferentes, e muitos fornecedores ficarão felizes em citar uma taxa de precisão geral que esconde uma enorme lacuna entre as duas. Se seus documentos são densos em equações, pergunte especificamente sobre o desempenho de fórmulas e tabelas, não apenas sobre a precisão geral do texto. E fique atento a modos de falha como colapso por repetição. Um modelo que ocasionalmente entra em loop infinito em uma página ruim representa um tipo de risco diferente daquele que é simplesmente um pouco menos preciso em média, e é o tipo de problema que só aparece quando você testa contra seus próprios documentos estranhos e do mundo real, em vez de um conjunto de benchmark limpo.