Nougat以前の最高のPDF-to-Mathツールが、数式を正しく認識できた確率が10%未満だった理由
元論文: Nougat: Neural Optical Understanding for Academic Documents — Lukas Blecher, Guillem Cucurull, Thomas Scialom, Robert Stojnic
PDFから数式を抽出する難しさ
一度試してみてください。物理学の論文のPDFを開き、そこから数式をコピーしてテキストファイルに貼り付けてみてください。得られるのは数式ではなく、バラバラに散らばった記号の塊です。順番が入れ替わっていたり、分数線や総和記号($\sum$)が完全に消えていたりすることもあります。PDFフォーマットは、ページ上の「どこにインクを配置するか」を記述するために作られたものであり、「そのインクが何を意味するか」を記述するものではないからです。読む分にはそれで十分ですが、再利用しようとすると悲惨な結果になります。
Meta AIのチーム(Lukas Blecher, Guillem Cucurull, Thomas Scialom, Robert Stojnic)は、この問題に正面から取り組むべく、「Nougat」(Neural Optical Understanding for Academic Documentsの略)というモデルを開発しました。彼らが報告した結果は衝撃的です。arXivの論文を用いたテストセットにおいて、PDFから数式を抽出する既存の最強ツールが正解を出せた割合(F1スコア)は約9.7%でしたが、Nougatは76.5%に達しました。これは単なる「改善」ではありません。「単純な段落以外には使い物にならない」状態から、「ベースとして活用できる十分な品質」への飛躍的な進化です。
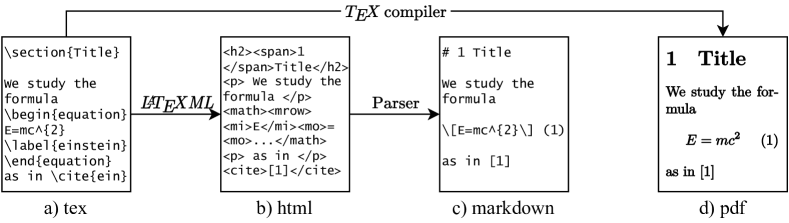
Figure from Nougat: Neural Optical Understanding for Academic Documents (Blecher et al., arXiv:2308.13418), licensed CC BY-SA 4.0.
PDFに「想定通りのテキスト」が含まれていない理由
多くの人が陥る罠がここにあります。PDFのページを見ると、そこにはテキストがあるように見えますし、実際にそのテキストを選択してコピーできることもあります。しかし、内部に保存されているのは実際には「座標(412, 88)に小文字のシグマのグリフを描画せよ」といった一連の命令セットに過ぎません。「このシグマは3行にわたる総和記号の一部である」とか「これは2列目のテーブルセルである」といった概念は存在しません。読書順、構造、そして意味のすべてが、配置された図形の集まりへと平坦化(フラット化)されてしまうのです。
普通の英文の段落であれば、これはほとんど問題になりません。既存のPDFテキスト抽出ツールやOCRツールを使えば、グリフを十分に読みやすい文章に再構成できるからです。しかし、学術論文には、この平坦化に耐えられない要素が溢れています。入れ子になった分数、行列、複数行にわたる数式、セルが結合された表、そしてインデント自体に意味を持つアルゴリズムなどです。標準的なOCRパイプラインに、スキャンされた数学論文から動作可能なLaTeX形式の数式を書き出すよう求めれば、通常は使い物にならない結果が返ってくるでしょう。
これこそがNougatが埋めようとしている空白です。つまり、すでに解決済みの課題である「ページ上の文字を読み取る」ことではなく、「人間がこのページを作成するために書いたであろう、実際のマークアップを再構築する」ことを目的としているのです。
OCRステップもバウンディングボックスも不要。ページ画像を入力し、マークアップを出力するだけ
Nougatを興味深いものにしている設計上の選択は、「何をしないか」という点にあります。多くのドキュメント理解パイプラインは、複数のステージを継ぎ接ぎして構築されています。まずテキストブロックの位置を検出し、各ブロックにOCRをかけ、表を個別に検出し、数式に見えるものには数式認識器を走らせ、最後にそれらすべてを一貫したドキュメントへと繋ぎ合わせようとします。しかし、ステージを重ねるごとに固有の誤差が生じ、それらが累積していくことになります。
Nougatはこれらすべてをスキップします。これは単一のVisual Transformerモデルであり、PDFページのラスタライズ画像(96 DPIでレンダリングされ、896×672ピクセルの固定サイズにリサイズされたもの)を入力として受け取り、言語モデルがテキストを1トークンずつ書き出すのと同様に、マークアップトークンのストリームを直接ひとつずつ出力します。内部的には、画像を階層的なパッチで処理するビジョンモデルであるSwin Transformerと、出力シーケンスを生成し、書き出しながら画像特徴量にクロスアテンションをかけるmBARTベースのデコーダーを組み合わせています。数式検出専用のモジュールも、レイアウト解析ステージも存在しません。モデルは単にページ全体を眺め、見えたものを軽量なマークアップ形式で書き出します。この形式では、見出し、太字、斜体、アルゴリズム、インラインおよびディスプレイ形式のLaTeX数式、そしてLaTeXの表を表現できます。
リリースされたモデルは2つのサイズがあります。10個のデコーダーレイヤーを持つ350 millionパラメータのbaseモデルと、4つのレイヤーを持つ250 millionパラメータの小型モデルです。どちらも、最近人々が「大規模」モデルと呼ぶフロンティア規模のものではなく、「一般的なGPU1枚で動作する」範囲に収まっています。
モデルを構築する前に、トレーニングデータを構築する必要があった
このプロジェクトで真に困難だったのは、おそらくアーキテクチャの設計ではありませんでした。最大の課題は、「ページ画像と、それを生成した正確なマークアップ」というペアの例を数百万件分確保する方法を見つけることでした。なぜなら、そのようなペアが揃った既製のデータセットはどこにも存在しなかったからです。
彼らが用いた手法はこうです。arXivの論文は、レンダリング後のPDFだけでなく、元のLaTeXソースと共に提出されます。そこでチームは、LaTeXソースをLaTeXMLというツールを使ってHTMLに変換し、さらにそのHTMLを独自の軽量マークアップ形式に変換しました。これにより、「正解(ground-truth)」となるマークアップが手に入りました。次に、同じソースをPDFとしてレンダリングし、各ページを画像としてラスタライズしました。これで、手動のラベル付けを一切行うことなく、「正確な画像」と「正確なマークアップ」のペアが揃ったことになります。
この手法によって、トレーニングデータの大部分が生成されました。具体的には、利用可能なLaTeXソースを持つ170万本のarXiv論文から750万ページ分です。さらに、LaTeXではなくXMLからパースしたPubMed Centralの53万6,000ページと、デジタル作成のPDFではなく実際にスキャンされた文書であるIndustry Documents Libraryの44万7,000ページを追加し、モデルに現実的なスキャナーノイズを学習させました。合計で約820万件のページ・マークアップペアになります。これは論文の中で地味な部分ですが、間違いなく、それ以外のすべてを可能にした重要な工程です。質の低いデータで学習させた巧妙なアーキテクチャよりも、正しくペアリングされた膨大なデータで学習させた平凡なアーキテクチャの方が、最終的に勝利することが多いものです。
結果:プレーンテキストに強く、数式は堅実、表は依然として不安定
arXivのテストセットにおけるNougatの総合的なedit distance(モデルの出力を正解に変換するために必要な文字レベルの挿入・削除・置換の回数。数値が低いほど高性能)は0.071となり、総合F1スコアは93.1%、BLEUスコアは89.1を記録しました。コンテンツの種類別に詳細を見ると、より興味深い傾向が見えてきます。
- プレーンテキスト: edit distance 0.058、F1 95.7%。ほぼ解決済みと言えるレベルです。
- 数式 (Math): edit distance 0.128、F1 76.5%、BLEU 56.9。難易度は大幅に上がりますが、実用的なレベルにあり、代替手法に比べて飛躍的な向上を遂げています。
- 表 (Tables): edit distance 0.211、F1 78.0%、BLEU 69.7。最も弱いカテゴリーであり、実際、結合セルや不規則なレイアウトに依然として混乱が見られます。
比較として、PDFの埋め込みレイヤーから直接テキストを抽出した場合(そもそもレイヤーが存在する場合のみ可能)、edit distanceは0.255となり、Nougatの数式スコアよりも悪く、プレーンテキストのスコアに比べると4倍近く劣る結果となりました。また、科学論文PDFの解析に広く利用されているGROBIDは、数式用の専用LaTeX-OCRアドオンで強化したとしても、数式のF1スコアはわずか9.7%にとどまりました。この比較こそが本論文の最大の成果です。数式を実用的なLaTeXに変換することは、業界全体で密かに「ほぼ不可能」な状態にありましたが、Nougatはそれを意味のあるレベルまで前進させた最初のアプローチの一つとなりました。
モデルがループに陥る場合
この論文で最も誠実な部分は失敗分析であり、そこで際立っている失敗モードは、自己回帰的な生成を扱ったことがある人なら誰でもすぐに気づく「繰り返し崩壊(repetition collapse)」です。テストセットの約1.5%において、モデルが同じ文章や記号、行を何度も繰り返し予測し続け、先に進めなくなる現象が発生しています。これは主に、トレーニングデータの分布から外れたページ(ほぼ空白のページ、特殊なレイアウトのページ、ノイズの多いスキャン文書など)で起こる傾向があります。
チームが導入した解決策は、推論時に適用する「検出と復旧」のトリックと、トレーニング中に意図的に反復的で退化した例をモデルに提示し、ループから脱出する方法を学習させるデータ拡張戦略の組み合わせです。これにより、繰り返しの発生率は32%減少しました。これは確かな改善ではありますが、同時にこの問題が完全には解決されていないことの認容でもあります。もしこのようなツールを商用利用するために評価しているのであれば、「時々同じ行を永遠に唱え続ける」という失敗モードは、事前に把握しておくべき重要な点です。なぜなら、このエラーは「静かに」起こるためです。システムがクラッシュすることはありませんが、一見それらしく見えるゴミのような出力が生成されるだけだからです。
他にも知っておくべき制限事項があります。まず、モデルは1ページずつ処理し、他のページの記憶を保持しないため、参考文献の番号付けやセクション間の相互参照が、複数ページにわたる文書内で不整合になる可能性があります。また、ほぼ全面的に英語テキストでトレーニングされているため、ラテン文字以外を用いた文書では、緩やかに精度が落ちるのではなく、完全に動作しなくなります。さらに、最初からデジタルで組版されたPDFに比べ、紙文書のスキャンデータは著しくパフォーマンスが低下します。これは、トレーニングデータの多くがクリーンなborn-digitalのarXivページに偏っていたことを考えれば妥当でしょう。そして、処理速度が遅い点です。NVIDIA A10G GPUを使用し、6ページを並列処理した場合、1バッチあたり約19.5秒かかり、1ページあたり約1,400トークンでした。対照的に、GROBIDは1秒間に約10.6個のPDFを処理します。これは勝負にすらならない差です。Nougatは、難易度の高いケースにおける精度の向上のために、速度を大幅に犠牲にしています。
OCRパイプラインの構築や選定において、なぜこれが重要なのか
扱うドキュメントが契約書や請求書、申請書などの場合は、本件は直接的な関係はありません。Nougatはほぼ学術論文のみで学習されており、その傾向は顕著です。多段組みの雑誌レイアウトや手書き文字、ビジネス文書などは、設計上の想定外となっています。また、本モデルは英語圏の論文を主眼としているため、日本語特有の縦書きレイアウトや複雑な漢字の認識についてはカバーされていない点に注意が必要です。
しかし、数式や表、構造化されたマークアップが重要な意味を持つ科学・技術系PDFを扱う場合、この論文から得られる教訓はNougatという単一のモデルに留まりません。これは、構造化された技術コンテンツにおいて、「OCR + レイアウト検出 + 個別の数式認識器」を組み合わせたパイプラインよりも、エンドツーエンドの「画像からマークアップへ」のモデルの方が優れていることを示す実証例です。数式認識における9.7%対76.5%という格差は、単なる精度の微差ではありません。それは、「研究論文に使うには到底信頼できないツール」か、「実際に製品化を検討できるツール」かという決定的な差を意味します。
OCRエンジンを評価する際の現実的な教訓は、「テキストをうまく処理できること」と「数式や表をうまく処理できること」は全く異なる能力であるということです。多くのベンダーは、この2つの間の大きな乖離を隠して、全体の正解率という数字を提示しがちです。もし扱うドキュメントに数式が密集しているなら、単なるテキストの精度ではなく、数式と表のパフォーマンスについて具体的に質問してください。また、「繰り返し崩壊(repetition collapse)」のような失敗モードにも注意してください。特定のページで無限ループに陥るモデルは、単に平均精度が少し低いモデルとは異なる種類のリスクを孕んでいます。そして、そうした問題は、クリーンなベンチマークセットではなく、現実世界の「癖のある」自社ドキュメントでテストして初めて明らかになるものです。