Nougat से पहले सबसे अच्छे PDF-to-Math टूल 10% से भी कम समय में समीकरणों को सही क्यों पहचान पाते थे
आधारित शोध-पत्र: Nougat: Neural Optical Understanding for Academic Documents — Lukas Blecher, Guillem Cucurull, Thomas Scialom, Robert Stojnic
एक आम समस्या और उसका समाधान
कभी इसे आज़माकर देखें: किसी physics paper की PDF खोलें, उसमें से एक equation कॉपी करें और उसे किसी text file में पेस्ट करें। आपको जो मिलेगा वह कोई equation नहीं होगी, बल्कि प्रतीकों (symbols) का एक बिखरा हुआ ढेर होगा—कभी क्रम गलत होगा, तो कभी fraction bar या summation sign पूरी तरह गायब होंगे। PDF फॉर्मेट को इस तरह बनाया गया था कि वह यह बताए कि पेज पर स्याही (ink) कहाँ जाएगी, न कि उस स्याही का अर्थ क्या है। पढ़ने के लिए तो यह ठीक है, लेकिन डेटा के पुन: उपयोग (reuse) के लिए यह एक आपदा जैसा है।
Meta AI की एक टीम (Lukas Blecher, Guillem Cucurull, Thomas Scialom, और Robert Stojnic) ने इस समस्या को सीधे तौर पर हल करने का फैसला किया और Nougat नाम का एक मॉडल बनाया, जिसका पूरा नाम Neural Optical Understanding for Academic Documents है। उनके द्वारा रिपोर्ट किए गए परिणाम चौंकाने वाले हैं: arXiv papers के एक टेस्ट सेट पर, PDF से गणितीय समीकरण निकालने वाले सबसे शक्तिशाली मौजूदा टूल का F1 score केवल 9.7% था। वहीं, Nougat ने 76.5% का स्कोर हासिल किया। यह कोई मामूली सुधार नहीं है; यह "सिर्फ साधारण पैराग्राफ के लिए उपयोगी" और "आगे काम करने के लिए पर्याप्त रूप से सक्षम" होने के बीच का अंतर है।
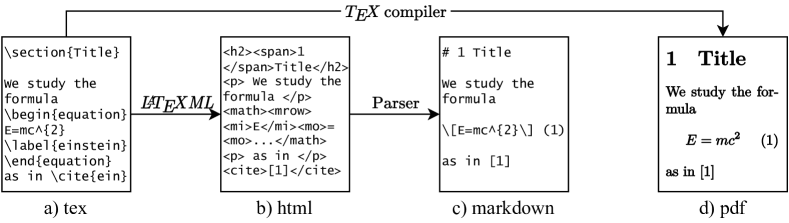
Figure from Nougat: Neural Optical Understanding for Academic Documents (Blecher et al., arXiv:2308.13418), licensed CC BY-SA 4.0.
एक PDF में वास्तव में वह टेक्स्ट क्यों नहीं होता जो आपको लगता है
यही वह हिस्सा है जहाँ लोग अक्सर गलती करते हैं: एक PDF पेज देखने में ऐसा लगता है जैसे उसमें टेक्स्ट है, और कभी-कभी आप उस टेक्स्ट को सिलेक्ट और कॉपी भी कर सकते हैं। लेकिन वास्तव में जो स्टोर होता है, वह निर्देशों का एक सेट होता है, जैसे "कोऑर्डिनेट्स (412, 88) पर लोअरकेस sigma का glyph ड्रा करें।" इसमें इस बात की कोई समझ नहीं होती कि "यह sigma एक summation का हिस्सा है जो तीन लाइनों तक फैला है" या "यह दूसरे कॉलम का एक टेबल सेल है।" रीडिंग ऑर्डर, स्ट्रक्चर और अर्थ, सब कुछ केवल पोजीशन किए गए शेप्स के ढेर में बदल जाता है।
अंग्रेजी गद्य (prose) के एक सामान्य पैराग्राफ के लिए, इससे कोई खास फर्क नहीं पड़ता। मौजूदा PDF टेक्स्ट एक्सट्रैक्शन और OCR टूल्स इन glyphs को वापस पठनीय वाक्यों में पर्याप्त रूप से जोड़ सकते हैं। लेकिन अकादमिक पेपर्स ऐसी चीजों से भरे होते हैं जो इस 'फ्लैटनिंग' प्रक्रिया में नष्ट हो जाती हैं: nested fractions, matrices, multi-line equations, merged cells वाली टेबल्स, और ऐसे algorithms जिनका इंडेंटेशन (indentation) कोई विशेष अर्थ रखता है। यदि आप किसी स्टैंडर्ड OCR पाइपलाइन से एक स्कैन्ड मैथ पेपर से वर्किंग LaTeX equation निकालने को कहेंगे, तो आपको आमतौर पर बेकार परिणाम (garbage) ही मिलेंगे।
Nougat इसी विशिष्ट कमी को पूरा करने की कोशिश करता है: इसका उद्देश्य केवल "पेज पर लिखे शब्दों को पढ़ना" नहीं है, जो कि एक सुलझाई जा चुकी समस्या है, बल्कि "उस वास्तविक markup को पुनर्गठित (reconstruct) करना है जिसे एक इंसान ने इस पेज को बनाने के लिए लिखा होगा।"
कोई OCR स्टेप नहीं, कोई bounding boxes नहीं, बस एक पेज इमेज इन और मार्कअप आउट
Nougat को जो चीज़ दिलचस्प बनाती है, वह है वह काम जो यह नहीं करता है। ज़्यादातर document-understanding पाइपलाइन्स कई चरणों को जोड़कर बनाई जाती हैं: पहले टेक्स्ट ब्लॉक्स का पता लगाना, फिर हर ब्लॉक पर OCR चलाना, टेबल्स को अलग से डिटेक्ट करना, गणित जैसे दिखने वाले हिस्सों पर formula recognizer चलाना, और फिर इन सबको जोड़कर एक सुसंगत दस्तावेज़ बनाने की कोशिश करना। हर चरण अपनी गलतियाँ लेकर आता है, और वे गलतियाँ समय के साथ बढ़ती जाती हैं।
Nougat इन सब चरणों को छोड़ देता है। यह एक सिंगल Visual Transformer मॉडल है जो PDF पेज की एक rasterized image (96 DPI पर रेंडर की गई, और 896×672 पिक्सेल के फिक्स्ड बॉक्स में रिसाइज की गई) लेता है और सीधे markup tokens की एक स्ट्रीम आउटपुट करता है—एक-एक करके, ठीक उसी तरह जैसे एक language model एक के बाद एक टोकन लिखता है। आंतरिक रूप से, यह एक Swin Transformer (एक विज़न मॉडल जो इमेज को hierarchical patches में प्रोसेस करता है) को mBART आधारित एक decoder के साथ जोड़ता है, जो आउटपुट सीक्वेंस जेनरेट करता है और लिखते समय इमेज फीचर्स पर cross-attend करता है। इसमें कोई अलग math-detection मॉड्यूल या layout-analysis चरण नहीं है। मॉडल बस पूरे पेज को देखता है और जो कुछ भी उसे दिखता है, उसे एक हल्के markup format में लिख देता है, जो headings, bold और italic टेक्स्ट, algorithms, inline और display LaTeX math, और LaTeX tables को दर्शा सकता है।
इसके दो साइज़ रिलीज़ किए गए थे: एक base model जिसमें 350 million parameters और 10 decoder layers हैं, और एक छोटा मॉडल जिसमें 250 million parameters और 4 layers हैं। दोनों ही "आप इसे एक साधारण GPU पर चला सकते हैं" वाली रेंज में आते हैं, न कि उस frontier-scale क्षेत्र में जिसे लोग आजकल "large" मॉडल कहते समय इस्तेमाल करते हैं।
मॉडल बनाने से पहले उन्हें ट्रेनिंग डेटा तैयार करना था
इस प्रोजेक्ट का वास्तव में सबसे कठिन हिस्सा शायद इसका आर्किटेक्चर नहीं था। असली चुनौती "पेज इमेज और उसे बनाने वाले सटीक मार्कअप" के लाखों उदाहरण खोजने की थी, क्योंकि ऐसा पेयरिंग वाला कोई भी रेडी-मेड डेटासेट उपलब्ध नहीं था।
उनकी तरकीब यह थी: arXiv पेपर्स केवल रेंडर किए गए PDF के रूप में नहीं, बल्कि उनके मूल LaTeX सोर्स के साथ सबमिट किए जाते हैं। इसलिए टीम ने LaTeX सोर्स लिया, उसे LaTeXML नामक टूल का उपयोग करके HTML में बदला, और फिर उस HTML को अपने स्वयं के लाइटवेट मार्कअप फॉर्मेट में बदल दिया। अब उनके पास ग्राउंड-ट्रुथ मार्कअप था। इसके बाद उन्होंने उसी सोर्स को PDF में रेंडर किया और पेजों को इमेज में बदल दिया। अब उनके पास एक मैचिंग पेयर था: सटीक इमेज और सटीक मार्कअप, जिसमें किसी मैनुअल लेबलिंग की आवश्यकता नहीं थी।
इसी प्रक्रिया से उनके अधिकांश ट्रेनिंग डेटा का निर्माण हुआ: उपयोग करने योग्य LaTeX सोर्स वाले 1.7 मिलियन arXiv आर्टिकल्स से 7.5 मिलियन पेज। उन्होंने इसमें PubMed Central से 536,000 पेज जोड़े (जिन्हें LaTeX के बजाय XML से पार्स किया गया था), और Industry Documents Library से 447,000 पेज जोड़े, जो डिजिटली-बॉर्न PDF के बजाय वास्तविक स्कैन किए गए दस्तावेज़ थे, ताकि मॉडल को असली स्कैनर नॉइज़ का अनुभव मिल सके। कुल मिलाकर: लगभग 8.2 मिलियन पेज-मार्कअप पेयर्स। यह इस पेपर का वह हिस्सा है जो सुनने में शायद रोमांचक न लगे, लेकिन संभवतः इसी ने बाकी सब कुछ संभव बनाया। खराब डेटा पर ट्रेन किया गया एक चतुर आर्किटेक्चर आमतौर पर सही ढंग से पेयर किए गए उदाहरणों के विशाल ढेर पर ट्रेन किए गए एक साधारण आर्किटेक्चर से हार जाता है।
परिणाम: प्लेन टेक्स्ट पर दमदार, गणित में ठोस, लेकिन टेबल्स में अब भी कमजोर
उनके arXiv टेस्ट सेट पर, Nougat का ओवरऑल edit distance (मोटे तौर पर, मॉडल के आउटपुट को सही उत्तर में बदलने के लिए कितने कैरेक्टर-लेवल insertions, deletions और substitutions की आवश्यकता होती है, जहाँ कम स्कोर बेहतर माना जाता है) 0.071 रहा, जिसमें ओवरऑल F1 93.1% और BLEU स्कोर 89.1 था। यदि इसे कंटेंट टाइप के आधार पर देखा जाए, तो तस्वीर और भी दिलचस्प हो जाती है:
- Plain text: edit distance 0.058, F1 95.7%। यह समस्या लगभग हल हो चुकी है।
- Math: edit distance 0.128, F1 76.5%, BLEU 56.9। यह काफी कठिन है, लेकिन उपयोग करने योग्य है, और अन्य विकल्पों की तुलना में एक बहुत बड़ी छलांग है।
- Tables: edit distance 0.211, F1 78.0%, BLEU 69.7। यह सबसे कमजोर कैटेगरी है, और यह व्यवहार में भी दिखता है: merged cells और अनियमित लेआउट अभी भी इसे भ्रमित करते हैं।
तुलना के लिए, एम्बेडेड PDF लेयर से सीधे टेक्स्ट निकालना (जब वह उपलब्ध होता है) 0.255 का edit distance देता है, जो Nougat के math स्कोर से भी खराब और Nougat के plain-text स्कोर से लगभग चार गुना ज्यादा खराब है। वहीं GROBID, जो साइंटिफिक PDFs को पार्स करने के लिए व्यापक रूप से इस्तेमाल किया जाने वाला टूल है, फॉर्मूला के लिए एक समर्पित LaTeX-OCR एड-ऑन के साथ होने के बावजूद, गणित (math) पर केवल 9.7% F1 तक पहुँच पाया। यह तुलना पूरे पेपर का मुख्य परिणाम है: गणित को उपयोग योग्य LaTeX में बदलना इंडस्ट्री में काफी समय से एक बड़ी चुनौती बनी हुई थी, और यह उन पहले दृष्टिकोणों में से एक है जिसने इसमें सार्थक सुधार किया है।
जब मॉडल एक लूप में फंस जाता है
इस पेपर का सबसे ईमानदार हिस्सा इसका failure analysis है, और इसमें सबसे प्रमुख failure mode वह है जिसे autoregressive generation पर काम करने वाला कोई भी व्यक्ति तुरंत पहचान लेगा: repetition collapse। टेस्ट सेट के लगभग 1.5% मामलों में, मॉडल एक ही वाक्य, सिंबल या लाइन को बार-बार प्रेडिक्ट करने लगता है और आगे नहीं बढ़ पाता। यह अक्सर उन पेजों पर होता है जो ट्रेनिंग डेटा के distribution से बाहर होते हैं: जैसे कि ज्यादातर खाली पेज, असामान्य लेआउट वाले पेज, या भारी noise वाले स्कैन किए हुए दस्तावेज़।
टीम ने इसे ठीक करने के लिए inference time पर एक detection-and-recovery ट्रिक का इस्तेमाल किया, साथ ही ट्रेनिंग के दौरान एक data augmentation strategy अपनाई, जिसमें मॉडल को जानबूझकर repetitive और degenerate उदाहरण दिखाए गए ताकि वह लूप से बाहर निकलना सीख सके। इस कॉम्बिनेशन ने repetition rate को 32% तक कम कर दिया। यह एक वास्तविक सुधार है, लेकिन साथ ही यह इस बात की स्वीकारोक्ति भी है कि समस्या पूरी तरह से हल नहीं हुई है। यदि आप प्रोडक्शन उपयोग के लिए इस तरह के टूल का मूल्यांकन कर रहे हैं, तो "कभी-कभी एक ही लाइन को अनंत काल तक दोहराते रहना" बिल्कुल वैसा ही failure mode है जिसके बारे में आप पहले से जानना चाहेंगे, क्योंकि यह silent होता है: कुछ भी क्रैश नहीं होता, बस आपको ऐसा कचरा आउटपुट मिलता है जो ऊपर से देखने में सही लगता है।
कुछ अन्य सीमाएं जिनके बारे में जानना जरूरी है: मॉडल एक बार में एक ही पेज प्रोसेस करता है और उसे अन्य पेजों की कोई याद (memory) नहीं रहती, इसलिए bibliographies की नंबरिंग और सेक्शन्स के बीच cross-references एक मल्टी-पेज दस्तावेज़ में असंगत (inconsistent) हो सकते हैं। इसे लगभग पूरी तरह से English टेक्स्ट पर ट्रेन किया गया था, और non-Latin scripts वाले दस्तावेज़ों के मामले में यह धीरे-धीरे खराब होने के बजाय पूरी तरह से फेल हो जाता है। स्कैन किए गए कागजी दस्तावेज़ों का प्रदर्शन उन PDFs की तुलना में काफी खराब रहता है जो शुरू से ही डिजिटल रूप से टाइपसेट किए गए थे; यह समझ में आता है क्योंकि ट्रेनिंग डेटा का एक बड़ा हिस्सा साफ-सुथरे, born-digital arXiv पेजों पर आधारित था। और यह धीमा है: एक NVIDIA A10G GPU पर, छह पेजों को पैरेलल में प्रोसेस करने में प्रति बैच लगभग 19.5 सेकंड लगे, जो प्रति पेज लगभग 1,400 tokens बैठते हैं। इसके विपरीत, GROBID लगभग 10.6 PDFs प्रति सेकंड प्रोसेस करता है। यह कोई करीबी मुकाबला नहीं है। Nougat कठिन मामलों में सटीकता (accuracy) पाने के लिए अपनी गति (speed) का काफी त्याग करता है।
यदि आप OCR पाइपलाइन बना रहे हैं या चुन रहे हैं, तो यह क्यों महत्वपूर्ण है
अगर आपके दस्तावेज़ कॉन्ट्रैक्ट्स, इनवॉइस या फॉर्म्स हैं, तो इनमें से कुछ भी आपके लिए सीधे तौर पर प्रासंगिक नहीं है। Nougat को लगभग पूरी तरह से academic papers पर ट्रेन किया गया था, और यह साफ़ दिखता है: multi-column मैगज़ीन लेआउट, handwriting और बिज़नेस दस्तावेज़ उस दायरे से बाहर हैं जिसके लिए इसे बनाया गया था।
लेकिन अगर आप scientific या technical PDFs के साथ काम कर रहे हैं जहाँ formulas, tables और structured markup का असल महत्व होता है, तो इस पेपर से मिलने वाली सीख Nougat से कहीं आगे तक जाती है। यह इस बात का एक working demonstration है कि end-to-end image-to-markup मॉडल्स उन पाइपलाइन्स को मात दे सकते हैं जो OCR, layout detection और एक अलग formula recognizer को जोड़कर बनाई जाती हैं, कम से कम structured technical content के लिए। math recognition पर 9.7%-versus-76.5% का अंतर दो औसत एप्रोच के बीच का मामूली अंतर नहीं है। यह एक ऐसे टूल और एक ऐसे टूल के बीच का अंतर है, जिस पर आप रिसर्च पेपर के लिए कभी भरोसा नहीं करेंगे बनाम जिस पर आप वास्तव में एक प्रोडक्ट बना सकते हैं।
OCR इंजनों का मूल्यांकन करने वाले किसी भी व्यक्ति के लिए practical takeaway यह है: "handles text well" और "handles math and tables well" वास्तव में अलग-अलग capabilities हैं, और कई वेंडर्स खुशी-खुशी आपको एक overall accuracy नंबर बताएंगे जो इन दोनों के बीच के बड़े अंतर को छिपा देता है। यहाँ यह ध्यान रखना ज़रूरी है कि अच्छी English OCR का मतलब यह नहीं है कि Devanagari OCR भी उतना ही सटीक होगा, क्योंकि देवनागरी की जटिल बनावट के लिए अलग चुनौतियों का सामना करना पड़ता है। अगर आपके दस्तावेज़ों में equations की भरमार है, तो केवल general text accuracy के बजाय विशेष रूप से formula और table performance के बारे में पूछें। साथ ही, repetition collapse जैसे failure modes पर नज़र रखें। एक मॉडल जो किसी खराब पेज पर कभी-कभी अनंत लूप (loop) में फंस जाता है, वह उस मॉडल से अलग तरह का रिस्क है जो औसत रूप से थोड़ा कम सटीक है; और इस तरह की समस्याएँ तभी सामने आती हैं जब आप किसी साफ़-सुथरे benchmark set के बजाय अपने खुद के अजीब, real-world दस्तावेज़ों पर टेस्ट करते हैं।