为什么在 Nougat 出现之前,最好的 PDF 转数学公式工具的准确率不足 10%
参考论文: Nougat: Neural Optical Understanding for Academic Documents — Lukas Blecher, Guillem Cucurull, Thomas Scialom, Robert Stojnic
挑战 PDF 中的数学公式
你可以试一下:打开一篇物理论文的 PDF,复制其中的一个公式并粘贴到文本文件中。你得到的绝对不是一个公式,而是一堆杂乱无章的符号——顺序可能是错的,分数线或求和符号可能完全丢失。这是因为 PDF 格式的设计初衷是描述墨水在页面上的分布位置,而不是这些墨水代表的含义。对于阅读来说这没问题,但对于内容的复用来说简直是一场灾难。
Meta AI 的一个团队(Lukas Blecher, Guillem Cucurull, Thomas Scialom, 和 Robert Stojnic)决定正面解决这个问题,他们开发了一个名为 Nougat 的模型(全称 Neural Optical Understanding for Academic Documents)。他们报告的结果令人震惊:在 arXiv 论文的测试集上,当时最强大的 PDF 数学公式提取工具的 F1 score 仅为 9.7% 左右;而 Nougat 达到了 76.5%。这不仅仅是一次小幅提升,而是将该功能从“除了纯文本段落外完全不可用”提升到了“足以支撑后续开发”的水平。
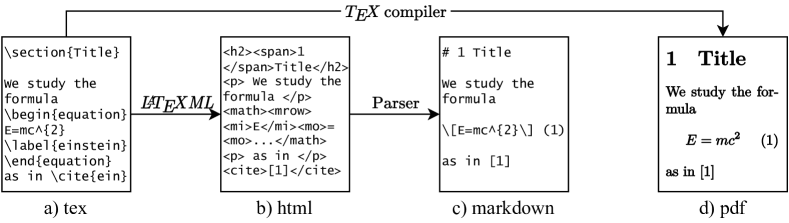
图表来自 Nougat: Neural Optical Understanding for Academic Documents (Blecher et al., arXiv:2308.13418),采用 CC BY-SA 4.0 许可。
为什么 PDF 并不像你想象的那样包含文本
这里有一个最容易让人产生误解的地方:PDF 页面看起来是有文本的,有时你甚至可以选中并复制这些文本。但实际上,PDF 存储的是一组指令,例如“在坐标 (412, 88) 处绘制小写 sigma 的字符形状”。它并没有“这个 sigma 是一个跨三行求和公式的一部分”或者“这是一个第二列的表格单元格”这样的概念。阅读顺序、结构和语义全部被扁平化成了堆叠在一起的定位形状。
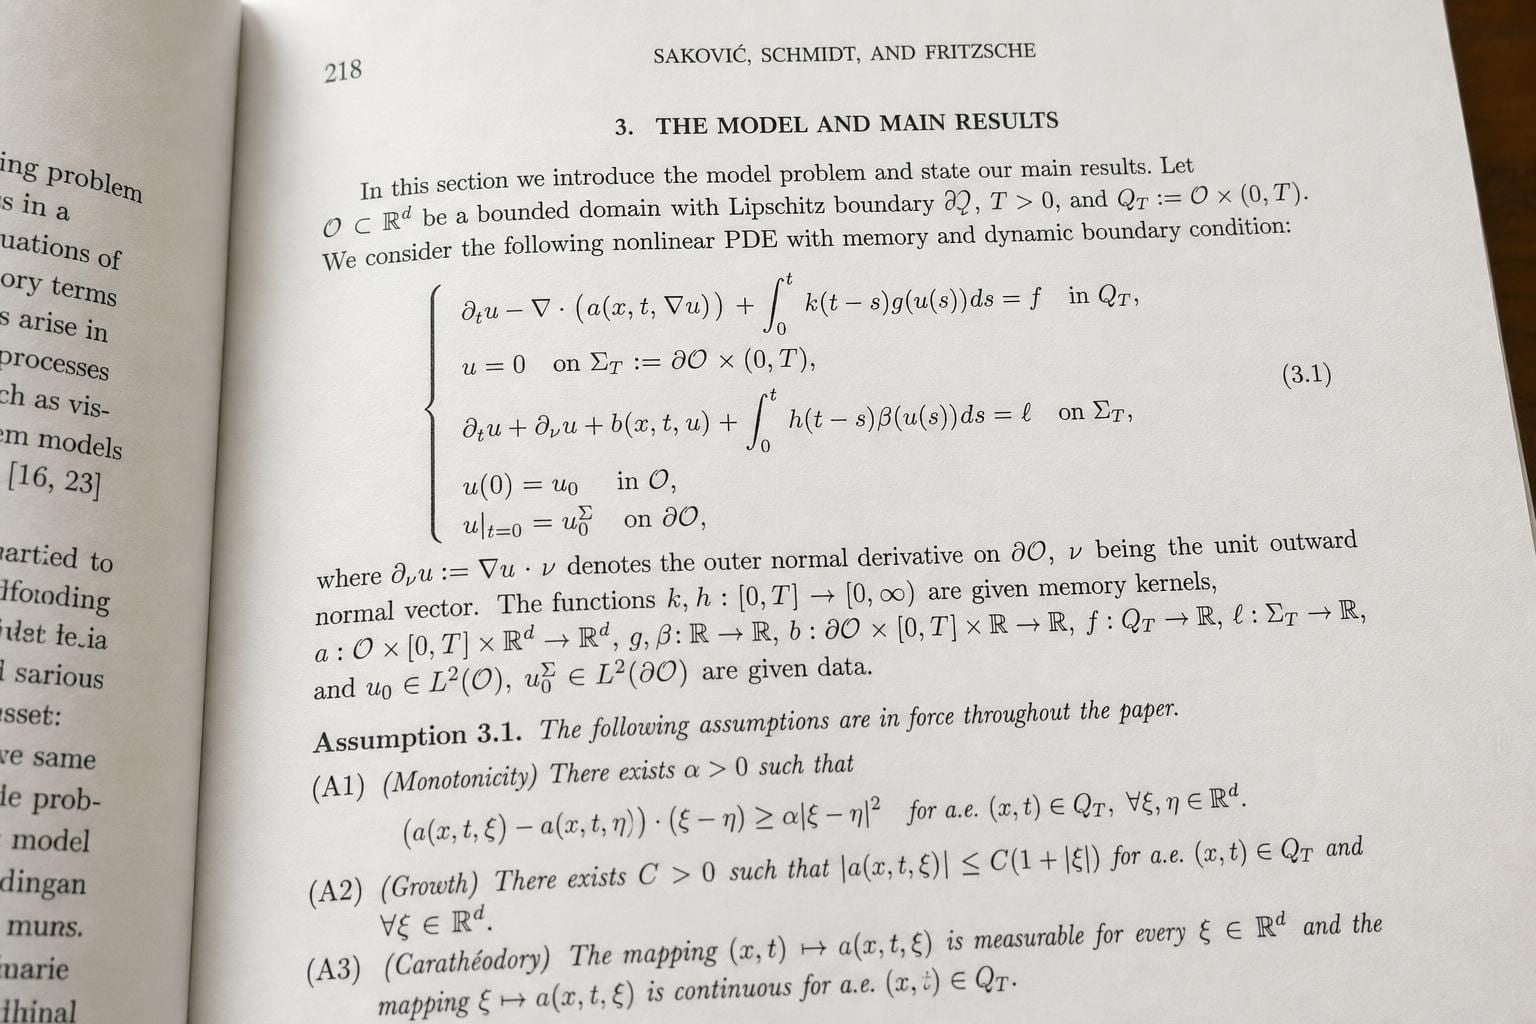
对于普通的英文段落,这通常不是问题。现有的 PDF 文本提取和 OCR 工具足以将这些字符重新拼接成可读的句子。但学术论文中充满了无法在扁平化过程中幸存的内容:嵌套分式、矩阵、多行公式、带有合并单元格的表格,以及具有特定含义的缩进算法。如果你要求一个标准的 OCR 流水线从扫描的数学论文中还原出可运行的 LaTeX 公式,你得到的通常是一堆乱码。
这正是 Nougat 试图填补的空白:它不是在做“读取页面上的文字”(这已经是一个被解决的问题),而是在做“重建人类为了生成这个页面而编写的实际标记语言(markup)”。
无需 OCR 步骤,无需边界框,仅需输入页面图像即可输出标记语言
Nougat 最有趣的设计选择在于它“不做什么”。大多数文档理解流水线是由多个阶段拼接而成的:先检测文本块的位置,对每个块运行 OCR,单独检测表格,对任何看起来像数学公式的内容运行公式识别器,然后尝试将所有这些碎片重新缝合成一个连贯的文档。每一个阶段都会引入自身的误差,而这些误差会不断累积。
Nougat 跳过了所有这些步骤。它是一个单一的 Visual Transformer 模型,输入是 PDF 页面的光栅化图像(以 96 DPI 渲染,并调整大小以适应固定的 896×672 像素区域),然后直接逐个输出标记 token 流,就像语言模型逐个生成文本一样。在底层,它将 Swin Transformer(一个通过分层补丁处理图像的视觉模型)与基于 mBART 的解码器相结合;解码器在生成输出序列时,会通过交叉注意力机制(cross-attends)回溯图像特征。这里没有独立的数学检测模块,也没有布局分析阶段。模型只需观察整个页面,然后将其看到的内容写成一种轻量级的标记格式,这种格式可以表达标题、加粗和斜体文本、算法、行内和独立块 LaTeX 数学公式以及 LaTeX 表格。
该模型发布了两种尺寸:一个拥有 10 个解码器层、3.5 亿参数的基础模型,以及一个拥有 4 个解码器层、2.5 亿参数的较小模型。两者都处于“可以在单块主流 GPU 上运行”的范围内,而非人们如今在提到“大”模型时通常指的那种前沿规模。
在构建模型之前,他们必须先构建训练数据
这个项目真正困难的部分可能不在于架构,而在于如何获取数百万组“页面图像及其对应的精确标记(markup)”示例,因为这种配对数据在任何现成的数据集中都不存在。
他们的巧妙之处在于:arXiv 论文在提交时会附带原始 LaTeX 源码,而不仅仅是渲染后的 PDF。因此,团队获取 LaTeX 源码,使用名为 LaTeXML 的工具将其转换为 HTML,然后再将 HTML 转换为他们自定义的轻量级标记格式。至此,他们获得了基准真相(ground-truth)标记。随后,他们将同一份源码渲染为 PDF 并将页面栅格化为图像。这样,他们就拥有了一组匹配对:精确的图像和精确的标记,完全无需手动标注。
这一流程产生了大部分训练数据:来自 170 万篇具有可用 LaTeX 源码的 arXiv 文章中的 750 万个页面。此外,他们还加入了来自 PubMed Central 的 53.6 万个页面(由 XML 而非 LaTeX 解析而来),以及来自 Industry Documents Library 的 44.7 万个页面(这些是真实的扫描文档而非数字化生成的 PDF),以让模型接触到真实的扫描噪声。总计约 820 万组页面-标记配对。这是论文中最不显眼的部分,但可以说正是这部分工作让其余的一切成为可能。一个在劣质数据上训练的精巧架构,通常敌不过一个在海量正确配对示例上训练的平庸架构。
测试结果:纯文本表现强劲,数学公式稳健,表格依然不稳定
在 arXiv 测试集上,Nougat 的整体编辑距离(roughly,指将模型输出转换为正确答案所需的字符级插入、删除和替换次数,数值越低越好)为 0.071,整体 F1 值为 93.1%,BLEU 分数为 89.1。如果按内容类型拆分,结果会变得更有意思:
- 纯文本 (Plain text):编辑距离 0.058,F1 95.7%。这几乎已经解决了。
- 数学公式 (Math):编辑距离 0.128,F1 76.5%,BLEU 56.9。难度大得多,但已具备可用性,且相比其他替代方案有了巨大的飞跃。
- 表格 (Tables):编辑距离 0.211,F1 78.0%,BLEU 69.7。这是表现最弱的类别,在实际应用中也可见而知:合并单元格和不规则布局仍然会让模型感到困惑。
作为对比,直接从 PDF 嵌入层提取文本(如果该层存在的话)得到的编辑距离为 0.255,比 Nougat 的数学分数还要差,几乎是 Nougat 纯文本分数的四倍。而广泛用于解析科学 PDF 的工具 GROBID,即使在配备了专门的 LaTeX-OCR 公式插件后,在数学公式上的 F1 值也仅达到了 9.7%。这一对比是整篇论文的核心结论:将数学公式转换为可用的 LaTeX 在行业内长期以来几乎处于失效状态,而 Nougat 是首批能产生实质性突破的方法之一。
当模型陷入循环时
该论文中最坦诚的部分是失效分析,其中最显著的失效模式是任何接触过自回归生成的人都会立即认出的问题:重复崩溃(repetition collapse)。在约 1.5% 的测试集上,模型会陷入不断预测同一个句子、符号或行的死循环,无法继续向下生成。这种情况通常发生在超出训练数据分布的页面上:主要是空白页、布局异常的页面或噪声严重的扫描文档。
团队采取的解决方案是在推理阶段使用一种“检测与恢复”技巧,并在训练期间采用数据增强策略,刻意让模型接触重复且退化的样本,从而学习如何打破循环。这一组合将重复率降低了 32%。这是一个实质性的改进,但同时也承认该问题尚未完全解决。如果你在评估此类工具以用于生产环境,“偶尔会陷入永无止境的重复吟诵”正是你需要提前了解的失效模式,因为这种错误是静默的:系统不会崩溃,你只会得到一些表面上看起来合理但实际上是垃圾的输出。
其他值得关注的局限性还包括:模型一次处理一页,且不具备对其他页面的记忆,因此在多页文档中,参考文献的编号和章节间的交叉引用可能会出现不一致。该模型几乎完全基于英文文本训练,面对非拉丁脚本的文档时会直接失效,而不会平稳地性能下降。扫描的纸质文档表现明显差于原生数字化排版的 PDF,考虑到训练数据大量倾向于干净的 born-digital arXiv 页面,这在情理之中。此外,它的速度较慢:在 NVIDIA A10G GPU 上,并行处理 6 页大约需要 19.5 秒每批次,每页约 1,400 个 token。相比之下,GROBID 每秒可处理约 10.6 个 PDF。两者完全不在一个量级。Nougat 用大量的速度牺牲换取了在复杂案例上的准确率。
为什么这对于构建或选择 OCR 流水线至关重要
如果你的文档是合同、发票或表单,那么上述内容与你没有直接关系。Nougat 几乎完全是在学术论文上训练的,这一点显而易见:多栏杂志布局、手写体以及商业文档都超出了它的设计范围。
但如果你处理的是包含公式、表格和结构化标记的科学或技术 PDF,且这些元素承载着核心含义,那么这篇论文带来的启示就超越了 Nougat 本身。它提供了一个切实可行的证明:对于结构化技术内容,端到端的“图像到标记”(image-to-markup)模型可以击败由 OCR、布局检测和独立公式识别器拼接而成的流水线。在数学识别上,9.7% 与 76.5% 的差距绝非两种平庸方案之间的微小波动,而是决定了该工具是“绝不敢交给它处理研究论文”还是“真正可以基于其构建产品”的本质区别。
对于任何评估 OCR 引擎的人来说,实际的经验教训是:“文本处理能力强”与“数学公式和表格处理能力强”完全是两种不同的能力。许多供应商会乐于向你提供一个整体准确率数字,从而掩盖两者之间的巨大差距。由于汉字等对数文字具有极高的字符密度和复杂的布局特性,在评估此类模型时需格外关注其对密集排版内容的解析能力。如果你的文档中充斥着大量等式,请专门询问公式和表格的性能,而不仅仅是通用文本的准确率。此外,要留意像“重复崩溃”(repetition collapse)这样的失效模式。一个偶尔会在糟糕页面上陷入死循环的模型,其带来的风险与一个平均准确率稍低的模型截然不同;而且这类问题只有在你使用真实的、复杂的自有文档进行测试时才会暴露,而非在干净的基准测试集中。