مجموعة بيانات الامتحانات التي تُصحِّح وفق سلالم تقييم محددة لا بالانطباعات العامة
استنادًا إلى: Multimodal examination answer data with expert-designed Outcome-Based Education rubrics for criterion-level assessment — Jahangir Alam SM, Md Khalid Syfullah, Saad Ahmed, Munira Akter Mou, A K Z Rasel Rahman, A. K. M. Masudur Rahman, Mohammed Sowket Ali
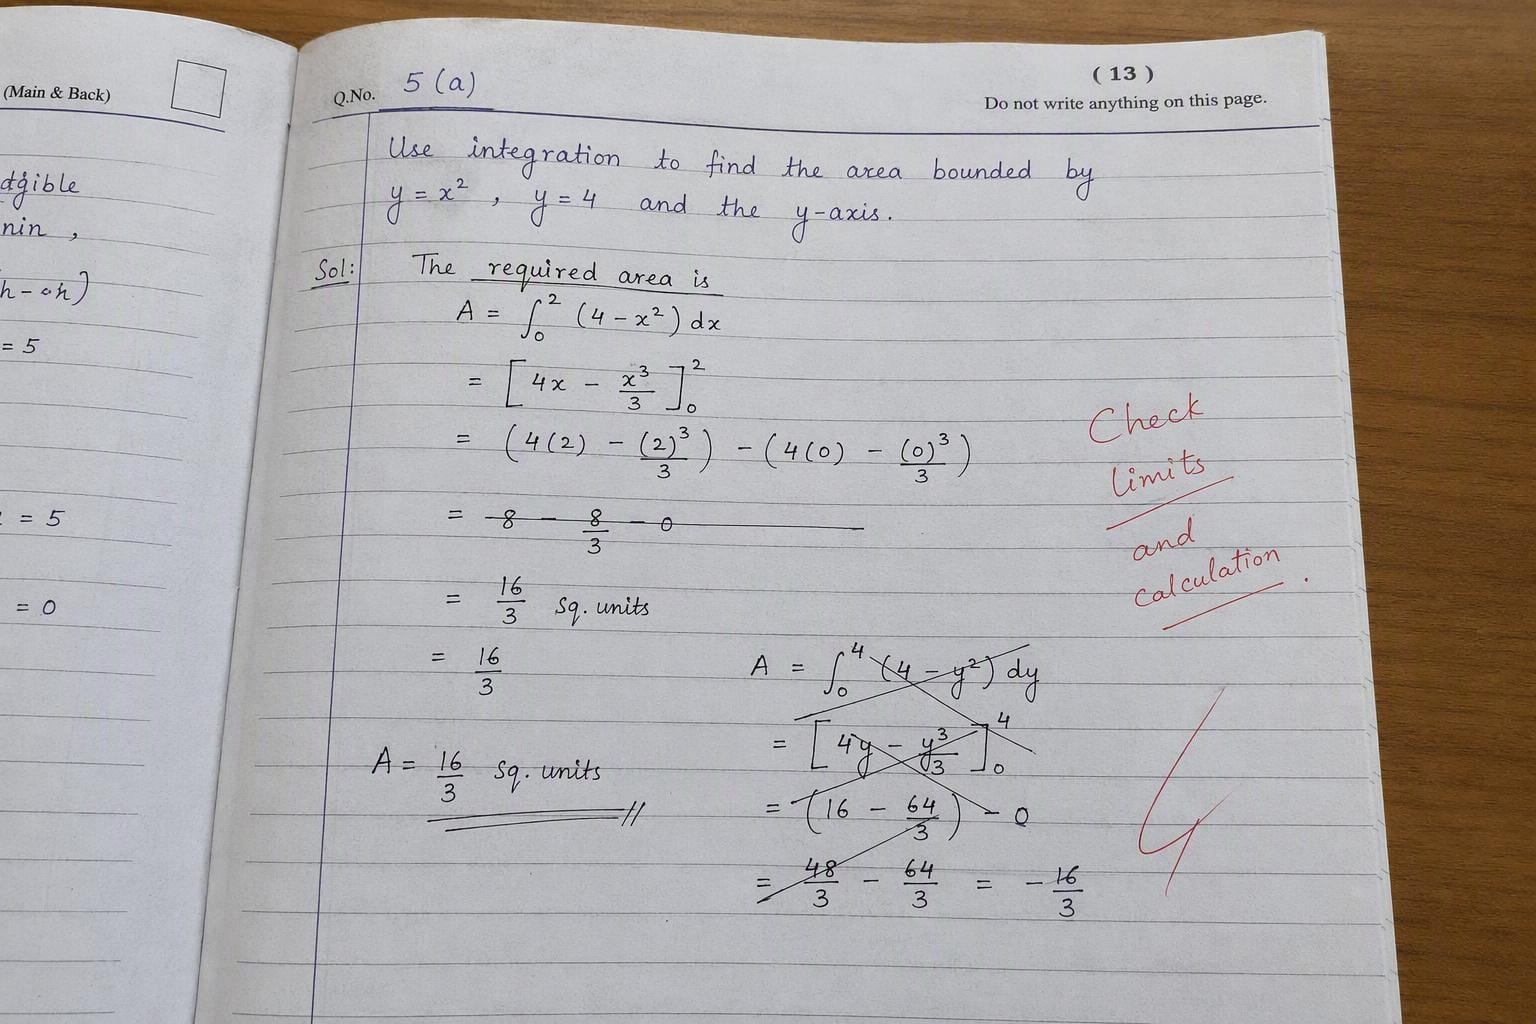
تخيّل ورقة امتحان في الفيزياء جرى مسحها ضوئيًا بكاميرا هاتف محمول، مائلة بضع درجات، وتغمرها إضاءة خافتة غير متساوية من مصباح فلورسنت علوي. شطب الطالب استنتاجًا رياضيًا خاطئًا، وحشر التصحيح في الهامش، ورسم بجانبه مخطط جسم حر (free-body diagram) غير متناسق. والآن، سلّم تلك الصفحة إلى مصحح آلي يعتمد على الذكاء الاصطناعي واطرح عليه سؤالاً دقيقًا ومحددًا للغاية: هل يستحق هذا المخطط درجتين من أصل ثلاث درجات مخصصة لمعيار «تحديد اتجاهات القوى بشكل صحيح»، أم يستحق درجة واحدة فقط؟
لا يكاد يرتبط هذا السؤال بقراءة الخط اليدوي إطلاقًا؛ فالقراءة هي الجزء السهل، أو على الأقل هي الجانب الذي استغرقت أبحاث التعرف الضوئي على الحروف (OCR) عقدين كاملين لإتقانه. أما الجزء الصعب حقًا فهو مطابقة عمل بشري غير مرتب بسلم تقييم (rubric) وضعه أستاذ المادة قبل أشهر، وتحديد الاستحقاق الفعلي لكل معيار على حدة. وتستهدف مجموعة بيانات جديدة صادرة عن أربع مؤسسات أكاديمية في بنغلاديش، أعدّها ثمانية من أعضاء هيئة التدريس ووُصفت في ورقة بحثية نُشرت على arXiv في 23 أغسطس، هذه المعضلة الأكثر تعقيدًا بشكل مباشر. لا تسجل الورقة درجات أداء لأي نموذج، بل هي وصف لمجموعة بيانات (data descriptor)—وهو المعادل الأكاديمي لعبارة: «إليكم حزمة من البيانات صُممت بعناية، فاستفيدوا منها». ومع ذلك، فإن هذه الحزمة تحمل في طياتها تفاصيل مثيرة للاهتمام تتجاوز هذا الوصف البسيط.
التصحيح معضلة تختلف تمامًا عن القراءة
تُدرَّب وتُختبَر معظم معايير الذكاء الاصطناعي للمستندات (Document AI benchmarks) على مستندات مثل الإيصالات والفواتير والنماذج. وتتميز هذه الوثائق بكونها مهيكلة وقابلة للتوقع؛ فالإجمالي يظل إجماليًا، والتاريخ يظل تاريخًا. أما إجابات الامتحانات فليست كذلك على الإطلاق، إذ قد تضم الصفحة الواحدة فقرة نصية، ومعادلة كيميائية، وشفرة زائفة (pseudocode)، ورسمًا تخطيطيًا يدويًا، وجدولاً، وأحيانًا تجتمع كل هذه العناصر ضمن إجابة واحدة. وإذا أضفنا إلى ذلك خط اليد الذي يتفاوت تفاوتًا هائلاً من طالب لآخر، نجد أنفسنا أمام نمط من المستندات لم تُصمم خطوط معالجة الـ OCR التقليدية للتعامل معه أبدًا.
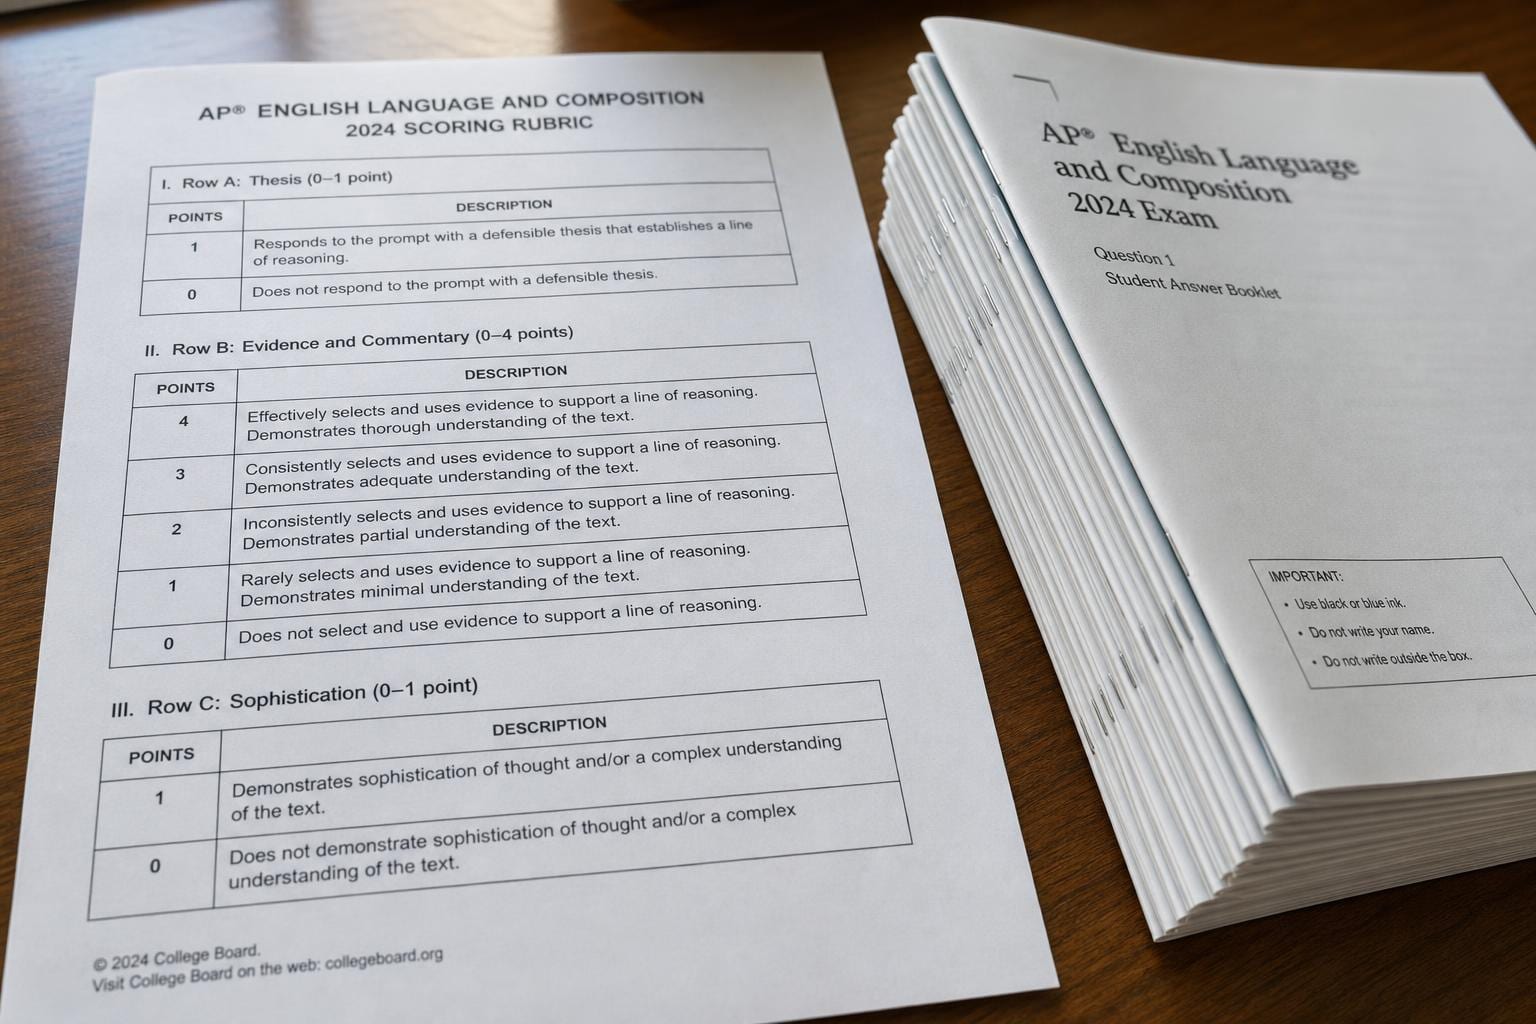
يأتي بعد ذلك الجانب الخاص بمجموعة البيانات هذه، وهو «التعليم القائم على المخرجات» (Outcome-Based Education أو اختصارًا OBE)، وهي فلسفة تقييم تعتمدها العديد من البرامج الهندسية والعلمية لأغراض الاعتماد الأكاديمي. فبدلاً من أن يقرأ الأستاذ الإجابة ويكتب «8/10» بناءً على انطباعه الشخصي، يفرض نظام OBE سلم تقييم صريحًا: قائمة من المعايير (مثل: «يذكر الصيغة الصحيحة»، «يستخدم الوحدات السليمة»، «يُظهر استنتاجًا مرتبًا منطقيًا»)، متبوعة بوصف دقيق لما يُعد أداءً قويًا أو كافيًا أو ضعيفًا في كل معيار، مع تحديد الحد الأقصى لدرجة كل منها. وتكون الدرجة الإجمالية مجرد حاصل جمع درجات تلك المعايير. إنها طريقة أكثر شفافية وقابلية للتدقيق في وضع الدرجات، وهي تحديدًا الهيكلية التي تحتاجها أبحاث التقييم الآلي إذا أرادت تقديم نتائج تتجاوز مجرد إعطاء رقم واحد مجرد.
تلك هي الفجوة التي تحاول هذه الورقة البحثية سدها. صحيح أن التصحيح الآلي للمقالات والإجابات القصيرة موجود منذ سنوات، إلا أن معظمه يركز على توقع درجة كلية شاملة (holistic score) من النصوص المطبوعة؛ فهو لا يوضح للطالب أي متطلب محدد قد أخفق فيه، ونادرًا ما يتعامل مع نصوص حقيقية مكتوبة بخط اليد وممسوحة ضوئيًا ومقترنة بسلالم تقييم فعلية. وتمنح مجموعة البيانات هذه الباحثين شطري المعضلة معًا في آن واحد، وعلى المستندات نفسها.
ما تحتويه المجموعة فعليًا
الأرقام هنا متواضعة، ويجدر بنا التمعن فيها قبل الإفراط في الحماس؛ إذ تضم مجموعة البيانات 485 مشاركة لإجابات امتحانات فردية من 415 طالبًا وافقوا على المشاركة من أربع مؤسسات، وتغطي تسع مواد دراسية و12 نموذج أسئلة متميزًا. وتحدد سلالم التقييم الاثنا عشر مجتمعة 47 معيارًا إجماليًا، بمتوسط يقارب أربعة معايير لكل سلم تقييم.
تمثل كل إجابة في المجموعة حزمة مصغرة متكاملة وليست مجرد ملف PDF. فإلى جانب الإجابة الممسوحة ضوئيًا، أرفق المؤلفون ما يلي:
- معرفًا عشوائيًا (randomized identifier)، بحيث يتعذر تتبع الملف والوصول إلى هوية طالب بعينه
- تصنيف المادة ونص السؤال الأصلي
- إجابة نموذجية كتبها مدرس المادة
- سلم التقييم: يتضمن تعريفات المعايير وتوصيف مستويات الأداء لكل منها
- الدرجات الممنوحة فعليًا لكل معيار، بالإضافة إلى الدرجة الإجمالية
يحظى هذا البند الأخير بأهمية بالغة تفوق ما يبدو للوهلة الأولى. فالعديد من مجموعات بيانات «التصحيح» لا توفر سوى الدرجة النهائية فقط، في حين توفر هذه المجموعة المسار التوثيقي الدقيق (paper trail): أي المعايير نال عددًا معينًا من النقاط؛ مما يتيح اختبار النموذج المُدرَّب ليس فقط لمعرفة ما إذا كان قد توقع المجموع الصحيح، بل للتأكد مما إذا كان قد توصل إلى تلك النتيجة للأسباب الصحيحة.
أما النسخ الممسوحة ضوئيًا نفسها فتبدو بعيدة كل البعد عن المثالية عن عمد؛ إذ جاء بعضها عبر تطبيق CamScanner، وبعضها عبر Adobe Scan، وبعضها الآخر عبر الماسحات الضوئية المسطحة التقليدية (flatbed scanners). وقد أبقى الباحثون على التباينات الناتجة في الإضاءة والتباين والاتجاه ومعدل الضغط ودقة الصورة بدلاً من توحيدها وإزالتها بالتنقيح. كما احتفظوا بالعشوائية البشرية الواقعية: اختلاف أساليب الخطوط، والشطب، والحسابات المعدلة، والتصحيحات المحشورة في الهوامش. فإذا كنت قد تعاملت سابقًا مع مجموعات بيانات OCR أكاديمية «نقية»، فإن هذا يناقض ما اعتدت عليه تمامًا، ولكنه الخيار الأكثر واقعية ومصداقية؛ فالقاعات الدراسية الحقيقية لا تقدم لك ورقة إجابة ممسوحة بماسح مسطح وبإضاءة مثالية، بل تعطيك ما التقطه طالب متوتر بأي هاتف كان في حوزته.
العمل الشاق وغير المرئي لجعل مجموعة البيانات موثوقة
تقوم المقالات الوصفية للبيانات مثل هذه الورقة وتفشل بناءً على التفاصيل الروتينية الدقيقة، وقد بذل المؤلفون جهدًا حقيقيًا فيها. فقبل إدراج أي عنصر في المجموعة النهائية، قاموا بدمج المشاركات الواردة من أربع مؤسسات مختلفة تتبع أساليب أرشفة متباينة، وتوحيد التسميات وتنسيق النصوص، والتحقق من صحة الدرجات ومقارنتها بالحدود القصوى لسلم التقييم، وتعمية كلٍّ من معرفات الطلاب وأسماء ملفات الـ PDF عشوائيًا حتى لا يكشف اسم الملف عن هوية مرسله. كما أجروا فحصًا لسلامة الربط بين ملفات JSON وملفات الـ PDF للتأكد من أن البيانات الوصفية (metadata) لكل إجابة تشير بالفعل إلى الملف الممسوح ضوئيًا الصحيح، وهو نوع من الأخطاء الخفية التي لا تظهر إلا عندما يُدرب شخص ما نموذجًا على مجموعة بيانات ارتبطت فيها البيانات الوصفية للسؤال رقم 14 خفيةً بالمسح الضوئي للإجابة رقم 9.
ثم دققوا المجموعة المكتملة تدقيقًا شاملاً: 485 مُعرّفًا فريدًا، و485 اسم ملف PDF فريدًا، وتطابقًا تامًا بين كل درجة إجمالية ومجموع درجات معاييرها، ووقوع كل درجة ضمن الحد الأقصى المحدد في سلم تقييمها. قد لا يبدو قراءة هذا الأمر مشوقًا، لكنه يصنع الفارق الحاسم بين مجموعة بيانات يثق بها الباحث وأخرى تضيع الأشهر الستة الأولى من أي مشروع يعتمد عليها في اكتشاف أخطاء إدخال البيانات الخاصة بها. فلو لم تتطابق الدرجة الإجمالية مع مجموع أجزائها، أو تشارك طالبان نفس المعرّف المفترض أن يكون فريدًا، لانهارت جدوى أي نموذج يُدرَّب عليها حتى قبل بدء تجربة واحدة. إن ضبط هذه المعايير التأسيسية لسلامة البيانات والإفصاح عنها بوضوح يزن قيمةً تفوق مجرد إضافة بضع مئات أخرى من أوراق الإجابات.
أهمية ذلك لكل من يطوّر أنظمة الـ OCR أو يختارها
إذا كنت تطوّر أنظمة الذكاء الاصطناعي للمستندات أو تُقيّمها، فإن الدرس المستفاد من هذه الورقة هو أن «نظام OCR الذي يُصحح الامتحانات» يمثل منتجًا مختلفًا كليًا عن «نظام OCR الذي يقرأ الامتحانات». فقد يتمكن النظام من تحويل استنتاج مكتوب بخط اليد إلى نص بدقة متناهية، لكنه يظل عديم الفائدة في التقييم إذا عجز عن ربط ذلك النص بمعيار محدد في سلم التقييم وتقدير مدى استيفائه له؛ فهذه معضلة استدلال ومطابقة مضافة فوق معضلة الإدراك البصري الأساسية، وهو ما لا تختبره أبدًا معظم معايير الـ OCR المعتادة (مثل الإيصالات، والفواتير، والنماذج، ووثائق الهوية).
ينعكس هذا عمليًا على عدة أمور تهم أي جهة تفاضل بين مزودي الخدمة أو تطور بنيتها الداخلية لتصحيح الامتحانات أو فحص الامتثال أو أي مهمة تتطلب تقييم المستندات بناءً على معايير صريحة بدلاً من مجرد استخراج الحقول منها:
- اختبر الأنظمة على أكثر المدخلات فوضوية مما ستواجهه فعليًا في الواقع، لا على أكثرها ترتيبًا ونظافة؛ فالكتابة بالخط العربي، على سبيل المثال، تفرض تحديات مضاعفة على أنظمة الـ OCR نظرًا لطبيعته المتصلة والكتابة من اليمين إلى اليسار وتغير أشكال الحروف بحسب موضعها والتشكيل الاختياري والترابطات الحرفية (ligatures). ويُعد المزيج المتعمد في هذه المجموعة بين تطبيقات المسح وتفاوت الإضاءة وأنماط الخط اليدوي تمثيلاً للواقع أفضل بكثير من المعايير المنقحة ذات الإضاءة المتجانسة.
- تساءل عما إذا كان النظام قادرًا على تعليل الدرجة وليس فقط استخراجها؛ فالمُقيّم الذي يدرك سلم التقييم ويقدم نتيجة مثل «3/5 في المعيار 2 لأن الاستنتاج الرياضي أغفل الشرط الحدي (boundary condition)» أثمن بكثير من نظام يكتفي بإخراج «72/100».
- انتبه لأي عدم تطابق خفي بين البيانات الوصفية المهيكلة والمستند الفعلي؛ وهو العيب الذي صُمم فحص التكامل بين JSON وPDF في هذه الورقة لاكتشافه. فأي خط معالجة يربط المحتوى المستخرج بسجلات خارجية (كسلم تقييم، أو بند في فاتورة، أو نموذج مطالبة) يحتاج إلى فحص تكامل مماثل، ومعظم الفرق لا تبني مثل هذا الفحص إلا بعد وقوع خطأ بالفعل.
يجدر بنا أيضًا أن نكون واقعيين ونعترف بأن «التقييم الآلي المدرك لسلالم التقييم»—وهو أحد مجالات الاستخدام المستهدفة في الورقة—ما يزال إلى حد كبير هدفًا طموحًا في مراحله الأولى. تتيح هذه البيانات البدء بالعمل في هذا الاتجاه، غير أنه لم ينشر أحد بعد نتائج تبرهن على وجود نموذج يمكنه تقييم رسم تخطيطي يدوي وفقًا لمعيار تقييم بموثوقية؛ وتلك هي الحدود الفعلية للتقنية في الوقت الراهن، وهي أبعد مما توحي به الحملات التسويقية في مجال الـ OCR.
ما لا يمكن لمجموعة البيانات هذه إخبارك به بعد
إن الورقة البحثية الوصفية للبيانات تُعد وعدًا وإعلانًا عن إمكانات وليست استعراضًا لنتائج منجزة، لذا ينبغي لنا النظر إلى الفجوات برؤية واضحة وموضوعية.
يأتي الحجم كأبرز تلك الفجوات وأوضحها؛ فـ 485 إجابة موزعة على 12 سلم تقييم تكفي للضبط الدقيق (fine-tune) لنموذج أو لتقييمه، لكنها لا تكفي أبدًا لتدريب نموذج من الصفر. ورغم أن تغطية تسع مواد دراسية تبدو واسعة، إلا أن وجود 12 نموذج أسئلة فقط إجمالاً يجعل تنوع أنماط الأسئلة في كل مادة محدودًا على الأرجح؛ وبالتالي، فإن أي نموذج يحقق نتائج جيدة هنا قد يكون واقعًا في فخ فرط المطابقة (overfitting) مع عدد محدود من هياكل سلالم التقييم.
وتشكل مسألة الوصول إلى البيانات قيدًا حقيقيًا آخر؛ إذ لم تُنشر البيانات للعامة، بل تتاح «عند الطلب المعقول» من المؤلف المسؤول (corresponding author) ولأغراض البحث العلمي فقط. وهو خيار مبرر ومنطقي لحماية خصوصية الطلاب، لا سيما مع كثرة الأعمال اليدوية التي قد تحتوي على مؤشرات لتحديد الهوية، إلا أن ذلك يعني أن المجموعة لن تتحول إلى معيار قياسي عام ومشترك على غرار ما حققته مجموعات مثل FUNSD أو DocVQA. وسيعمل كل بحث يستخدمها لاحقًا انطلاقًا من نقطة وصول مختلفة قليلاً، مما يزيد من صعوبة إعادة إنتاج النتائج والتحقق منها عبر المختبرات المختلفة.
كذلك لا يرد أي ذكر لمدى توافق المقيمين (inter-rater agreement) بين أعضاء هيئة التدريس الثمانية المشاركين. فإذا كان هناك أستاذان قد يضعان درجتين مختلفتين لنفس الاستنتاج المكتوب بخط اليد استنادًا إلى سلم التقييم ذاته، فإن هذا التباين يتحول إلى تشويش خفي مدمج ضمن درجات «الحقيقة الأرضية» (ground truth). ورغم أن الورقة توثق التطابق بين الدرجات الإجمالية ومجموع درجات المعايير—وهو فحص مهم للاتساق الداخلي—إلا أن ذلك لا يعادل التأكد من اتساق درجات المعايير نفسها بين مصحح وآخر.
وفوق ذلك، تبقى هذه الورقة مجرد مقال لوصف البيانات: لا نموذج خط أساس (baseline model)، ولا أرقام دقة، ولا تصور لمدى صعوبة المهمة عندما يحاول أحد تنفيذها عمليًا. وهذا أمر مقبول ومبرر في حدود ما تدعيه الورقة لنفسها، لكن على القراء الذين يأملون في العثور على دليل يثبت فاعلية التصحيح المدرك لسلالم التقييم أن يتعاملوا مع هذه البيانات كمادة خام، لا كإثبات لمفهوم عملي (proof of concept).
لا يقلل أيٌّ مما سبق من قيمة هذا الإنجاز؛ فالحصول على موافقة 415 طالبًا، والتنسيق بين ثمانية من أعضاء هيئة التدريس في أربع مؤسسات، وبناء مجموعة بيانات تربط بين نسخ ممسوحة ضوئيًا غير منمقة وسلالم تقييم ودرجات ممنوحة فعليًا هو عمل لوجستي شاق حقًا. وهو نوع الأساسات الخفية التي لا غنى عنها قبل أن يتمكن أي مطور من بناء نموذج جدير بالثقة لتصحيح امتحان طالب مجهول. فالأبحاث المشوقة ما زالت بانتظار أن تُنجز، وهذه المحاولة تمثل أول خطوة صادقة لتزويدها بمادة واقعية تنطلق منها.