感覚ではなくルーブリックで採点する試験データセット
元論文: Multimodal examination answer data with expert-designed Outcome-Based Education rubrics for criterion-level assessment — Jahangir Alam SM, Md Khalid Syfullah, Saad Ahmed, Munira Akter Mou, A K Z Rasel Rahman, A. K. M. Masudur Rahman, Mohammed Sowket Ali
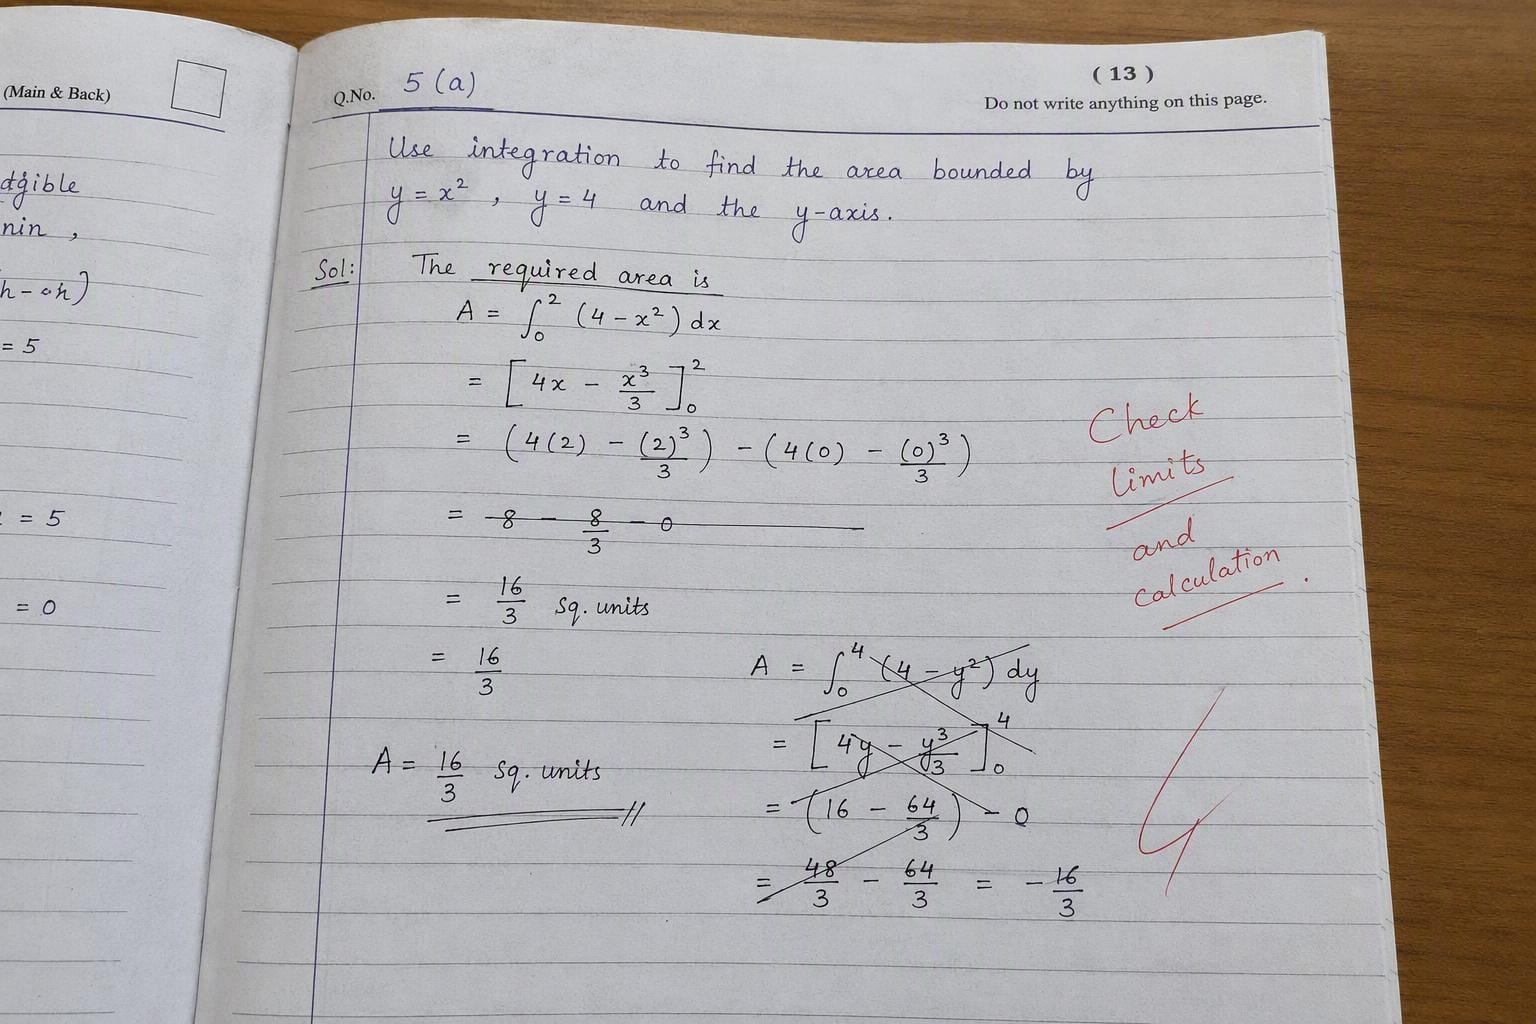
誰かのスマートフォンでスキャンされ、数度傾き、頭上の蛍光灯で半分だけ照らされた物理の試験答案を想像してみてほしい。答案では、間違った数式展開を二重線で消し、余白に修正を詰め込み、それに合わせて歪んだフリーボディダイアグラム(力のつり合い図)が描かれている。さて、この答案用紙をAI採点システムに渡し、極めて具体的な質問を投げかけてみる。「この図は『力の向きを正しく特定しているか』に割り当てられた3点満点のうち、2点に値するだろうか、それとも1点だけだろうか?」
この問いは、手書き文字を読み取ることとはほとんど関係がない。文字の読み取り自体は容易な部分であり、少なくとも過去20年間のOCR研究が得意としてきた領域だ。真に難しいのは、人間が書いた乱雑な答案を、教員が何ヶ月も前に作成したルーブリックへとマッピングし、基準ごとにどれだけの点数を与えるべきかを判断することである。バングラデシュの4つの学術機関に所属する8名の教員によって構築され、8月23日にarXivへ投稿された論文で解説されている新しいデータセットは、まさにこのより困難な課題を真正面から見据えている。この論文自体は、モデルのスコアを一切報告していない。これはデータ記述(data descriptor)論文であり、学術的に言えば「丹念に作り上げた素材の一式を用意したので、ぜひ使ってみてほしい」という趣旨のものだ。しかし、この一式の中身は、そうした言葉から想像される以上に興味深い。
「読むこと」と「採点すること」は全く別の問題である
大半の文書AI(Document AI)ベンチマークは、レシートや請求書、各種フォームなどを対象に学習および評価を行っている。そうした文書は構造化されており、予測しやすい。合計金額は合計金額であり、日付は日付だ。しかし、試験の答案はそのどちらでもない。1枚のページの中に、説明文の段落、化学反応式、擬似コードのスニペット、手書きの図、表が混在し、ときにはそれらすべてがひとつの解答の中に詰め込まれていることもある。そこに学生ごとに大きく異なる手書き文字が加われば、汎用的なOCRパイプラインでは到底想定されていない文書タイプが出来上がる。
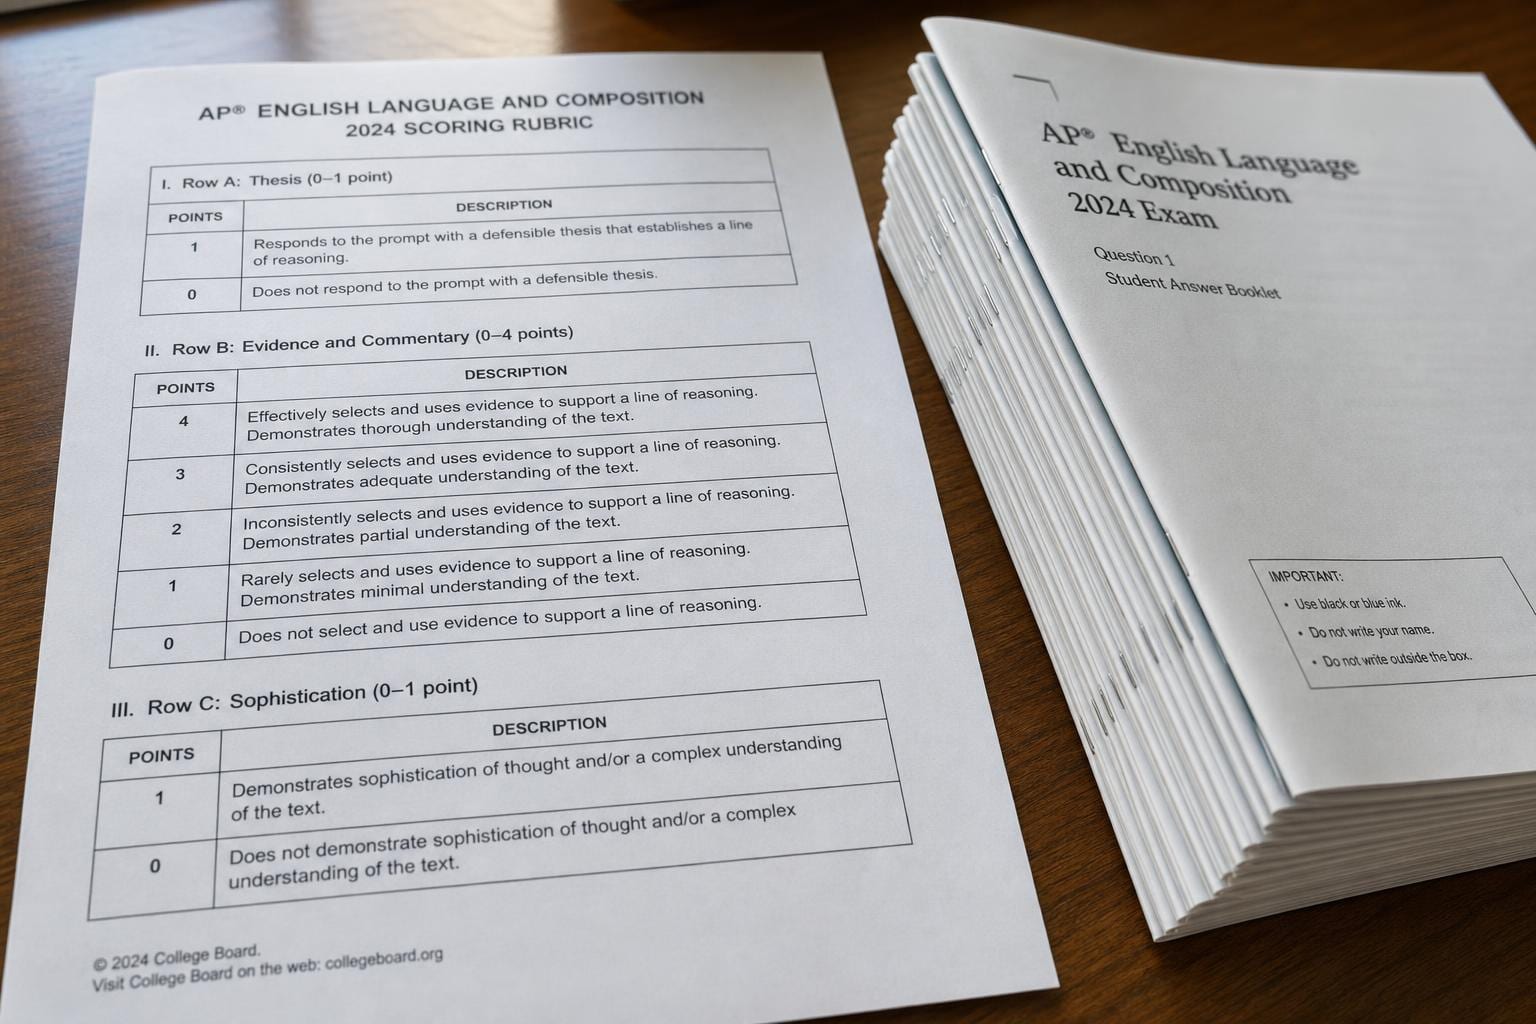
さらに、このデータセット固有の特徴として「アウトカム・ベース教育(Outcome-Based Education: OBE)」の存在がある。これは多くの工学・科学系プログラムが認定基準(アクレディテーション)として採用している採点哲学だ。教員が答案を読んで直感で「8/10」と書き込むのではなく、OBEでは明確なルーブリックが求められる。具体的には、基準のリスト(例えば「正しい公式を記述している」「適切な単位を適用している」「論理的な順序で導出を示している」など)、各基準における優(strong)・可(adequate)・不可(weak)の定義、そして基準ごとの配点上限が定められる。総合得点は、各基準の得点の単純な合計にすぎない。これは監査可能性が高く透明性のある採点方法であり、単なる1つの数値以上の有用なアウトプットを目指す自動採点研究にとって、まさに必要とされていた構造である。
この論文が埋めようとしているのは、まさにそのギャップだ。小論文や短答式記述の自動採点は長年研究されてきたが、そのほとんどはテキストから全体的なスコア(holistic score)を予測するものだった。学生に対して具体的にどの要件を満たせなかったのかを伝えることはできず、実際のルーブリックが紐づいた実際のスキャン手書き答案を扱うことも稀だった。本データセットは、同一の文書上でこの問題の両面を同時に研究者へと提供している。
コレクションに実際に含まれているもの
データセットの規模自体は控えめであり、過度に期待する前にこの数字を冷静に受け止めておく必要がある。収録されているのは、4つの教育機関における同意済みの学生415名から得られた、485件の試験答案提出物だ。対象は9つの科目と12種類の個別の問題テンプレートにわたる。12のルーブリック全体で合計47の評価基準が定義されており、ルーブリック1つあたり平均約4つの基準が含まれている計算になる。
コレクション内の各答案は、単なるPDFではなく、小さなひとまとまりのデータバンドルとして構成されている。スキャンされた答案に加え、著者らは以下の情報を付与している:
- 特定の学生を特定できないようにするためのランダム化された識別子(ID)
- 科目ラベルおよび元の問題文
- 担当教員によって作成された模範解答
- ルーブリック:各評価基準の定義および達成度レベルの記述
- 各基準に対して実際に付与された得点、および総合得点
この最後の項目は、一見する以上に重要だ。多くの「採点」データセットには最終スコアしか含まれていない。しかし本データセットには監査証跡(ペーパートレイル)が存在する。すなわち、どの基準で何点を獲得したかが記録されているため、これで訓練されたモデルは、単に正しい総合得点を予測できたかどうかだけでなく、適切な根拠に基づいてその得点に至ったかどうかまで検証することが可能になる。
スキャンデータそのものは、意図的に洗練されていない、ありのままの状態が保たれている。一部はCamScanner、一部はAdobe Scan、そして一部は従来のフラットベッドスキャナから取り込まれたものであり、著者らは照明、コントラスト、向き、圧縮率、解像度のばらつきを正規化して排除することなく、そのまま残している。また、筆跡の違い、取り消し線、計算の書き直し、余白に押し込まれた修正といった、人間ならではの乱雑さもそのまま維持された。もしこれまで学術向けの「クリーンな」OCRデータセットを扱ったことがあるなら、これは普段目にするものとは真逆であり、より誠実なアプローチだと言える。実際の教室現場で手に入るのは、フラットベッドスキャナで完璧な照明のもと取り込まれた答案用紙ではない。ストレスを抱えた学生が、手元にあるスマートフォンでどうにか撮影した写真なのだ。
データセットの信頼性を担保する地道な作業
このようなデータ記述論文の成否は、一見地味な作業にかかっており、著者らはそこに多大な労力を費やしている。最終コレクションに収録される前に、管理規約の異なる4つの独立した機関からの提出物を統合し、ラベルとテキスト形式を標準化し、ルーブリックの配点上限に照らしてスコアの妥当性を検証した。さらに、ファイル名から提出者が漏洩しないよう、学生識別子とPDFファイル名の両方をランダム化した。また、各答案のメタデータが対応する正しいスキャンファイルを指しているかを確認する「JSON-to-PDF整合性チェック」も実施している。これは、問題14のメタデータが答案9のスキャン画像に気付かぬまま紐づけられているような、モデルの学習を始めて初めて露呈する類のバグを未然に防ぐものだ。
続いて著者らは完成したコレクションの監査を行った。485件の一意な識別子、485件の一意なPDFファイル名、すべての総合得点と基準別得点の合計との一致、そしてすべてのスコアがルーブリックの配点上限内に収まっていることの確認である。これらは読んでいて胸躍るような内容ではないが、研究者が信頼できるデータセットになるか、それともそれを利用したプロジェクトの最初の半年間がデータ入力ミスの洗い出しに消えることになるかの分かれ目となる。総合得点が内訳の合計と一致しなかったり、一意であるはずのIDを2人の学生が共有していたりすれば、実験を1回行う前から、その上で学習させたすべての成果が台無しになってしまう。こうした基本的なデータ健全性(データハイジーン)を確実に担保し、それを明記することは、提出物の数をさらに数百件増やすこと以上に価値がある。
OCRの構築や選定に関わる者にとってなぜ重要なのか
文書AIを開発、あるいは評価している立場からすれば、本論文が示唆する教訓は、「試験を採点するOCR」は「試験を読み取るOCR」とは根本的に異なる製品であるということだ。手書きの数式展開を完璧に書き起こせたとしても、その転記結果をルーブリックの特定の基準と結びつけ、要件をどれだけ満たしているかを判定できなければ、採点システムとしては役に立たない。これは認識(知覚)問題の上に推論と照合の課題が重なったものであり、一般的なOCRベンチマーク(レシート、請求書、帳票、身分証など)ではそもそも評価すら行われていない。なお日本の読者視点では、本データセットが英語の横書き文書を前提としており、多くのOCR/VLMにとって最難関ケースとなる漢字・かなの混在や縦書きレイアウトの処理といった固有の課題は対象外となっている点にも留意が必要だ。
具体的には、ベンダーの評価を行う担当者や、採点・コンプライアンスチェック、あるいは単なるフィールド抽出を超えて明示的な基準に照らして文書を評価する社内パイプラインを構築する開発者にとって、以下の点が実践的な示唆となる:
- 最もクリーンな入力ではなく、現場で実際に遭遇する最も乱雑な入力でテストすること。スキャンアプリ、照明、筆跡のばらつきを意図的に混在させたこのデータセットは、均一な照明下で綺麗に整えられたベンチマークよりも、実世界の文書をはるかによく反映している。
- 単にスコアを出力するだけでなく、システムがその採点理由を説明できるかどうかを問うこと。「境界条件の導出が抜けているため、基準2は3/5点」と返せるルーブリック認識型の評価システムは、単に「72/100点」と出力するシステムよりもはるかに価値がある。
- 構造化メタデータと元文書との間で密かに生じる不整合に警戒すること。これは本論文のJSON-to-PDFチェックが捕捉するために設計された類のバグだ。抽出されたコンテンツを外部レコード(ルーブリック、請求書の明細行、保険請求フォームなど)と紐付けるパイプラインでは、同様の整合性チェックが不可欠だが、大半のチームは実際に問題が発生するまでそうしたチェックを構築しない。
また、本論文で挙げられているユースケースのひとつである「ルーブリックを考慮した自動評価」は、現時点ではまだ大半が期待先行(aspirational)の段階にあることも率直に認識しておく必要がある。本データセットはその研究に着手することを可能にしたものの、手書きの図をルーブリックの基準に照らして高精度に採点できるモデルの成果は、まだ誰も発表していない。それこそが真のフロンティアであり、多くのOCRベンダーが宣伝するマーケティング文句よりも、実際の実現地点はずっと先にある。
このデータセットがまだ教えてくれないこと
データ記述論文が提示するのは可能性の約束であって、実験結果そのものではない。したがって、残された課題について冷静に見極めておくことが重要だ。
明白な課題の筆頭はデータ規模である。12のルーブリックに対する485件の答案という規模は、モデルのファインチューニングや評価には十分であっても、ゼロからモデルを事前学習するには不足している。9科目というのは一見幅広く聞こえるが、問題テンプレートが全体で12種類しかないため、各科目内における出題形式のカバレッジはおそらく薄い。ここで良好な性能を示したモデルも、単に少数のルーブリック形式に過学習(オーバーフィッティング)しているだけという可能性もある。
アクセス性もまた現実的な制約となっている。データは一般公開されておらず、連絡先著者(corresponding author)へ「合理的な要請(upon reasonable request)」を行うことで、研究目的に限って利用可能となる。手書きの個人特定につながりかねない成果物が大量に含まれていることを考慮すれば、学生のプライバシー保護の観点からこれは妥当な判断といえるが、FUNSDやDocVQAのように共有の公開ベンチマークとして機能することは難しくなる。このデータセットを利用する論文ごとにアクセスの条件や時期が微妙に異なることになり、研究室間での結果の再現はより困難になる。
また、データ作成に関わった8名の教員間での評価者間一致度(inter-rater agreement)についての言及がない点も挙げられる。もし同一のルーブリックを用いて、2人の採点者が同じ手書きの数式展開に対して異なる点数を付けていたとすれば、その採点のブレは「正解(ground truth)」スコアの中に不可視のノイズとして埋め込まれてしまう。論文では総合得点と各基準得点の合計との一致が報告されており、これは内部一貫性のチェックとしては極めて重要だが、採点者間で基準別の付与得点そのものが一貫していることを確認したこととは同義ではない。
そして何より、本論文は純粋なデータ紹介記事である。ベースラインモデルの提示もなければ、精度の数値もなく、実際にこのタスクに取り組んだ際にどれほど困難であるかの実感も掴めない。論文の趣旨を考えればそれで何ら問題はないのだが、ルーブリックに基づく自動採点が実用に耐える証拠を期待している読者は、これを概念実証(proof of concept)ではなく、あくまで研究のための未加工な素材(raw material)として捉えるべきである。
だからといって、本データセットの価値が損なわれるわけではない。415名の学生から同意を取り付け、4つの教育機関にまたがる8名の教員を調整し、乱雑な実際のスキャン画像と本物のルーブリック、そして実際に付与された得点を紐づけたデータセットを構築することは、極めて困難なロジスティクス作業である。そしてそれこそが、他人の試験を安心して任せられるモデルを構築する前に、誰かが行わなければならない地道な基礎固めなのだ。真に刺激的な研究はこれから行われなければならない。今回のデータセットは、そうした研究に真に価値ある足がかりを与えるための、誠実な第一歩なのである。