O dataset de provas que avalia por rubricas, e não por "feeling"
Baseado em: Multimodal examination answer data with expert-designed Outcome-Based Education rubrics for criterion-level assessment — Jahangir Alam SM, Md Khalid Syfullah, Saad Ahmed, Munira Akter Mou, A K Z Rasel Rahman, A. K. M. Masudur Rahman, Mohammed Sowket Ali
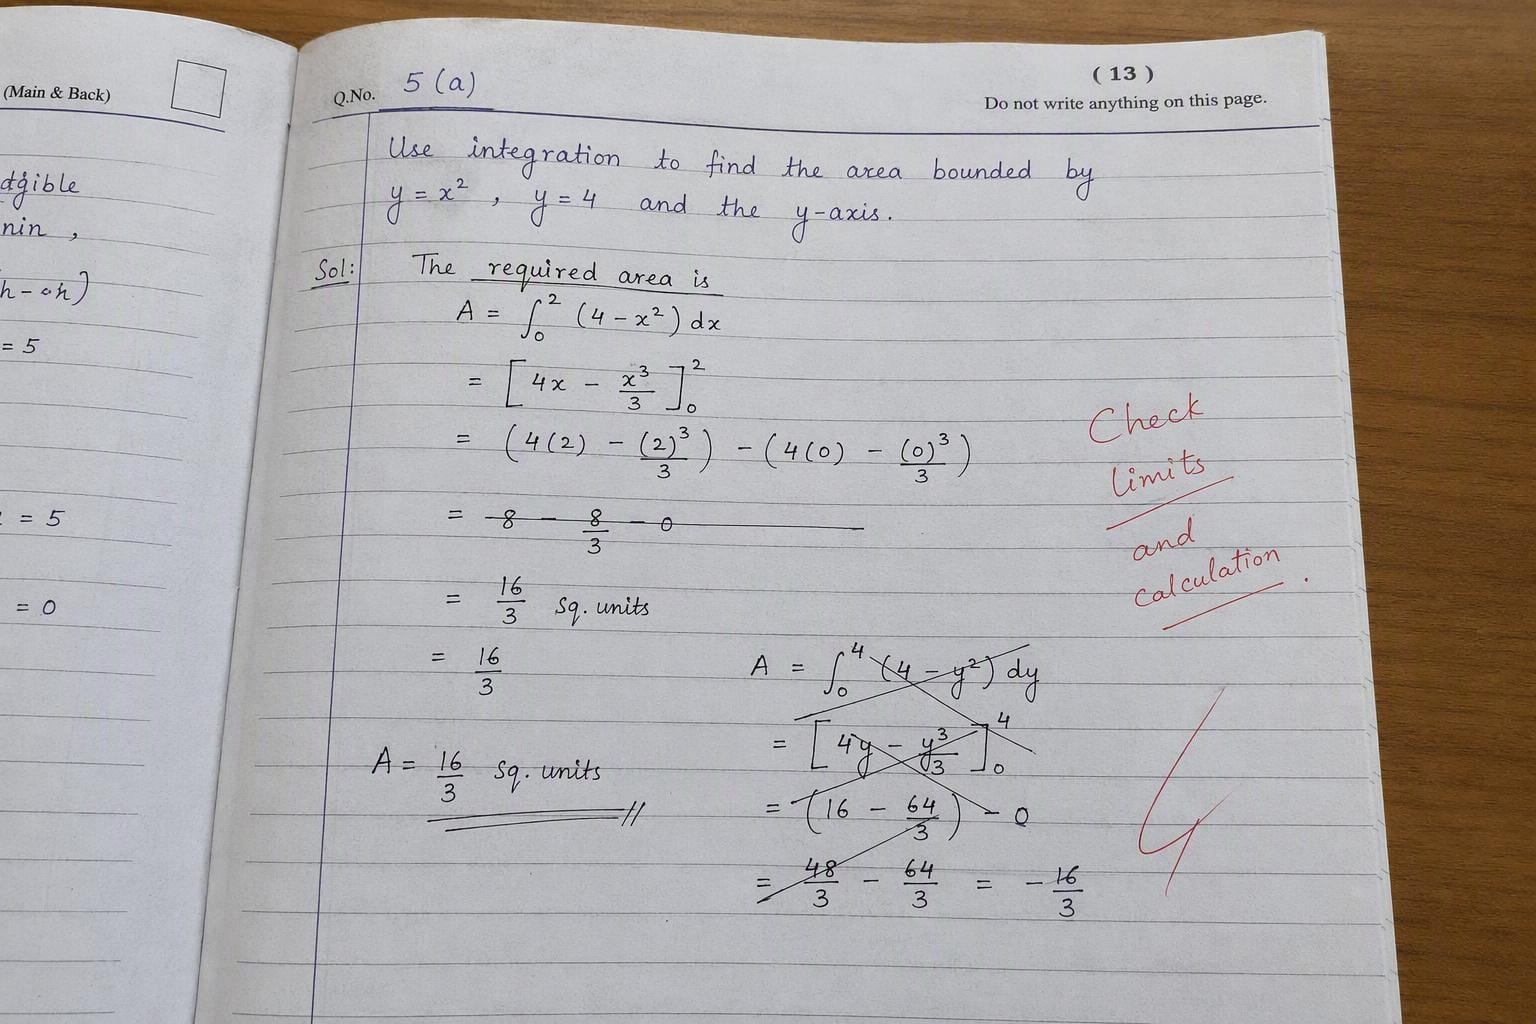
Imagine uma prova de física digitalizada pela câmera do celular, inclinada alguns graus, sob a iluminação precária de uma lâmpada fluorescente. O estudante riscou uma dedução errada, espremeu uma correção na margem e desenhou um diagrama de corpo livre meio torto para acompanhar. Agora entregue essa página para um sistema de avaliação por IA e faça uma pergunta bem específica: o diagrama merece 2 dos 3 pontos atribuídos a "identifica corretamente as direções das forças", ou apenas 1?
Essa pergunta quase não tem relação com a leitura da caligrafia. Ler o texto é a parte fácil — ou pelo menos a parte em que a pesquisa em OCR passou duas décadas se aprimorando. A parte difícil é mapear um trabalho humano desordenado em uma rubrica que algum professor elaborou meses antes e decidir, critério por critério, quanto crédito ele merece. Um novo dataset criado por oito professores de quatro instituições acadêmicas de Bangladesh, descrito em um artigo disponibilizado no arXiv em 23 de agosto, mira exatamente nesse problema mais complexo. Ele não relata a pontuação de nenhum modelo. Trata-se de um data descriptor, o equivalente acadêmico de "aqui está uma caixa de materiais cuidadosamente montada, fiquem à vontade para usar". Mas a caixa é bem mais interessante do que isso faz parecer.
Corrigir provas é um problema diferente de ler
A maioria dos benchmarks de Document AI treina e avalia modelos em itens como recibos, faturas e formulários. Esses documentos são estruturados e previsíveis: um total é um total, uma data é uma data. Respostas de provas não são nada disso. Uma única página pode conter um parágrafo de texto dissertativo, uma equação química, um trecho de pseudocódigo, um diagrama desenhado à mão e uma tabela — às vezes tudo na mesma resposta. Some a isso a caligrafia, que varia drasticamente de um aluno para o outro, e você tem um tipo de documento para o qual os pipelines genéricos de OCR nunca foram projetados.
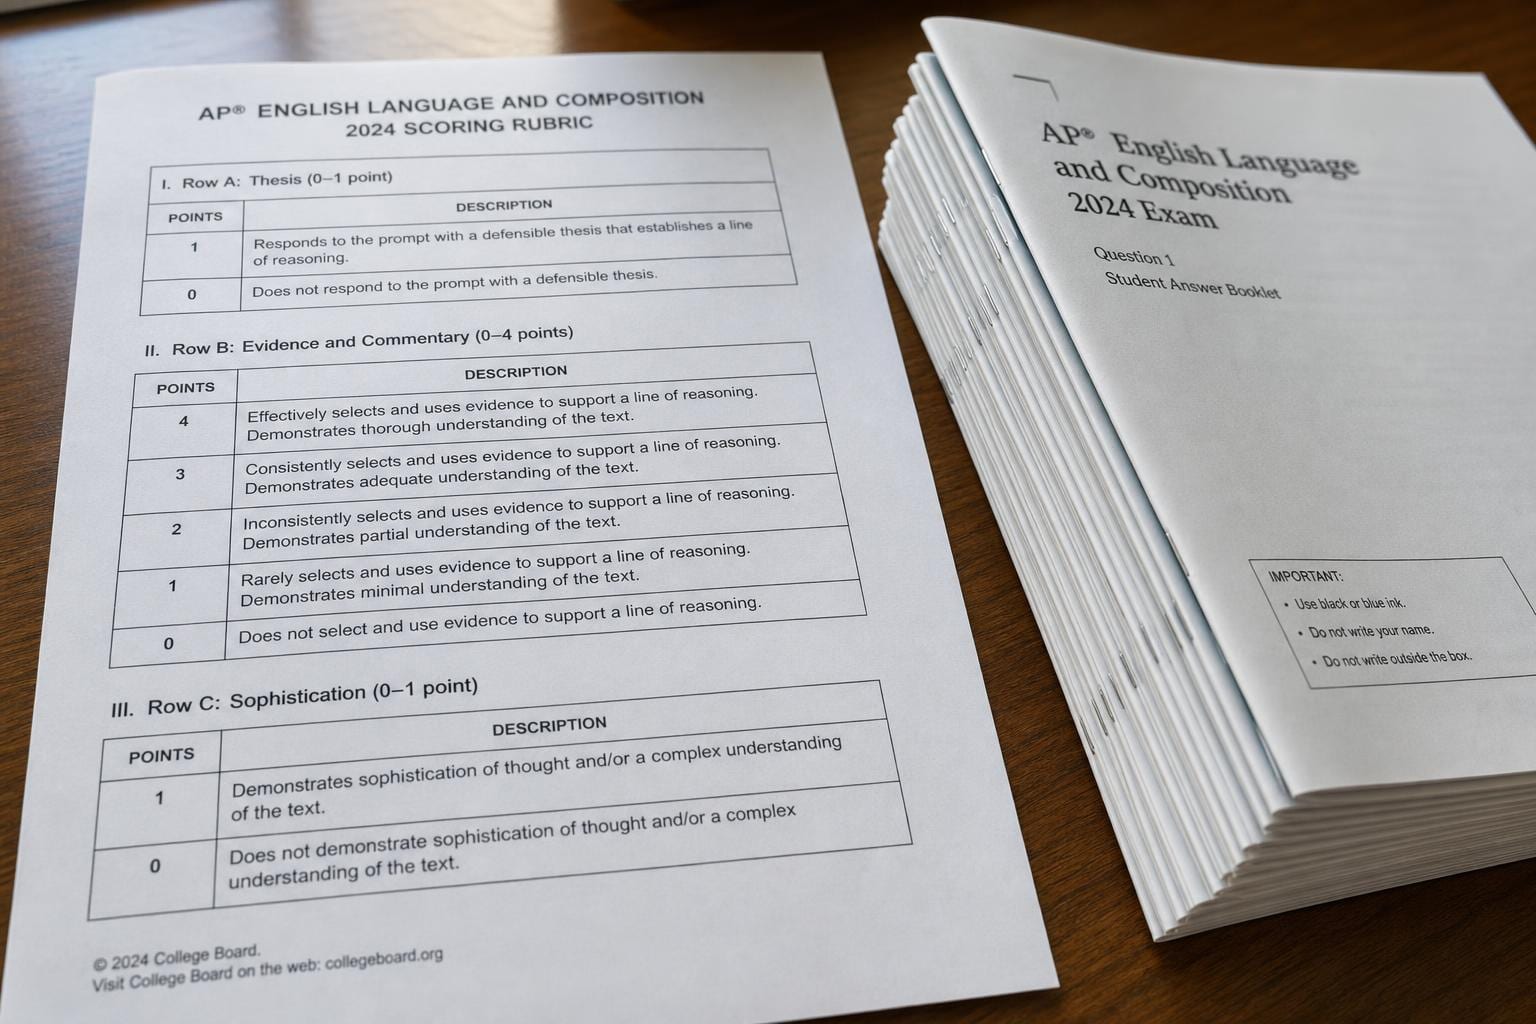
Há também o fator específico deste dataset: a Educação Baseada em Resultados (Outcome-Based Education, ou OBE), uma abordagem pedagógica de avaliação adotada por muitos cursos de engenharia e ciências para fins de acreditação. Em vez de um professor ler a resposta e atribuir "8/10" por intuição, a OBE exige uma rubrica explícita: uma lista de critérios (como "apresenta a fórmula correta", "utiliza as unidades corretas", "demonstra uma dedução estruturada logicamente"), uma descrição do que constitui um desempenho forte, adequado ou fraco em cada um deles, e uma pontuação máxima por critério. A nota final é simplesmente a soma das notas obtidas em cada critério. É uma forma de avaliação mais transparente e auditável — exatamente o tipo de estrutura de que a pesquisa em correção automatizada necessita se quiser produzir algo mais útil do que um único número.
É essa lacuna que o artigo busca preencher. A avaliação automatizada de redações e respostas curtas já existe há anos, mas a maior parte dos métodos estima uma nota holística com base no texto. Eles não apontam ao estudante qual requisito específico ele deixou de cumprir e raramente operam a partir de manuscritos reais digitalizados acompanhados de rubricas autênticas. Este dataset fornece aos pesquisadores as duas metades desse desafio de uma só vez, sobre os mesmos documentos.
O que realmente há na coleção
Os números são modestos, e vale a pena ter isso em mente antes de qualquer entusiasmo excessivo. O dataset reúne 485 submissões individuais de respostas de provas de 415 estudantes que consentiram com a pesquisa, distribuídos por quatro instituições, abrangendo nove disciplinas e 12 modelos distintos de questões. As 12 rubricas definem, no total, 47 critérios — uma média de cerca de quatro critérios por rubrica.
Cada resposta na coleção é um pequeno pacote completo, não apenas um arquivo PDF. Junto à resposta digitalizada, os autores incluíram:
- um identificador aleatorizado, para que o arquivo não possa ser associado a um estudante específico
- a identificação da disciplina e a questão original
- uma resposta-modelo elaborada pelo instrutor
- a rubrica: definições dos critérios e descrições dos níveis de desempenho para cada um
- as notas efetivamente atribuídas em cada critério, além da pontuação total
Esse último item é mais importante do que aparenta. Muitos datasets de "avaliação" trazem somente a pontuação final. Este oferece toda a trilha de auditoria: qual critério recebeu quantos pontos, permitindo avaliar se um modelo treinado nele não apenas previu a nota total correta, mas se chegou a ela pelos motivos certos.
As digitalizações em si são intencionalmente sem retoques. Algumas vieram do CamScanner, outras do Adobe Scan e algumas de scanners de mesa tradicionais; os autores preservaram as variações resultantes de iluminação, contraste, orientação, compressão e resolução, em vez de eliminá-las via normalização. Eles também mantiveram as imperfeições humanas: diferentes caligrafias, trechos rasurados, cálculos corrigidos e anotações espremidas nas margens. Para quem já trabalhou com datasets acadêmicos de OCR perfeitamente "limpos", isso é o oposto do habitual — e representa a escolha mais realista. No dia a dia de uma sala de aula, ninguém recebe provas digitalizadas em scanner de mesa sob iluminação perfeita. Recebe-se o que um aluno sob pressão conseguiu registrar com a câmera do celular disponível.
O trabalho pouco glamoroso de tornar um dataset confiável
Artigos de descrição de dados como este dependem fundamentalmente das etapas mais trabalhosas e minuciosas, e os autores dedicaram um esforço considerável a elas. Antes de qualquer submissão integrar a coleção final, eles consolidaram os dados vindos de quatro instituições distintas com convenções de arquivamento diferentes, padronizaram rótulos e formatação de texto, validaram as notas em relação às pontuações máximas das rubricas e tornaram aleatórios os identificadores dos alunos e os nomes dos PDFs, impedindo que o nome de um arquivo revelasse o autor. Também executaram uma verificação de integridade entre os arquivos JSON e os PDFs para assegurar que os metadados de cada resposta realmente apontassem para o arquivo digitalizado correto — o tipo de inconsistência invisível até o momento em que alguém treina um modelo sobre uma base em que os metadados da questão 14 foram silenciosamente associados à imagem da resposta 9.
Em seguida, realizaram uma auditoria em toda a coleção finalizada: 485 identificadores únicos, 485 nomes de arquivos PDF únicos, correspondência exata entre cada nota total e a soma das notas por critério, além de todas as pontuações dentro dos limites máximos estabelecidos nas rubricas. Nada disso é fascinante de ler, mas é o que separa um dataset em que pesquisadores podem confiar de outro em que os primeiros seis meses de trabalho são consumidos na descoberta de erros de digitação e inconsistência de dados. Se uma nota total não correspondesse à soma das partes, ou se dois alunos compartilhassem o mesmo identificador supostamente único, qualquer modelo treinado nele já estaria comprometido antes mesmo do primeiro experimento. Garantir essa consistência básica e documentá-la de forma explícita tem mais valor do que ter incluído algumas centenas adicionais de submissões.
Por que isso importa para quem desenvolve ou escolhe soluções de OCR
Se você projeta ou avalia soluções de Document AI, a lição central deste artigo é que um "OCR que corrige provas" é um produto substancialmente diferente de um "OCR que lê provas". Um sistema pode transcrever com precisão absoluta uma dedução matemática manuscrita e, ainda assim, ser inútil para correção caso não consiga correlacionar essa transcrição a um critério específico da rubrica e avaliar em que medida ela o atende. Esse é um desafio de raciocínio e correspondência conceitual sobreposto a um problema de percepção visual — e a maior parte dos benchmarks de OCR (recibos, faturas, formulários, documentos de identificação) simplesmente não avalia isso.
Na prática, isso traz algumas diretrizes para quem avalia fornecedores ou constrói pipelines internos de avaliação de provas, análise de conformidade ou qualquer processo que pontue documentos com base em critérios explícitos, em vez de apenas extrair campos:
- Teste com as entradas mais imperfeitas que você encontrará no mundo real, não com as mais limpas. A variedade intencional de aplicativos de captura, iluminação e estilos de escrita deste dataset serve como uma aproximação muito mais fiel de documentos reais do que um benchmark com curadoria perfeita e iluminação uniforme.
- Exija que o sistema consiga justificar uma nota, e não apenas produzi-la. Um avaliador baseado em rubricas capaz de indicar "3/5 no critério 2 porque a dedução ignora a condição de contorno" tem muito mais valor prático do que um que apenas devolve "72/100".
- Previna desalinhamentos silenciosos entre metadados estruturados e os documentos de origem — exatamente a falha que a checagem JSON-para-PDF deste artigo se propôs a evitar. Qualquer pipeline que cruze dados extraídos com registros externos (uma rubrica, um item de nota fiscal, um formulário de sinistro) exige checagens de integridade semelhantes, mas a maioria das equipes só desenvolve essas validações após enfrentar problemas graves.
Também vale admitir honestamente que a "avaliação automatizada orientada a rubricas", um dos casos de uso apontados pelos autores, ainda é uma meta em grande parte aspiracional. Este dataset torna viável pesquisar o tema, mas até agora ninguém publicou resultados demonstrando um modelo capaz de avaliar de forma confiável um diagrama desenhado à mão frente a critérios de uma rubrica. Essa é a fronteira real — e ela se encontra bem mais distante do que muitas promessas de marketing em OCR sugerem.
O que este dataset ainda não nos diz
Um artigo de descrição de dados é uma promessa, não uma validação empírica de resultados, e é prudente analisar suas lacunas com clareza.
O volume é a limitação mais evidente. 485 respostas distribuídas em 12 rubricas são suficientes para fine-tuning ou avaliação de modelos, mas insuficientes para treiná-los do zero. Nove disciplinas soa como um escopo amplo, mas com apenas 12 modelos de questões no total, a diversidade de tipos de perguntas dentro de cada matéria tende a ser restrita. Um modelo com bom desempenho aqui pode simplesmente estar sofrendo overfitting a um conjunto pequeno de formatos de rubricas.
O acesso também impõe uma restrição considerável. Os dados não são abertos publicamente; estão disponíveis apenas "mediante solicitação razoável" ao autor correspondente, para uso estritamente acadêmico. Trata-se de uma decisão justificável pela privacidade dos alunos, especialmente diante da quantidade de registros manuscritos passíveis de identificação, mas significa que o conjunto não poderá se consolidar como um benchmark público de referência da mesma forma que o FUNSD ou o DocVQA. Cada trabalho que utilizá-lo partirá de condições de acesso ligeiramente distintas, o que prejudica a reprodutibilidade entre laboratórios.
Além disso, não há menção à concordância interavaliadores (inter-rater agreement) entre os oito professores envolvidos. Se dois docentes avaliassem a mesma dedução manuscrita de maneiras divergentes usando a mesma rubrica, essa discrepância se tornaria um ruído invisível incorporado às notas de referência (ground truth). O artigo aponta a concordância entre a nota total e a soma dos critérios — um controle de consistência interna relevante —, mas isso não comprova que a pontuação por critério seja consistente entre diferentes corretores.
Por fim, trata-se de uma publicação estritamente descritiva: sem modelos de baseline, sem métricas de acurácia e sem estimativa empírica de quão difícil essa tarefa se revela na prática. Isso é condizente com o escopo proposto pelo trabalho, mas quem busca evidências de que a correção automatizada por rubricas já é funcional deve encarar esse material como insumo para pesquisa, e não como comprovação de conceito.
Nada disso invalida a importância da iniciativa. Reunir o consentimento de 415 alunos, articular oito professores em quatro instituições e estruturar um dataset que vincula digitalizações reais e imperfeitas a rubricas autênticas e notas efetivas constitui um esforço logístico expressivo. É exatamente esse trabalho de base, sem atalhos nem glamour, que precisa existir antes que se possa construir qualquer modelo confiável para corrigir a prova de um estudante. A pesquisa mais promissora ainda está por vir. Esta é apenas a primeira tentativa honesta de fornecer a ela um ponto de partida consistente.