按评分细则打分,而非凭感觉:一份独特的考试数据集
参考论文: Multimodal examination answer data with expert-designed Outcome-Based Education rubrics for criterion-level assessment — Jahangir Alam SM, Md Khalid Syfullah, Saad Ahmed, Munira Akter Mou, A K Z Rasel Rahman, A. K. M. Masudur Rahman, Mohammed Sowket Ali
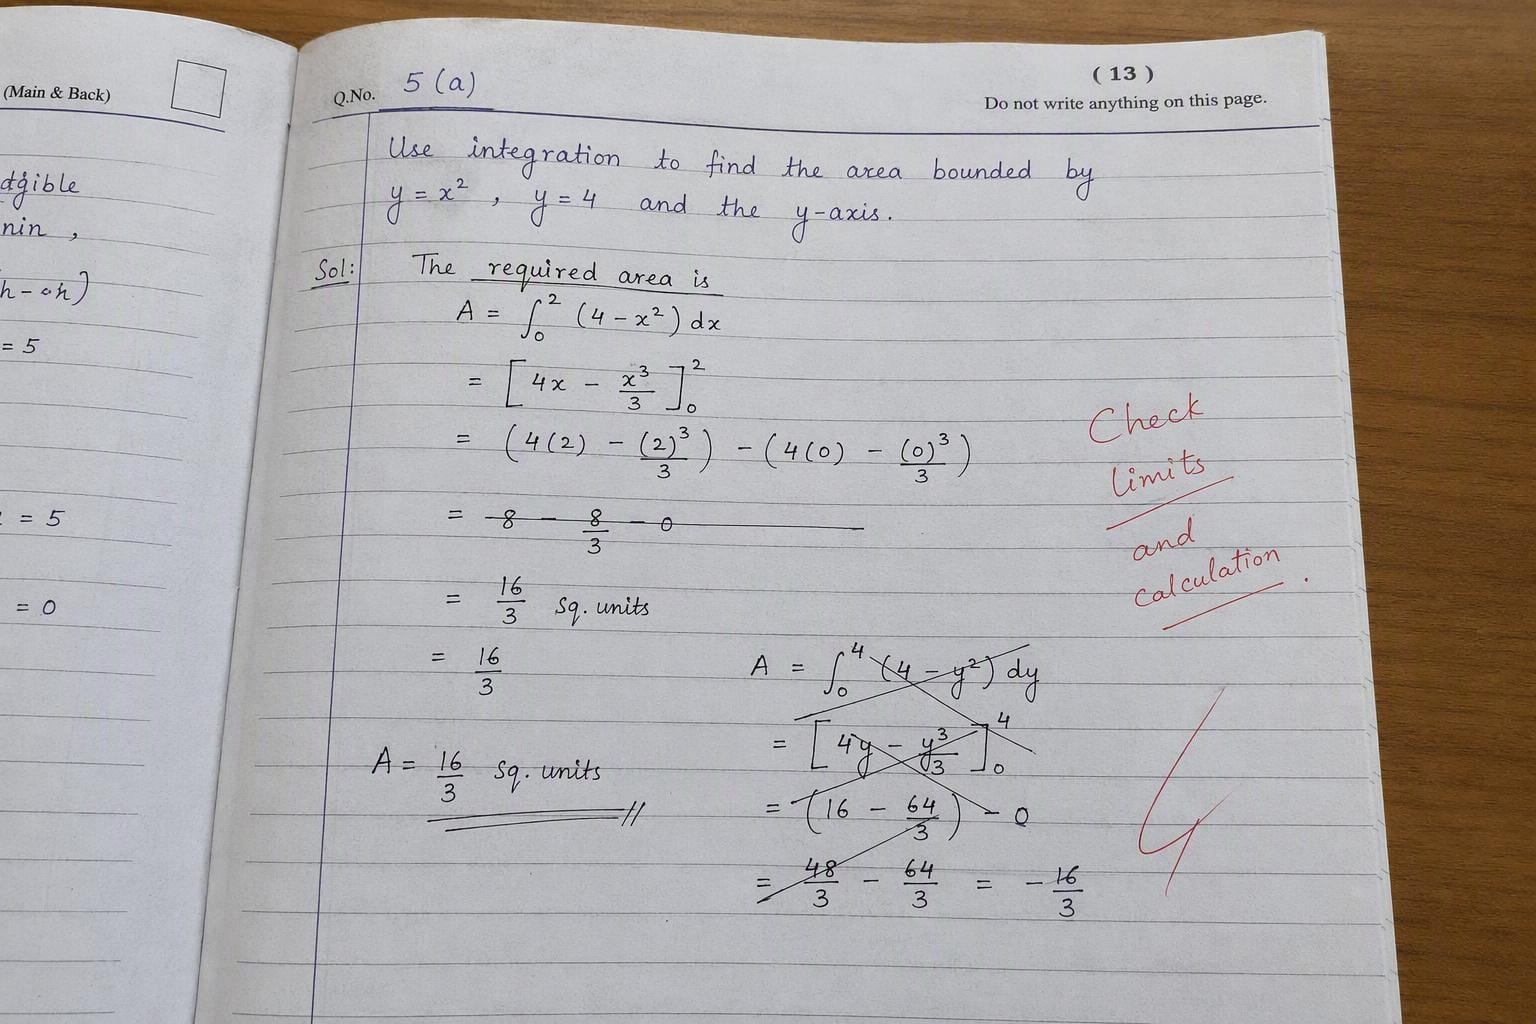
想象这样一份物理试卷:它被用手机拍照扫描,角度倾斜了几度,头顶荧光灯管的光线只照亮了一半。学生划掉了一处错误的推导,在页边狭窄的空白处挤进了一段修改,旁边还随手画了一幅歪歪扭扭的受力分析图。现在,把这一页交给 AI 批改系统,并向它提出一个非常具体的问题:在这道题分配给“正确标出受力方向”的 3 分中,这幅图到底应该得 2 分,还是只得 1 分?
这个问题几乎与识别手写文字无关。认出字迹反而是相对简单的部分——或者至少可以说,是 OCR 研究在过去二十年里已经相当擅长的领域。真正困难的地方,在于将人类凌乱的书写内容与任课教授数月前拟定的评分细则(rubric)对齐,并逐条标准判定它应当得到多少分。来自孟加拉国四所学术机构、由八位教职人员共同构建并于 8 月 23 日发布在 arXiv 上的一篇论文所介绍的全新数据集,正是直面这一更深层次难题的尝试。这篇论文并没有汇报任何模型在特定基准上的测试得分;它是一篇数据描述性论文(data descriptor),在学术语境下就相当于在说:“这是一箱精心整理好的研究素材,拿去用吧。”但这个“箱子”里的东西,远比听上去要耐人寻味得多。
阅卷评分与文字识别是两码事
大多数文档 AI 基准测试的训练和评估都集中在收据、发票和各类表单上。这些文档高度结构化且具备规律性:总金额就是总金额,日期就是日期。但考试答卷却截然不同。仅仅单单一页纸上,就可能同时包含一段文字论述、一个化学方程式、几行伪代码、一幅手绘图表以及一个表格,有时甚至全部混杂在同一道题的作答中。再加上因人而异、风格迥异的手写字迹,便构成了一种通用 OCR 处理管线从未专门针对设计的文档形态。
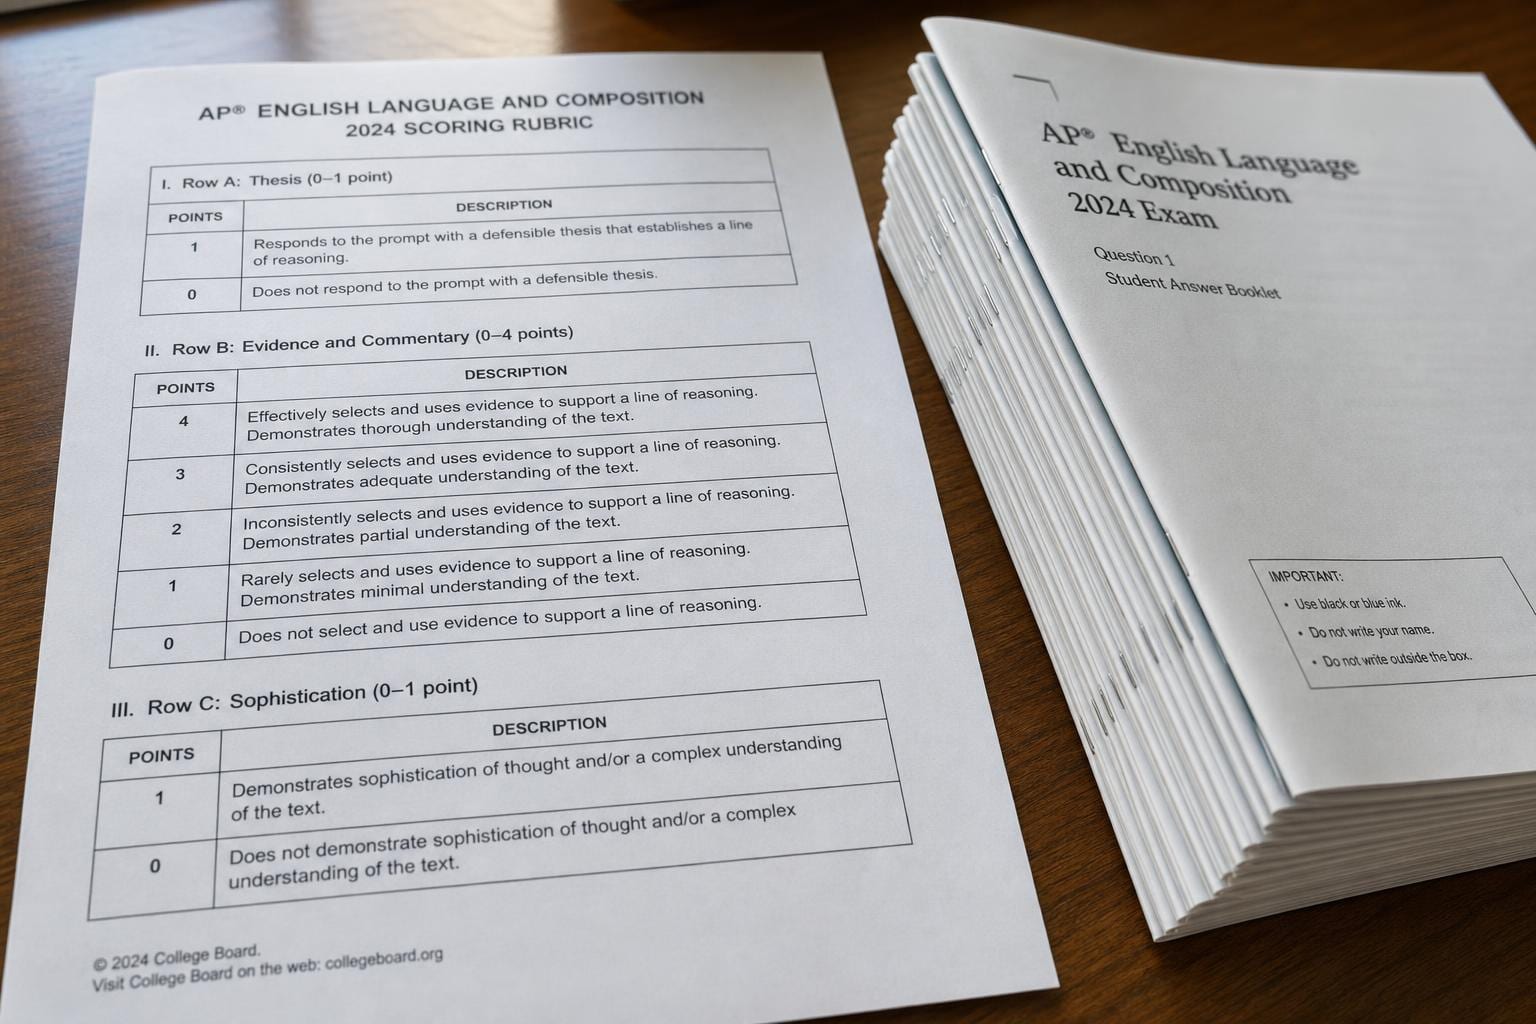
此外,还有该数据集特有的一面:成果导向教育(Outcome-Based Education,简称 OBE)。这是一种许多工科和理科专业在教学评估认证中广泛采用的评分理念。OBE 不允许教授仅凭直觉看完作答后随手写下一个“8/10”,而是要求必须有明确细致的评分细则(rubric):列出一系列评判标准(例如“给出了正确的公式”、“使用了正确的单位”、“展现了逻辑清晰的推导过程”),对各项标准下何为优秀、合格或薄弱给出具体描述,并明确每项标准的最高分值。最终的总分正是这些单项分数的求和。这是一种更具可审计性、更透明的评分机制,而对于自动阅卷研究而言,若想产出比单纯一个最终总分更有价值的评估结果,这恰恰是其亟需的结构化支撑。
而这正是该论文试图填补的空白。自动文章与简答题评分技术已经发展多年,但其中绝大多数仅是直接根据纯文本预测一个整体总分。它既无法告诉学生究竟漏掉了哪一条具体要求,也极少能够在真实扫描的手写试卷上与真正的评分细则相结合。该数据集则在同一批文档上,同时为研究人员提供了解决这一问题的两块拼图。
数据集里究竟包含什么
首先需要正视的是,该数据集的规模并不大,在感到兴奋之前有必要明确这一点。它收录了来自四所学术机构、415 名签署知情同意书的学生所提交的 485 份独立考试答卷,涵盖 9 门科目以及 12 个不同的试题模板。这 12 套评分细则总共定义了 47 项评分标准,平均每套细则大约包含 4 项标准。
数据集中的每一份答卷都是一个完整的数据包,而不仅仅是一份单独的 PDF。除了答卷的扫描件之外,作者还附带了:
- 随机生成的唯一标识符,确保文件无法反向追溯到具体某位学生
- 科目标签以及原始题目
- 由任课教师撰写的标准答案
- 评分细则:各项评判标准的定义及其不同表现等级的描述
- 各项评分标准的实际赋分,以及最终总分
最后这一项的重要性可能远超表面所见。许多所谓的“阅卷评分”数据集往往只记录了最终总分。而该数据集则保留了完整的评分轨迹:哪一项标准拿到了几分清清楚楚。这样一来,基于它训练的模型不仅能检验总分预测是否准确,还能验证模型得出该总分的评判理由是否站得住脚。
扫描图像本身的质量并没有刻意追求精美。有些图像来自扫描全能王(CamScanner),有些来自 Adobe Scan,还有一些来自传统的平板扫描仪;作者完整保留了由此产生的光照、对比度、旋转角度、压缩率以及分辨率的各种差异,而不是简单地做标准化消除。他们同样保留了人类书写中的真实混乱:各式各样的笔迹风格、被划掉的草稿推导、涂改的计算过程、以及挤在页边空白处的补正。如果你之前接触过那些“干净”的学术 OCR 数据集,这里的景象与它们大相径庭,但也更为真实坦率。现实中的教学场景从不会递给你一份用平板扫描仪精心扫描、光线完美的答卷;交到你手上的,往往是一个焦虑的学生用手头随便哪部手机随手拍出来的模样。
让数据集值得信赖的繁琐幕后工作
像这类数据论文,其价值往往取决于那些最枯燥乏味的细节,而作者在这些方面确实倾注了大量心血。在将数据收录进最终集合之前,他们整合了来自四所归档规范各异的高校的提交记录,统一了标签和文本格式,根据评分细则的最大分值核验了各项得分,并对学生标识符和 PDF 文件名进行了随机化处理,以防文件名泄露提交者身份。他们还执行了 JSON 到 PDF 的一致性校验,确保每份答案的元数据精准指向对应的扫描文件——若非如此,往往直到有人用它训练模型时,才会惊觉第 14 题的元数据早就在暗中被错配给了第 9 题答卷的扫描件,这种隐蔽的 bug 危害极大。
随后,他们对最终数据集进行了全面审计:确保包含 485 个唯一标识符、485 个独立的 PDF 文件名、每一项总分与各单项标准得分之和完全吻合,且每一项得分均在细则规定的最高分值范围之内。这些内容读起来或许并不令人兴奋,但它正是一个“值得研究人员信赖的数据集”与“让项目前六个月都耗费在排查录入错误上的数据集”之间的根本区别。如果总分与其分项之和对不上,或者两位学生碰巧共用了同一个本应唯一的标识符,那么任何实验尚未展开,基于该数据集构建的成果就已失去了立足之本。把这些底层的数据治理工作做扎实并明确写出来,其价值远胜于多收录几百份答卷。
为什么这对构建或选型 OCR 系统的人至关重要
如果你正在研发或评估文档 AI,这篇论文带来的启示在于:“能够批改试卷的 OCR”与“仅仅识别试卷的 OCR”在产品本质上不可同日而语。一套系统即便能够完美转录手写的公式推导,但如果无法将转录内容与评分细则中的特定标准相对应并裁定其符合程度,在阅卷场景中依然无济于事。这是在感知问题之上叠加了推理与匹配问题,而大多数现有的 OCR 基准测试(收据、发票、表单、证件等)根本没有覆盖此类维度的考察。同时需要指出的是,该论文目前仅聚焦于英文与拉丁字符,而对于包含数千常用字、字形结构与版面排版更为密集的汉字表意文字系统而言,手写识别与评分细则的对齐难度无疑还会进一步放大。
具体而言,对于正在评估供应商方案或自建内部管线以实现批改评分、合规审查或任何需要对照明确标准打分(而非仅提取字段)的任务,这意味着以下几点考量:
- 在实际能遇到的最混乱输入上进行测试,而不是最干净的样本。该数据集刻意混合了不同的扫描 App、光照条件和手写风格,相比那些精心挑选、光照均匀的基准数据集,能更好地代表真实世界的文档。
- 考察系统是否能给出评分依据,而不仅仅是吐出一个分数。一个具备细则感知能力、能够反馈“由于推导中遗漏了边界条件,因此在准则 2 上得 3/5 分”的评估系统,远比单纯返回“72/100”的系统有价值得多。
- 警惕结构化元数据与底层文档之间悄然发生的错位,这正是论文中 JSON 到 PDF 一致性检查旨在拦截的漏洞。任何将提取内容与外部记录(如评分细则、发票行项目、理赔单据)进行关联的管线,都需要此类完整性校验,而大多数团队往往要等到问题爆发后才想起去构建。
同时我们也要坦承,论文中设想的核心应用场景之一——“感知评分细则的自动化阅卷评估”,目前在很大程度上仍停留在愿景阶段。该数据集让针对这一目标的研究成为可能,但目前尚无公开发表的成果能够证明有模型可以依据评分标准稳定可靠地对一幅手绘图表进行判分。这才是真正的技术前沿,而且它比市面上许多 OCR 营销宣传所暗示的距离要遥远得多。
这份数据集尚无法解答的问题
一篇数据描述论文本质上是一份承诺,而非最终成果;因此,对其局限性保持清醒的认识至关重要。
最显而易见的短板是数据规模。涵盖 12 套评分细则的 485 份答卷足以用来微调或评测模型,但远不足以从零开始训练一个模型。9 门学科听起来覆盖面挺广,但总共只有 12 个试题模板,这意味着每个学科内部对题型风格的覆盖可能相当单薄。在这个数据集上表现出色的模型,很可能只是对为数不多的几种细则结构产生了过拟合。
获取门槛同样是一个实质性的限制。该数据并未完全公开发布,而是仅供学术研究使用,需向通讯作者提出“合理申请”后方可获取。出于保护学生隐私的考量——特别是考虑到其中涉及大量手写且具有个人身份辨识度的作业内容——这一决定完全情有可原;但这也意味着它无法像 FUNSD 或 DocVQA 那样成为一个公开共享的通用基准。未来每一篇使用该数据集的论文都可能基于略微不同的获取途径,不同实验室之间复现成果的难度也随之上升。
此外,论文并未提及参与评阅的八位教师之间的评分者信度(inter-rater agreement)。如果两位教师针对同一个评分细则,对同一段手写推导给出了不同的分数,这种分歧就会化为不可见的噪声,固化在作为“真实标签”(ground truth)的分数中。论文确实报告了总分与各单项标准得分之和的一致性,这是一项重要的内部一致性检查,但它并不等同于验证了不同阅卷人之间在单项标准赋分上的一致性。
最后,这纯粹是一篇数据文章:没有基线模型,没有准确率指标,也没有展现当有人真正着手尝试时这项任务究竟有多困难。就该论文自身的定位而言这无可厚非,但若是读者希望从中寻找“基于细则的自动阅卷切实可行”的实证依据,则应当将其视为待加工的原材料,而非概念验证。
然而,上述任何一点都无损于其核心价值。获得 415 名学生的知情同意、协调四所高校的八位教师、并构建一个将真实的潦草扫描件与真实的评分细则及实际赋分紧密绑定的数据集,本身就是一项极具挑战的繁重工程。在任何人能够构建出足以令人信赖、能批改陌生人试卷的模型之前,这类不显山露水的铺垫工作必不可少。真正引人入胜的研究尚未揭幕,但这迈出了脚踏实地的第一步,为后续探索提供了真正有分量的基石。