वह एग्ज़ाम डेटासेट जो सिर्फ अंदाज़े पर नहीं, बल्कि रुब्रिक्स के आधार पर ग्रेड करता है
आधारित शोध-पत्र: Multimodal examination answer data with expert-designed Outcome-Based Education rubrics for criterion-level assessment — Jahangir Alam SM, Md Khalid Syfullah, Saad Ahmed, Munira Akter Mou, A K Z Rasel Rahman, A. K. M. Masudur Rahman, Mohammed Sowket Ali
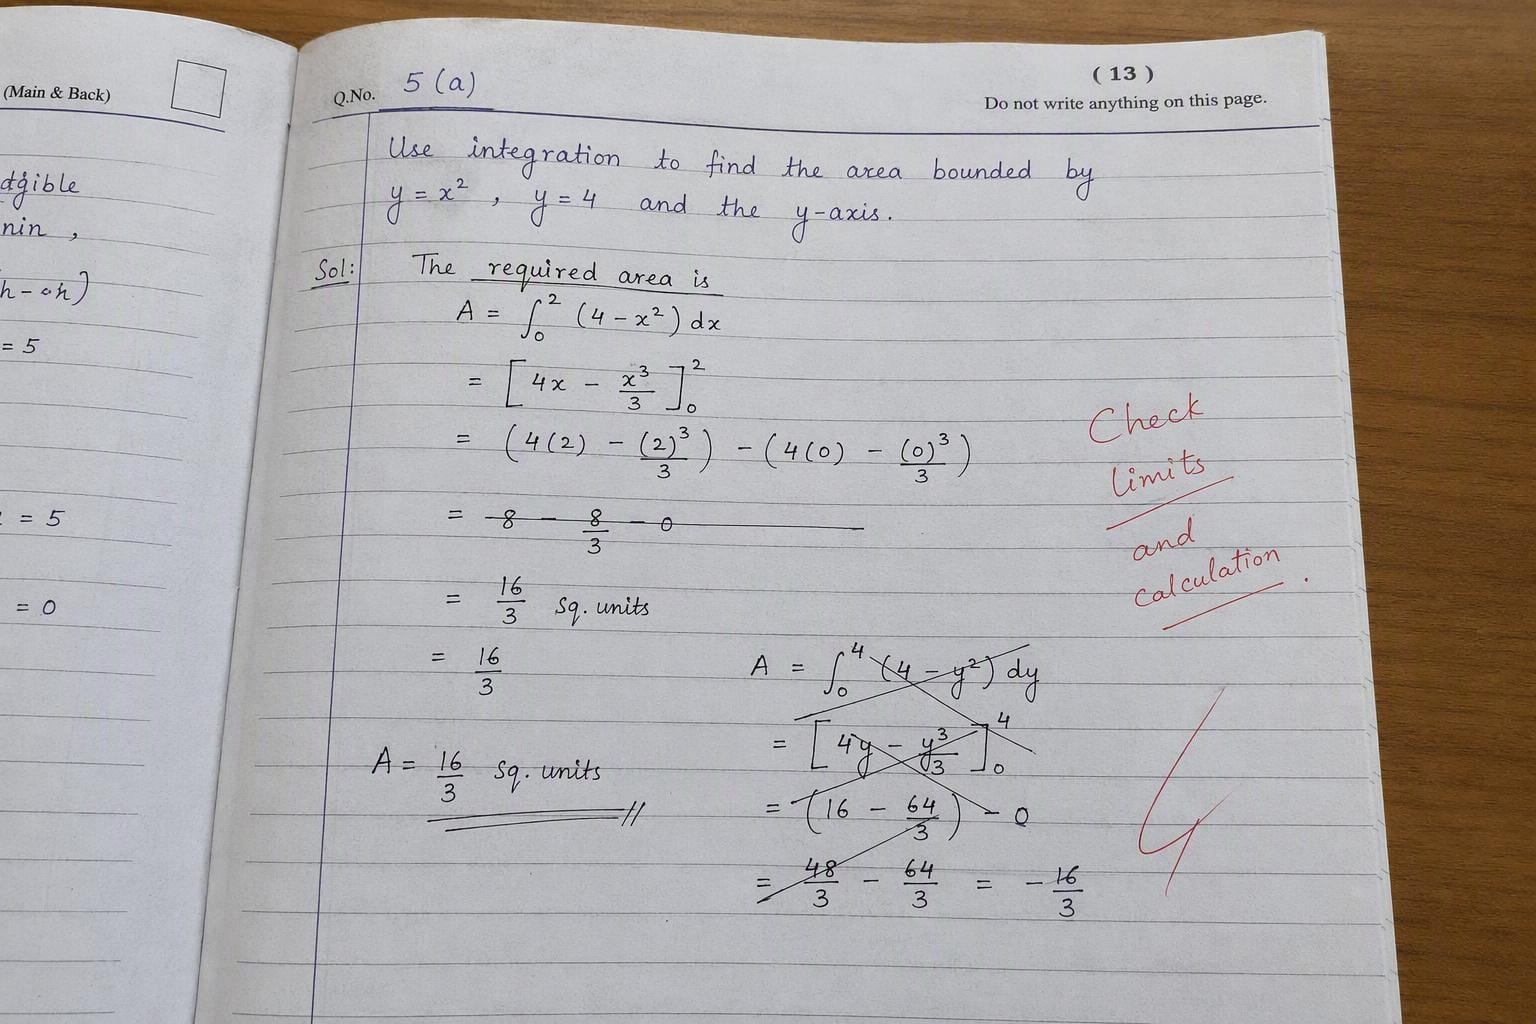
कल्पना कीजिए फ़िज़िक्स का एक एग्ज़ाम पेपर, जो किसी के फ़ोन से स्कैन किया गया है, कुछ डिग्री झुका हुआ है, और ऊपर जलती फ़्लोरोसेंट ट्यूब की मद्धिम रोशनी में आधा ही ठीक से दिख रहा है। छात्र ने एक गलत डेरिवेशन (derivation) को काट दिया है, मार्जिन में किसी तरह सुधार लिखा है, और साथ में एक टेढ़ा-मेढ़ा फ्री-बॉडी डायग्राम (free-body diagram) बनाया है। अब वह पेज किसी AI ग्रेडर को दीजिए और उससे एक बेहद सटीक सवाल पूछिए: क्या यह डायग्राम "correctly identifies force directions" के लिए निर्धारित 3 अंकों में से 2 अंक पाने का हकदार है, या सिर्फ 1?
इस सवाल का हैंडराइटिंग पढ़ने से लगभग कोई लेना-देना नहीं है। उसे पढ़ना तो आसान काम है, या कम से कम वह हिस्सा है जिसमें महारत हासिल करने के लिए OCR रिसर्च ने दो दशक बिताए हैं। असली मुश्किल काम है इंसान के बिखरे हुए, अव्यवस्थित काम को महीनों पहले किसी प्रोफेसर द्वारा लिखे गए रुब्रिक के साथ मैप करना, और क्राइटेरियन-दर-क्राइटेरियन यह तय करना कि वह कितने अंकों का हकदार है। बांग्लादेश के चार अकादमिक संस्थानों के आठ फैकल्टी सदस्यों द्वारा तैयार किया गया और 23 अगस्त को arXiv पर पोस्ट किए गए एक पेपर में वर्णित नया डेटासेट, सीधे तौर पर इसी कठिन समस्या पर केंद्रित है। यह किसी मॉडल के स्कोर की रिपोर्ट नहीं करता। यह एक डेटा डिस्क्रिप्टर (data descriptor) है, जिसका अकादमिक मतलब है: "यहाँ हमने बेहद सावधानी से तैयार किया हुआ डेटा रखा है, जाइए और इसका इस्तेमाल कीजिए।" लेकिन यह डेटा जितना सुनने में लगता है, उससे कहीं अधिक दिलचस्प है।
पढ़ना और ग्रेडिंग करना: दो बिल्कुल अलग समस्याएँ
ज्यादातर डॉक्यूमेंट AI बेंचमार्क रसीदों (receipts), इनवॉइस और फॉर्म जैसी चीज़ों पर ट्रेन और टेस्ट किए जाते हैं। वे दस्तावेज़ संरचित (structured) और पूर्वानुमेय (predictable) होते हैं: कुल राशि हमेशा कुल राशि होती है, तारीख हमेशा तारीख होती है। परीक्षा के उत्तर इनमें से कुछ भी नहीं होते। एक ही पेज पर गद्य का एक पैराग्राफ, एक रासायनिक समीकरण (chemical equation), स्यूडोकोड (pseudocode) का एक टुकड़ा, हाथ से बना डायग्राम और एक टेबल हो सकती है—कभी-कभी यह सब एक ही उत्तर में मौजूद होता है। इसमें हर छात्र की अलग-अलग और बेतरतीब हैंडराइटिंग भी जोड़ दीजिए, तो आपको एक ऐसा डॉक्यूमेंट टाइप मिलता है जिसके लिए जेनेरिक OCR पाइपलाइनों को कभी डिज़ाइन ही नहीं किया गया था।
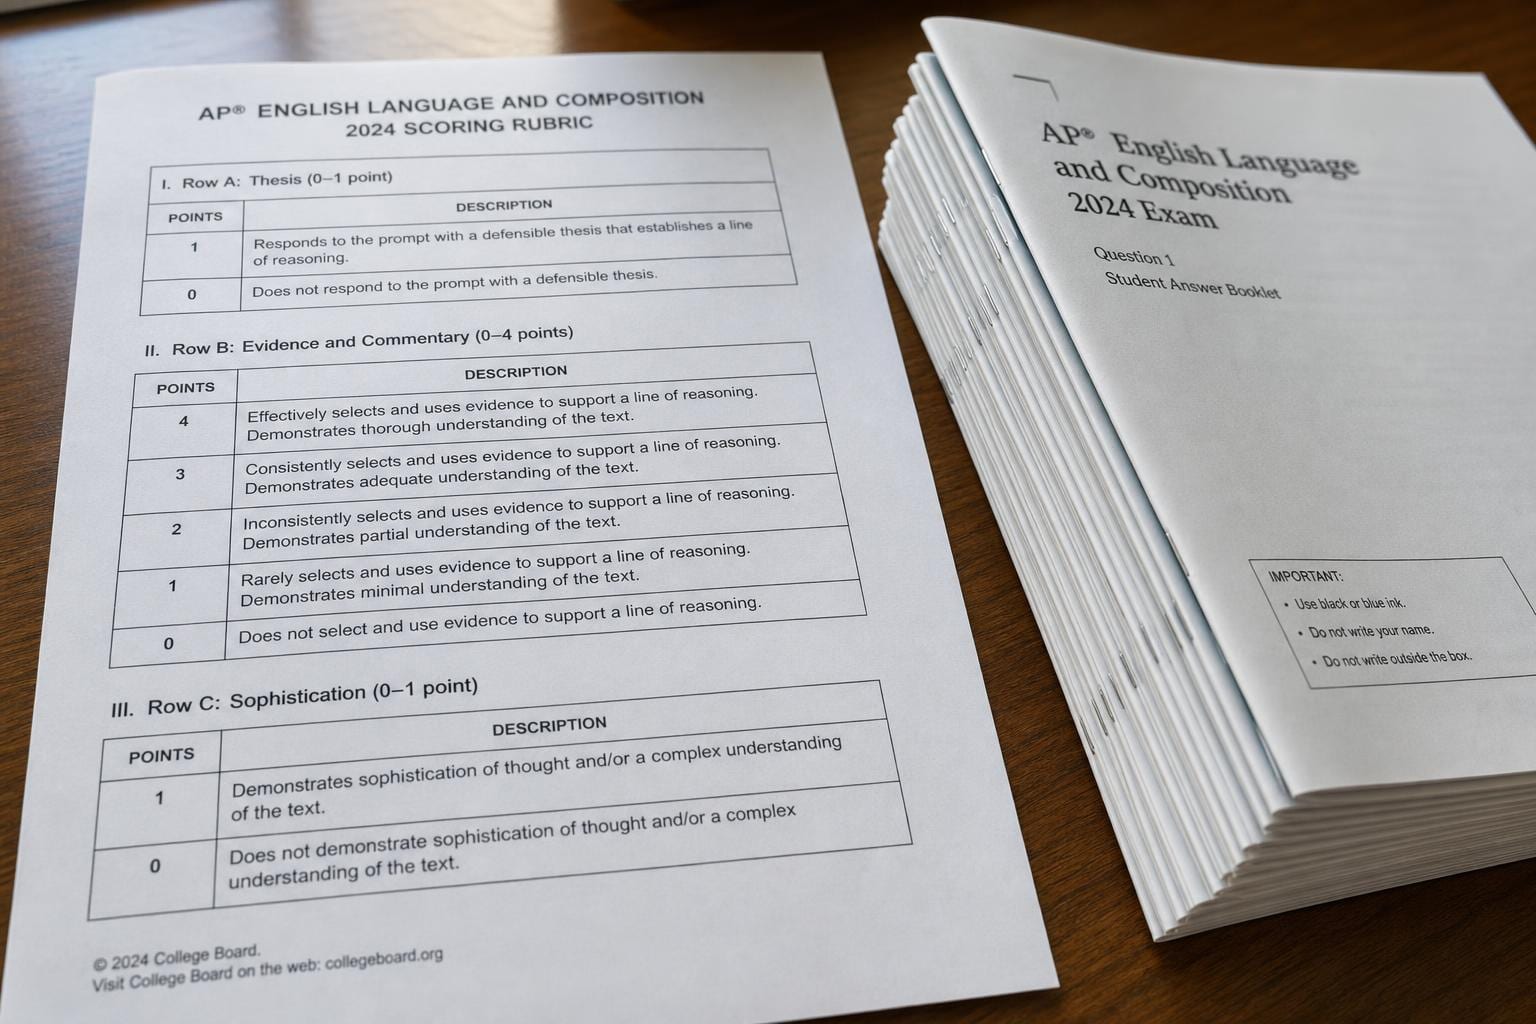
फिर एक पहलू ऐसा है जो विशेष रूप से इस डेटासेट से जुड़ा है: आउटकम-बेस्ड एजुकेशन (Outcome-Based Education) या OBE, जो एक ग्रेडिंग फिलॉसफी है जिसे कई इंजीनियरिंग और साइंस प्रोग्राम एक्रीडिटेशन (मान्यता) के लिए इस्तेमाल करते हैं। इसमें कोई प्रोफेसर सिर्फ अपने अंदाज़े या सहज ज्ञान (gut feel) के आधार पर उत्तर पढ़कर "8/10" नहीं लिखता, बल्कि OBE के तहत एक स्पष्ट रुब्रिक (explicit rubric) की ज़रूरत होती है: मानदंडों की एक सूची (जैसे कि "states the correct formula," "applies correct units," "shows a logically ordered derivation"), हर मानदंड पर मजबूत, पर्याप्त या कमजोर प्रदर्शन का विवरण, और प्रति क्राइटेरियन अधिकतम अंक। कुल स्कोर बस इन अलग-अलग क्राइटेरियन स्कोर्स का योग होता है। यह ग्रेडिंग का कहीं अधिक ऑडिट-योग्य (auditable) और पारदर्शी तरीका है, और ऑटोमेटेड ग्रेडिंग रिसर्च को अगर सिर्फ एक अकेले नंबर के बजाय कुछ उपयोगी परिणाम देना है, तो उसे ठीक इसी तरह के स्ट्रक्चर की ज़रूरत है।
यह पेपर इसी अंतर को पाटने की कोशिश करता है। ऑटोमेटेड एसे (essay) और शॉर्ट-आंसर स्कोरिंग सालों से मौजूद है, लेकिन उनमें से ज्यादातर सिर्फ टेक्स्ट के आधार पर एक समग्र (holistic) स्कोर का अनुमान लगाते हैं। वे छात्र को यह नहीं बताते कि उनसे कौन सी विशिष्ट आवश्यकता छूट गई, और वे शायद ही कभी वास्तविक रुब्रिक्स से जुड़ी वास्तविक स्कैंड हैंडराइटिंग पर काम करते हैं। यह डेटासेट रिसर्चर्स को एक ही दस्तावेज़ पर इस समस्या के दोनों पहलुओं को एक साथ सुलझाने का अवसर देता है।
इस कलेक्शन में असल में क्या शामिल है
डेटा के आंकड़े काफी सामान्य (modest) हैं, और बहुत उत्साहित होने से पहले इस बात को समझ लेना ज़रूरी है। इस डेटासेट में चार संस्थानों के 415 सहमत छात्रों के 485 व्यक्तिगत परीक्षा उत्तर सबमिशन शामिल हैं, जो नौ विषयों और 12 अलग-अलग प्रश्न टेम्प्लेट्स को कवर करते हैं। इन 12 रुब्रिक्स में कुल मिलाकर 47 क्राइटेरिया परिभाषित हैं, यानी औसतन प्रति रुब्रिक लगभग चार क्राइटेरिया।
कलेक्शन में प्रत्येक उत्तर केवल एक PDF नहीं है, बल्कि एक छोटा बंडल है। स्कैंड उत्तर के साथ, ऑथर्स ने निम्नलिखित चीजें जोड़ी हैं:
- एक रैंडमाइज़्ड आइडेंटिफायर (randomized identifier), ताकि फ़ाइल को किसी विशिष्ट छात्र से ट्रेस न किया जा सके
- विषय का लेबल और मूल प्रश्न
- इंस्ट्रक्टर द्वारा लिखा गया एक आदर्श उत्तर (model answer)
- रुब्रिक: प्रत्येक के लिए क्राइटेरियन की परिभाषाएं और प्रदर्शन स्तर के विवरण
- प्रति क्राइटेरियन वास्तव में दिए गए अंक, साथ ही कुल अंक
यह आखिरी बिंदु जितना दिखता है, उससे कहीं अधिक मायने रखता है। कई "ग्रेडिंग" डेटासेट्स में केवल अंतिम स्कोर होता है। लेकिन इसमें पूरा पेपर ट्रेल (paper trail) मौजूद है: किस क्राइटेरियन पर कितने अंक मिले, ताकि इस पर ट्रेन किए गए मॉडल की जाँच केवल इस बात पर न की जा सके कि उसने सही कुल स्कोर का अनुमान लगाया या नहीं, बल्कि इस बात पर भी की जा सके कि वह सही कारणों से उस निष्कर्ष तक पहुँचा या नहीं।
ये स्कैन खुद जानबूझकर बहुत सामान्य और अनगढ़ (unglamorous) रखे गए हैं। कुछ CamScanner से लिए गए हैं, कुछ Adobe Scan से, तो कुछ पारंपरिक फ्लैटबेड स्कैनर से। ऑथर्स ने लाइटिंग, कंट्रास्ट, ओरिएंटेशन, कम्प्रेशन और रिज़ॉल्यूशन में आने वाले अंतर को सामान्य (normalize) करने के बजाय वैसा ही रहने दिया है। उन्होंने इंसानी गलतियों और बिखराव को भी जस का तस रखा है: अलग-अलग हैंडराइटिंग शैलियाँ, काटे गए शब्द, दोबारा की गई गणनाएँ, और मार्जिन में ठूंसे गए सुधार। अगर आपने पहले किसी "क्लीन" अकादमिक OCR डेटासेट पर काम किया है, तो यह उससे बिल्कुल उलट है, और यह कहीं अधिक ईमानदार विकल्प है। असली क्लासरूम आपको फ्लैटबेड पर स्कैन की गई, एकदम सही रोशनी वाली उत्तर पुस्तिकाएं नहीं देते। वे वही देते हैं जो किसी तनावग्रस्त छात्र ने अपने उपलब्ध फ़ोन से जैसे-तैसे फ़ोटो खींचकर भेजा हो।
डेटासेट को भरोसेमंद बनाने का अनगढ़ और बारीक काम
इस तरह के डेटा आर्टिकल्स अपनी बारीकियों और उबाऊ लगने वाले हिस्सों पर ही टिकते या फेल होते हैं, और ऑथर्स ने उन पर वास्तविक मेहनत की है। फाइनल कलेक्शन में कुछ भी शामिल करने से पहले, उन्होंने अलग-अलग फ़ाइलिंग परंपराओं वाले चार अलग-अलग संस्थानों से सबमिशन को समेकित (consolidate) किया, लेबल्स और टेक्स्ट फ़ॉर्मेटिंग को मानकीकृत (standardize) किया, रुब्रिक के अधिकतम अंकों के आधार पर स्कोर्स को सत्यापित किया, और छात्र आइडेंटिफायर्स तथा PDF फ़ाइल नामों दोनों को रैंडमाइज़ किया ताकि फ़ाइल नाम से यह लीक न हो कि इसे किसने सबमिट किया था। उन्होंने यह सुनिश्चित करने के लिए एक JSON-to-PDF इंटीग्रिटी चेक भी चलाया कि प्रत्येक उत्तर का मेटाडेटा वास्तव में सही स्कैंड फ़ाइल को इंगित करता है—यह एक ऐसा बग है जो तब तक दिखाई नहीं देता जब तक कोई मॉडल को ऐसे डेटासेट पर ट्रेन न कर दे जहाँ प्रश्न 14 का मेटाडेटा चुपचाप उत्तर 9 के स्कैन से जुड़ा हो।
इसके बाद उन्होंने तैयार कलेक्शन का ऑडिट किया: 485 यूनिक आइडेंटिफायर्स, 485 यूनिक PDF फ़ाइल नाम, प्रत्येक कुल अंक और उसके क्राइटेरियन अंकों के योग के बीच पूर्ण मिलान, और प्रत्येक स्कोर का अपने रुब्रिक के अधिकतम दायरे में होना। इसके बारे में पढ़ना शायद बहुत रोमांचक न लगे, लेकिन यही वह अंतर है जो एक ऐसे डेटासेट में होता है जिस पर कोई रिसर्चर भरोसा कर सके, और एक ऐसे डेटासेट में जिसके उपयोग से किसी प्रोजेक्ट के शुरुआती छह महीने केवल डेटा-एंट्री की गलतियाँ खोजने में ही निकल जाएँ। यदि कुल अंक उसके घटकों के योग से मेल नहीं खाते, या दो छात्रों को एक ही यूनिक आइडेंटिफायर मिल जाता, तो कोई भी प्रयोग शुरू होने से पहले ही उस पर ट्रेन किए गए मॉडल की विश्वसनीयता खत्म हो जाती। इस बुनियादी डेटा हाइजीन (data hygiene) को सही रखना और इसे स्पष्ट रूप से बताना, कुछ सौ अतिरिक्त सबमिशन जोड़ने से कहीं अधिक मूल्यवान है।
OCR बनाने या चुनने वाले किसी भी व्यक्ति के लिए यह क्यों मायने रखता है
यदि आप डॉक्यूमेंट AI बना रहे हैं या उसका मूल्यांकन कर रहे हैं, तो इस पेपर से मिलने वाला सबक यह है कि "परीक्षाओं को ग्रेड करने वाला OCR", "परीक्षाओं को पढ़ने वाले OCR" से बुनियादी तौर पर एक अलग प्रोडक्ट है। कोई सिस्टम हाथ से लिखे किसी डेरिवेशन को पूरी तरह से ट्रांसक्राइब कर सकता है और फिर भी ग्रेडिंग के लिए बेकार साबित हो सकता है, यदि वह उस ट्रांसक्रिप्शन को रुब्रिक के किसी विशिष्ट क्राइटेरियन से जोड़ न सके और यह तय न कर सके कि वह उसे कितनी अच्छी तरह पूरा करता है। यह परसेप्शन (perception) की समस्या के ऊपर रीजनिंग और मैचिंग की एक अतिरिक्त परत है—और ज़्यादातर OCR बेंचमार्क (रसीदें, इनवॉइस, फ़ॉर्म, आईडी दस्तावेज़) इसका परीक्षण ही नहीं करते। साथ ही, दक्षिण एशियाई संदर्भ में यह ध्यान रखना भी अहम है कि अंग्रेज़ी में मजबूत OCR होने का मतलब देवनागरी जैसी जटिल लिपि (शिरोरेखा, मात्राओं और संयुक्ताक्षरों वाली) के लिए भी अच्छा OCR होना नहीं है।
ठोस रूप से, इसका मतलब किसी वेंडर का मूल्यांकन करने या ग्रेडिंग, कंप्लायंस चेकिंग, या किसी ऐसे काम के लिए इन-हाउस पाइपलाइन बनाने वाले किसी भी व्यक्ति के लिए कुछ बातें हैं जो दस्तावेज़ से केवल फ़ील्ड निकालने के बजाय स्पष्ट मानदंडों के आधार पर उसे स्कोर करता है:
- सबसे गंदे और बेतरतीब इनपुट पर टेस्ट करें जिसे आप वास्तव में वास्तविक दुनिया में देखेंगे, न कि सबसे साफ़-सुथरे इनपुट पर। स्कैनिंग ऐप्स, लाइटिंग और हैंडराइटिंग शैलियों का इस डेटासेट का जानबूझकर किया गया मिश्रण किसी सुव्यवस्थित, समान रूप से प्रकाशित बेंचमार्क की तुलना में वास्तविक दुनिया के दस्तावेज़ों का कहीं बेहतर प्रतिनिधित्व करता है।
- पूछें कि क्या कोई सिस्टम सिर्फ स्कोर देने के बजाय उस स्कोर की व्याख्या (explain) भी कर सकता है। एक रुब्रिक-अवेयर इवैल्यूएटर जो यह बताता है कि "क्राइटेरियन 2 पर 3/5 अंक, क्योंकि डेरिवेशन में बाउंड्री कंडीशन छूट गई है," वह उस सिस्टम से कहीं अधिक मूल्यवान है जो सिर्फ "72/100" लौटाता है।
- स्ट्रक्चर्ड मेटाडेटा और अंतर्निहित दस्तावेज़ के बीच मौन मिसअलाइनमेंट (silent misalignment) पर नज़र रखें, यह वही बग है जिसे पकड़ने के लिए इस पेपर में JSON-to-PDF चेक बनाया गया था। कोई भी पाइपलाइन जो निकाले गए कंटेंट को बाहरी रिकॉर्ड्स (एक रुब्रिक, एक इनवॉइस लाइन, एक क्लेम फॉर्म) के साथ जोड़ती है, उसे इसी तरह के इंटीग्रिटी चेक की आवश्यकता होती है, और अधिकांश टीमें तब तक ऐसा नहीं बनातीं जब तक कि कुछ गड़बड़ न हो जाए।
यह बात स्वीकार करना भी ज़रूरी है कि "रुब्रिक-अवेयर ऑटोमेटेड इवैल्यूएशन," जो कि इस पेपर के बताए गए मुख्य उपयोगों में से एक है, अभी भी काफी हद तक एक परिकल्पना ही है। यह डेटासेट इस दिशा में काम करना संभव बनाता है, लेकिन अभी तक किसी ने भी ऐसे नतीजे प्रकाशित नहीं किए हैं जो यह दिखाते हों कि कोई मॉडल किसी रुब्रिक क्राइटेरियन के आधार पर हाथ से बने डायग्राम को पूरी सटीकता और विश्वसनीयता से ग्रेड कर सकता है। असली फ्रंटियर (frontier) यही है, और यह कई OCR मार्केटिंग दावों की तुलना में अभी काफी दूर है।
यह डेटासेट अभी आपको क्या नहीं बता सकता
डेटा डिस्क्रिप्टर पेपर एक वादा होता है, कोई अंतिम परिणाम नहीं, और इसकी कमियों को लेकर स्पष्ट दृष्टिकोण रखना ज़रूरी है।
आकार (size) सबसे स्पष्ट कमी है। 12 रुब्रिक्स में फैले 485 उत्तर किसी मॉडल को फाइन-ट्यून (fine-tune) या इवैल्यूएट करने के लिए पर्याप्त हैं, लेकिन स्क्रैच से किसी मॉडल को ट्रेन करने के लिए काफी नहीं हैं। नौ विषय सुनने में व्यापक लगते हैं, लेकिन कुल केवल 12 प्रश्न टेम्प्लेट्स के साथ, प्रत्येक विषय के भीतर प्रश्नों की शैलियों का कवरेज संभवतः काफी सीमित है। यहाँ अच्छा प्रदर्शन करने वाला मॉडल हो सकता है कि केवल रुब्रिक्स के कुछ सीमित पैटर्न्स पर ओवरफ़िट (overfitting) हो रहा हो।
डेटा तक पहुँच (access) भी एक वास्तविक सीमा है। यह डेटा खुले तौर पर प्रकाशित नहीं है; यह केवल रिसर्च के उपयोग के लिए, संबंधित लेखक से "उचित अनुरोध पर" (upon reasonable request) उपलब्ध है। छात्रों की प्राइवेसी के लिहाज़ से यह एक उचित और बचाव योग्य निर्णय है, खासकर यह देखते हुए कि इसमें हाथ से लिखा हुआ व्यक्तिगत पहचान योग्य कितना काम शामिल है, लेकिन इसका मतलब यह भी है कि यह डेटासेट FUNSD या DocVQA की तरह एक साझा सार्वजनिक बेंचमार्क नहीं बन सकता। इसका उपयोग करने वाला प्रत्येक पेपर पहुँच के थोड़े अलग बिंदु से काम करेगा, और अलग-अलग लैब्स में परिणामों को रीप्रोड्यूस (reproduce) करना अधिक कठिन हो जाएगा।
इसमें आठ फैकल्टी योगदानकर्ताओं के बीच इंटर-रेटर एग्रीमेंट (inter-rater agreement) का भी कोई उल्लेख नहीं है। यदि दो शिक्षक एक ही रुब्रिक पर एक ही हस्तलिखित डेरिवेशन को अलग-अलग अंक देते, तो वह असहमति "ग्राउंड ट्रुथ" (ground truth) अंकों में एक अदृश्य नॉइज़ (noise) के रूप में शामिल हो जाती है। यह पेपर कुल अंकों और क्राइटेरियन के योग के बीच सामंजस्य की रिपोर्ट करता है, जो कि एक महत्वपूर्ण इंटरनल-कंसिस्टेंसी चेक है, लेकिन यह इस बात की पुष्टि करने जैसा नहीं है कि अलग-अलग ग्रेडर्स के बीच क्राइटेरियन अंक अपने आप में सुसंगत हैं।
और यह पूरी तरह से एक डेटा आर्टिकल है: इसमें कोई बेसलाइन मॉडल नहीं है, कोई एक्यूरेसी के आंकड़े नहीं हैं, और जब कोई वास्तव में इसे आज़माएगा तो यह काम कितना कठिन साबित होगा, इसका कोई अंदाज़ा नहीं है। पेपर के दावों के संदर्भ में यह ठीक भी है, लेकिन जो पाठक यह सबूत तलाश रहे हैं कि रुब्रिक-अवेयर ग्रेडिंग प्रभावी रूप से काम करती है, उन्हें इसे एक रॉ मटीरियल (raw material) के रूप में देखना चाहिए, न कि प्रूफ-ऑफ-कॉन्सेप्ट (proof of concept) के रूप में।
इनमें से कोई भी बात इसके महत्व को कम नहीं करती। 415 छात्रों से सहमति लेना, चार संस्थानों के आठ फैकल्टी सदस्यों के बीच समन्वय करना, और एक ऐसा डेटासेट तैयार करना जो वास्तविक बिखरे हुए स्कैन्स को वास्तविक रुब्रिक्स और वास्तव में दिए गए अंकों से जोड़ता हो, वास्तव में एक बेहद कठिन लॉजिस्टिकल काम है। किसी अनजान छात्र की परीक्षा को ग्रेड करने के लिए एक विश्वसनीय मॉडल बनाने से पहले इस प्रकार का बुनियादी काम होना बेहद ज़रूरी है। दिलचस्प रिसर्च तो अभी होनी बाकी है। यह तो बस उस दिशा में आगे बढ़ने के लिए एक वास्तविक आधार प्रदान करने का पहला ईमानदार प्रयास है।