El dataset de exámenes que califica con rúbricas, no por intuición
Basado en: Multimodal examination answer data with expert-designed Outcome-Based Education rubrics for criterion-level assessment — Jahangir Alam SM, Md Khalid Syfullah, Saad Ahmed, Munira Akter Mou, A K Z Rasel Rahman, A. K. M. Masudur Rahman, Mohammed Sowket Ali
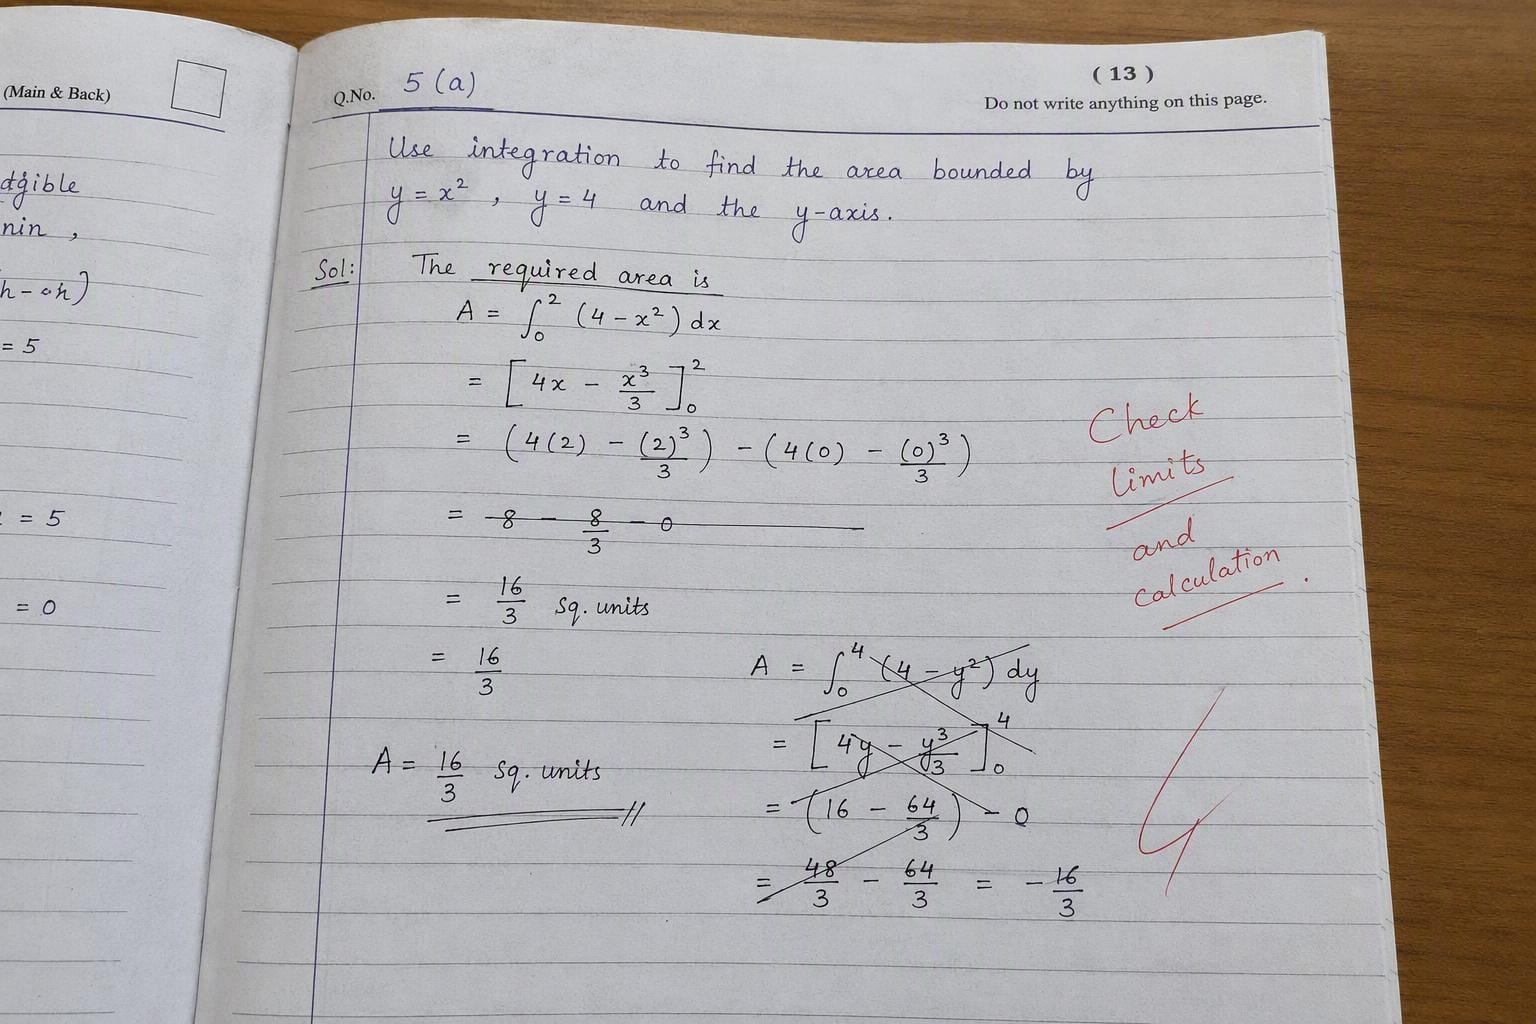
Imagina un examen de física escaneado con el teléfono, inclinado unos cuantos grados y apenas iluminado por un tubo fluorescente en el techo. El estudiante tachó una deducción errónea, apretó una corrección en el margen y dibujó un diagrama de cuerpo libre algo torcido para acompañarla. Ahora, dale esa página a un calificador basado en IA y hazle una pregunta muy concreta: ¿obtiene el diagrama 2 de los 3 puntos asignados a «identifica correctamente las direcciones de las fuerzas», o solo 1?
Esa pregunta casi no tiene nada que ver con leer la caligrafía. Leerla es la parte fácil, o al menos la parte en la que la investigación en OCR lleva dos décadas perfeccionándose. Lo difícil es mapear el trabajo humano desordenado sobre una rúbrica que algún profesor redactó meses atrás y decidir, criterio por criterio, cuánto puntaje merece. Un nuevo dataset procedente de cuatro instituciones académicas de Bangladés, elaborado por ocho docentes y descrito en un artículo publicado en arXiv el 23 de agosto, apunta directamente a ese problema más difícil. No reporta la puntuación de ningún modelo. Es un descriptor de datos (data descriptor), el equivalente académico de «aquí hay una caja de material cuidadosamente preparada, ve a usarla». Pero la caja es más interesante de lo que parece.
Calificar es un problema diferente a leer
La mayoría de los benchmarks de Document AI se entrenan y evalúan con elementos como recibos, facturas y formularios. Esos documentos son estructurados y predecibles: un total es un total, una fecha es una fecha. Las respuestas de examen no son ninguna de las dos cosas. Una sola página puede contener un párrafo de texto, una ecuación química, un fragmento de pseudocódigo, un diagrama dibujado a mano y una tabla; a veces, todo en la misma respuesta. Si a esto se añade la escritura a mano, que varía enormemente de un estudiante a otro, se obtiene un tipo de documento para el que los pipelines genéricos de OCR nunca fueron diseñados.
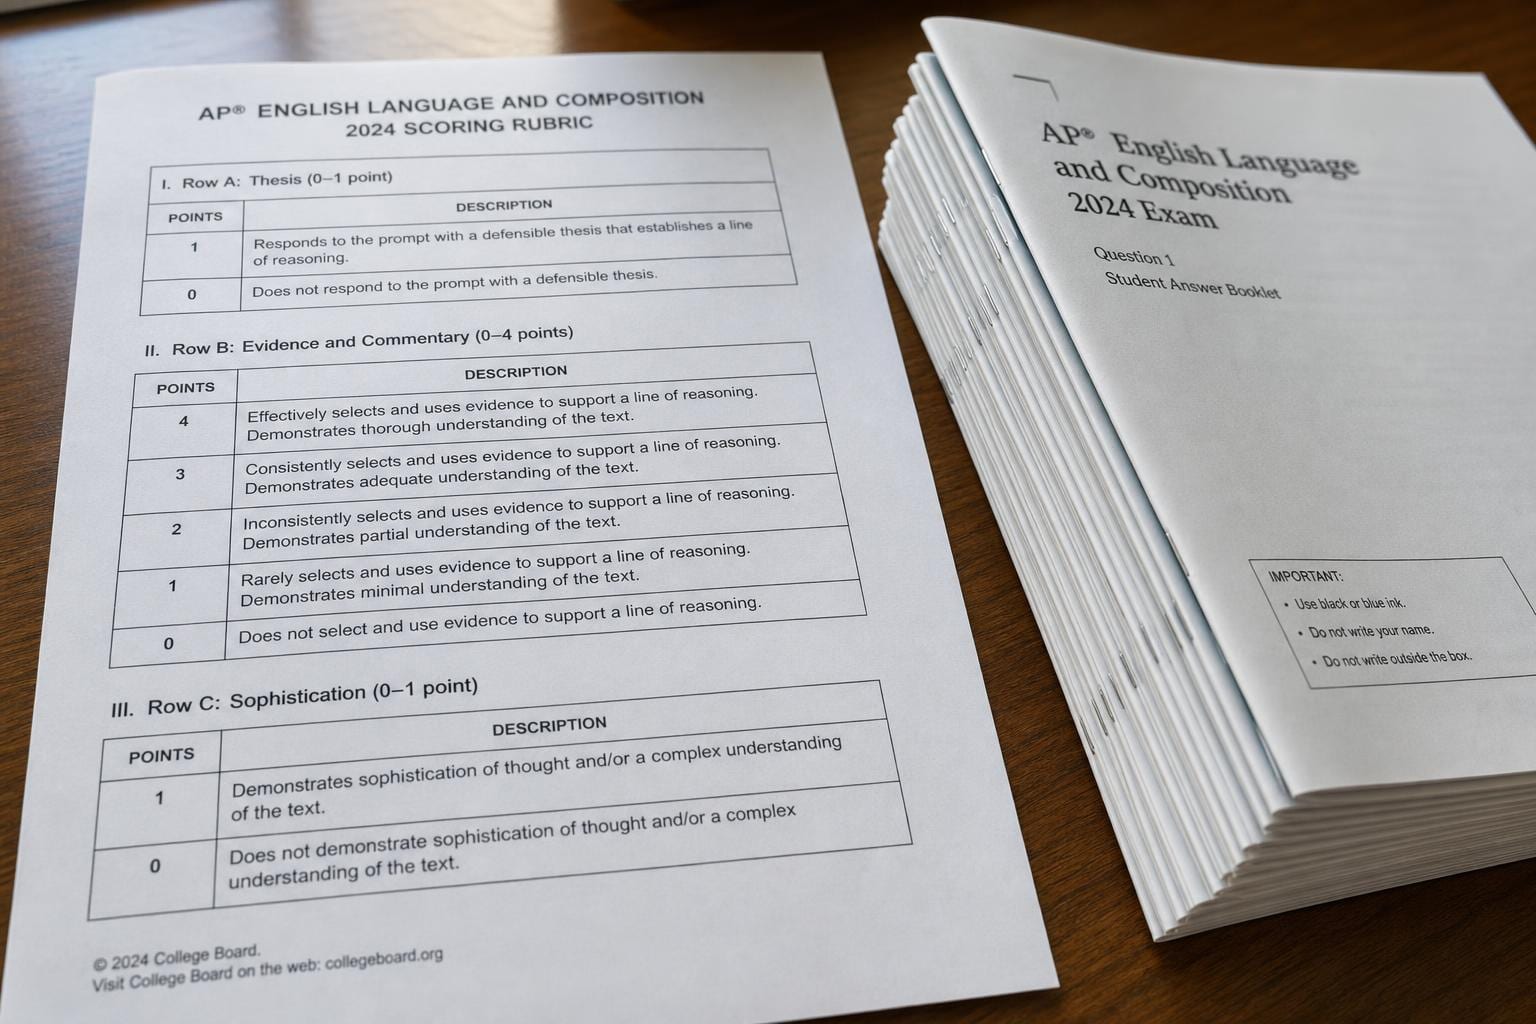
Luego está la parte específica de este dataset: la Educación Basada en Resultados (Outcome-Based Education u OBE), una filosofía de calificación que muchos programas de ingeniería y ciencias utilizan para su acreditación. En lugar de que un profesor lea una respuesta y escriba «8/10» basándose en su intuición, la OBE exige una rúbrica explícita: una lista de criterios (por ejemplo, «enuncia la fórmula correcta», «aplica las unidades correctas», «muestra una deducción lógicamente ordenada»), una descripción de lo que cuenta como un desempeño sólido, adecuado o deficiente en cada uno, y una puntuación máxima por criterio. La puntuación total es simplemente la suma de las puntuaciones de los criterios. Es una forma de calificar más auditable y transparente, y es exactamente el tipo de estructura que la investigación en evaluación automatizada necesita si quiere producir algo más útil que un simple número.
Esa es la brecha que este artículo intenta cerrar. La calificación automatizada de ensayos y respuestas cortas existe desde hace años, pero la mayor parte predice una puntuación holística a partir de texto. No le dice al estudiante qué requisito específico omitió y rara vez trabaja a partir de escritura manuscrita real escaneada con rúbricas reales adjuntas. Este dataset ofrece a los investigadores ambas mitades de ese problema a la vez, sobre los mismos documentos.
Qué contiene realmente la colección
Las cifras son modestas, y conviene asimilarlas antes de entusiasmarse. El dataset contiene 485 entregas individuales de respuestas de examen de 415 estudiantes que dieron su consentimiento en cuatro instituciones, abarcando nueve asignaturas y 12 plantillas de preguntas distintas. Entre las 12 rúbricas definen 47 criterios en total, un promedio de aproximadamente cuatro criterios por rúbrica.
Cada respuesta en la colección es un pequeño paquete, no solo un PDF. Junto a la respuesta escaneada, los autores adjuntaron:
- un identificador aleatorizado, para que el archivo no pueda rastrearse hasta un estudiante específico
- la etiqueta de la asignatura y la pregunta original
- una respuesta modelo redactada por el instructor
- la rúbrica: definiciones de criterios y descripciones de niveles de desempeño para cada uno
- las puntuaciones efectivamente otorgadas por criterio, más el total
Ese último elemento importa más de lo que parece. Muchos datasets de «calificación» solo cuentan con la puntuación final. Este tiene el rastro documental: qué criterio obtuvo cuántos puntos, de modo que un modelo entrenado con él puede verificarse no solo en función de si predijo el total correcto, sino de si llegó a él por las razones correctas.
Los escaneos en sí son deliberadamente poco vistosos. Algunos provinieron de CamScanner, otros de Adobe Scan y otros de escáneres planos convencionales; los autores mantuvieron las variaciones resultantes en iluminación, contraste, orientación, compresión y resolución en lugar de eliminarlas mediante normalización. También conservaron el desorden humano: distintos estilos de caligrafía, tachaduras, cálculos corregidos y anotaciones apretadas en los márgenes. Si antes has trabajado con un dataset académico de OCR «limpio», esto es lo opuesto a lo que sueles encontrar, y es la opción más honesta. Las aulas reales no te entregan una hoja de respuestas escaneada en escáner plano y perfectamente iluminada. Te entregan lo que sea que un estudiante estresado fotografió con el teléfono que tenía a mano.
El trabajo poco glamuroso de hacer que un dataset sea confiable
Los artículos de datos como este dependen por completo de las partes tediosas, y los autores dedicaron un esfuerzo real a ellas. Antes de incorporar nada a la colección final, consolidaron las entregas de cuatro instituciones independientes con diferentes convenciones de archivo, estandarizaron etiquetas y formatos de texto, validaron las puntuaciones frente a los máximos de las rúbricas y aleatorizaron tanto los identificadores de los estudiantes como los nombres de los archivos PDF para que el nombre de un archivo no filtre quién lo entregó. También ejecutaron una verificación de integridad de JSON a PDF para asegurarse de que los metadatos de cada respuesta apunten realmente al archivo escaneado correcto, que es el tipo de error invisible hasta que alguien entrena un modelo en un dataset donde los metadatos de la pregunta 14 están asociados silenciosamente al escaneo de la respuesta 9.
Luego auditaron la colección finalizada: 485 identificadores únicos, 485 nombres de archivos PDF únicos, concordancia entre cada puntuación total y la suma de sus puntuaciones por criterio, y cada nota situada dentro del máximo de su rúbrica. Nada de esto resulta emocionante de leer, pero es la diferencia entre un dataset en el que un investigador puede confiar y uno en el que los primeros seis meses de cualquier proyecto que lo utilice se gastan en descubrir sus propios errores de entrada de datos. Si una puntuación total no coincidiera con la suma de sus partes, o si dos estudiantes compartieran un identificador supuestamente único, eso socavaría cualquier modelo entrenado con él antes de ejecutar un solo experimento. Cuidar esa higiene básica y declararla explícitamente tiene más valor del que habrían tenido otros cientos de entregas adicionales.
Por qué es importante para cualquiera que desarrolle o elija OCR
Si estás desarrollando o evaluando sistemas de Document AI, la lección de este artículo es que un «OCR que califica exámenes» es un producto fundamentalmente distinto a un «OCR que lee exámenes». Un sistema puede transcribir una deducción manuscrita a la perfección y, aun así, ser inútil para la calificación si no puede conectar esa transcripción con un criterio específico de una rúbrica y decidir qué tan bien lo satisface. Se trata de un problema de razonamiento y correspondencia superpuesto a un problema de percepción, y la mayoría de los benchmarks de OCR (recibos, facturas, formularios, documentos de identidad) simplemente no lo evalúan.
En términos concretos, esto implica varias cosas para cualquiera que evalúe a un proveedor o construya un pipeline interno de calificación, verificación de cumplimiento normativo o cualquier tarea que puntúe un documento frente a criterios explícitos en lugar de limitarse a extraer campos de él:
- Haz pruebas con los datos de entrada más desordenados que verás en la práctica, no con los más limpios. La combinación deliberada de aplicaciones de escaneo, iluminación y estilos de caligrafía de este dataset es una mejor aproximación a los documentos del mundo real que un benchmark curado y uniformemente iluminado.
- Pregunta si un sistema puede explicar una puntuación, no solo generarla. Un evaluador consciente de la rúbrica que devuelve «3/5 en el criterio 2 porque la deducción omite la condición de contorno» vale más que uno que simplemente devuelve «72/100».
- Presta atención a las desalineaciones silenciosas entre los metadatos estructurados y el documento subyacente, el tipo de error para el que se diseñó la verificación JSON a PDF de este artículo. Cualquier pipeline que asocie contenido extraído con registros externos (una rúbrica, una línea de factura, un formulario de reclamación) necesita este tipo de control de integridad, y la mayoría de los equipos no lo construye hasta que algo ya ha salido mal.
También vale la pena ser sinceros en cuanto a que la «evaluación automatizada basada en rúbricas», uno de los casos de uso declarados del artículo, sigue siendo en gran medida aspiracional. Este dataset permite empezar a trabajar en ello, pero nadie ha publicado todavía resultados que demuestren un modelo capaz de calificar de forma confiable un diagrama dibujado a mano frente al criterio de una rúbrica. Esa es la frontera real, y se encuentra mucho más lejos de lo que sugiere gran parte del marketing de OCR.
Lo que este dataset todavía no puede decirte
Un artículo de descripción de datos es una promesa, no un resultado, y conviene tener una mirada lúcida sobre las limitaciones.
El tamaño es la más obvia. 485 respuestas a lo largo de 12 rúbricas son suficientes para hacer fine-tuning o evaluar un modelo, pero no para entrenar uno desde cero. Nueve asignaturas suena amplio, pero con solo 12 plantillas de preguntas en total, la cobertura de estilos de preguntas dentro de cada asignatura es probablemente escasa. Un modelo que obtenga buenos resultados aquí podría estar simplemente cayendo en overfitting ante un número reducido de estructuras de rúbricas.
El acceso también representa una limitación real. Los datos no están publicados en abierto; están disponibles «a petición razonable» al autor de correspondencia, únicamente para fines de investigación. Es una decisión justificable para proteger la privacidad de los estudiantes, sobre todo considerando la cantidad de trabajo manuscrito que contiene información potencialmente identificable, pero significa que el dataset no puede convertirse en un benchmark público compartido como lo fueron FUNSD o DocVQA. Cada artículo que lo utilice trabajará a partir de un punto de acceso ligeramente distinto, y reproducir resultados entre diferentes laboratorios se vuelve más difícil.
Tampoco se menciona el acuerdo interevaluador entre los ocho docentes colaboradores. Si dos profesores hubieran calificado la misma deducción manuscrita de manera diferente con la misma rúbrica, esa discrepancia se convierte en ruido invisible integrado en las puntuaciones de referencia (ground truth). El artículo reporta concordancia entre las puntuaciones totales y las sumas de los criterios, lo cual es una comprobación de consistencia interna importante, pero no equivale a confirmar que las puntuaciones por criterio sean consistentes entre distintos evaluadores.
Y este es puramente un artículo de datos: no hay modelo de referencia (baseline), no hay cifras de precisión ni noción de qué tan difícil resulta realmente la tarea una vez que alguien la intenta. Eso es adecuado para lo que el artículo pretende ser, pero los lectores que busquen pruebas de que la calificación basada en rúbricas funciona deben tratar esto como materia prima, no como prueba de concepto.
Nada de eso le resta valor. Conseguir el consentimiento de 415 estudiantes, coordinar a ocho docentes en cuatro instituciones y construir un dataset que vincule escaneos reales y desordenados con rúbricas reales y puntuaciones reales otorgadas es un trabajo logístico genuinamente difícil, y es el tipo de labor básica poco vistosa que debe existir antes de que alguien pueda construir un modelo en el que valga la pena confiar para calificar el examen de un desconocido. La investigación verdaderamente interesante todavía tiene que producirse. Esto es solo el primer intento honesto de ofrecerle algo real con lo que trabajar.