ملفات PDF الخاصة بك تساوي تريليونات من الـ Tokens. ومعظم مسارات عمل OCR تهدرها.
استنادًا إلى: olmOCR: Unlocking Trillions of Tokens in PDFs with Vision Language Models — Jake Poznanski, Aman Rangapur, Jon Borchardt, Jason Dunkelberger, Regan Huff, Daniel Lin, Aman Rangapur, Christopher Wilhelm, Kyle Lo, Luca Soldaini
تكلفة استخراج النصوص من ملفات PDF
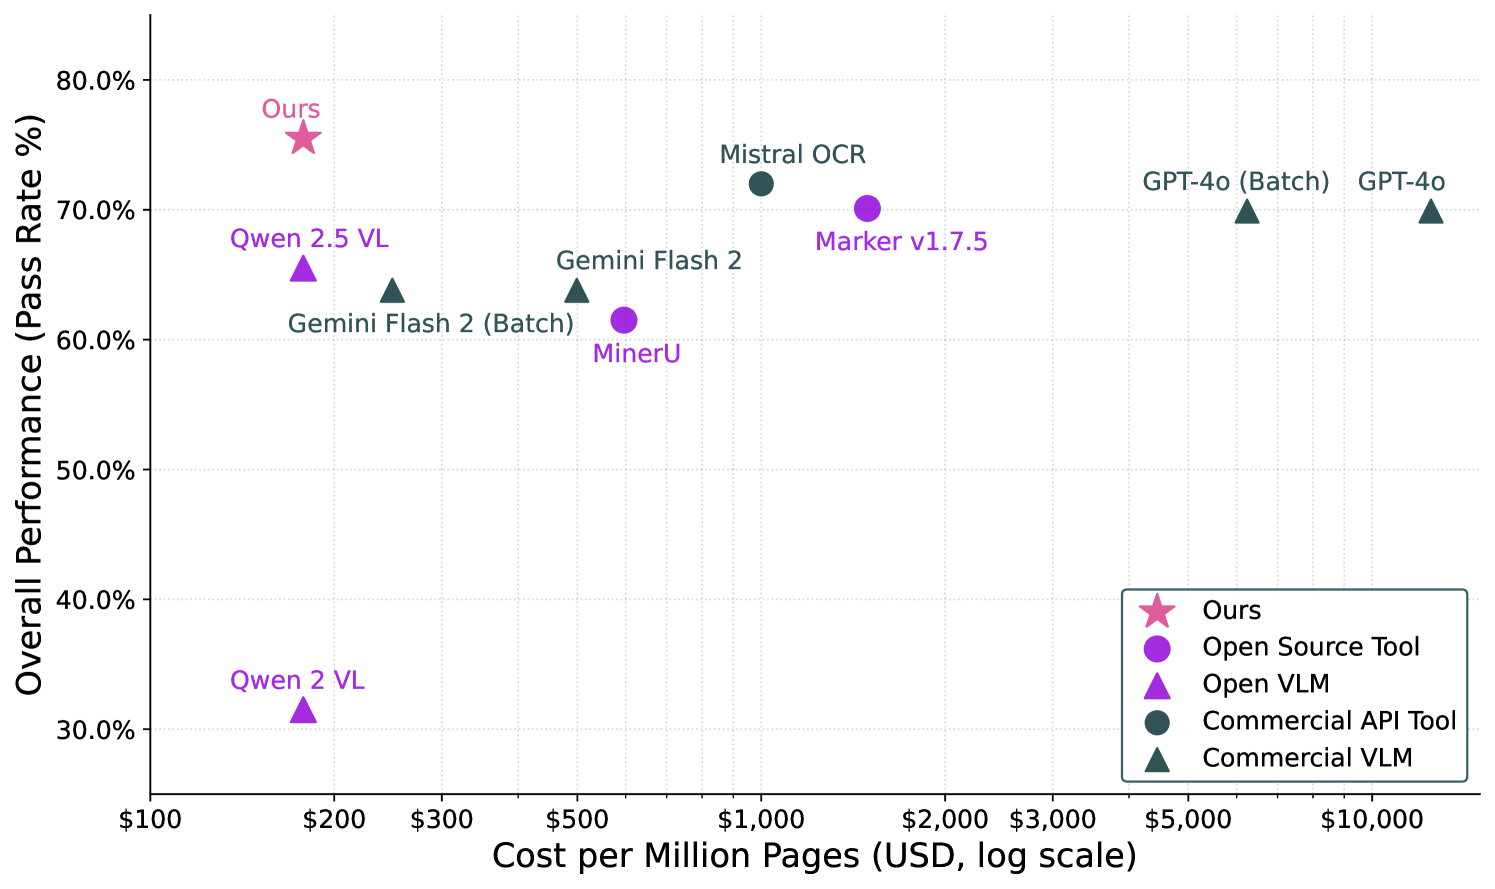
إليك رقم قد يجعلك تتوقف عن التمرير: إن معالجة كل صفحة PDF على الإنترنت باستخدام GPT-4o لاستخراج نصوص نظيفة ستكلف أكثر من 6,240 دولاراً لكل مليون صفحة. وإذا أسقطنا هذا الرقم على مليارات ملفات PDF الموجودة في الأرشيفات الحكومية، والمجلات العلمية، والوثائق القضائية، والكتب القديمة الممسوحة ضوئياً، فستجد نفسك أمام فاتورة تصل إلى عشرات الملايين من الدولارات فقط لجعل هذه النصوص قابلة للاستخدام بواسطة نموذج لغوي أو فهرس بحث.
نظر فريق في معهد Allen Institute for AI (Ai2) إلى هذا الرقم وطرح سؤالاً أكثر إثارة للاهتمام: ماذا لو لم تكن بحاجة إلى GPT-4o على الإطلاق؟ كانت إجابتهم هي olmOCR، وهو نموذج رؤية (vision model) يحتوي على 7 مليار parameter، تم ضبطه بدقة (fine-tuned) خصيصاً لقراءة ملفات PDF، وهو يعالج مليون صفحة مقابل 176 دولاراً فقط. هذا ليس مجرد فارق بسيط عن سعر GPT-4o، بل هو أرخص بنحو 35 مرة، ووفقاً لاختبارات القياس (benchmark) الخاصة بهم، فهو أكثر دقة أيضاً.
إذا كنت تعمل على تطوير أي شيء يتعلق باستخراج البيانات من المستندات، فإن هذه الورقة البحثية تستحق الفهم بالتفصيل، لأنها تحسم بهدوء جدلاً استمر لعدة سنوات: هل تحتاج إلى نموذج ضخم عام الغرض لقراءة ملف PDF بشكل جيد، أم أن نموذجاً أصغر ومتخصصاً يمكنه القيام بذلك بشكل أفضل؟
شكل من ورقة olmOCR: Unlocking Trillions of Tokens in PDFs with Vision Language Models (Poznanski et al., arXiv:2502.18443)، مرخصة بموجب CC BY 4.0.
لماذا تُعد قراءة ملفات PDF مشكلة أصعب مما تبدو عليه
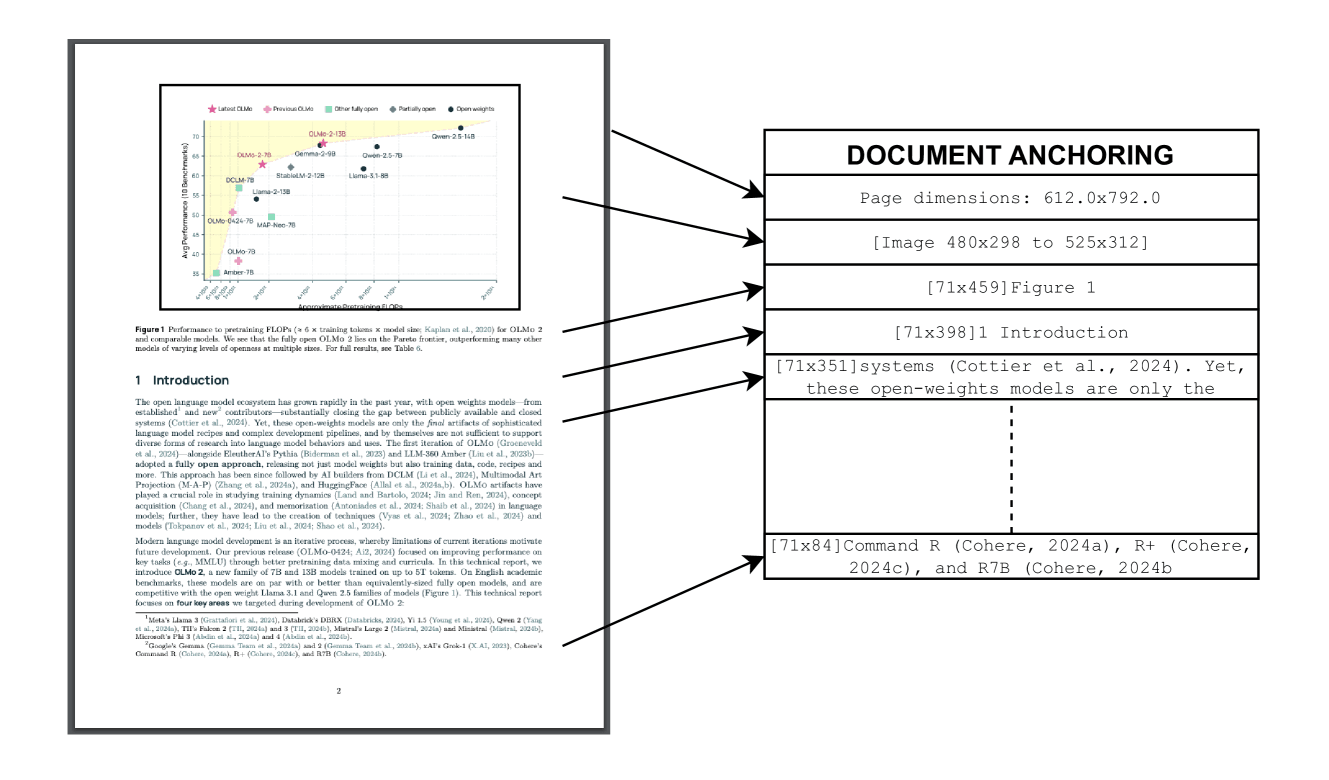
ملف PDF ليس مجرد نص مُغلف بإطار، بل هو مجموعة من تعليمات الرسم: ضع هذا الرمز (glyph) عند الإحداثيات x/y، ارسم هذا الخط هنا، وضع هذه الصورة هناك. لا يوجد مفهوم متأصل يشير إلى أن "هذا فقرة" أو "هذا جدول" أو "اقرأ من الأعلى إلى الأسفل، ثم العمود الأيسر، ثم العمود الأيمن". تقوم أدوات استخراج النصوص التقليدية (مثل pdftotext و PyMuPDF وأمثالها) بتحليل تعليمات الرسم هذه ومحاولة إعادة بناء ترتيب القراءة، لكنها تفشل باستمرار؛ ففي الأوراق البحثية ذات العمودين، تتداخل النصوص سطرًا بسطر، وتتحول الجداول إلى "حساء من الكلمات"، وتلتصق الحواشي السفلية في منتصف الجمل، أما الصفحات الممسوحة ضوئياً (والتي هي مجرد صور لا تحتوي على نصوص مدمجة) فلا تعيد أي شيء على الإطلاق.
تتجاوز نماذج الرؤية واللغة (Vision language models) هذه المشكلة من خلال التعامل مع الصفحة كما يفعل البشر: كصورة. حيث يتم عرض صورة الصفحة على النموذج، ويُطلب منه وصف ما هو مكتوب فيها وبالترتيب. هذه الطريقة تعمل بشكل أفضل بمراحل من تحليل التنسيق (layout parsing) في المستندات المعقدة، وهذا هو السبب في أن الكثيرين بدأوا بتمرير ملفات PDF عبر GPT-4o و Gemini لعمليات OCR. لكن العائق يكمن في التكلفة، وزمن الاستجابة (latency)، وحقيقة أن الكثير من ملفات PDF (مثل السجلات الطبية، والوثائق القانونية، وأي شيء يتطلب السرية) لا يمكن إرسالها إلى واجهة برمجة تطبيقات (API) تابعة لجهة خارجية.
لذا، فإن الهدف الحقيقي ليس "هل يستطيع VLM قراءة ملف PDF"، فهذا أمر مثبت بالفعل. بل الهدف هو: هل يمكنك الحصول على قدرة قراءة صفحات بمستوى GPT-4o من نموذج صغير يمكنك تشغيله بنفسك، على أجهزتك الخاصة، وبتكلفة تجعل معالجة مائة مليون صفحة مجرد "مشروع عطلة نهاية أسبوع" بدلاً من أن تكون بنداً مكلفاً في الميزانية.
مشكلة بيانات التدريب: 260,000 صفحة، فوضوية عن قصد
لا يمكنك ضبط نموذج (fine-tune) ليقرأ ملفات PDF بكفاءة دون وجود أمثلة تدريبية لنماذج تقرأ هذه الملفات بكفاءة، وهنا تكمن الصعوبة. قام فريق Ai2 ببناء olmOCR-mix-0225، وهي مجموعة بيانات تضم 260,000 صفحة مستخرجة من أكثر من 100,000 ملف PDF تم جمعها، والمثير للاهتمام هنا ليس حجم البيانات، بل تكوينها.
فبدلاً من اختيار عينة نظيفة وممثلة، تعمد الفريق ملء مجموعة البيانات بالوثائق التي تتسبب عادةً في تعطل أنظمة OCR: مثل الصفحات التي تحتوي على رموز رياضية كثيفة، والجداول ذات الخلايا المدمجة، والملاحظات المكتوبة بخط اليد، والمسوحات الضوئية منخفضة الجودة التي تظهر فيها الشوائب والميلان، والنماذج، والتنسيقات متعددة الأعمدة. وقد قاموا بتوليد النصوص المرجعية (ground-truth text) لهذه الصفحات باستخدام GPT-4o نفسه (وهي تكلفة باهظة تُدفع لمرة واحدة، لأنك تحتاج للقيام بذلك مرة واحدة لكل مثال تدريبي، وليس لكل صفحة في مرحلة الإنتاج)، كما استعانوا بمراجعين بشريين لضمان جودة جزء من هذه البيانات.
هذه هي الرؤية ذاتها التي تقف خلف معظم مشاريع التقطير (distillation) الناجحة: يمكن لنموذج صغير أن يضاهي نموذجاً أكبر في مهمة محددة إذا غذيته بمخرجات النموذج الأكبر كإشارة تدريبية، ولكن بشرط أن تغطي أمثلة التدريب التوزيع الفعلي للحالات الصعبة التي ستواجهها في بيئة العمل الحقيقية. فلو كانت مجموعة البيانات تتكون من ملفات PDF سهلة ونظيفة، لنتج عن ذلك نموذج بارع في التعامل مع الملفات السهلة والنظيفة، ولكنه سيكون عديم الفائدة بمجرد مواجهته لصورة إيصال مصور بزاوية مائلة.
بناء معيار قياس لا تسمح أدواته الحالية بالتفوق بسهولة
قبل تطوير olmOCR، قام الفريق ببناء olmOCR-Bench، وهي مجموعة مكونة من 1,400 ملف PDF صُممت بناءً على فكرة محددة: وهي أن معظم معايير قياس OCR الحالية سهلة للغاية، لأنها تهيمن عليها مستندات رقمية الأصل (born-digital)، نظيفة وذات عمود واحد، وهي ملفات تستطيع جميع الأدوات التعامل معها بكفاءة. فإذا كان معيار القياس الخاص بك يتكون بنسبة 90% من مستندات سهلة، ستبدو الأداة الضعيفة جيدة تقريباً مثل الأداة الممتازة، ولن تتمكن من التمييز بين الأنظمة التي تحدث فرقاً حقيقياً.
بدلاً من ذلك، يركز olmOCR-Bench على الفئات التي تفصل القدرات الفعلية عن الادعاءات التسويقية: الأوراق العلمية المليئة بالمعادلات، الجداول ذات الهياكل غير المنتظمة، المستندات ذات الخطوط الصغيرة أو غير المألوفة، المسوحات الضوئية القديمة والمتدهورة، والتنسيقات متعددة الأعمدة. وبدلاً من تقييم النص المستخرج مقابل مرجع باستخدام مقياس تشابه النصوص التقريبي (fuzzy string-similarity metric) — والذي قد يكافئ الأداة لمجرد استخراج الكلمات بشكل صحيح بينما يدمر هيكل المستند تماماً — استخدموا اختبارات وحدة (unit tests) محددة. هل تظهر المعادلة بصيغة LaTeX الصحيحة؟ هل صمد هيكل صفوف وأعمدة الجدول؟ هل تم الحفاظ على ترتيب القراءة الطبيعي عبر تنسيق العمودين؟ إما أن تجتاز الأداة كل فحص أو تفشل فيه.
هذا الأمر أكثر أهمية مما يبدو؛ فالكثير من مقارنات OCR المنشورة تعتمد سراً في قياساتها على الـ 90% السهلة، وهي بالضبط المنطقة التي تكون فيها الفروقات بين الأدوات في أدنى مستوياتها والأقل فائدة من حيث المعرفة.
الشكل من olmOCR: Unlocking Trillions of Tokens in PDFs with Vision Language Models (Jake Poznanski et al., arXiv:2502.18443)، مرخص بموجب CC BY 4.0.
الأرقام: olmOCR يتفوق على GPT-4o و Gemini Flash 2 و Qwen-2.5-VL
في اختبار olmOCR-Bench، تفوق النموذج 7B الذي خضع لعملية الضبط الدقيق (fine-tuned) على كل من GPT-4o و Gemini Flash 2 و Qwen-2.5-VL، وهي النماذج البصرية العامة التي استُخلص منها (distilled). إن تفوق نموذج متخصص مصمم لمهمة واحدة على النماذج العامة التي درّبته ليس ظاهرة جديدة، لكن الأمر يستحق التأمل: فالنموذج الأصغر لا يفوز لأنه "أذكى" بمعناه العام، بل لأنه يسخر كامل قدراته لمهارة واحدة محددة بدقة، كما أن بيانات التدريب صُممت خصيصاً لتغطية حالات الفشل التي تحتاج تلك المهارة لتجاوزها.
أما مقارنة التكلفة فهي الجزء الذي يغير فعلياً من سقف الممكنات؛ فبينما تبلغ تكلفة GPT-4o حوالي 6,240 دولاراً لكل مليون صفحة، تبلغ تكلفة olmOCR حوالي 176 دولاراً فقط لكل مليون صفحة. هنا لا تختار بين خيار "ميسور التكلفة" وآخر "أقل يسراً"، بل تختار بين أداة يمكنك تشغيلها بميزانية بحثية، وأداة أخرى لا يمكنك تبرير استخدامها إلا لشريحة ضيقة وعالية القيمة من مستنداتك. هذه الفجوة هي ما يجعل عبارات مثل "إطلاق العنان لتريليونات الرموز (tokens)" أكثر من مجرد شعار تسويقي؛ فبأسعار GPT-4o، تظل معظم أرشيفات PDF في العالم مغلقة لأن ميزانية أي جهة لن تغطي قراءتها بالكامل. أما بتكلفة 176 دولاراً لكل مليون صفحة، تصبح مشاريع الرقمنة الضخمة، وعمليات التدريب على مجموعات بيانات كاملة (whole-corpus)، وفهرسة البحث في الأرشيفات الشاملة، أموراً يمكن لفريق متوسط الحجم التخطيط لها وتنفيذها فعلياً.
كما صُمم مسار العمل (pipeline) ليركز على إنتاجية المعالجة (throughput) بدلاً من الاستدعاءات الفردية؛ فهو يدعم كلاً من vLLM و SGLang كخلفيات للاستدلال (inference backends)، وقد صُمم ليتوسع وفقاً لأي إعدادات GPU متوفرة لديك بدلاً من اشتراط تكوين محدد. هذا خيار متعمد يستهدف المستخدم المنشود: الشخص الذي يعالج ملايين الصفحات بنظام الدفعات (batch)، وليس من يبني ميزة لرفع مستند واحد فقط.
لماذا يهم هذا الأمر كل من يقوم ببناء أو اختيار أنظمة OCR
إذا كنت بصدد تحديد كيفية التعامل مع استخراج البيانات من المستندات في منتج ما، فإن olmOCR يقدم دليلاً على فرضية محددة: بالنسبة لعمليات OCR ذات الأحجام الضخمة، يمكن لنموذج مفتوح ومتخصص أن يتفوق على النماذج الرائدة العامة (frontier models) من حيث الجودة والتكلفة معاً، شريطة أن يقوم شخص ما بالعمل الشاق والمضني في بناء مجموعة بيانات تدريبية تغطي الحالات المعقدة والسيئة. هذا الدرس يختلف عن المقولة العامة بأن "النماذج الصغيرة بدأت تلحق بالنماذج الكبيرة"؛ فهو درس أكثر تحديداً وفائدة: الضبط الدقيق (fine-tuning) الموجه لمهمة معينة باستخدام بيانات صعبة وتمثيلية يمكن أن يتفوق على مجرد زيادة حجم النموذج، على الأقل في المشكلات ذات الهيكلية البصرية الواضحة مثل قراءة الصفحات. وتزداد هذه التحديات تعقيداً عند التعامل مع النصوص العربية، نظراً لطبيعة الخط المتصل، والكتابة من اليمين إلى اليسار، وتغير أشكال الحروف حسب موقعها في الكلمة، مما يجعل عملية الـ OCR أكثر صعوبة.
ويمكن تلخيص الاستنتاجات العملية في ثلاثة قرارات أساسية:
- إذا كنت تعالج ملفات PDF على نطاق واسع (أرشيفات، مجموعات بيانات تدريبية، أو مسارات مستندات تضم ملايين الصفحات)، فإن نموذجاً مستضافاً ذاتياً مثل olmOCR يلغي تكلفة واجهة برمجة التطبيقات (API) لكل صفحة، والتي تجعل هذه المشاريع مكلفة حتى في مرحلة النموذج الأولي. إن الفجوة بين 6,240 دولاراً و176 دولاراً لكل مليون صفحة هي الفرق بين قولنا "أجرينا تجربة على 10,000 صفحة" و"قمنا بمعالجة الأرشيف بأكمله".
- إذا كانت مستنداتك حساسة (سجلات طبية، قانونية، أو مالية لا يمكن أن تخرج من بنيتك التحتية)، فإن النموذج الذي يمكنك تشغيله بنفسك ليس مجرد خيار أرخص، بل هو الخيار الوحيد الذي يلبي متطلبات الامتثال والأمان لديك في المقام الأول.
- إذا كنت تقوم بمقارنة أدوات OCR لاتخاذ قرار شراء، فاسأل عما يختبره المقياس (benchmark) فعلياً. فالأداة التي تحقق نتائج جيدة في ملفات PDF النظيفة ذات العمود الواحد، وتفشل في الجداول الممسوحة ضوئياً أو الأوراق الأكاديمية متعددة الأعمدة، ستتصرف بشكل مختلف تماماً بناءً على ما تغذيها به من بيانات. إن نهج olmOCR-Bench، الذي يعطي وزناً متعمداً للحالات الصعبة، هو السؤال الصحيح الذي يجب توجيهه لأي مورد عند مراجعة أرقامه، بما في ذلك مقارنات الكتالوج الخاصة بـ OpenOCR.
ما لم تعالجه الورقة البحثية
النتائج قوية، ولكن من المهم أن نكون صريحين بشأن نطاق العمل. يتكون olmOCR-Bench من 1,400 ملف PDF تم اختيارها من قبل الفريق نفسه الذي بنى النموذج الذي يتم تقييمه، ورغم أن منهجية "اختبار الوحدة" (unit-test) تمثل تحسناً حقيقياً مقارنة بـ "مطابقة السلاسل النصية التقريبية" (fuzzy string matching)، إلا أن ادعاء "لقد بنينا أصعب معيار قياس ثم حققنا فيه أفضل نتيجة" هو ادعاء يستوجب قدراً من الشك الصحي حتى تقوم مجموعات مستقلة بإعادة إنتاج هذا التصنيف على مجموعات المستندات الخاصة بها.
كما أن النموذج بحجم 7B parameter، مما يعني أنه يتطلب بنية تحتية حقيقية من وحدات GPU ليعمل بالإنتاجية المذكورة في الورقة. تكلفة 176 دولاراً لكل مليون صفحة تفترض أنك تمتلك بالفعل أو يمكنك استئجار الأجهزة اللازمة لتشغيل vLLM أو SGLang بكفاءة؛ فهي ليست سعراً تدفعه مقابل كل استدعاء API كما هو الحال في تسعير GPT-4o. وبالنسبة لشخص يعالج بضع مئات من الصفحات شهرياً، قد تظل واجهات برمجة التطبيقات المتقدمة (frontier API) هي الخيار الأبسط والأرخص بمجرد احتساب الوقت الهندسي اللازم لإعداد خط معالجة مستضاف ذاتياً. كما تظل الكتابة اليدوية، والمسوحات الضوئية المتدهورة للغاية، والمستندات باللغات ذات الموارد المحدودة مدرجة في الورقة نفسها كتحديات قائمة وليست مشكلات تم حلها.
لا يقلل أي من ذلك من قيمة النتيجة الجوهرية، بل يعني أن القراءة المنصفة هي: "هذا خيار قوي جداً ومنخفض التكلفة لمعالجة ملفات PDF على نطاق واسع عندما تتحكم في البنية التحتية"، وليس "لقد تم حل مشكلة OCR وأصبحت مجانية". وبالنسبة للمشكلة المحددة التي يستهدفها النموذج — وهي استخراج كميات ضخمة من نصوص PDF دون تحمل تكاليف frontier-API — فإنه يمثل قطعة مفيدة حقاً من البنية التحتية المفتوحة. وحقيقة أن Ai2 قامت بإصدار النموذج وبيانات التدريب ومعيار القياس بدلاً من مجرد نشر الورقة البحثية تعني أن بإمكان أي شخص التحقق من هذه الأرقام بدلاً من قبولها كمسلمات.