你的 PDF 价值数万亿个 Token,而大多数 OCR 流水线正在将它们浪费掉。
参考论文: olmOCR: Unlocking Trillions of Tokens in PDFs with Vision Language Models — Jake Poznanski, Aman Rangapur, Jon Borchardt, Jason Dunkelberger, Regan Huff, Daniel Lin, Aman Rangapur, Christopher Wilhelm, Kyle Lo, Luca Soldaini
成本与效率的博弈
这里有一个足以让你停下刷屏脚步的数字:如果使用 GPT-4o 来提取互联网上所有 PDF 页面的纯净文本,每百万页的成本将超过 6,240 美元。将这个规模扩展到政府档案、科学期刊、法院文件和旧扫描书籍中数以十亿计的 PDF,仅仅为了让这些文本能被语言模型或搜索索引使用,你可能需要支付数千万美元的账单。
Allen Institute for AI (Ai2) 的团队在看到这个数字后,提出了一个更有趣的问题:如果根本不需要 GPT-4o 呢?他们的答案是 olmOCR——一个拥有 70 亿参数、专门为阅读 PDF 而微调的视觉模型。处理一百万页的成本仅为 176 美元。这与 GPT-4o 的价格相比,绝非简单的微小差距,而是便宜了约 35 倍;而且根据他们的 benchmark,olmOCR 的准确率还更高。
如果你在开发任何涉及文档提取的功能,那么这篇论文非常值得深入研究。因为它悄然解决了过去几年里一直存在的一个争论:阅读 PDF 究竟需要一个巨大的通用模型,还是一个更小、更专业的模型能做得更好?
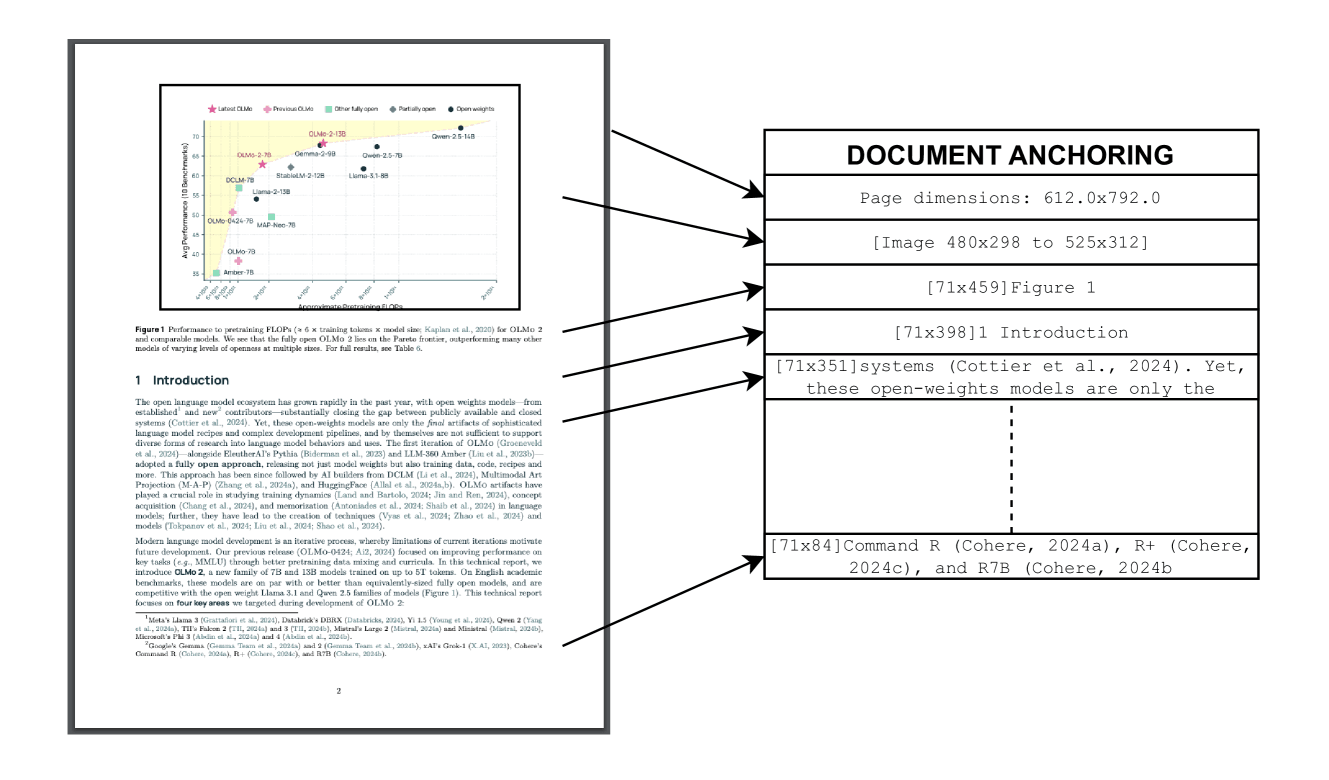
图表出自 olmOCR: Unlocking Trillions of Tokens in PDFs with Vision Language Models (Poznanski et al., arXiv:2502.18443),采用 CC BY 4.0 许可。
为什么读取 PDF 比看起来要困难得多
PDF 并不是简单地给文本套了个壳,而是一系列绘图指令:在这个 x/y 坐标放置这个字符字形,在这里画一条线,在那里放一张图片。它本身并没有“这是一个段落”、“这是一个表格”或者“先从上到下阅读,然后读左列,再读右列”这样的概念。传统的 PDF 文本提取工具(如 pdftotext、PyMuPDF 等)通过解析这些绘图指令来尝试重建阅读顺序,但它们经常失效:双栏学术论文的列内容会被逐行交错混在一起,表格变成了乱码词堆,脚注被强行插入到句子中间,而扫描页(本质上只是图像,完全没有嵌入文本)则根本无法提取出任何内容。
视觉语言模型(Vision language models)通过像人类一样将页面视为一张图片,巧妙地绕过了这个问题。直接向模型展示页面图像,并要求它按顺序描述上面写了什么。对于排版混乱的文档,这种方法比布局解析(layout parsing)效果好得多,这也是为什么人们一直将 PDF 传给 GPT-4o 和 Gemini 进行 OCR 的原因。但问题在于成本、延迟,以及许多 PDF(如医疗记录、法律文件或任何有保密要求的文档)根本无法发送给第三方 API。
因此,真正的目标不再是“VLM 能否读取 PDF”——这一点已经得到了验证。真正的目标是:能否通过一个可以在自有硬件上运行的小模型,实现 GPT-4o 级别的页面读取能力,并将其成本降低到让处理一亿页文档变成一个“周末小项目”,而不是一项沉重的预算开支。
训练数据难题:26 万页,刻意制造的“混乱”
如果你没有模型高效阅读 PDF 的训练示例,就无法通过微调让模型具备这种能力,而这恰恰是最困难的部分。Ai2 团队构建了 olmOCR-mix-0225,这是一个包含 260,000 个页面的数据集,提取自 100,000 多个抓取的 PDF 文件。其核心亮点不在于规模,而在于构成。
他们并没有筛选干净且具有代表性的样本,而是刻意地加入了那些会让 OCR 系统崩溃的文档:包含密集数学符号的页面、带有合并单元格的表格、手写注释、带有明显噪点和倾斜的低质量扫描件、表单以及多栏布局。他们使用 GPT-4o 为这些页面生成了 ground-truth 文本(这是一次性的高昂成本,因为每个训练样本只需处理一次,而非在生产环境中的每个页面都如此),并由人工对部分内容进行了质量审核。
这与大多数成功的蒸馏项目背后的逻辑一致:如果你将大模型的输出作为训练信号,小模型在特定狭窄的任务上可以媲美大模型,但前提是你的训练示例必须覆盖生产环境中实际会出现的各种极端困难案例。如果数据集只包含简单、干净的 PDF,那么训练出的模型在处理简单文档时表现出色,但一旦遇到一张倾斜拍摄的收据照片,就将毫无用处。
构建一个让现有工具无法轻易胜任的基准测试
在开发 olmOCR 之前,团队首先构建了 olmOCR-Bench。这是一个包含 1,400 份 PDF 的数据集,其核心理念在于:大多数现有的 OCR 基准测试过于简单,因为它们充斥着大量干净、单栏且原生数字化的文档,而这些文档几乎所有工具都能处理得很好。如果你的基准测试中 90% 都是简单文档,那么一个糟糕的工具看起来会和优秀的工具差不多,你将无法分辨出那些真正具有性能差异的系统。
相比之下,olmOCR-Bench 专注于那些能将“真实能力”与“营销噱头”区分开的类别:充满公式的科学论文、结构不规则的表格、使用极小或罕见字体的文档、陈旧且质量低劣的扫描件,以及多栏布局。他们并没有使用模糊的字符串相似度指标将提取的文本与参考答案进行比对(因为这种方式可能会在文档结构被完全破坏的情况下,只要单词正确就给工具打高分),而是采用了针对性的单元测试。例如:公式是否以正确的 LaTeX 渲染?表格的行与列结构是否得以保留?双栏布局中的自然阅读顺序是否正确?工具要么通过检查,要么失败。
这一点比听起来要重要得多。许多已发布的 OCR 对比测试在潜意识中是对那 90% 的简单文档进行基准测试,而这恰恰是工具之间差异最小、且最没有参考价值的领域。
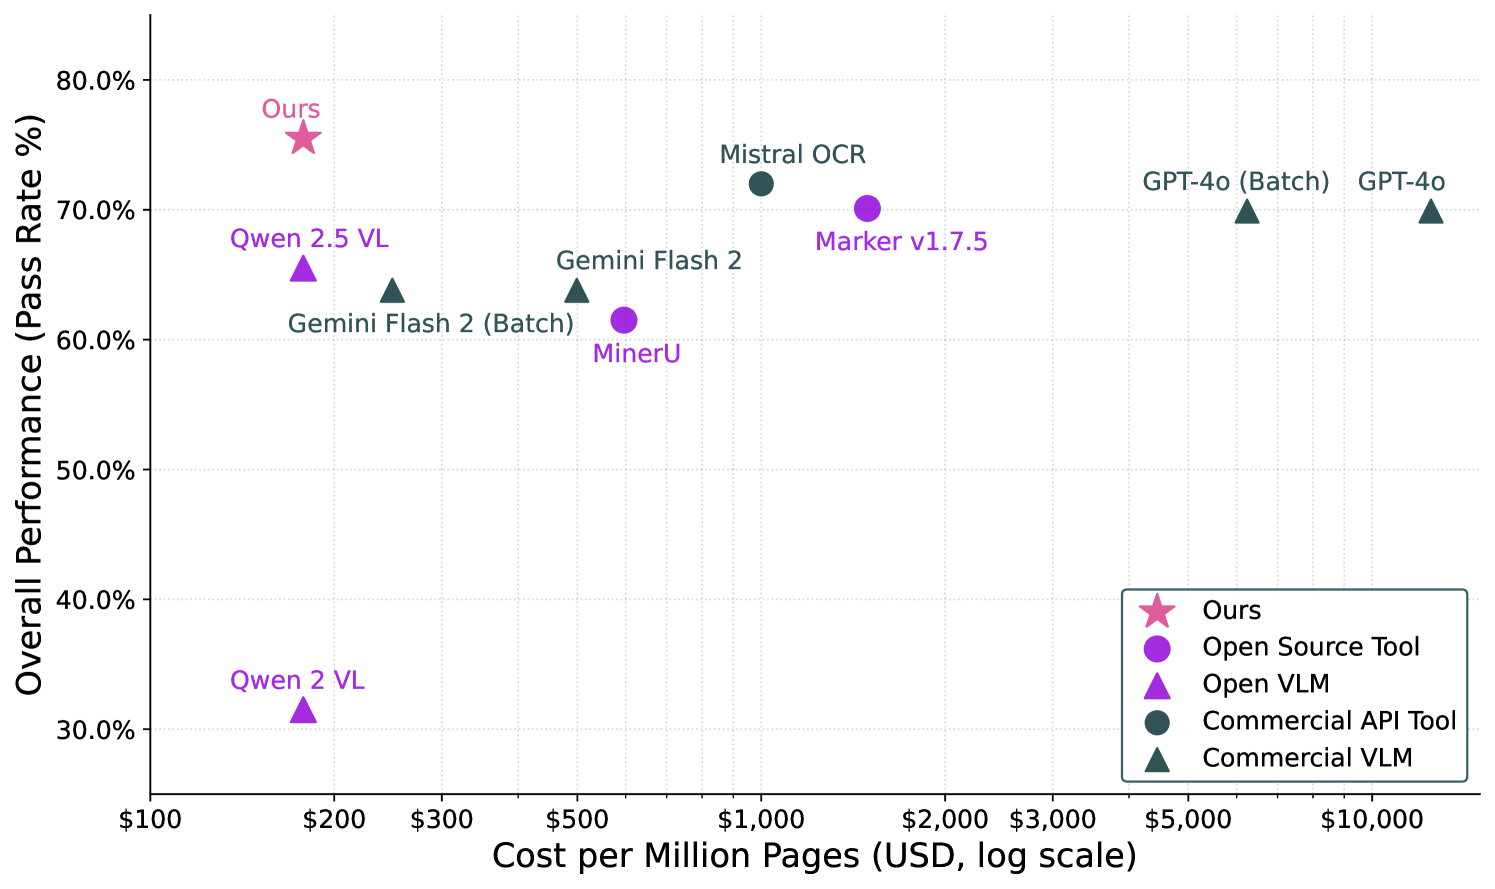
图片来自 olmOCR: Unlocking Trillions of Tokens in PDFs with Vision Language Models(Jake Poznanski 等人,arXiv:2502.18443),采用 CC BY 4.0 许可。
数据对比:olmOCR 击败 GPT-4o、Gemini Flash 2 和 Qwen-2.5-VL
在 olmOCR-Bench 测试中,经过微调的 7B 模型表现优于 GPT-4o、Gemini Flash 2 以及 Qwen-2.5-VL(即其蒸馏来源的通用视觉模型)。一个针对特定任务构建的专业模型能够击败训练它的通用模型,这并非新鲜事,但仍值得深思:这个较小的模型获胜并非因为它在某种通用意义上更智能,而是因为它的全部容量都集中在一项狭窄且定义明确的技能上,且训练数据是专门为覆盖该技能所需的各种失效模式而构建的。
而成本对比才是真正改变可行性的关键。GPT-4o 每百万页的成本约为 6,240 美元,而 olmOCR 仅为 176 美元。这不再是“负担得起”与“稍微贵一点”之间的选择,而是在“可以用研究预算运行的工具”与“只能用于极少数高价值文档的工具”之间做选择。正是这个巨大的差距,让“解锁数万亿个 token”这类措辞不再仅仅是营销口号:在 GPT-4o 的定价下,世界上大多数 PDF 存档将依然被锁死,因为没有人的预算能覆盖全部读取成本。而当成本降至每百万页 176 美元时,大规模数字化项目、全语料库训练以及全存档搜索索引,才真正成为中型团队可以规划并实施的目标。
此外,该流水线是为高吞吐量而非单次调用而设计的:它支持 vLLM 和 SGLang 作为推理后端,并旨在适配各种 GPU 配置,而非要求特定的硬件环境。这是针对目标用户群体的刻意选择——我们的用户是那些需要批量处理数百万页文档的人,而不是在开发单个文档上传功能的人。
为什么这对于构建或选择 OCR 的开发者至关重要
如果你正在决定如何在产品中处理文档提取,olmOCR 证明了一个特定的观点:对于大规模 OCR 任务,只要有人愿意承担构建涵盖各种极端复杂案例的训练集这一枯燥工作,一个专门的开源模型在质量和成本上都能击败通用前沿模型。这与通常所说的“小模型正在追赶大模型”不同,而是一个更具体且更有用的结论:针对困难且具有代表性的数据进行任务特定微调,其效果可以超越单纯的模型规模,至少对于像页面阅读这样具有视觉结构化特征的问题是如此。对于处理汉字等具有数千个字符且布局密集的日志图形文字时,这种针对复杂布局的微调能力尤为关键。
在实际操作中,这可以转化为三个核心决策:
- 如果你需要大规模处理 PDF(如档案库、训练语料库或包含数百万页面的文档流水线),像 olmOCR 这样可自托管的模型消除了单页 API 成本,而这种成本往往让项目在原型阶段就变得极其昂贵。每百万页 6,240 美元与 176 美元之间的差距,决定了你是只能“对 1 万页进行试点”还是能够“处理整个档案库”。
- 如果你的文档具有敏感性(如无法离开基础设施的医疗、法律或财务记录),能够自行运行的模型不仅更便宜,而且是唯一能满足合规性要求的选择。
- 如果你在为采购决策而对 OCR 工具进行基准测试,请询问基准测试实际测试的内容。一个在干净的单栏 PDF 上得分很高,但在扫描表格或多栏学术论文上表现糟糕的工具,其最终效果将完全取决于你输入的内容。olmOCR-Bench 刻意向困难案例倾斜的评估方法,正是质疑任何供应商数据(包括 OpenOCR 自身的目录对比)时应该采取的正确方式。
论文尚未解决的问题
尽管结果令人印象深刻,但我们仍需客观地看待其适用范围。olmOCR-Bench 包含 1,400 份 PDF,由开发该模型的同一个团队策划。虽然其单元测试方法比模糊字符串匹配有了实质性提升,但“我们构建了最难的基准测试,然后在该测试中表现最好”这一说法值得保持审慎,直到独立团队在自己的文档集上复现出同样的排名。
此外,该模型是一个 7B 参数模型,这意味着需要真实的 GPU 基础设施才能达到论文中所述的吞吐量。每百万页 176 美元的成本是基于你已经拥有或能够租赁运行 vLLM 或 SGLang 的硬件而计算的;这并非像 GPT-4o 那样按 API 调用付费。对于每月仅处理几百页文档的用户,考虑到搭建自托管流水线的工程时间,前沿 API 仍可能是更简单、更便宜的选择。同时,论文本身也将手写体、极度模糊的扫描件以及低资源语言文档列为尚未解决的开放性挑战。
这些限制并不影响核心结论。它只是意味着,客观的解读应该是:“对于能够控制基础设施的大规模 PDF 处理任务,这是一个非常强大且廉价的选择”,而不是“OCR 问题已经彻底解决且完全免费”。针对其目标场景——即在无需支付前沿 API 高昂费用的情况下解锁海量 PDF 文本——它确实是一项非常有用的开源基础设施。而 Ai2 不仅发布了论文,还公开了模型、训练数据和基准测试,这意味着任何人都可以验证这些数据,而无需盲目信任。