Seus PDFs valem trilhões de tokens. A maioria dos pipelines de OCR está jogando-os fora.
Baseado em: olmOCR: Unlocking Trillions of Tokens in PDFs with Vision Language Models — Jake Poznanski, Aman Rangapur, Jon Borchardt, Jason Dunkelberger, Regan Huff, Daniel Lin, Aman Rangapur, Christopher Wilhelm, Kyle Lo, Luca Soldaini
O Custo da Extração de Texto
Aqui está um número que deve fazer você parar a rolagem da tela: processar cada página de PDF na internet através do GPT-4o para extrair texto limpo custaria mais de $6.240 por milhão de páginas. Projete isso para os bilhões de PDFs armazenados em arquivos governamentais, periódicos científicos, processos judiciais e livros antigos digitalizados, e você terá uma conta de dezenas de milhões de dólares apenas para tornar esse texto utilizável por um modelo de linguagem ou um índice de busca.
Uma equipe do Allen Institute for AI (Ai2) analisou esse número e fez uma pergunta mais interessante: e se você não precisasse do GPT-4o? A resposta deles é o olmOCR, um modelo de visão de 7 bilhões de parâmetros ajustado especificamente para a leitura de PDFs, que processa um milhão de páginas por $176. Isso não é apenas uma pequena diferença em relação ao preço do GPT-4o; é cerca de 35 vezes mais barato e, de acordo com o benchmark deles, também é mais preciso.
Se você desenvolve qualquer solução que envolva extração de documentos, vale a pena entender este artigo em detalhes, pois ele resolve discretamente uma discussão que já dura alguns anos: você precisa de um modelo gigante e de propósito geral para ler um PDF com qualidade, ou um modelo menor e especializado consegue fazer isso melhor?
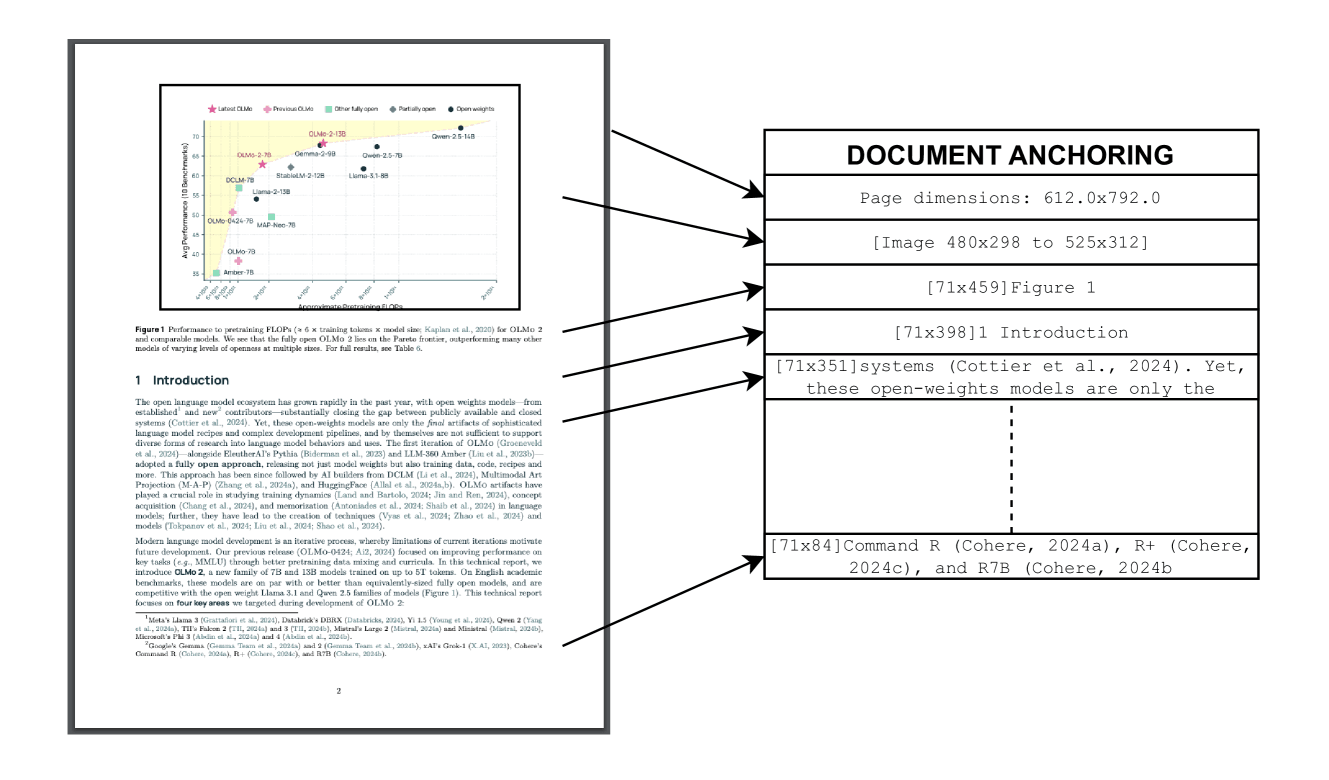
Figura de olmOCR: Unlocking Trillions of Tokens in PDFs with Vision Language Models (Poznanski et al., arXiv:2502.18443), licenciada sob CC BY 4.0.
Por que ler um PDF é um problema mais difícil do que parece
Um PDF não é apenas texto com uma "embalagem" ao redor. Ele é um conjunto de instruções de desenho: coloque este glifo de caractere nesta coordenada x/y, coloque aquela linha aqui, coloque esta imagem ali. Não existe um conceito inerente de "isto é um parágrafo", "isto é uma tabela" ou "leia de cima para baixo, depois a coluna da esquerda e então a da direita". Os extratores de texto de PDF tradicionais (pdftotext, PyMuPDF e similares) analisam essas instruções de desenho e tentam reconstruir a ordem de leitura, mas falham constantemente: artigos acadêmicos de duas colunas têm suas colunas intercaladas linha por linha, tabelas viram uma "sopa de palavras", notas de rodapé ficam grudadas no meio de uma frase e páginas escaneadas (que são apenas imagens, sem texto incorporado) não retornam nada.
Os Vision Language Models (VLMs) contornam isso tratando a página da mesma forma que um ser humano faria: como uma imagem. Mostre ao modelo uma imagem da página e peça para ele descrever o que está escrito, em ordem. Isso funciona drasticamente melhor do que a análise de layout para documentos complexos, e é por isso que as pessoas têm processado PDFs via GPT-4o e Gemini para OCR. O problema é o custo, a latência e o fato de que muitos PDFs (prontuários médicos, documentos jurídicos, qualquer coisa com requisitos de confidencialidade) não podem ser enviados para a API de terceiros.
Portanto, o verdadeiro objetivo não é "um VLM consegue ler um PDF?". Isso já está comprovado. O objetivo é: você consegue obter a capacidade de leitura de página do GPT-4o em um modelo pequeno que possa executar por conta própria, em seu próprio hardware, a um custo que transforme o processamento de cem milhões de páginas em um projeto de fim de semana, em vez de uma linha orçamentária exorbitante.
O problema dos dados de treinamento: 260.000 páginas, deliberadamente caóticas
Não é possível fazer o fine-tuning de um modelo para ler PDFs com eficiência sem exemplos de treinamento de um modelo que já leia PDFs com eficiência, e é aí que reside a maior dificuldade. A equipe da Ai2 criou o olmOCR-mix-0225, um conjunto de dados com 260.000 páginas extraídas de mais de 100.000 PDFs rastreados; e o ponto interessante não é o tamanho, mas a composição.
Em vez de selecionar uma amostra limpa e representativa, eles a preencheram deliberadamente com os documentos que costumam quebrar sistemas de OCR: páginas com notações matemáticas densas, tabelas com células mescladas, anotações manuscritas, digitalizações de baixa qualidade com ruídos e inclinações, formulários e layouts de múltiplas colunas. Eles geraram o texto de referência (ground-truth) para essas páginas utilizando o próprio GPT-4o (um custo elevado e pontual, já que isso só precisa ser feito uma vez por exemplo de treinamento, e não por página em produção) e contaram com a revisão humana de uma parte do material para garantir a qualidade.
Esta é a mesma lógica por trás da maioria dos projetos de destilação bem-sucedidos: um modelo menor pode se equiparar a um maior em uma tarefa específica se você utilizar as saídas do modelo maior como sinal de treinamento — mas isso só funciona se os seus exemplos de treinamento cobrirem a distribuição real de casos complexos que surgirão em produção. Um conjunto de dados composto apenas por PDFs limpos e simples teria resultado em um modelo excelente para PDFs limpos e simples, mas inútil no momento em que encontrasse um recibo fotografado em ângulo.
Construindo um benchmark no qual as ferramentas existentes não poderiam ser boas
Antes de desenvolverem o olmOCR, a equipe criou o olmOCR-Bench, um conjunto de 1.400 PDFs projetados com base em uma ideia específica: a maioria dos benchmarks de OCR existentes é fácil demais, pois é dominada por documentos digitais nativos, de coluna única e limpos, que qualquer ferramenta já processa adequadamente. Se o seu benchmark é composto por 90% de documentos fáceis, uma ferramenta ruim parece quase tão boa quanto uma excelente, e torna-se impossível distinguir os sistemas que realmente fazem a diferença.
Em vez disso, o olmOCR-Bench concentra-se nas categorias que separam a capacidade real das promessas de marketing: artigos científicos repletos de equações, tabelas com estruturas irregulares, documentos com fontes minúsculas ou incomuns, digitalizações antigas e degradadas e layouts de múltiplas colunas. Em vez de pontuar o texto extraído em relação a uma referência usando uma métrica de similaridade de string imprecisa (que pode premiar uma ferramenta por acertar as palavras, mesmo que ela destrua completamente a estrutura do documento), eles utilizam testes unitários direcionados. A equação é renderizada com o LaTeX correto? A estrutura de linhas e colunas da tabela foi preservada? A ordem de leitura natural é mantida em um layout de duas colunas? A ferramenta passa em cada verificação ou não.
Isso é mais importante do que parece. Muitas comparações de OCR publicadas fazem benchmarks silenciosamente nos 90% fáceis, que é exatamente onde as diferenças entre as ferramentas são menores e menos úteis de se conhecer.
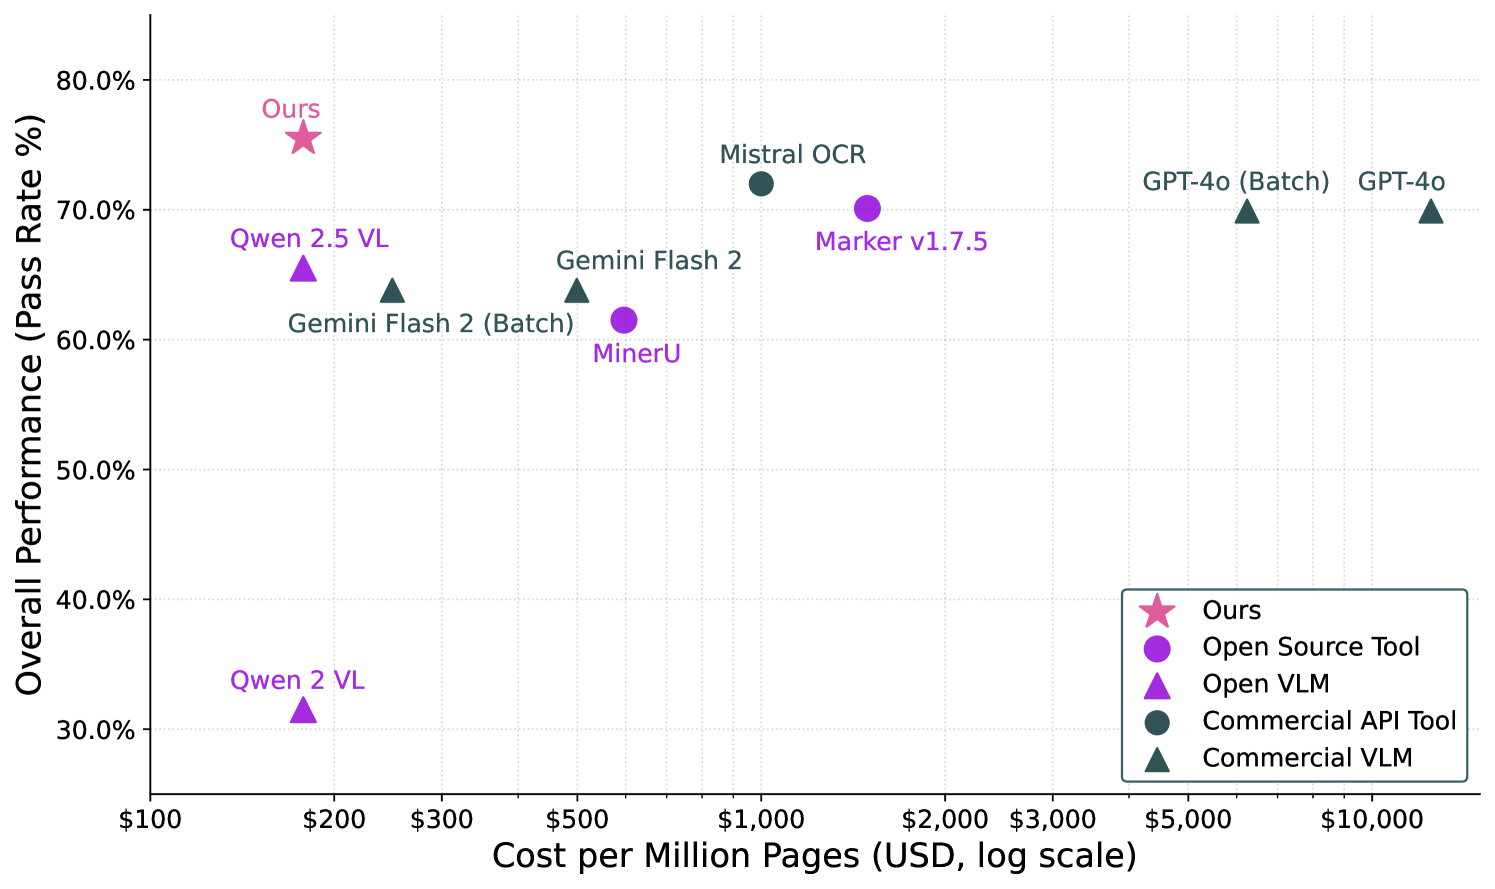
Figura de olmOCR: Unlocking Trillions of Tokens in PDFs with Vision Language Models (Jake Poznanski et al., arXiv:2502.18443), licenciada CC BY 4.0.
Os números: olmOCR supera GPT-4o, Gemini Flash 2 e Qwen-2.5-VL
No olmOCR-Bench, o modelo 7B com fine-tuning supera o GPT-4o, o Gemini Flash 2 e o Qwen-2.5-VL — os modelos de visão de propósito geral dos quais ele foi destilado. O fato de um modelo especializado em uma única tarefa vencer os modelos generalistas que o treinaram não é um fenômeno novo, mas ainda assim merece reflexão: o modelo menor não está vencendo por ser "mais inteligente" em um sentido geral. Ele vence porque toda a sua capacidade é dedicada a uma habilidade específica e bem definida, e os dados de treinamento foram construídos especificamente para cobrir as falhas que essa habilidade precisa superar.
A comparação de custos é a parte que realmente muda o que é viável. Com aproximadamente $6.240 por milhão de páginas para o GPT-4o contra $176 por milhão de páginas para o olmOCR, você não está escolhendo entre "acessível" e "um pouco menos acessível". Você está escolhendo entre uma ferramenta que pode ser executada com um orçamento de pesquisa e outra que só seria justificável para uma fatia pequena e de alto valor dos seus documentos. Essa diferença é o que torna frases como "desbloquear trilhões de tokens" mais do que apenas um slogan de marketing: com os preços do GPT-4o, a maior parte do arquivo de PDFs do mundo permanece bloqueada, pois nenhum orçamento cobre a leitura de tudo. A $176 por milhão de páginas, projetos de digitalização em massa, treinamentos de corpora inteiros e índices de busca de arquivos completos tornam-se objetivos que uma equipe de médio porte pode realmente planejar e implementar.
O pipeline também foi construído para throughput em vez de chamadas isoladas: ele suporta vLLM e SGLang como backends de inferência e foi projetado para escalar em qualquer configuração de GPU, sem exigir uma configuração específica. Essa é uma escolha deliberada para o usuário-alvo: alguém que processa milhões de páginas em lote, e não alguém que está criando um recurso de upload de documento único.
Por que isso é importante para quem está construindo ou escolhendo um OCR
Se você está decidindo como lidar com a extração de documentos em um produto, o olmOCR serve como evidência para uma afirmação específica: para OCR de alto volume, um modelo aberto especializado pode superar um modelo de fronteira de propósito geral, tanto em qualidade quanto em custo, desde que alguém tenha feito o trabalho árduo de construir um conjunto de treinamento que cubra os casos problemáticos. Esta é uma lição diferente de "modelos menores estão alcançando os grandes" de forma geral. É algo mais restrito e útil: o ajuste fino (fine-tuning) específico para a tarefa, utilizando dados difíceis e representativos, pode superar a escala bruta do modelo, pelo menos para problemas visualmente estruturados como a leitura de uma página.
A conclusão prática divide-se em três decisões reais:
- Se você processa PDFs em escala (arquivos, corpora de treinamento, pipelines de documentos com milhões de páginas), um modelo auto-hospedado como o olmOCR elimina o custo de API por página que torna esses projetos caros até mesmo para prototipar. A diferença entre $6.240 e $176 por milhão de páginas é a diferença entre "fizemos um piloto com 10.000 páginas" e "processamos todo o arquivo".
- Se seus documentos são sensíveis (registros médicos, jurídicos ou financeiros que não podem sair da sua infraestrutura), um modelo que você possa executar localmente não é apenas mais barato, é a única opção que satisfaz seus requisitos de conformidade desde o início.
- Se você está comparando ferramentas de OCR para tomar uma decisão de compra, questione o que o benchmark está realmente testando. Uma ferramenta que pontua bem em PDFs limpos de coluna única, mas mal em tabelas digitalizadas ou artigos acadêmicos de múltiplas colunas, se comportará de maneira muito diferente dependendo do que você realmente inserir nela. A abordagem do olmOCR-Bench, que prioriza deliberadamente os casos difíceis, é a pergunta certa a se fazer sobre os números de qualquer fornecedor, incluindo as comparações de catálogo do próprio OpenOCR.
O que o artigo não resolve
Os resultados são sólidos, mas é importante ser honesto sobre o escopo. O olmOCR-Bench consiste em 1.400 PDFs selecionados pela mesma equipe que desenvolveu o modelo avaliado; e embora a metodologia de testes unitários seja uma melhoria real em relação ao fuzzy string matching, a afirmação "construímos o benchmark mais difícil e tivemos o melhor desempenho nele" merece um certo ceticismo até que grupos independentes reproduzam o ranking em seus próprios conjuntos de documentos.
O modelo também possui 7B de parâmetros, o que significa que requer uma infraestrutura de GPU robusta para operar com a vazão descrita no artigo. O custo de $176 por milhão de páginas pressupõe que você já possua ou possa alugar o hardware para executar vLLM ou SGLang de forma eficiente; não é um preço pago por chamada de API, como ocorre com a precificação do GPT-4o. Para quem processa algumas centenas de páginas por mês, as APIs de ponta podem continuar sendo a escolha mais simples e barata, considerando o tempo de engenharia necessário para implementar um pipeline auto-hospedado. Além disso, caligrafia manual, digitalizações extremamente degradadas e documentos em idiomas com poucos recursos continuam listados no próprio artigo como desafios em aberto, e não como problemas resolvidos.
Nada disso anula a conclusão principal. Apenas significa que a leitura honesta é: "esta é uma opção muito forte e barata para processamento de PDFs em larga escala onde você controla a infraestrutura", e não "o OCR agora está resolvido e é gratuito". Para o problema específico que visa — desbloquear grandes volumes de texto em PDF sem os preços de APIs de ponta — trata-se de uma peça de infraestrutura aberta genuinamente útil. O fato de a Ai2 ter liberado o modelo, os dados de treinamento e o benchmark, em vez de apenas o artigo, significa que qualquer pessoa pode verificar esses números em vez de aceitá-los por fé.