Tus PDFs valen billones de tokens. La mayoría de los pipelines de OCR los están desperdiciando.
Basado en: olmOCR: Unlocking Trillions of Tokens in PDFs with Vision Language Models — Jake Poznanski, Aman Rangapur, Jon Borchardt, Jason Dunkelberger, Regan Huff, Daniel Lin, Aman Rangapur, Christopher Wilhelm, Kyle Lo, Luca Soldaini
El costo de la extracción de texto
Aquí hay una cifra que debería hacerte detenerte mientras navegas: procesar cada página de PDF en internet a través de GPT-4o para extraer texto limpio costaría más de $6,240 por millón de páginas. Si escalas eso a los miles de millones de PDFs que residen en archivos gubernamentales, revistas científicas, expedientes judiciales y libros antiguos escaneados, te enfrentarías a una factura de decenas de millones de dólares solo para que ese texto sea utilizable por un modelo de lenguaje o un índice de búsqueda.
Un equipo del Allen Institute for AI (Ai2) analizó esa cifra y se planteó una pregunta más interesante: ¿y si no necesitaras GPT-4o en absoluto? Su respuesta es olmOCR, un modelo de visión de 7 billion parameters ajustado específicamente para leer PDFs, el cual procesa un millón de páginas por $176. Esto no es una diferencia insignificante respecto al precio de GPT-4o; es aproximadamente 35 veces más barato y, según su benchmark, también es más preciso.
Si desarrollas cualquier herramienta relacionada con la extracción de documentos, vale la pena analizar este paper en detalle, ya que resuelve discretamente un debate que ha estado vigente durante un par de años: ¿se necesita un modelo gigante y de propósito general para leer bien un PDF, o puede un modelo más pequeño y especializado hacerlo mejor?
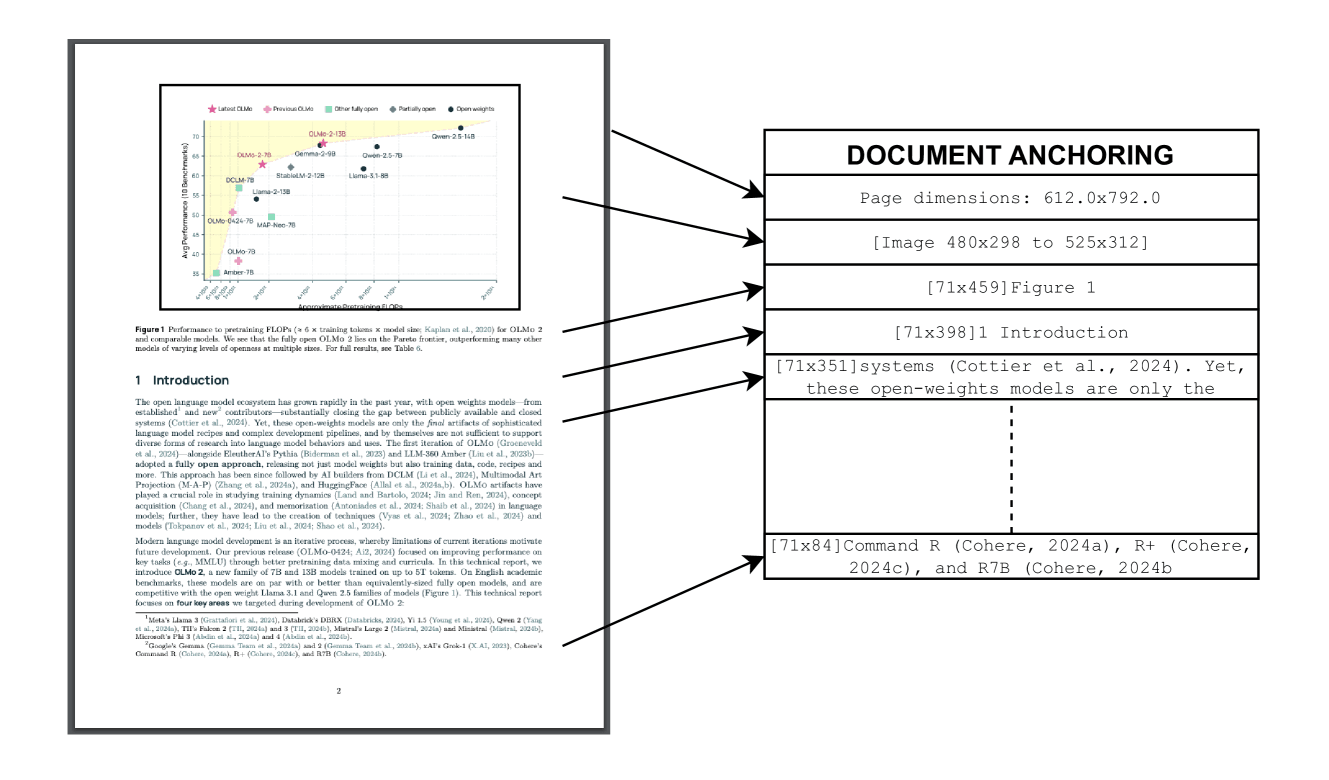
Figura de olmOCR: Unlocking Trillions of Tokens in PDFs with Vision Language Models (Poznanski et al., arXiv:2502.18443), bajo licencia CC BY 4.0.
Por qué leer un PDF es un problema más complejo de lo que parece
Un PDF no es texto envuelto en un contenedor; es un conjunto de instrucciones de dibujo: coloca este glifo de carácter en esta coordenada x/y, traza esta línea aquí, inserta esta imagen allá. No existe un concepto inherente de "esto es un párrafo", "esto es una tabla" o "lee de arriba abajo, luego la columna izquierda y después la derecha". Los extractores de texto tradicionales (pdftotext, PyMuPDF y similares) analizan esas instrucciones de dibujo e intentan reconstruir el orden de lectura, pero fallan constantemente: en los artículos académicos de dos columnas, las líneas se intercalan, las tablas se convierten en una sopa de palabras, las notas al pie quedan pegadas en medio de una oración y las páginas escaneadas (que son solo imágenes sin texto incrustado) no devuelven nada.
Los Vision language models evitan esto tratando la página como lo haría una persona: como una imagen. Se le muestra al modelo una imagen de la página y se le pide que describa lo que está escrito en ella, en orden. Esto funciona drásticamente mejor que el análisis de diseño (layout parsing) para documentos desordenados, razón por la cual se han estado procesando PDFs a través de GPT-4o y Gemini para OCR. El inconveniente es el costo, la latencia y el hecho de que muchos PDFs (historiales médicos, documentos legales o cualquier archivo con requisitos de confidencialidad) no pueden enviarse a una API de terceros.
Por lo tanto, el verdadero objetivo no es "¿puede un VLM leer un PDF?". Eso ya está comprobado. El objetivo es: ¿puedes obtener una capacidad de lectura de página al nivel de GPT-4o utilizando un modelo pequeño que puedas ejecutar tú mismo, en tu propio hardware, a un costo que convierta el procesamiento de cien millones de páginas en un proyecto de fin de semana en lugar de una partida presupuestaria?
El problema de los datos de entrenamiento: 260,000 páginas, deliberadamente desordenadas
No se puede ajustar un modelo para que lea PDFs correctamente sin ejemplos de entrenamiento donde un modelo ya lo haga bien, y resulta que esa es la parte difícil. El equipo de Ai2 creó olmOCR-mix-0225, un conjunto de datos de 260,000 páginas extraídas de más de 100,000 PDFs rastreados; lo interesante aquí no es el tamaño, sino la composición.
En lugar de seleccionar una muestra limpia y representativa, la cargaron deliberadamente con los documentos que suelen hacer fallar a los sistemas de OCR: páginas con notación matemática densa, tablas con celdas combinadas, anotaciones manuscritas, escaneos de baja calidad con ruido visible y desalineación, formularios y diseños de varias columnas. Generaron el texto de referencia (ground-truth) para estas páginas utilizando el propio GPT-4o (un coste elevado y puntual, ya que solo es necesario hacerlo una vez por ejemplo de entrenamiento y no por cada página en producción) y contaron con revisores humanos para validar la calidad de una parte del conjunto.
Esta es la misma lógica detrás de la mayoría de los proyectos de destilación exitosos: un modelo más pequeño puede igualar el rendimiento de uno más grande en una tarea específica si se utilizan las salidas del modelo mayor como señal de entrenamiento, pero solo si los ejemplos de entrenamiento cubren la distribución real de los casos difíciles que se encontrarán en producción. Un conjunto de datos de PDFs limpios y sencillos habría dado como resultado un modelo excelente para PDFs limpios y sencillos, pero inútil en el momento en que se enfrentara a un recibo fotografiado en ángulo.
Creando un benchmark en el que las herramientas existentes no pudieran destacar
Antes de desarrollar olmOCR, el equipo creó olmOCR-Bench, un conjunto de 1,400 PDFs diseñados bajo una premisa específica: la mayoría de los benchmarks de OCR actuales son demasiado sencillos, ya que predominan los documentos digitales nativos, de una sola columna y limpios, que cualquier herramienta ya procesa correctamente. Si tu benchmark consiste en un 90% de documentos fáciles, una herramienta mediocre parece casi tan buena como una excelente, y resulta imposible distinguir entre los sistemas que realmente marcan la diferencia.
En su lugar, olmOCR-Bench se concentra en las categorías que separan la capacidad real de las promesas comerciales: artículos científicos llenos de ecuaciones, tablas con estructuras irregulares, documentos con fuentes diminutas o inusuales, escaneos antiguos y degradados, y diseños de varias columnas. En vez de calificar el texto extraído frente a una referencia mediante una métrica de similitud de cadenas difusa (que puede premiar a una herramienta por acertar las palabras aunque destruya completamente la estructura del documento), utilizan pruebas unitarias específicas. ¿Se renderiza la ecuación con el LaTeX correcto? ¿Se mantiene la estructura de filas y columnas de la tabla? ¿Se conserva el orden de lectura natural en un diseño de dos columnas? La herramienta supera cada comprobación o no lo hace.
Esto es más importante de lo que parece. Muchas de las comparativas de OCR publicadas realizan sus benchmarks discretamente sobre ese 90% fácil, que es precisamente donde las diferencias entre herramientas son menores y menos útiles de conocer.
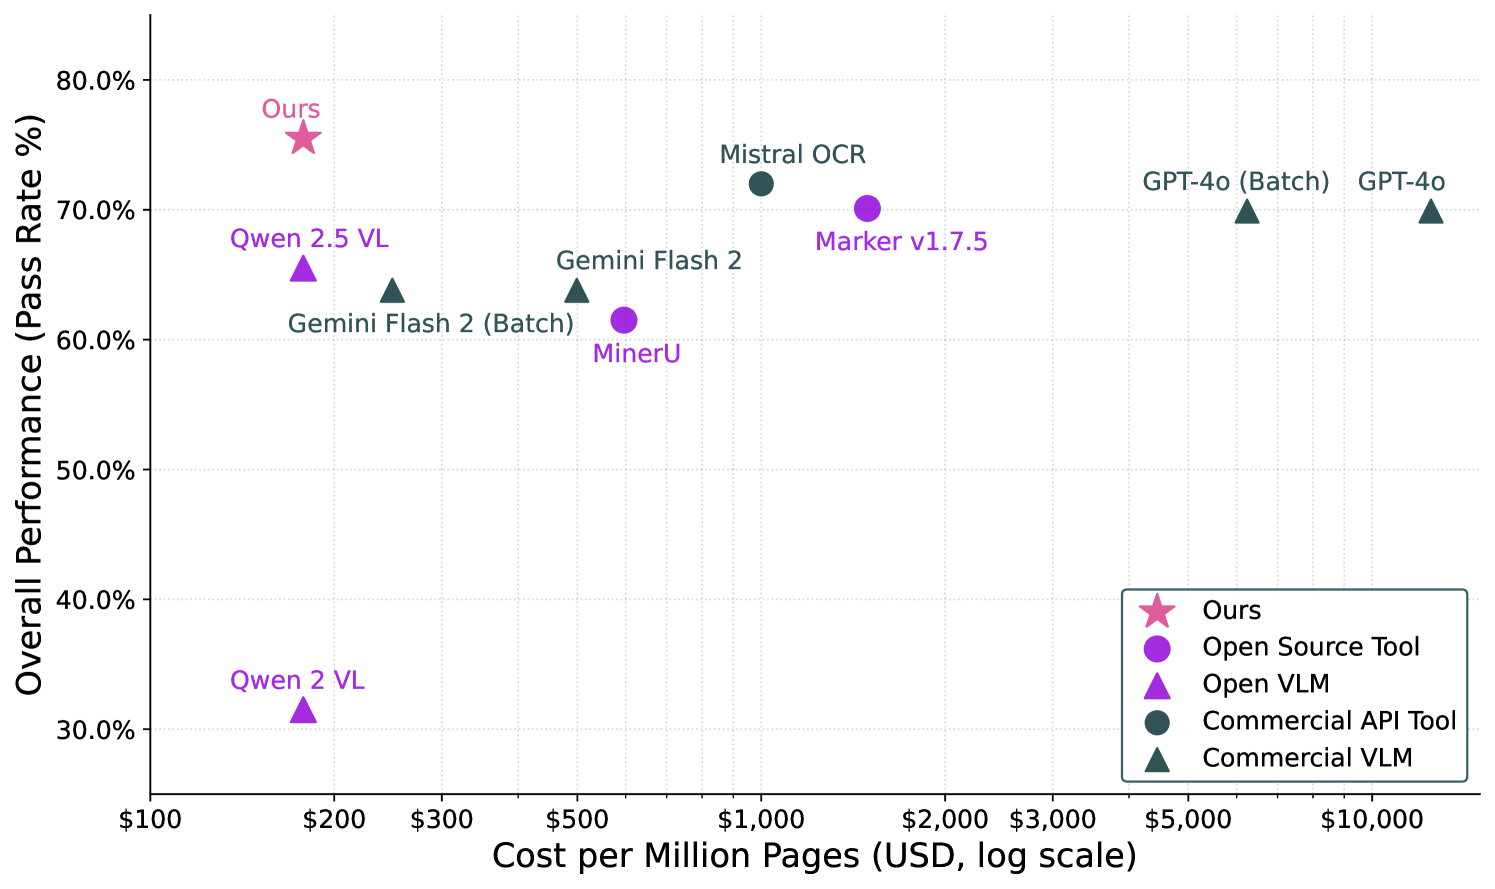
Figura de olmOCR: Unlocking Trillions of Tokens in PDFs with Vision Language Models (Jake Poznanski et al., arXiv:2502.18443), con licencia CC BY 4.0.
Las cifras: olmOCR supera a GPT-4o, Gemini Flash 2 y Qwen-2.5-VL
En olmOCR-Bench, el modelo 7B ajustado (fine-tuned) supera a GPT-4o, Gemini Flash 2 y Qwen-2.5-VL, los modelos de visión de propósito general de los cuales fue destilado. Que un modelo especializado en una sola tarea supere a los modelos generales que lo entrenaron no es un fenómeno nuevo, pero es un punto importante a analizar: el modelo más pequeño no gana por ser "más inteligente" en un sentido general. Gana porque toda su capacidad se dedica a una habilidad específica y bien definida, y los datos de entrenamiento se diseñaron específicamente para cubrir los casos de fallo que dicha habilidad debe superar.
La comparación de costos es el aspecto que realmente cambia lo que es viable. Con un costo aproximado de $6,240 por millón de páginas para GPT-4o frente a $176 por millón de páginas para olmOCR, no se está eligiendo entre algo "asequible" y algo "ligeramente menos asequible". Se está eligiendo entre una herramienta que se puede ejecutar con un presupuesto de investigación y otra que solo se puede justificar para una fracción muy pequeña y de alto valor de los documentos. Esa brecha es lo que hace que frases como "desbloquear billones de tokens" sean más que un eslogan de marketing: con los precios de GPT-4o, la mayor parte del archivo PDF del mundo permanece bloqueada porque ningún presupuesto cubre la lectura total. A $176 por millón de páginas, los proyectos de digitalización masiva, los entrenamientos con corpus completos y los índices de búsqueda de archivos totales se convierten en objetivos que un equipo mediano puede planificar y ejecutar.
El pipeline también está diseñado para el rendimiento masivo (throughput) en lugar de llamadas individuales: es compatible con vLLM y SGLang como backends de inferencia, y está diseñado para escalar en cualquier configuración de GPU en lugar de requerir una configuración específica. Esta es una decisión deliberada pensando en el usuario objetivo: alguien que procesa millones de páginas en lotes (batch), y no alguien que desarrolla una función de carga de un solo documento.
Por qué es importante para cualquiera que desarrolle o elija un sistema de OCR
Si está decidiendo cómo gestionar la extracción de documentos en un producto, olmOCR es la prueba de una premisa específica: para el OCR de alto volumen, un modelo abierto especializado puede superar a un modelo frontier de propósito general tanto en calidad como en coste, siempre que alguien haya realizado el trabajo arduo de construir un conjunto de entrenamiento que cubra los casos más complejos. Esta es una lección distinta a la de que "los modelos pequeños están alcanzando a los grandes" en general. Es una conclusión más acotada y útil: el fine-tuning específico para una tarea sobre datos difíciles y representativos puede superar la escala bruta del modelo, al menos en problemas con una estructura visual tan definida como la lectura de una página.
En la práctica, esto se traduce en tres decisiones reales:
- Si procesa PDFs a gran escala (archivos, corpora de entrenamiento, flujos de documentos con millones de páginas), un modelo autoalojado como olmOCR elimina el coste de API por página que hace que estos proyectos sean caros incluso en fase de prototipo. La diferencia entre $6,240 y $176 por millón de páginas es la diferencia entre "hicimos un piloto con 10,000 páginas" y "procesamos todo el archivo".
- Si sus documentos son sensibles (registros médicos, legales o financieros que no pueden salir de su infraestructura), un modelo que pueda ejecutar usted mismo no es solo más barato, sino que es la única opción que satisface sus requisitos de cumplimiento normativo desde el principio.
- Si está comparando herramientas de OCR para tomar una decisión de compra, pregunte qué está evaluando realmente el benchmark. Una herramienta que obtiene buenos resultados en PDFs limpios de una sola columna, pero malos en tablas escaneadas o artículos académicos multicolumna, se comportará de manera muy distinta según lo que realmente procese. El enfoque de olmOCR-Bench, que pondera deliberadamente los casos difíciles, es la pregunta correcta que debe hacer ante las cifras de cualquier proveedor, incluidas las comparaciones del catálogo de OpenOCR.
Lo que el artículo no resuelve
Los resultados son sólidos, pero es importante ser honestos sobre el alcance. olmOCR-Bench consiste en 1,400 PDFs curados por el mismo equipo que desarrolló el modelo evaluado; y aunque la metodología de unit-test es una mejora real frente al fuzzy string matching, la afirmación de "construimos el benchmark más difícil y luego obtuvimos el mejor resultado" merece un escepticismo saludable hasta que grupos independientes reproduzcan el ranking con sus propios conjuntos de documentos.
Además, se trata de un modelo de 7B parámetros, lo que significa que requiere una infraestructura de GPU real para operar con el throughput que describe el artículo. El costo de $176 por millón de páginas asume que ya posees o puedes alquilar el hardware para ejecutar vLLM o SGLang de manera eficiente; no es un precio que pagas por llamada a la API como ocurre con el pricing de GPT-4o. Para alguien que procesa unos pocos cientos de páginas al mes, las API de frontera podrían seguir siendo la opción más sencilla y económica una vez que se contabiliza el tiempo de ingeniería necesario para montar un pipeline self-hosted. Asimismo, la escritura a mano, los escaneos extremadamente degradados y los documentos en idiomas con pocos recursos siguen figurando en el propio artículo como desafíos abiertos, no como problemas resueltos.
Nada de esto invalida el hallazgo principal. Simplemente significa que la lectura honesta es: "esta es una opción muy potente y económica para el procesamiento de PDFs a gran escala donde controlas la infraestructura", y no "el OCR ya está resuelto y es gratuito". Para el problema específico que aborda —desbloquear grandes volúmenes de texto en PDF sin los costos de una API de frontera— es una pieza de infraestructura abierta genuinamente útil. El hecho de que Ai2 haya liberado el modelo, los datos de entrenamiento y el benchmark, en lugar de solo el artículo, permite que cualquiera pueda verificar estas cifras en lugar de aceptarlas por fe.