आपके PDFs खरबों Tokens के लायक हैं। अधिकांश OCR Pipelines उन्हें बर्बाद कर रहे हैं।
आधारित शोध-पत्र: olmOCR: Unlocking Trillions of Tokens in PDFs with Vision Language Models — Jake Poznanski, Aman Rangapur, Jon Borchardt, Jason Dunkelberger, Regan Huff, Daniel Lin, Aman Rangapur, Christopher Wilhelm, Kyle Lo, Luca Soldaini
एक ऐसा आंकड़ा जो आपको सोचने पर मजबूर कर देगा
एक आंकड़े पर गौर कीजिए: इंटरनेट के हर PDF पेज से क्लीन टेक्स्ट निकालने के लिए अगर आप GPT-4o का इस्तेमाल करते हैं, तो प्रति मिलियन पेजों का खर्च $6,240 से अधिक होगा। अब इसे सरकारी आर्काइव्स, साइंटिफिक जर्नल्स, कोर्ट फाइलिंग्स और पुरानी स्कैन की गई किताबों में मौजूद अरबों PDFs के पैमाने पर देखें, तो इस टेक्स्ट को किसी लैंग्वेज मॉडल या सर्च इंडेक्स के लिए उपयोगी बनाने का बिल करोड़ों डॉलर में पहुँच जाएगा।
Allen Institute for AI (Ai2) की एक टीम ने इस आंकड़े को देखा और एक दिलचस्प सवाल पूछा: क्या होगा अगर आपको GPT-4o की ज़रूरत ही न पड़े? उनका जवाब है olmOCR, एक 7-billion-parameter विज़न मॉडल जिसे खास तौर पर PDFs पढ़ने के लिए fine-tune किया गया है, और यह एक मिलियन पेजों को मात्र $176 में प्रोसेस करता है। यह GPT-4o की कीमत के आसपास भी नहीं है; यह लगभग 35 गुना सस्ता है, और उनके बेंचमार्क के अनुसार, यह अधिक सटीक (accurate) भी है।
यदि आप डॉक्यूमेंट एक्सट्रैक्शन से जुड़ा कोई भी टूल बना रहे हैं, तो इस पेपर को विस्तार से समझना ज़रूरी है, क्योंकि यह पिछले कुछ वर्षों से चल रही एक बहस को खामोशी से सुलझा देता है: क्या PDF को सही ढंग से पढ़ने के लिए एक विशाल, जनरल-पर्पस मॉडल की ज़रूरत है, या एक छोटा और स्पेशलाइज्ड मॉडल इसे बेहतर तरीके से कर सकता है?
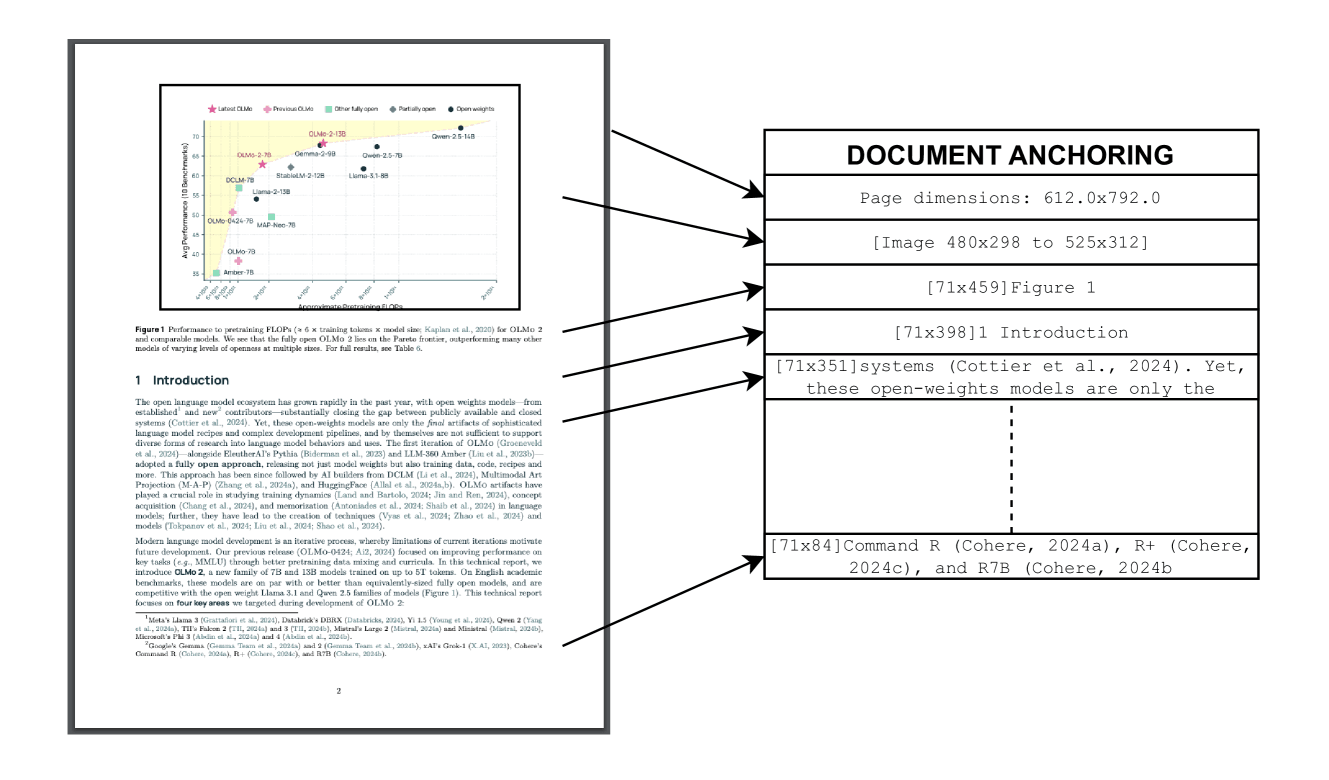
Figure from olmOCR: Unlocking Trillions of Tokens in PDFs with Vision Language Models (Poznanski et al., arXiv:2502.18443), licensed CC BY 4.0.
PDF पढ़ना दिखने में जितना आसान लगता है, असल में उतना है नहीं
एक PDF केवल टेक्स्ट का एक रैपर नहीं होता। यह ड्राइंग निर्देशों (drawing instructions) का एक समूह है: इस कैरेक्टर ग्लिफ (character glyph) को इस x/y कोऑर्डिनेट पर रखें, इस लाइन को यहाँ रखें, और इस इमेज को वहाँ रखें। इसमें "यह एक पैराग्राफ है" या "यह एक टेबल है" या "ऊपर से नीचे, फिर बाएं कॉलम और फिर दाएं कॉलम में पढ़ें" जैसा कोई अंतर्निहित कॉन्सेप्ट नहीं होता। पारंपरिक PDF टेक्स्ट एक्सट्रैक्टर्स (pdftotext, PyMuPDF और अन्य) इन ड्राइंग निर्देशों को पार्स करते हैं और रीडिंग ऑर्डर को फिर से बनाने की कोशिश करते हैं, लेकिन वे अक्सर विफल हो जाते हैं: दो-कॉलम वाले एकेडमिक पेपर्स के कॉलम लाइन-दर-लाइन आपस में मिल जाते हैं, टेबल्स शब्दों के ढेर (word soup) में बदल जाते हैं, फुट नोट्स वाक्य के बीच में चिपक जाते हैं, और स्कैन किए गए पेज (जो केवल इमेज होते हैं और जिनमें कोई एम्बेडेड टेक्स्ट नहीं होता) कुछ भी रिटर्न नहीं करते।
Vision language models इस समस्या को एक इंसान की तरह पेज को एक तस्वीर मानकर हल करते हैं। मॉडल को पेज की एक इमेज दिखाएं और उससे पूछें कि उस पर क्रम के अनुसार क्या लिखा है। अस्त-व्यस्त दस्तावेज़ों के लिए यह तरीका लेआउट पार्सिंग की तुलना में कहीं अधिक बेहतर काम करता है, यही कारण है कि लोग OCR के लिए PDFs को GPT-4o और Gemini के ज़रिए प्रोसेस कर रहे हैं। लेकिन इसमें समस्या लागत (cost), लेटेंसी (latency) और इस तथ्य की है कि कई PDFs (मेडिकल रिकॉर्ड्स, कानूनी दस्तावेज़, या गोपनीयता की आवश्यकता वाली कोई भी चीज़) को किसी थर्ड-पार्टी API पर भेजा ही नहीं जा सकता।
इसलिए असली लक्ष्य यह नहीं है कि "क्या एक VLM PDF पढ़ सकता है।" यह तो सिद्ध हो चुका है। असली लक्ष्य यह है: क्या आप एक छोटे मॉडल से GPT-4o-लेवल की पेज रीडिंग क्षमता प्राप्त कर सकते हैं जिसे आप अपने स्वयं के हार्डवेयर पर चला सकें, और जिसकी लागत इतनी कम हो कि एक करोड़ पेजों को प्रोसेस करना बजट की बड़ी मद बनने के बजाय केवल एक वीकेंड प्रोजेक्ट बनकर रह जाए।
ट्रेनिंग डेटा की समस्या: 260,000 पेज, जानबूझकर अव्यवस्थित
आप किसी मॉडल को PDFs को बेहतर तरीके से पढ़ने के लिए तब तक fine-tune नहीं कर सकते, जब तक आपके पास ऐसे ट्रेनिंग उदाहरण न हों जहाँ मॉडल वास्तव में PDFs को सही ढंग से पढ़ रहा हो, और यही सबसे कठिन हिस्सा साबित होता है। Ai2 टीम ने olmOCR-mix-0225 बनाया, जो 100,000 से अधिक crawled PDFs से लिए गए 260,000 पेजों का एक dataset है। यहाँ दिलचस्प बात इसका आकार नहीं, बल्कि इसकी संरचना (composition) है।
एक साफ-सुथरे और प्रतिनिधि सैंपल को चुनने के बजाय, उन्होंने जानबूझकर इसमें उन दस्तावेज़ों को शामिल किया जो OCR सिस्टम्स को विफल कर देते हैं: जैसे घने math notation वाले पेज, merged cells वाली tables, handwritten annotations, visible speckling और skew वाले लो-क्वालिटी स्कैन्स, फॉर्म्स और multi-column layouts। उन्होंने इन पेजों के लिए ground-truth text खुद GPT-4o का उपयोग करके जनरेट किया (यह एक महंगा, एक बार का खर्च था, क्योंकि इसे प्रति production page के बजाय केवल प्रति training example एक बार करने की आवश्यकता होती है) और गुणवत्ता के लिए इसका एक हिस्सा इंसानों से रिव्यू करवाया।
यही सोच अधिकांश सफल distillation प्रोजेक्ट्स के पीछे भी है: यदि आप एक छोटे मॉडल को ट्रेनिंग सिग्नल के रूप में बड़े मॉडल के आउटपुट देते हैं, तो वह एक विशिष्ट कार्य (narrow task) में बड़े मॉडल की बराबरी कर सकता है, लेकिन यह तभी संभव है जब आपके ट्रेनिंग उदाहरण उन कठिन मामलों (hard cases) के वास्तविक वितरण (distribution) को कवर करें जो production में सामने आएंगे। आसान और साफ PDFs के dataset से एक ऐसा मॉडल तैयार होता जो आसान और साफ PDFs के लिए तो बेहतरीन होता, लेकिन जैसे ही उसके सामने किसी तिरछे एंगल से खींची गई रसीद (receipt) आती, वह बेकार हो जाता।
एक ऐसा बेंचमार्क बनाना जिसमें मौजूदा टूल्स के अच्छा प्रदर्शन करने की गुंजाइश न हो
olmOCR बनाने से पहले, टीम ने olmOCR-Bench तैयार किया, जो 1,400 PDFs का एक सेट है। इसे एक खास विचार के आधार पर बनाया गया था: अधिकांश मौजूदा OCR benchmarks बहुत आसान होते हैं, क्योंकि उनमें ज्यादातर साफ-सुथरे, सिंगल-कॉलम और born-digital दस्तावेज़ होते हैं जिन्हें हर टूल आसानी से हैंडल कर लेता है। यदि आपके बेंचमार्क में 90% दस्तावेज़ आसान हैं, तो एक खराब टूल भी लगभग एक बेहतरीन टूल जैसा ही दिखता है, और आप उन सिस्टम्स के बीच का अंतर नहीं पहचान पाते जो वास्तव में मायने रखते हैं।
इसके बजाय, olmOCR-Bench उन श्रेणियों पर ध्यान केंद्रित करता है जो वास्तविक क्षमता और मार्केटिंग दावों के बीच अंतर स्पष्ट करती हैं: समीकरणों (equations) से भरे वैज्ञानिक शोध पत्र, अनियमित संरचना वाली टेबल, बहुत छोटे या असामान्य फोंट वाले दस्तावेज़, पुराने और खराब हो चुके स्कैन्स, और मल्टी-कॉलम लेआउट। निकाले गए टेक्स्ट को किसी रेफरेंस के साथ fuzzy string-similarity metric के जरिए स्कोर करने के बजाय (जो किसी टूल को केवल शब्दों को सही लिखने के लिए रिवॉर्ड दे सकता है, भले ही उसने दस्तावेज़ की संरचना को पूरी तरह नष्ट कर दिया हो), वे लक्षित unit tests का उपयोग करते हैं। क्या समीकरण सही LaTeX के साथ रेंडर होता है? क्या टेबल की रो (row) और कॉलम संरचना बरकरार रहती है? क्या टू-कॉलम लेआउट में नेचुरल रीडिंग ऑर्डर बना रहता है? एक टूल या तो प्रत्येक चेक को पास करता है या नहीं।
यह बात सुनने में जितनी साधारण लगती है, उससे कहीं अधिक महत्वपूर्ण है। प्रकाशित होने वाले कई OCR तुलनात्मक अध्ययन चुपचाप उसी आसान 90% हिस्से पर बेंचमार्किंग करते हैं, जहाँ टूल्स के बीच का अंतर सबसे कम होता है और जिसके बारे में जानना सबसे कम उपयोगी होता है।
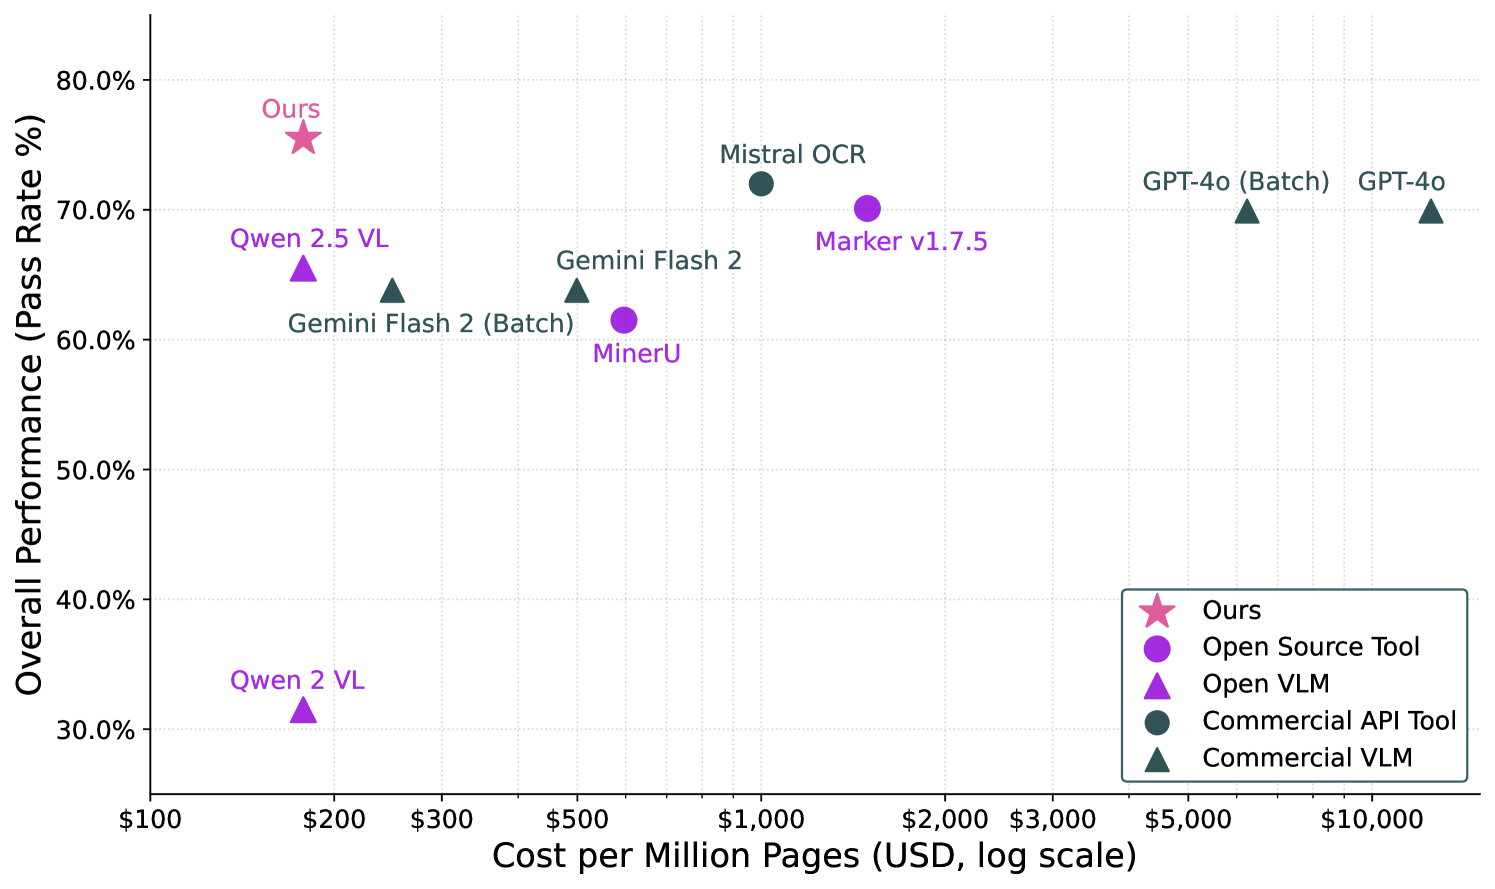
olmOCR: Unlocking Trillions of Tokens in PDFs with Vision Language Models से आकृति (जेक पोज़्नानस्की और अन्य, arXiv:2502.18443), CC BY 4.0 लाइसेंस के अधीन।
आंकड़े: olmOCR ने GPT-4o, Gemini Flash 2 और Qwen-2.5-VL को पीछे छोड़ा
olmOCR-Bench पर, फाइन-ट्यून्ड 7B मॉडल ने GPT-4o, Gemini Flash 2 और Qwen-2.5-VL जैसे जनरल-पर्पज विजन मॉडल्स को मात दी है, जिनसे इसे डिस्टिल (distill) किया गया था। किसी एक विशेष कार्य के लिए बनाया गया स्पेशलाइज्ड मॉडल उन जनरल मॉडल्स से बेहतर प्रदर्शन करे जिन्होंने उसे ट्रेन किया है, यह कोई नई बात नहीं है, लेकिन इस पर गौर करना जरूरी है: छोटा मॉडल इसलिए नहीं जीत रहा है क्योंकि वह सामान्य तौर पर अधिक स्मार्ट है। यह इसलिए जीत रहा है क्योंकि इसकी पूरी क्षमता एक संकीर्ण और स्पष्ट रूप से परिभाषित कौशल (skill) पर केंद्रित है, और इसके ट्रेनिंग डेटा को विशेष रूप से उन फेलियर मोड्स (failure modes) को कवर करने के लिए बनाया गया था जिन्हें इस कौशल को निखारने के लिए जरूरी था।
लागत (cost) की तुलना वह हिस्सा है जो वास्तव में संभावनाओं को बदल देता है। GPT-4o के लिए प्रति मिलियन पेज लगभग $6,240 के मुकाबले olmOCR के लिए $176 की लागत का मतलब है कि आप "किफायती" और "थोड़ा कम किफायती" के बीच चुनाव नहीं कर रहे हैं। आप एक ऐसे टूल के बीच चुनाव कर रहे हैं जिसे आप एक रिसर्च बजट पर चला सकते हैं, और एक ऐसे टूल के बीच जिसे आप केवल अपने दस्तावेजों के एक छोटे और उच्च-मूल्य वाले हिस्से के लिए ही उचित ठहरा सकते हैं। यही वह अंतर है जो "ट्रिलियंस ऑफ टोकन्स को अनलॉक करने" जैसे वाक्यांशों को केवल एक मार्केटिंग हेडलाइन से कहीं अधिक बनाता है: GPT-4o की कीमतों पर, दुनिया का अधिकांश PDF आर्काइव बंद ही रहता है, क्योंकि किसी का भी बजट इसे पूरा पढ़ने का खर्च नहीं उठा सकता। $176 प्रति मिलियन पेज की दर पर, मास डिजिटाइजेशन प्रोजेक्ट्स, होल-कॉर्पस ट्रेनिंग रन और फुल-आर्काइव सर्च इंडेक्स ऐसी चीजें बन जाती हैं जिन्हें एक मध्यम आकार की टीम वास्तव में प्लान कर सकती है और लागू कर सकती है।
इस पाइपलाइन को वन-ऑफ कॉल्स के बजाय थ्रूपुट (throughput) के लिए बनाया गया है: यह इन्फरेंस बैकएंड के रूप में vLLM और SGLang दोनों को सपोर्ट करता है, और इसे किसी एक विशिष्ट कॉन्फ़िगरेशन की आवश्यकता के बजाय आपके पास मौजूद किसी भी GPU सेटअप पर स्केल करने के लिए डिज़ाइन किया गया है। यह लक्षित उपयोगकर्ता (target user) के लिए एक जानबूझकर लिया गया निर्णय है, जो कि वह व्यक्ति है जो बैच में लाखों पेजों को प्रोसेस कर रहा है, न कि वह जो केवल सिंगल-डॉक्यूमेंट अपलोड फीचर बना रहा है।
OCR बनाने या चुनने वालों के लिए यह क्यों महत्वपूर्ण है
यदि आप अपने प्रोडक्ट में डॉक्यूमेंट एक्सट्रैक्शन (document extraction) को हैंडल करने का तरीका तय कर रहे हैं, तो olmOCR एक खास दावे को साबित करता है: हाई-वॉल्यूम OCR के लिए, एक स्पेशलाइज्ड ओपन मॉडल क्वालिटी और कॉस्ट दोनों के मामले में जनरल-पर्पस फ्रंटियर मॉडल को मात दे सकता है, बशर्ते किसी ने उन कठिन और 'ugly' केसेस को कवर करने वाला ट्रेनिंग सेट बनाने की मेहनत की हो। यह इस सामान्य धारणा से अलग सबक है कि "छोटे मॉडल्स अब बड़े मॉडल्स की बराबरी कर रहे हैं।" यह अधिक सटीक और उपयोगी है: कठिन और रिप्रजेंटेटिव डेटा पर टास्क-स्पेसिफिक फाइन-ट्यूनिंग, रॉ मॉडल स्केल (raw model scale) से बेहतर प्रदर्शन कर सकती है, खासकर उन समस्याओं के लिए जो पेज रीडिंग की तरह विजुअली स्ट्रक्चर्ड होती हैं। यहाँ यह ध्यान रखना जरूरी है कि अंग्रेजी OCR में अच्छी परफॉरमेंस का मतलब यह नहीं है कि देवनागरी जैसे जटिल स्क्रिप्ट्स का OCR भी उतना ही सटीक होगा।
प्रैक्टिकल तौर पर, इसके तीन मुख्य निर्णय निकलते हैं:
- यदि आप बड़े पैमाने पर PDFs प्रोसेस कर रहे हैं (जैसे आर्काइव्स, ट्रेनिंग कॉर्पोरा, या लाखों पेजों वाली डॉक्यूमेंट पाइपलाइन्स), तो olmOCR जैसा सेल्फ-होस्टेड मॉडल प्रति-पेज API कॉस्ट को खत्म कर देता है, जिसकी वजह से अक्सर ऐसे प्रोजेक्ट्स का प्रोटोटाइप बनाना भी महंगा हो जाता है। प्रति मिलियन पेजों पर $6,240 और $176 के बीच का अंतर यह तय करता है कि आप सिर्फ "10,000 पेजों पर पायलट रन" करेंगे या "पूरे आर्काइव को प्रोसेस" करेंगे।
- यदि आपके डॉक्यूमेंट्स संवेदनशील हैं (जैसे मेडिकल, लीगल या फाइनेंशियल रिकॉर्ड्स जो आपके इंफ्रास्ट्रक्चर से बाहर नहीं जा सकते), तो खुद का चलाया गया मॉडल न केवल सस्ता है, बल्कि यह एकमात्र विकल्प है जो आपकी कंप्लायंस (compliance) आवश्यकताओं को पूरा करता है।
- यदि आप खरीदारी के फैसले के लिए OCR टूल्स की बेंचमार्किंग कर रहे हैं, तो यह पूछें कि बेंचमार्क वास्तव में क्या टेस्ट कर रहा है। एक टूल जो क्लीन सिंगल-कॉलम PDFs पर अच्छा स्कोर करता है लेकिन स्कैन किए गए टेबल्स या मल्टी-कॉलम एकेडेमिक पेपर्स पर फेल हो जाता है, वह आपके वास्तविक डेटा के आधार पर बिल्कुल अलग व्यवहार करेगा। olmOCR-Bench का अप्रोच, जो जानबूझकर कठिन केसेस को ज्यादा वेटेज देता है, किसी भी वेंडर के नंबर्स (OpenOCR के कैटलॉग कंपैरिजन सहित) से पूछने वाला सही सवाल है।
पेपर किन समस्याओं को हल नहीं करता
परिणाम प्रभावशाली हैं, लेकिन इसकी सीमाओं के बारे में ईमानदार होना ज़रूरी है। olmOCR-Bench में 1,400 PDFs शामिल हैं जिन्हें उसी टीम ने तैयार किया है जिसने उस मॉडल को बनाया है जिसका मूल्यांकन किया जा रहा है। हालांकि unit-test methodology, fuzzy string matching की तुलना में एक वास्तविक सुधार है, लेकिन "हमने सबसे कठिन बेंचमार्क बनाया और फिर उसी में सबसे अच्छा प्रदर्शन किया" ऐसा दावा तब तक संदेह के घेरे में रहता है जब तक कि स्वतंत्र समूह अपने स्वयं के डॉक्यूमेंट सेट्स पर इस रैंकिंग को दोबारा साबित न कर दें।
यह मॉडल एक 7B parameter मॉडल है, जिसका अर्थ है कि पेपर में बताए गए throughput पर चलाने के लिए इसे वास्तविक GPU infrastructure की आवश्यकता होगी। प्रति मिलियन पेज $176 की लागत इस धारणा पर आधारित है कि आपके पास पहले से हार्डवेयर उपलब्ध है या आप vLLM या SGLang को कुशलतापूर्वक चलाने के लिए उसे किराए पर ले सकते हैं; यह GPT-4o pricing की तरह प्रति API कॉल भुगतान करने वाली कीमत नहीं है। महीने में कुछ सौ पेज प्रोसेस करने वाले व्यक्ति के लिए, self-hosted pipeline सेटअप करने में लगने वाले इंजीनियरिंग समय को देखते हुए, frontier API अभी भी एक सरल और सस्ता विकल्प हो सकता है। इसके अलावा, handwriting, अत्यधिक खराब स्कैन्स और low-resource languages वाले दस्तावेज़ पेपर में अभी भी खुली चुनौतियों के रूप में सूचीबद्ध हैं, न कि हल की गई समस्याओं के रूप में।
इनमें से कोई भी बात मुख्य निष्कर्ष को कम नहीं करती। इसका सीधा और ईमानदार मतलब यह है कि "यह बड़े पैमाने पर PDF processing के लिए एक बहुत शक्तिशाली और सस्ता विकल्प है जहाँ इंफ्रास्ट्रक्चर पर आपका नियंत्रण हो," न कि यह कि "OCR अब पूरी तरह हल हो चुका है और मुफ्त है।" जिस विशिष्ट समस्या को यह लक्षित करता है—बिना frontier-API pricing के बड़ी मात्रा में PDF टेक्स्ट को अनलॉक करना—उसके लिए यह वास्तव में एक उपयोगी open infrastructure है। और यह तथ्य कि Ai2 ने केवल पेपर के बजाय मॉडल, training data और benchmark को रिलीज़ किया है, इसका मतलब है कि कोई भी इन आंकड़ों को केवल विश्वास करने के बजाय स्वयं सत्यापित कर सकता है।