あなたのPDFには数兆トークンの価値がある。しかし、ほとんどのOCRパイプラインはそれを捨てている。
元論文: olmOCR: Unlocking Trillions of Tokens in PDFs with Vision Language Models — Jake Poznanski, Aman Rangapur, Jon Borchardt, Jason Dunkelberger, Regan Huff, Daniel Lin, Aman Rangapur, Christopher Wilhelm, Kyle Lo, Luca Soldaini
PDF抽出のコスト革命
スクロールする手を止めて、この数字に注目してください。インターネット上のすべてのPDFページをGPT-4oに通してクリーンなテキストを抽出する場合、100万ページあたり6,240ドル以上のコストがかかります。これを政府のアーカイブ、学術誌、裁判資料、古いスキャン本など、数億、数兆ページに及ぶPDFに適用すれば、言語モデルや検索インデックスで利用可能な形式にするだけで、数千万ドルという莫大な請求書が届くことになります。
Allen Institute for AI (Ai2) のチームはこの数字を見て、より興味深い問いを立てました。「そもそもGPT-4oが必要なのだろうか?」ということです。彼らが導き出した答えが olmOCR です。これはPDFの読み取りに特化してファインチューニングされた70億パラメータのビジョンモデルで、100万ページの処理コストはわずか176ドルです。これはGPT-4oの価格と「誤差」で済むレベルではありません。約35倍も安く、しかも彼らのベンチマークによれば、精度においても上回っています。
ドキュメント抽出に関わる開発をしているのであれば、この論文は詳細まで読み込む価値があります。なぜなら、ここ数年続いていた「PDFを適切に読み取るには巨大な汎用モデルが必要なのか、それとも小型の特化型モデルの方が優れた成果を出せるのか」という議論に、静かに終止符を打つ内容だからです。
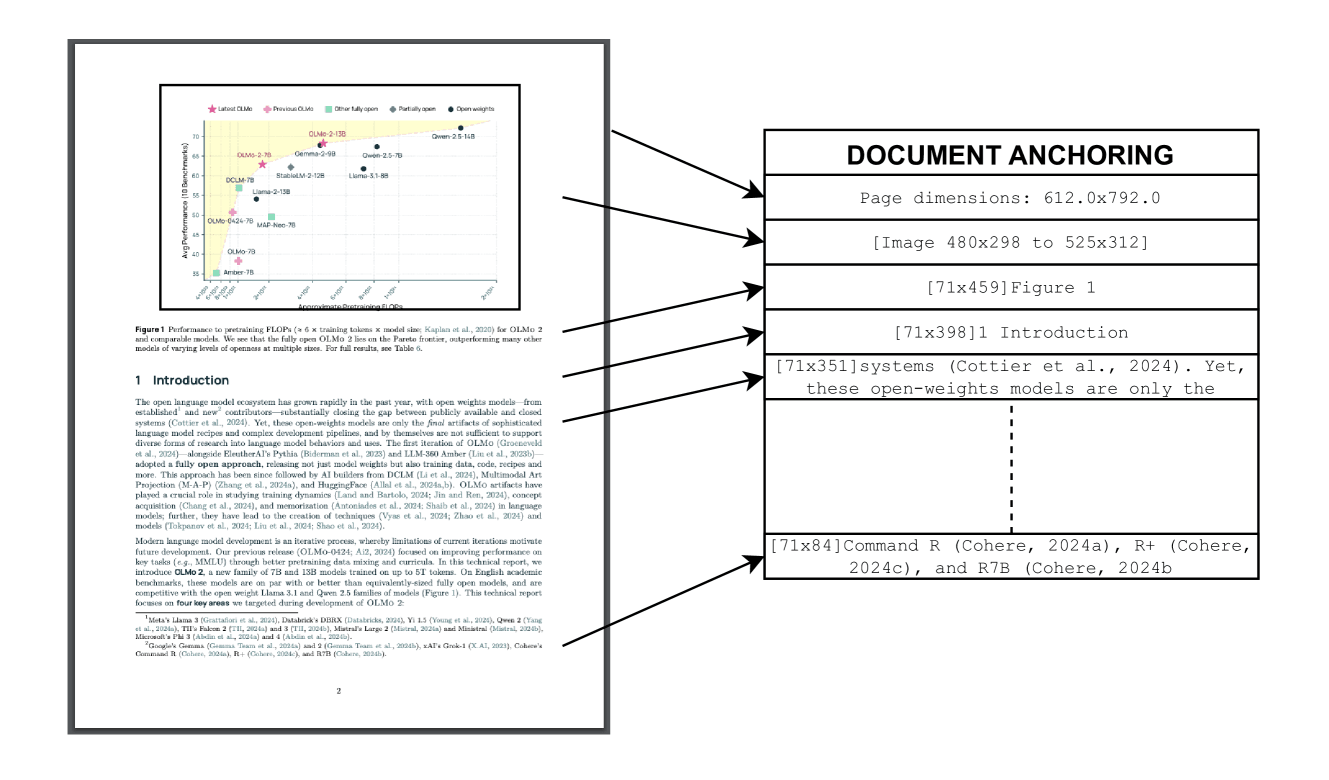
Figure from olmOCR: Unlocking Trillions of Tokens in PDFs with Vision Language Models (Poznanski et al., arXiv:2502.18443), licensed CC BY 4.0.
PDFの読み取りが想定以上に困難な理由
PDFとは、単にテキストをラップしたものではありません。それは「この文字グリフをこのx/y座標に配置せよ」「ここに線を引け」「ここに画像を置け」といった描画命令の集合体です。そこには「ここが段落である」とか「ここが表である」、あるいは「上から下へ読み、次に左列、そして右列へ進む」といった概念は本来存在しません。従来のPDFテキスト抽出ツール(pdftotextやPyMuPDFなど)は、これらの描画命令を解析して読書順を再構築しようとしますが、頻繁に破綻します。例えば、2段組みの学術論文では列が一行おきに混ざり合い、表は単なる単語の羅列になり、脚注が文章の途中に挿入され、さらに(埋め込みテキストが一切ない単なる画像である)スキャンされたページからは何も抽出できません。
Vision language models(VLM)は、ページを人間と同じように「一枚の画像」として扱うことで、この問題を回避します。モデルにページの画像を見せ、そこに何が書かれているかを順番に説明させるのです。この手法は、レイアウト解析よりも複雑なドキュメントに対して劇的に高い効果を発揮します。だからこそ、多くの人々がOCRのためにPDFをGPT-4oやGeminiに流し込んできたわけです。しかし、課題はコストとレイテンシ、そして機密保持が求められる多くのPDF(医療記録や法的文書など)をサードパーティのAPIに送信できないという点にあります。
したがって、真の目標は「VLMがPDFを読めるか」ということではありません。それはすでに証明済みです。真の目標は、GPT-4oレベルのページ読み取り能力を、自前のハードウェアで動作する小型モデルで実現し、1億ページを処理することが「予算項目」ではなく「週末のプロジェクト」で済むほどの低コストで実現できるか、ということです。
学習データの課題:意図的に「乱雑」に構成された26万ページ
PDFを適切に読み取れるモデルをファインチューニングするには、モデルがPDFを適切に読み取っている学習例が必要ですが、ここが最も困難な部分となります。Ai2チームは、10万件以上のクロール済みPDFから抽出した26万ページからなるデータセット「olmOCR-mix-0225」を構築しました。注目すべきは、その規模ではなく「構成」です。
彼らは、クリーンで代表的なサンプルを厳選するのではなく、あえてOCRシステムが苦手とするドキュメントを大量に組み込みました。具体的には、高密度の数式、セル結合を含む表、手書きの注釈、ノイズや傾きのある低品質なスキャンデータ、フォーム、そして多段組みレイアウトなどです。これらのページの正解テキスト(ground-truth)はGPT-4oを用いて生成されました(これは一度きりのコストであり、本番環境のページごとではなく、学習例ごとに一度だけ行えばよいため、許容可能な費用です)。また、品質確保のために一部のデータには人間によるレビューを導入しました。
これは、多くの成功した蒸留(distillation)プロジェクトに共通する洞察です。つまり、大きなモデルの出力を学習信号として与えれば、小さなモデルでも特定の狭いタスクにおいて大きなモデルに匹敵する性能を持たせることができます。ただし、それは学習例が、本番環境で遭遇するであろう「困難なケース」の分布を十分にカバーしている場合に限られます。簡単でクリーンなPDFだけのデータセットで学習させた場合、クリーンなPDFには強いものの、斜めに撮影されたレシートのようなデータに直面した瞬間に使い物にならないモデルになっていたでしょう。
既存のツールが太刀打ちできないベンチマークの構築
olmOCRを開発する前に、チームはまずolmOCR-Benchを構築しました。これは1,400件のPDFで構成されたデータセットで、「既存のOCRベンチマークの多くは簡単すぎる」という特定の考えに基づいて設計されています。なぜなら、多くのベンチマークは、どのツールでも十分に処理できる「クリーンで、1段組みの、デジタル作成されたドキュメント」が中心だからです。ベンチマークの90%が簡単なドキュメントであれば、性能の低いツールでも優れたツールとほぼ同じ結果が出てしまい、本当に重要なシステム間の差異を判別することができません。
そこでolmOCR-Benchでは、実際の能力とマーケティング上の主張を分けるカテゴリーに焦点を当てました。具体的には、数式が多用された学術論文、不規則な構造のテーブル、極小または特殊なフォントのドキュメント、劣化して古いスキャンデータ、そして多段組みのレイアウトなどです。また、抽出したテキストを曖昧な文字列類似度メトリクスで参照データと比較するのではなく(これでは、ドキュメント構造を完全に破壊していても単語さえ合っていれば高得点になってしまうため)、ターゲットを絞ったユニットテストを採用しています。「数式が正しいLaTeXでレンダリングされているか?」「テーブルの行と列の構造が維持されているか?」「2段組みレイアウトにおいて自然な読書順が保たれているか?」といったチェック項目に対し、パスするかしないかで判定します。
これは、一見地味に聞こえるかもしれませんが、極めて重要なことです。公開されている多くのOCR比較検証では、密かに「簡単な90%」でベンチマークが行われています。しかし、そここそがツール間の差が最も小さく、知る価値が最も低い領域なのです。
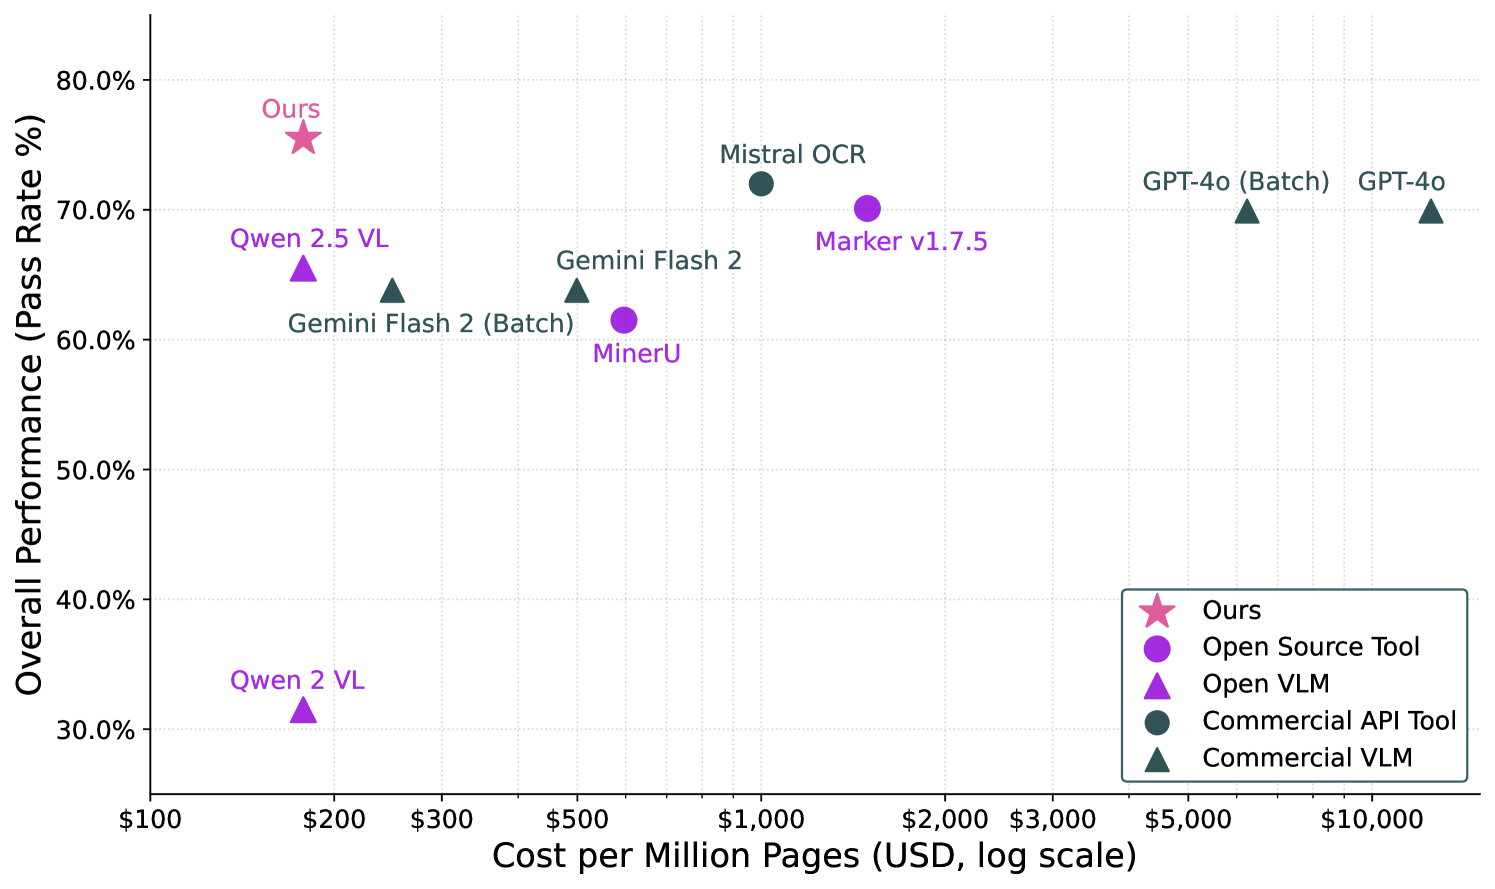
olmOCR: Unlocking Trillions of Tokens in PDFs with Vision Language Models(Jake Poznanski 他, arXiv:2502.18443)からの図、CC BY 4.0 ライセンス。
数値で見る性能:olmOCRがGPT-4o、Gemini Flash 2、Qwen-2.5-VLを凌駕
olmOCR-Benchにおいて、ファインチューニングされた7Bモデルは、蒸留元となった汎用ビジョンモデルであるGPT-4o、Gemini Flash 2、Qwen-2.5-VLを上回る性能を示しました。特定のタスクに特化したモデルが、その学習元となった汎用モデルを上回ることは珍しい現象ではありませんが、注目すべき点があります。この小型モデルが勝利したのは、汎用的な意味で「賢い」からではありません。モデルの全容量を一つの狭く明確に定義されたスキルに投入し、さらにそのスキルが直面する失敗パターンを網羅するようにトレーニングデータを構築した結果なのです。
実際に何が可能になるかを決定づけるのは、コストの比較です。GPT-4oが100万ページあたり約6,240ドルであるのに対し、olmOCRは約176ドルです。これは単に「手頃か、少し高くつくか」という選択ではありません。「研究予算で運用できるツール」か、「極めて価値の高い一部の文書にしか適用できないツール」かという選択です。この圧倒的な差こそが、「数兆トークンの解放」という言葉を単なるマーケティング文句以上のものにします。GPT-4oの価格設定では、予算的に全ページを読み込ませることは不可能なため、世界中のPDFアーカイブの大部分は「ロックされたまま」となります。しかし、100万ページあたり176ドルであれば、大規模なデジタル化プロジェクトやコーパス全体のトレーニング、アーカイブ全域の検索インデックス作成などが、中規模のチームでも実際に計画し、実行できる現実的な目標となります。
また、このパイプラインは単発のAPIコールではなく、スループットを重視して構築されています。推論バックエンドとしてvLLMとSGLangの両方をサポートしており、特定の構成に依存せず、保有しているあらゆるGPUセットアップに合わせてスケールするように設計されています。これは、単一文書のアップロード機能を実装したいユーザーではなく、数百万ページをバッチ処理したいというターゲットユーザーを想定した意図的な設計です。
OCRの構築や選定においてこれが重要である理由
製品におけるドキュメント抽出の手法を検討している方にとって、olmOCRは一つの重要な証明となります。それは、「大量のOCR処理を行う場合、地道な作業で『厄介なケース』を網羅したトレーニングセットを構築さえすれば、特化したオープンモデルが品質とコストの両面で汎用的なフロンティアモデルを凌駕できる」ということです。これは単に「小型モデルが大型モデルに追いつきつつある」という一般的な話とは異なります。より限定的で実用的な教訓、つまり「ページ読み取りのような視覚的構造を持つ問題においては、モデルの規模を追うよりも、代表的な難解データを用いたタスク特化型のファインチューニングの方が効果的である」という点にあります。なお、本手法は主に横書きを想定しているため、日本語特有の縦書きレイアウトや複雑な漢字の組み合わせへの対応については別途検証が必要です。
実務上のポイントは、以下の3つの判断基準に集約されます。
- PDFを大規模に処理する場合(アーカイブ、学習コーパス、数百万ページ規模のドキュメントパイプラインなど):olmOCRのようなセルフホスト型モデルを導入すれば、プロトタイプ作成さえ困難にする「ページごとのAPIコスト」を排除できます。100万ページあたり6,240ドルかかるか、176ドルで済むかの差は、「1万ページでパイロット運用して終了」にするか、「アーカイブ全体を処理しきるか」という決定的な差になります。
- 機密性の高いドキュメントを扱う場合(インフラ外に出せない医療、法務、財務記録など):自前で運用可能なモデルは、単にコストが安いだけでなく、コンプライアンス要件を満たすための唯一の選択肢となります。
- 導入検討のためにOCRツールのベンチマークを比較する場合:そのベンチマークが「実際に何をテストしているのか」を確認してください。クリーンな1段組みPDFでは高得点だが、スキャンされた表や多段組みの学術論文では低得点というツールは、入力データによって挙動が激変します。あえて難解なケースに重点を置いたolmOCR-Benchのアプローチは、OpenOCR自身のカタログ比較を含め、あらゆるベンダーが提示する数値に対して投げかけるべき正しい問いと言えます。
本論文で解決されていない点
結果は強力ですが、その適用範囲について正直に検討しておく価値があります。olmOCR-Benchは、評価対象となるモデルを構築したチーム自身によってキュレーションされた1,400件のPDFで構成されています。ユニットテストの手法は、曖昧な文字列照合(fuzzy string matching)よりも確実に改善されていますが、「自分たちで最も困難なベンチマークを作成し、そこで最高成績を収めた」という主張は、独立したグループが独自のドキュメントセットでランキングを再現するまで、ある程度の懐疑心を持って接すべきでしょう。
また、このモデルは7Bパラメータのモデルであるため、論文に記載されているスループットで動作させるには、本格的なGPUインフラストラクチャが必要です。「100万ページあたり176ドル」というコストは、vLLMやSGLangを効率的に動作させるハードウェアを既に所有しているか、レンタルできることを前提としています。GPT-4oの価格設定のように、APIコールごとに支払う料金ではありません。月に数百ページ程度を処理するユーザーにとっては、セルフホストのパイプラインを構築するためのエンジニアリング時間を考慮すると、依然として最先端のAPIを利用する方がシンプルで安価な選択肢となる可能性があります。さらに、手書き文字、極端に劣化しているスキャンデータ、およびリソースの少ない言語(low-resource languages)のドキュメントについては、論文内でも解決済みの問題ではなく、依然として「今後の課題」として挙げられています。
とはいえ、これらの点は核心となる知見を損なうものではありません。正当な解釈としては、「OCRが完全に解決され、無料になった」ということではなく、「インフラを自前で管理できる環境において、大規模なPDF処理を行うための非常に強力かつ安価な選択肢が現れた」ということです。最先端APIの価格を気にせず大量のPDFテキストを抽出するという特定の課題に対して、これは真に有用なオープンインフラストラクチャと言えます。そして、Ai2が単に論文を出すだけでなく、モデル、トレーニングデータ、およびベンチマークを公開したことで、誰もが数値を鵜呑みにせず、自ら検証することが可能になりました。