TextMonkey: تعليم نموذج Vision-Language Model الإشارة إلى السطر الذي قرأه للتو
استنادًا إلى: TextMonkey: An OCR-Free Large Multimodal Model for Understanding Document — Yuliang Liu, Biao Yang, Qiang Liu, Zhang Li, Zhiyin Ma, Shuo Zhang, Xiang Bai
ما وراء مجرد الإجابة
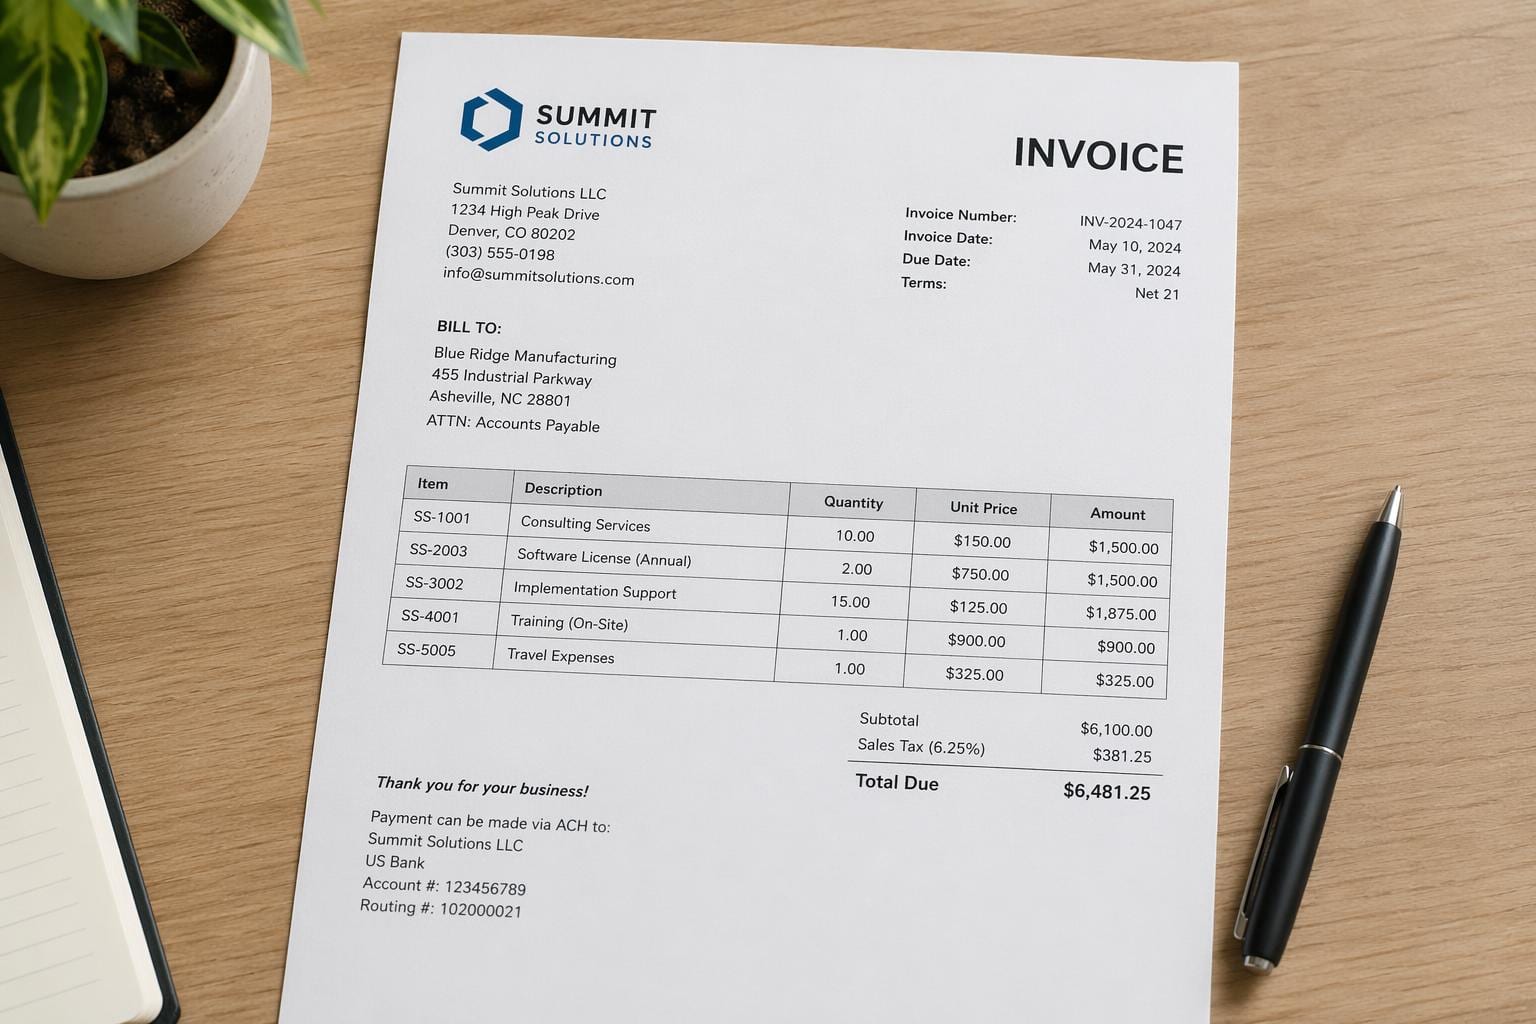
إذا سألت معظم أدوات الذكاء الاصطناعي المخصصة للمستندات "ما هو الإجمالي في هذه الفاتورة؟"، فستحصل على رقم كإجابة. لكن لا توجد وسيلة للتحقق من صحته، ولا طريقة لمعرفة ما إذا كان النموذج قد قرأ الصف الرابع أم أنه التقط عن طريق الخطأ مبلغاً فرعياً من الصف السابع؛ عليك فقط أن تثق بالنتيجة.
لكن TextMonkey، وهو بحث نُشر عام 2024 من جامعة Huazhong University of Science and Technology، يقدم نهجاً أكثر فائدة: فهو يجيب على السؤال ويرسم مربعاً حول النص الدقيق الذي استند إليه للوصول إلى تلك الإجابة. فإذا طلبت منه البحث عن كلمة معينة، لن يكتفي بقول "نعم، إنها موجودة"، بل سيعطيك إحداثياتها بدقة. قد يبدو هذا مجرد ميزة بسيطة، لكنه في الواقع رهان هيكلي حول كيفية عمل هذه النماذج، وهو الجزء الأكثر إثارة للاهتمام في هذا البحث.
الطريقة القديمة: التعرف الضوئي أولاً، ثم الفهم ثانياً
لسنوات طويلة، كانت عملية "قراءة" المستندات بواسطة الذكاء الاصطناعي تعتمد على مسار عمل مكون من خطوتين. الخطوة الأولى: يقوم محرك OCR (مثل Tesseract أو أدوات أكثر تطوراً) بتحويل البكسلات إلى سلاسل نصية. الخطوة الثانية: يقوم نموذج لغوي بقراءة هذه النصوص والإجابة على الأسئلة المتعلقة بها.
تكمن المشكلة في أن الخطوة الأولى تشكل "عنق زجاجة" يفتقر إلى أي ذاكرة للصورة الأصلية. فبمجرد أن يحول الـ OCR فاتورتك إلى سلسلة من الحروف، يفقد النموذج بالفعل التنسيق، وهيكل الجداول، وحجم الخط الذي يحدد السطر الرئيسي، والسياق البصري الذي يخبر القارئ البشري بأن "هذا الرقم مكتوب بخط عريض وموجود داخل مربع، لذا فهو على الأرجح المجموع الكلي". وإذا أخطأ محرك OCR في قراءة حرف أو أغفل سطراً كاملاً، فلن يدرك النموذج اللغوي أبداً أن هناك شيئاً قد فُقد، بل سيجيب بكل ثقة بناءً على مدخلات خاطئة.
ينتمي TextMonkey إلى عائلة جديدة من النماذج "الخالية من OCR" (OCR-free) التي تتجاوز الخطوة الأولى تماماً. حيث ينظر النموذج مباشرة إلى صورة المستند ويقوم بتوليد النص والهيكل والإجابات دفعة واحدة، تماماً كما تلقي نظرة سريعة على إيصال وتعرف المجموع الكلي دون الحاجة إلى نسخ كل حرف بشكل واعٍ أولاً. هذه الفكرة ليست جديدة بحلول عام 2024، ولكن TextMonkey يدفع بها إلى آفاق أبعد من حيث الدقة (resolution)، والكفاءة، والجزء المبتكر حقاً وهو القدرة على الإشارة (the ability to point).
لماذا تتسبب صور المستندات في تعطل نماذج الرؤية الحاسوبية العادية
لقد تم بناء وضبط معظم نماذج الرؤية واللغة (Vision-language models) للتعامل مع الصور الفوتوغرافية: مثل كلب على الشاطئ، أو طبق طعام، أو مشهد شارع. أما المستندات فهي حالة مختلفة تماماً.
فالصورة الفوتوغرافية قد تظل واضحة حتى لو تم ضغطها إلى 224x224 بكسل؛ حيث يمكنك حينها معرفة أن الصورة لكلب. لكن صفحة تحتوي على نصوص مالية مكثفة ومضغوطة إلى 224x224 ستتحول إلى كتلة غير مقروءة. لقد صُممت مشفرات الرؤية (vision encoders) القياسية لنظام دقة محدد، بينما تحتاج المستندات إلى نظام مختلف كلياً: دقة عالية، لأن معنى حقل معين في نموذج ما غالباً ما يعتمد على بضعة أحرف صغيرة، ولأن المعلومات تكون موزعة بالتساوي عبر الصفحة بدلاً من أن تكون متمركزة في منطقة بارزة واحدة.
قد يبدو رفع دقة الإدخال حلاً بديهياً، لكنه يتسبب في مشاكل أخرى. تعالج نماذج Vision transformers الصورة عن طريق تقسيمها إلى رقع (patches) صغيرة وحساب الانتباه (attention) فيما بينها. وفي الدقات العالية، يزداد عدد هذه الرقع بشكل كبير، وإذا كانت كل رقعة "ترى" محيطها المباشر فقط، سيفقد النموذج القدرة على تتبع العناصر التي تمتد عبر مناطق مختلفة، مثل صف في جدول يمتد من الحافة اليسرى إلى الحافة اليمنى لمستند عريض. لذا، فإن مجرد زيادة الدقة دون معالجة هذه المشكلة سيؤدي إما إلى إغفال العلاقات طويلة المدى أو سيجعل التكلفة الحسابية باهظة للغاية.
كيف يقرأ TextMonkey الصفحة فعلياً
يعتمد النهج المتبع في الورقة البحثية على عدة أجزاء تعمل معاً بشكل متكامل.
آلية Shifted Window Attention. بدلاً من معالجة الصورة عالية الدقة بالكامل كعملية attention واحدة ضخمة (وهو أمر مكلف حاسوبياً)، أو تقسيمها إلى نوافذ معزولة غير متداخلة لا يمكنها التواصل فيما بينها (مما يؤدي لفقدان المعلومات العابرة للنوافذ)، استعار TextMonkey حيلة من بنية Swin Transformer الرؤيوية: تتم معالجة الصورة في نوافذ محلية، ثم يتم إزاحة حدود النوافذ في الطبقة التالية بحيث يتم تجميع المناطق التي كانت مقسمة سابقاً هذه المرة. وعبر عدة طبقات، تنتشر المعلومات بفعالية عبر الصورة بأكملها دون تحمل تكلفة الـ global attention الكاملة. وقد أضاف المؤلفون تفصيلاً أهم مما يبدو: لقد قاموا بتهيئة آلية الـ shifted attention هذه بقيمة صفر (zero-initialize)، مما يعني أنها لا تساهم بشيء في بداية التدريب ثم تزداد تدريجياً. هذا يحافظ على استقرار التدريب المبكر بدلاً من إقحام آلية عابرة للنوافذ غير مكتملة التدريب والمخاطرة بتشتت النموذج (diverge).
تقليص الـ tokens الفائضة. تنتج صور المستندات عالية الدقة على مستوى الـ patch عدداً كبيراً من الـ tokens، وجزء كبير منها يكون فائضاً عن الحاجة. تخيل هامشاً فارغاً كبيراً، أو نسيج خلفية متكرراً عبر عشرات الـ patches. يستخدم TextMonkey مرشحاً قائماً على التشابه (similarity-based filter) لتحديد هذه الـ tokens ذات المعلومات المنخفضة وحذفها قبل وصولها إلى الأجزاء المكلفة من النموذج. والنتيجة الجديرة بالملاحظة هنا هي أن هذا ليس مجرد حيلة لزيادة السرعة؛ حيث تشير الورقة البحثية إلى أن تقليص الـ tokens الفائضة أدى فعلياً إلى تحسين الأداء بالإضافة إلى تسريع النموذج، مما يشير إلى أن بعض تلك الـ tokens "الإضافية" كانت تعمل كضجيج (noise) بدلاً من أن تكون إشارة مفيدة (signal).
مهام Text spotting و grounding كعمليات تدريبية. هذا هو الجزء المسؤول عن سلوك "الإشارة" أو التحديد. فبدلاً من تدريب النموذج فقط على الإجابة عن الأسئلة بنصوص حرة، قام المؤلفون أيضاً بتدريبه على الـ text spotting (إيجاد النصوص في مواقع محددة ونسخها) والـ grounding (إرجاع الـ bounding box الخاص بعبارة معينة). والأهم من ذلك، أنهم دمجوا المعلومات الموضعية (positional information) ضمن إجابات النموذج نفسها؛ فبينما يجيب TextMonkey على سؤال "ما هو المجموع"، يمكن أن تتضمن الاستجابة إحداثيات المكان الذي قرأ منه هذه الإجابة. وهذا يحول الإجابة المبهمة إلى إجابة قابلة للتحقق.
فهم لقطات الشاشة عبر الـ fine-tuning. يكتسب النموذج أيضاً القدرة على تحليل لقطات شاشة لواجهات المستخدم (واجهات التطبيقات، صفحات الويب) من خلال عملية fine-tuning مستهدفة، مما يوسع مهارات قراءة المستندات لتشمل مجالاً بصرياً مختلفاً تماماً: مجال يتسم بالتشتت، والاعتماد الكثيف على التنسيق (layout)، والأيقونات والأزرار بدلاً من الفقرات النصية الكثيفة.
الأرقام، ومعناها الفعلي
تم تقييم TextMonkey عبر 12 معياراً (benchmarks) موزعة على ثلاث فئات:
- المهام المتمحورة حول نصوص المشاهد (قراءة النصوص في صور من العالم الحقيقي — مثل لافتات الشوارع وملصقات المنتجات): STVQA و TextVQA و OCRVQA. نسبة التحسن: 5.2%.
- المهام الموجهة نحو المستندات (المستندات المهيكلة — مثل النماذج، والإنفوجرافيك، والمخططات، والجداول): DocVQA و InfoVQA و ChartVQA و DeepForm و Kleister Charity و WikiTableQuestions. نسبة التحسن: 6.9%.
- استخراج المعلومات الأساسية (سحب حقول محددة من مستندات شبه مهيكلة — مثل استخراج "اسم المورد" و"المبلغ المستحق" من فاتورة): FUNSD و SROIE و POIE. نسبة التحسن: 2.8%.
يتماشى القفز الأكبر في فئة المستندات (6.9%) مع الإطار الذي طرحته الورقة البحثية؛ فهذا هو المجال الذي يُفترض أن يكون لمعالجة دقة النافذة المزاحة (shifted-window resolution) وتصفية الرموز (token filtering) التأثير الأكبر، لأن النماذج السابقة كانت تفقد المعلومات في النماذج والجداول الكثيفة عند استخدام دقة منخفضة.
أما رصد نصوص المشاهد (إيجاد وقراءة النصوص المبعثرة في صورة طبيعية، وليس مسحاً ضوئياً نظيفاً) فقد تحسن بنسبة 10.9%، وهي أكبر قيمة منفردة في الورقة. ومن المرجح أن يكون هذا هو العائد المباشر لتدريب النموذج بشكل صريح على مهام الرصد والربط (spotting and grounding) بدلاً من التعامل مع تحديد المواقع كأمر ثانوي.
وفي OCRBench، وهي مجموعة شاملة تضم 29 مهمة فرعية متعلقة بـ OCR، سجل TextMonkey 561 نقطة، متفوقاً على النماذج متعددة الوسائط (multimodal models) مفتوحة المصدر التي كانت متاحة لفهم المستندات في ذلك الوقت. وتتغير أرقام OCRBench بسرعة في هذا المجال ويتم تجاوزها في غضون عام أو عامين، لذا يجب اعتبار درجة 561 بمثابة "أحدث ما توصل إليه العلم في مارس 2024" بدلاً من كونها تصنيفاً دائماً، ومع ذلك، تظل الفجوة النسبية مقارنة بالنماذج المفتوحة السابقة مؤشراً مفيداً على القيمة التي حققتها الخيارات المعمارية للنموذج.
أين تكمن نقاط القصور
لا يتوسع البحث في مناقشة القيود، ولكن هناك بعض الفجوات التي تستحق التوضيح بشكل صريح.
تعتمد خطوة تصفية الرموز (token-filtering) على "التشابه" لتحديد العناصر الزائدة، وهو مجرد نهج استدلالي (heuristic). ومن المحتمل أن يؤدي ذلك أحياناً إلى استبعاد رمز منخفض التكرار ولكنه يحمل دلالة مهمة، مثل ختم صغير أو علامة مائية باهتة تظهر مرة واحدة فقط ولا تبدو "مشابهة" لأي شيء آخر في الصفحة. ورغم أن البحث يشير إلى مكاسب في الأداء العام، إلا أن ذلك يمثل متوسطاً عبر مقاييس الاختبار (benchmarks)، وليس ضماناً ضد حالات صعبة ومحددة.
أما دقة الربط المكاني (Grounding accuracy) فهي مرتبطة بجودة القراءة الأساسية؛ فإذا أخطأ النموذج في قراءة رقم ما، فإن مربع الإحاطة (bounding box) الذي سيرسمه سيشير بثقة إلى دليل خاطئ. إن عملية الربط تمنحك القدرة على "التحقق"، لكنها لا تضمن "الصحة". وهي تحسن حقيقي مقارنة بمبدأ "ثق بي"، لكنها ليست دليلاً قاطعاً.
علاوة على ذلك، لا تزال مقاييس الاختبار المستخدمة هنا تعتمد بشكل أساسي على اللغة الإنجليزية وتنسيقات المستندات الغربية. لا يوجد في ملخص البحث ما يشير إلى اختبار المستندات متعددة اللغات، أو النماذج التي تعتمد بكثافة على الكتابة اليدوية، أو عمليات المسح الضوئي الأكثر تعقيداً التي تظهر في أرشيفات العالم الحقيقي (مثل المستندات المائلة، أو ذات التباين المنخفض، أو الملطخة بالقهوة). فالأداء في بيئة الاختبارات النظيفة يرتبط بالأداء في العالم الحقيقي، لكنهما ليسا متطابقين.
لماذا يهم هذا الأمر كل من يقوم ببناء أو شراء أنظمة OCR
إذا كنت بصدد اختيار محرك ذكاء اصطناعي للمستندات لمنتجك، فإن القدرة على "الربط المرجعي" (grounding) هي الأمر الذي يجب التركيز عليه، أكثر من مجرد أرقام الاختبارات القياسية (benchmarks). فالنموذج الذي يكتفي بإخراج نتيجة مثل "الإجمالي هو 482.19 دولاراً" لا يمنحك أي وسيلة لاكتشاف الخطأ عند وقوعه. أما النموذج الذي يخرج الرقم مع "صندوق إحاطة" (bounding box)، فيتيح لك بناء واجهة مستخدم تُمكّن المراجع البشري من رؤية المنطقة المظللة وتأكيدها أو رفضها بنظرة سريعة، بدلاً من إعادة قراءة المستند بالكامل. وبالنسبة لأي سير عمل يتضمن أموالاً أو عقوداً أو امتثالاً قانونياً، فإن هذا الفرق هو الذي يحدد ما إذا كان نظام الـ OCR "قابلاً للفحص العشوائي" أو "نظاماً يجب الوثوق به ثقة عمياء".
كما يمثل هذا التوجه نقطة تحول أوسع بعيداً عن مسارات العمل التقليدية التي تعتمد على "التعرف الضوئي ثم التحليل" (OCR-then-parse)، والانتقال نحو نماذج موحدة تقرأ وتفهم المستند في تمريرة واحدة. يظهر هذا التحول في العديد من النماذج التي نتتبعها، وهو يغير الحسابات لكل من بنى بنية تحتية تفترض أن استخراج النصوص وفهم المستندات خطوتان منفصلتان تقوم بهما أدوات مختلفة. لم يعد الأمر كذلك بشكل متزايد، والنماذج التي تتجاوز مرحلة "التسليم" بين الأدوات تتفوق في الاختبارات القياسية للمستندات لسبب بسيط: لا شيء يضيع في الترجمة بين سلسلة نصوص الـ OCR والنموذج الذي يقرأها. وتبرز أهمية هذا التكامل بشكل خاص عند التعامل مع اللغة العربية، حيث تزيد طبيعة الخط المتصل والحروف المتغيرة حسب موقعها في الكلمة من تعقيد عمليات الـ OCR التقليدية.
أما من الناحية العملية، فإن زاوية "كفاءة الرموز" (token-efficiency) مهمة جداً؛ فإذا كنت تقوم بعمليات الاستنتاج (inference) على نطاق واسع، فإن التقنية التي تقلل الرموز المكررة وتحسن الدقة في آن واحد هي أمر نادر لدرجة تستحق الملاحظة، إذ لا تأتي مكاسب الكفاءة والجودة معاً في العادة، ولكن هذا ما حدث هنا.