TextMonkey: एक Vision-Language Model को उस लाइन की ओर इशारा करना सिखाना जिसे उसने अभी पढ़ा है
आधारित शोध-पत्र: TextMonkey: An OCR-Free Large Multimodal Model for Understanding Document — Yuliang Liu, Biao Yang, Qiang Liu, Zhang Li, Zhiyin Ma, Shuo Zhang, Xiang Bai
पारदर्शिता की समस्या
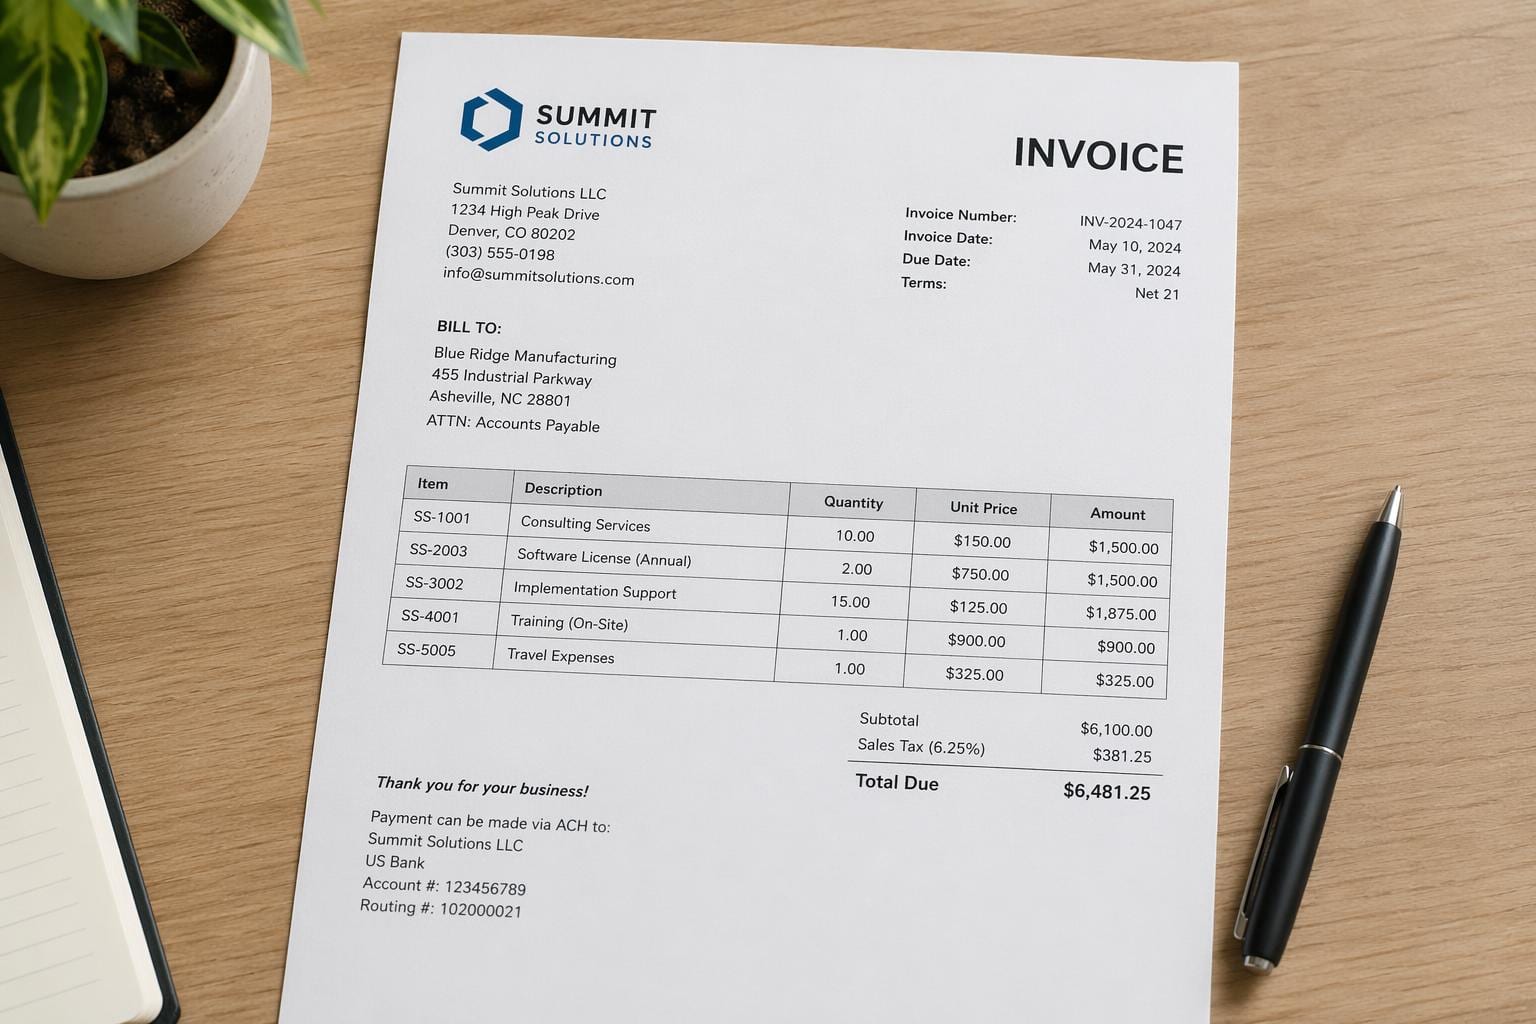
यदि आप अधिकांश document AI tools से पूछें कि "इस invoice का कुल योग (total) क्या है?", तो वे आपको एक नंबर दे देंगे। लेकिन इसे जांचने का कोई तरीका नहीं है, और न ही यह जानने का कि मॉडल ने row 4 को पढ़ा है या गलती से row 7 से subtotal उठा लिया है। आपको बस उस पर भरोसा करना पड़ता है।
Huazhong University of Science and Technology के 2024 के एक पेपर, TextMonkey, ने कुछ अधिक उपयोगी समाधान पेश किया है: यह न केवल प्रश्न का उत्तर देता है, बल्कि उस सटीक टेक्स्ट के चारों ओर एक बॉक्स भी बनाता है जिसका उपयोग उसने उत्तर तक पहुँचने के लिए किया था। यदि आप इसे कोई शब्द खोजने के लिए कहते हैं, तो यह केवल "हाँ, यह यहाँ है" नहीं कहता — बल्कि यह आपको coordinates देता है। यह सुनने में एक छोटी सी विशेषता लग सकती है, लेकिन वास्तव में यह इस बारे में एक structural bet है कि इन मॉडल्स को कैसे काम करना चाहिए, और यही इस पेपर का सबसे दिलचस्प हिस्सा है।
पुराना तरीका: पहले OCR, फिर समझ
सालों तक, AI के ज़रिए किसी दस्तावेज़ को "पढ़ने" का मतलब एक दो-चरणीय (two-step) पाइपलाइन था। पहले चरण में, एक OCR इंजन (Tesseract, या उससे कुछ अधिक उन्नत) पिक्सेल को टेक्स्ट स्ट्रिंग्स में बदलता है। दूसरे चरण में, एक लैंग्वेज मॉडल उन स्ट्रिंग्स को पढ़ता है और उनसे संबंधित सवालों के जवाब देता है।
समस्या यह है कि पहला चरण एक ऐसी बाधा (bottleneck) बन जाता है जिसमें मूल इमेज की कोई याददाश्त नहीं रहती। एक बार जब OCR आपके इनवॉइस को कैरेक्टर्स की एक स्ट्रिंग में बदल देता है, तो मॉडल लेआउट, टेबल स्ट्रक्चर, फॉन्ट साइज़ (जिससे पता चलता था कि कौन सी लाइन हेडर है), और उस विजुअल कॉन्टेक्स्ट को खो देता है जो एक इंसान को यह बताता है कि "यह नंबर बोल्ड है और एक बॉक्स में है, इसलिए यह शायद कुल राशि (total) है।" यदि OCR इंजन किसी कैरेक्टर को गलत पढ़ता है या कोई लाइन छोड़ देता है, तो लैंग्वेज मॉडल को कभी पता ही नहीं चलता कि कुछ खो गया है। वह बस गलत इनपुट के आधार पर आत्मविश्वास के साथ जवाब देता है।
TextMonkey "OCR-free" मॉडल्स के एक नए परिवार का हिस्सा है जो पहले चरण को पूरी तरह छोड़ देते हैं। यह मॉडल सीधे दस्तावेज़ की इमेज को देखता है और टेक्स्ट, स्ट्रक्चर और जवाब एक साथ जेनरेट करता है—ठीक वैसे ही जैसे आप किसी रसीद पर एक नज़र डालते हैं और हर कैरेक्टर को सचेत रूप से ट्रांसक्राइब किए बिना ही कुल राशि जान लेते हैं। 2024 तक यह कोई नया विचार नहीं था, लेकिन TextMonkey इसे रेजोल्यूशन, एफिशिएंसी और—सबसे नया हिस्सा—पॉइंट करने की क्षमता (ability to point) के मामले में और आगे ले जाता है।
दस्तावेज़ की छवियाँ सामान्य विज़न मॉडल्स को क्यों विफल कर देती हैं
Vision-language मॉडल्स को मुख्य रूप से तस्वीरों के लिए बनाया और ट्यून किया गया था: जैसे समुद्र तट पर एक कुत्ता, भोजन की एक प्लेट, या सड़क का कोई दृश्य। लेकिन दस्तावेज़ (Documents) बिल्कुल अलग होते हैं।
एक तस्वीर को 224x224 पिक्सेल तक छोटा (scrunch) करने पर भी वह पहचानी जा सकती है; आप तब भी बता सकते हैं कि वह एक कुत्ता है। लेकिन वित्तीय विवरणों (financial text) से भरे एक घने पेज को यदि 224x224 में छोटा कर दिया जाए, तो वह पूरी तरह से अपठनीय हो जाता है। स्टैंडर्ड vision encoders एक निश्चित resolution regime के लिए बनाए गए थे, जबकि दस्तावेज़ों को एक पूरी तरह से अलग regime की आवश्यकता होती है: हाई resolution। ऐसा इसलिए है क्योंकि किसी फॉर्म फील्ड का अर्थ अक्सर कुछ छोटे अक्षरों पर निर्भर करता है, और जानकारी किसी एक मुख्य क्षेत्र में केंद्रित होने के बजाय पूरे पेज पर समान रूप से फैली होती है।
इनपुट resolution को बढ़ाना एक स्पष्ट समाधान लगता है, लेकिन यह अन्य समस्याओं को जन्म देता है। Vision transformers एक इमेज को छोटे patches में विभाजित करके और उनके बीच attention की गणना करके प्रोसेस करते हैं। उच्च resolution पर patches की संख्या बहुत बढ़ जाती है, और यदि प्रत्येक patch केवल अपने आस-पास के क्षेत्र को "देखता" है, तो मॉडल उन चीज़ों का ट्रैक खो देता है जो कई क्षेत्रों में फैली होती हैं—जैसे कि एक टेबल की रो (row) जो एक चौड़े दस्तावेज़ के बाएं किनारे से दाएं किनारे तक जाती है। इस समस्या को हल किए बिना केवल resolution बढ़ाना या तो long-range relationships को नज़रअंदाज़ करता है या फिर कंप्यूटेशनल रूप से बहुत महंगा (prohibitively expensive) हो जाता है।
TextMonkey वास्तव में एक पेज को कैसे पढ़ता है
इस पेपर का दृष्टिकोण कुछ ऐसे हिस्सों में बंटा है जो मिलकर काम करते हैं।
Shifted Window Attention. पूरी हाई-रिज़ॉल्यूशन इमेज को एक विशाल attention computation के रूप में प्रोसेस करने (जो कि महंगा है) या इसे अलग-अलग non-overlapping विंडोज़ में बांटने (जिससे cross-window जानकारी खो जाती है) के बजाय, TextMonkey ने Swin Transformer विज़न आर्किटेक्चर की एक ट्रिक अपनाई है: इमेज को लोकल विंडोज़ में प्रोसेस करें, और फिर अगली लेयर में विंडो बाउंड्रीज़ को शिफ्ट करें ताकि वे क्षेत्र जो पहले अलग थे, इस बार एक साथ समूहबद्ध हो जाएं। कई लेयर्स के बाद, पूरी ग्लोबल attention की भारी लागत चुकाए बिना जानकारी प्रभावी रूप से पूरी इमेज में फैल जाती है। लेखकों ने एक ऐसा विवरण जोड़ा है जो सुनने में साधारण लगता है लेकिन बहुत महत्वपूर्ण है: उन्होंने इस shifted attention मैकेनिज्म को zero-initialize किया है, जिसका अर्थ है कि ट्रेनिंग की शुरुआत में यह कुछ भी योगदान नहीं देता और धीरे-धीरे बढ़ता है। यह शुरुआती ट्रेनिंग को स्थिर रखता है, बजाय इसके कि एक आधा-ट्रेन हुआ cross-window मैकेनिज्म बीच में डाल दिया जाए और उम्मीद की जाए कि मॉडल diverge न हो।
Cutting redundant tokens. पैच लेवल पर हाई-रिज़ॉल्यूशन डॉक्यूमेंट इमेज बहुत सारे टोकन पैदा करती हैं, और उनमें से एक बड़ा हिस्सा redundant (अनावश्यक) होता है। उदाहरण के लिए, एक बड़ा खाली मार्जिन, या दर्जनों पैच में दोहराया गया एक ही बैकग्राउंड टेक्सचर। TextMonkey इन कम-जानकारी वाले टोकन की पहचान करने और उन्हें मॉडल के महंगे हिस्सों तक पहुँचने से पहले हटाने के लिए similarity-based फ़िल्टर का उपयोग करता है। यहाँ ध्यान देने योग्य बात यह है कि यह केवल स्पीड बढ़ाने की ट्रिक नहीं है। पेपर बताता है कि redundant टोकन को हटाने से मॉडल के तेज़ होने के साथ-साथ उसके प्रदर्शन (performance) में भी सुधार हुआ, जिससे पता चलता है कि वे "अतिरिक्त" टोकन सिग्नल के बजाय शोर (noise) की तरह काम कर रहे थे।
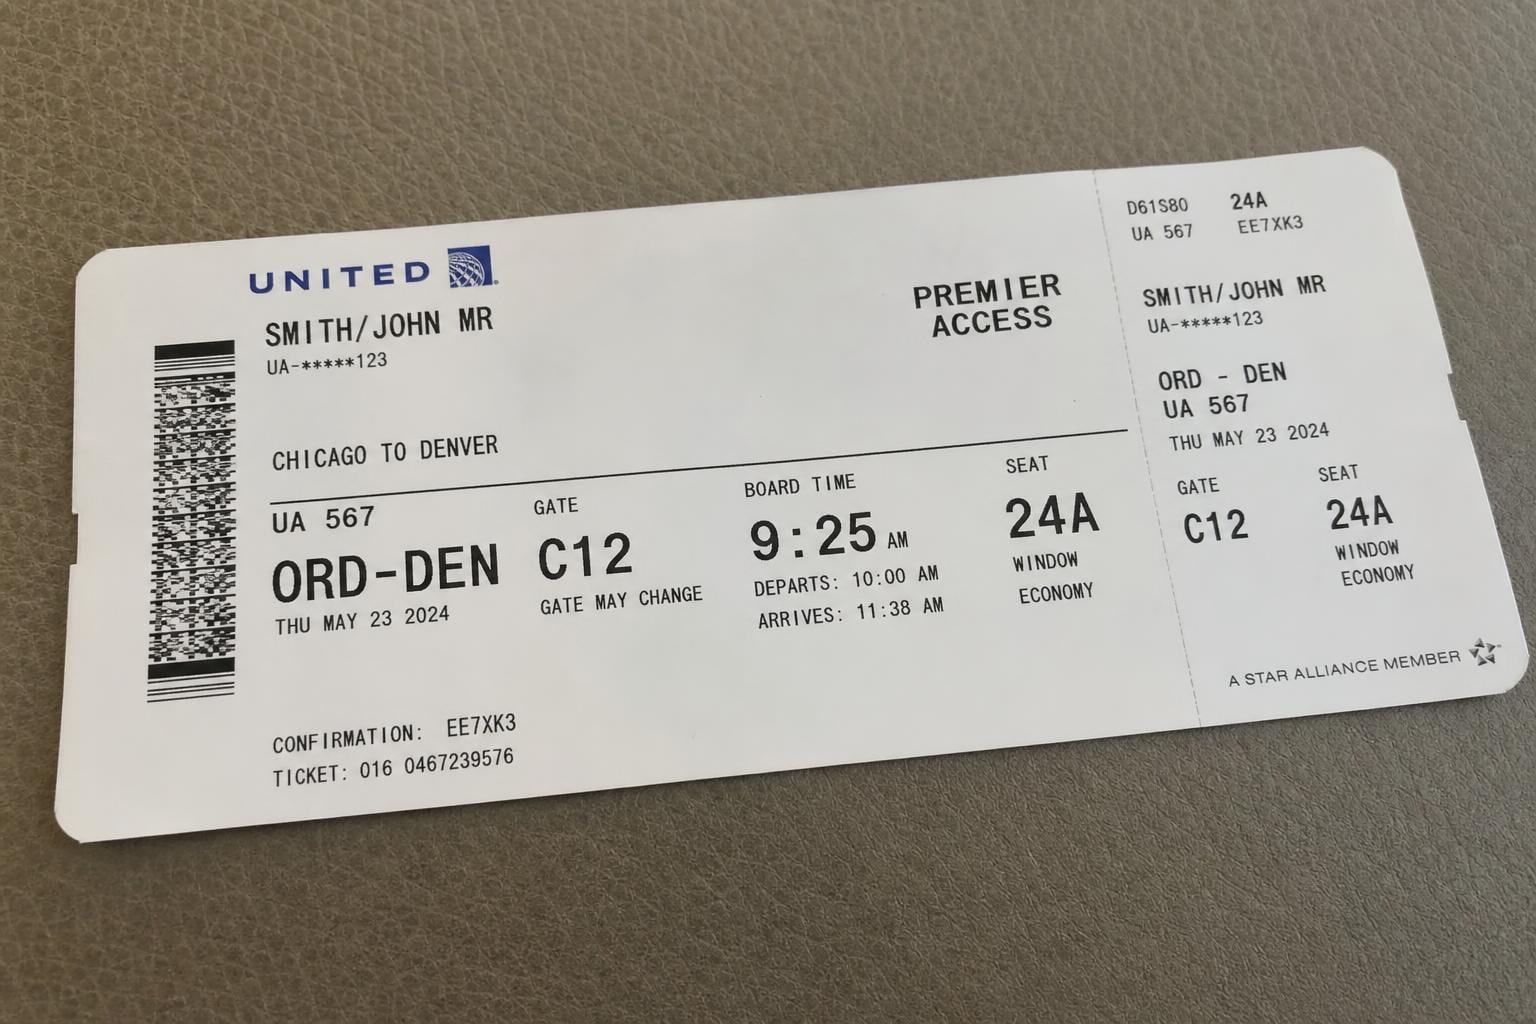
Text spotting और grounding ट्रेनिंग टास्क के रूप में. यह वह हिस्सा है जो 'पॉइंटिंग' व्यवहार पैदा करता है। मॉडल को केवल फ्री टेक्स्ट में सवालों के जवाब देने के लिए ट्रेन करने के बजाय, लेखकों ने इसे text spotting (विशिष्ट स्थानों पर टेक्स्ट खोजना और उसे ट्रांसक्राइब करना) और grounding (एक वाक्यांश दिए जाने पर उसका bounding box लौटाना) के लिए भी ट्रेन किया है। महत्वपूर्ण बात यह है कि वे पोजीशनल जानकारी को मॉडल के जवाबों में ही शामिल करते हैं, इसलिए जब TextMonkey जवाब देता है कि "कुल राशि क्या है," तो प्रतिक्रिया में उन कोऑर्डिनेट्स (coordinates) को शामिल किया जा सकता है जहाँ से उसने वह उत्तर पढ़ा है। यह एक अस्पष्ट उत्तर को जांचने योग्य (checkable) उत्तर में बदल देता है।
Fine-tuning के माध्यम से Screenshot understanding. टारगेटेड fine-tuning के जरिए मॉडल UI स्क्रीनशॉट (ऐप इंटरफेस, वेब पेज) को पार्स करने की क्षमता भी हासिल करता है। यह डॉक्यूमेंट पढ़ने के उन्हीं कौशल को एक अलग विजुअल डोमेन तक विस्तारित करता है: जो घने टेक्स्ट पैराग्राफ के बजाय विरल (sparse), लेआउट-हैवी और आइकन-और-बटन आधारित होता है।
आंकड़े, और उनका वास्तविक अर्थ
TextMonkey का मूल्यांकन 12 benchmarks पर किया गया, जिन्हें तीन श्रेणियों में बांटा गया था:
- Scene text-centric tasks (वास्तविक दुनिया की तस्वीरों में टेक्स्ट पढ़ना — जैसे स्ट्रीट साइन, प्रोडक्ट लेबल): STVQA, TextVQA, OCRVQA। सुधार: 5.2%।
- Document-oriented tasks (स्ट्रक्चर्ड डॉक्यूमेंट्स — फॉर्म, इन्फोग्राफिक्स, चार्ट, टेबल): DocVQA, InfoVQA, ChartVQA, DeepForm, Kleister Charity, WikiTableQuestions। सुधार: 6.9%।
- Key information extraction (सेमी-स्ट्रक्चर्ड डॉक्यूमेंट्स से विशिष्ट फील्ड्स निकालना — जैसे किसी इनवॉइस से "vendor name" और "amount due" निकालना): FUNSD, SROIE, POIE। सुधार: 2.8%।
डॉक्यूमेंट-ओरिएंटेड श्रेणी में सबसे बड़ी बढ़त (6.9%) दिखना पेपर के अपने फ्रेमवर्क के अनुरूप है: यहीं पर shifted-window resolution handling और token filtering का सबसे अधिक प्रभाव पड़ना चाहिए, क्योंकि घने फॉर्म और टेबल ही वे जगहें हैं जहाँ पुराने मॉडल्स कम रिज़ॉल्यूशन पर जानकारी खो देते थे।
Scene text spotting (एक प्राकृतिक फोटो में बिखरे हुए टेक्स्ट को ढूंढना और पढ़ना, न कि किसी क्लीन स्कैन में) में 10.9% का सुधार हुआ, जो इस पेपर का सबसे बड़ा आंकड़ा है। यह संभवतः मॉडल को केवल लोकलाइजेशन को गौण मानने के बजाय, स्पष्ट रूप से spotting और grounding tasks पर ट्रेन करने का सीधा परिणाम है।
OCRBench, जो 29 OCR-संबंधित सब-टास्क का एक व्यापक सूट है, उस पर TextMonkey ने 561 स्कोर किया, जो उस समय डॉक्यूमेंट अंडरस्टैंडिंग के लिए बनाए गए पिछले ओपन-सोर्स लार्ज मल्टीमोडल मॉडल्स से बेहतर था। इस क्षेत्र में OCRBench के आंकड़े तेजी से बदलते हैं और एक-दो साल में पुराने हो जाते हैं, इसलिए 561 को स्थायी रैंकिंग के बजाय "मार्च 2024 के state of the art" के रूप में देखें। फिर भी, पिछले ओपन मॉडल्स की तुलना में यह सापेक्ष अंतर यह बताने के लिए पर्याप्त है कि आर्किटेक्चरल विकल्पों से क्या लाभ मिला।
यहाँ अभी भी कुछ कमियाँ हैं
पेपर में सीमाओं पर अधिक चर्चा नहीं की गई है, लेकिन कुछ कमियों को स्पष्ट रूप से बताना ज़रूरी है।
टोकन-फ़िल्टरिंग स्टेप इस बात का निर्णय लेने के लिए 'similarity' पर निर्भर करता है कि क्या redundant है, जो कि एक heuristic है। यह संभव है कि यह कभी-कभी किसी कम-frequency वाले लेकिन महत्वपूर्ण टोकन को हटा दे, जैसे कि कोई छोटा स्टैम्प या हल्का वॉटरमार्क जो केवल एक बार दिखाई देता है और पेज पर किसी अन्य चीज़ के "similar" नहीं दिखता। पेपर नेट परफॉरमेंस गेन्स की रिपोर्ट करता है, लेकिन यह बेंचमार्क्स का एक औसत है, किसी विशिष्ट कठिन केस के खिलाफ कोई गारंटी नहीं।
Grounding accuracy केवल उतनी ही अच्छी होती है जितनी कि underlying reading। यदि मॉडल किसी अंक (digit) को गलत पढ़ता है, तो उसके द्वारा बनाया गया bounding box आत्मविश्वास के साथ गलत प्रमाण की ओर इशारा करेगा। Grounding आपको verifiability प्रदान करता है, correctness नहीं। यह "trust me" के मुकाबले एक वास्तविक सुधार है, लेकिन यह कोई प्रमाण नहीं है।
इसके अलावा, यहाँ इस्तेमाल किए गए बेंचमार्क्स अभी भी मुख्य रूप से English-language और अधिकतर Western document formats हैं। पेपर के abstract में ऐसा कुछ भी नहीं है जो multilingual documents, handwriting-heavy forms, या वास्तविक दुनिया के बैकलाग्स में मिलने वाले अधिक अव्यवस्थित स्कैन्स (skewed, low-contrast, coffee-stained) पर टेस्टिंग का सुझाव दे। Clean benchmark performance और messy-real-world performance के बीच सह-संबंध (correlated) होता है, वे एक समान (identical) नहीं होते।
OCR बनाने या खरीदने वालों के लिए यह क्यों महत्वपूर्ण है
यदि आप किसी प्रोडक्ट के लिए document AI engine चुन रहे हैं, तो raw benchmark numbers के बजाय यहाँ 'grounding capability' पर ध्यान देना अधिक ज़रूरी है। एक मॉडल जो केवल यह आउटपुट देता है कि "the total is $482.19", आपको यह पकड़ने का कोई मौका नहीं देता कि वह कब गलत है। इसके विपरीत, एक मॉडल जो नंबर के साथ bounding box भी देता है, आपको ऐसा UI बनाने की सुविधा देता है जहाँ एक human reviewer हाइलाइट किए गए क्षेत्र को देख सकता है और पूरे दस्तावेज़ को दोबारा पढ़ने के बजाय एक नज़र में उसे confirm या reject कर सकता है। पैसे, कॉन्ट्रैक्ट्स या compliance से जुड़े किसी भी वर्कफ़्लो के लिए, यही अंतर "OCR जिसे आप spot-check कर सकते हैं" और "OCR जिस पर आपको पूरी तरह भरोसा करना पड़ता है" के बीच का अंतर है।
यह OCR-then-parse पाइपलाइन्स से हटकर उन single models की ओर बढ़ते बदलाव का भी एक संकेत है जो एक ही pass में पढ़ते और समझते हैं। यह बदलाव उन कई मॉडल्स में दिख रहा है जिन्हें हम ट्रैक करते हैं, और यह उन लोगों के लिए पूरा गणित बदल देता है जिन्होंने यह मानकर इंफ्रास्ट्रक्चर बनाया था कि OCR text extraction और document understanding अलग-अलग टूल्स द्वारा किए जाने वाले अलग-अलग स्टेप्स हैं। अब ऐसा नहीं रहा, और जो मॉडल्स इस handoff को स्किप करते हैं, वे document-heavy benchmarks में जीत रहे हैं क्योंकि OCR string और उसे पढ़ने वाले मॉडल के बीच translation में कुछ भी खोता नहीं है। यहाँ यह ध्यान देना ज़रूरी है कि English OCR में मज़बूत प्रदर्शन का मतलब यह नहीं है कि Devanagari OCR भी उतना ही सटीक होगा, क्योंकि भारतीय लिपियों की जटिलता अलग होती है।
Token-efficiency का पहलू भी व्यावहारिक रूप से मायने रखता है। यदि आप बड़े पैमाने पर inference चला रहे हैं, तो ऐसी तकनीक जो redundant tokens को कम करे और साथ ही accuracy को सुधारे, काफी दुर्लभ होती है: आमतौर पर efficiency और quality gains एक साथ नहीं आते, लेकिन यहाँ ऐसा हुआ है।