TextMonkey:教视觉语言模型指向它刚刚阅读的行
参考论文: TextMonkey: An OCR-Free Large Multimodal Model for Understanding Document — Yuliang Liu, Biao Yang, Qiang Liu, Zhang Li, Zhiyin Ma, Shuo Zhang, Xiang Bai
大多数文档 AI 工具
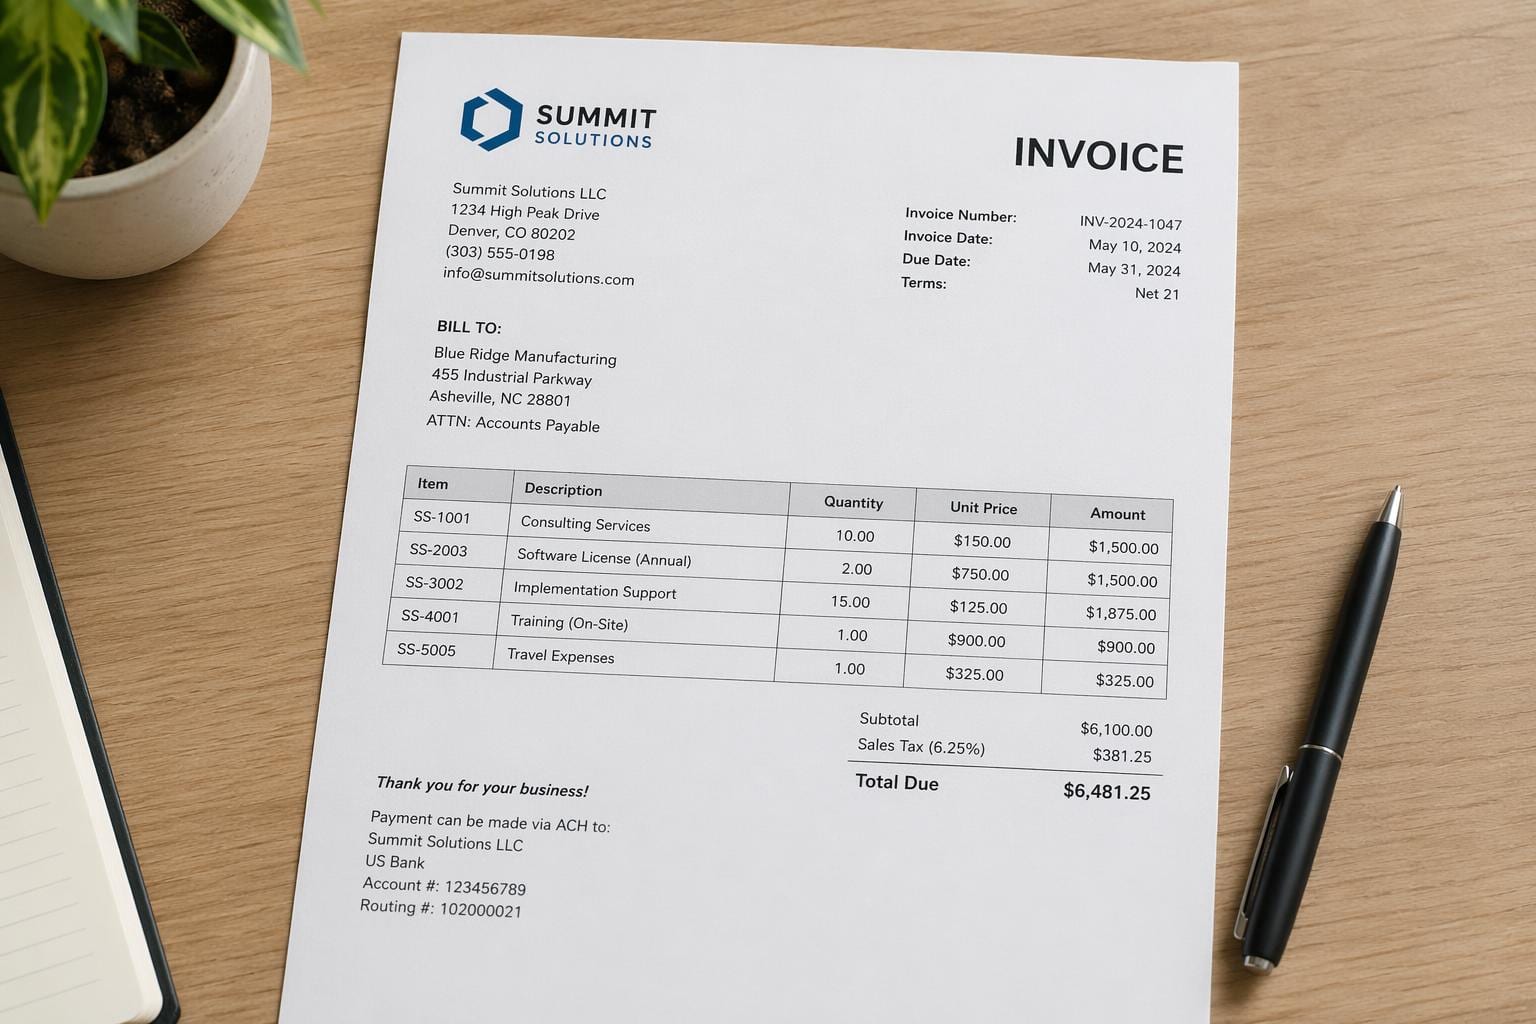
如果你问大多数文档 AI 工具“这张发票的总金额是多少?”,你会得到一个数字。但你无法验证它,也无法知道模型是读取了第 4 行,还是不小心抓取了第 7 行的一个子总计。你只能选择信任它。
TextMonkey 是华中科技大学于 2024 年发表的一篇论文,它做了一些更有用的事情:它不仅回答问题,还会在它用来得出答案的确切文本周围画一个框。如果你让它找一个词,它不会只说“是的,它在这里”——它会给你坐标。这听起来像是一个小功能。但实际上,这是关于这些模型应该如何工作的一种结构性赌注,也是这篇论文中最有趣的部分。
传统方式:先OCR,再理解
多年来,用AI“阅读”文档意味着一个两步走的流程。第一步,OCR引擎(如Tesseract,或更高级的工具)将像素转换为文本字符串。第二步,语言模型读取这些字符串并回答相关问题。
问题在于,第一步是一个瓶颈,且无法保留原始图像的记忆。一旦OCR将你的发票转换为一串字符,模型就已经丢失了布局、表格结构、指示哪一行是标题的字体大小,以及告诉人类读者“这个数字是粗体且在框内,可能是总计”的视觉上下文。如果OCR引擎误读了一个字符或漏掉了一行,语言模型根本不知道有任何信息丢失。它只是基于错误的输入自信地给出答案。
TextMonkey属于新一代“无OCR”模型,跳过了第一步。该模型直接查看文档图像,并一次性生成文本、结构和答案,就像你瞥一眼收据就能知道总计,而无需有意识地转录每个字符一样。这并非2024年的新想法,但TextMonkey在分辨率、效率以及——真正新颖的部分——指向能力方面将其推向了新的高度。
为什么文档图像会破坏普通视觉模型
视觉语言模型主要是为照片构建和微调的:海滩上的一只狗、一盘食物、一个街景。文档则是另一回事。
一张照片可以被压缩到 224x224 像素;你仍然能认出它是一只狗。而一页密集的金融文本被压缩到 224x224 像素后,就会变成无法阅读的糊状物。标准的视觉编码器是为一种分辨率范围构建的,而文档需要完全不同的分辨率范围:高分辨率,因为表单字段的含义往往取决于少数几个小字符,以及均匀分布在页面上的信息,而不是集中在一个显著区域。
提高输入分辨率是显而易见的解决方案,但它会在其他地方破坏东西。视觉变压器通过将图像分割成小块并计算它们之间的注意力来处理图像。在更高分辨率下,会有更多的小块,如果每个小块只“看到”自己的邻域,模型就会丢失跨越区域的东西,比如从宽文档的左边缘延伸到右边缘的表格行。仅仅增加分辨率而不解决这个问题,要么会错过长距离关系,要么会变得非常昂贵。
TextMonkey 实际如何阅读页面
该论文的方法由几个协同工作的部分组成。
移位窗口注意力(Shifted Window Attention)。 与其将整个高分辨率图像作为一个巨大的注意力计算来处理(计算成本高昂),或者将其分割为彼此孤立、无法交互的非重叠窗口(会丢失跨窗口信息),TextMonkey 借鉴了 Swin Transformer 视觉架构中的一个技巧:在局部窗口中处理图像,然后在下一层中移动窗口边界,使得之前被分割的区域此次被组合在一起。经过多层处理,信息有效地在整个图像中传播,而无需支付全局注意力的全部成本。作者添加了一个看似简单实则重要的细节:他们对这种移位注意力机制进行了零初始化,这意味着在训练开始时它不产生任何贡献,而是逐渐增强。这保持了早期训练的稳定性,而不是将一个半成品的跨窗口机制直接投入训练,并寄希望于模型不会发散。
剔除冗余 Token。 高分辨率文档图像在 patch 级别会产生大量 Token,其中很大一部分是冗余的。想象一下大片的空白页边距,或者在几十个 patch 中重复出现的相同背景纹理。TextMonkey 使用基于相似度的过滤器来识别这些低信息量的 Token,并在它们进入模型昂贵部分之前将其丢弃。值得注意的发现是:这不仅仅是一个加速技巧。论文报告称,剔除冗余 Token 实际上在提高模型速度的同时提升了性能,这表明一些“额外”的 Token 起到了噪声而非信号的作用。
将文本检测和定位作为训练任务。 这是产生指向行为的部分。作者不仅训练模型以自由文本形式回答问题,还训练它执行文本检测(在特定位置查找并转录文本)和定位(给定一个短语,返回其边界框)。关键在于,他们将位置信息融入模型的回答本身,因此当 TextMonkey 回答“总计是多少”时,响应可以包含它读取该答案的位置坐标。这使得原本不透明的答案变得可验证。
通过微调理解截图。 模型还通过有针对性的微调获得了解析 UI 截图(应用程序界面、网页)的能力,将相同的文档阅读技能扩展到一个截然不同的视觉领域:稀疏、布局密集、以图标和按钮驱动,而非密集的文字段落。
数据及其实际含义
TextMonkey 在 12 个基准测试上进行了评估,这些测试分为三类:
- 以场景文本为中心的任务(读取现实世界照片中的文本——如路标、产品标签):STVQA、TextVQA、OCRVQA。提升幅度:5.2%。
- 面向文档的任务(结构化文档——表单、信息图、图表、表格):DocVQA、InfoVQA、ChartVQA、DeepForm、Kleister Charity、WikiTableQuestions。提升幅度:6.9%。
- 关键信息抽取(从半结构化文档中提取特定字段——例如从发票中提取“供应商名称”和“应付金额”):FUNSD、SROIE、POIE。提升幅度:2.8%。
面向文档的任务类别表现出最大的提升(6.9%),这与论文自身的定位相符:正是在这里,移位窗口分辨率处理和令牌过滤技术最能发挥作用,因为密集的表单和表格正是早期模型在低分辨率下容易丢失信息的场景。
场景文本识别(在自然照片中而非清晰扫描件中发现并读取分散的文本)提升了 10.9%,这是论文中最大的单项提升数值。这很可能是明确在识别和定位任务上训练模型,而非将定位视为事后补充所带来的直接收益。
在包含 29 个 OCR 相关子任务的综合基准测试 OCRBench 上,TextMonkey 得分为 561,领先于当时用于文档理解的先前开源大型多模态模型。该领域的 OCRBench 分数更新迅速,通常在一两年内就会被超越,因此应将 561 视为“2024 年 3 月的最先进水平”,而非永久排名,但与先前开源模型的相对差距仍然有助于说明架构选择所带来的优势。
当前仍存在的不足
论文并未深入探讨局限性,但有几个差距值得明确指出。
令牌过滤步骤依赖相似度来判断冗余,这是一种启发式方法。这可能会导致偶尔丢弃低频但重要的令牌,例如只出现一次且与页面上其他内容不“相似”的小印章或微弱水印。论文报告了整体性能提升,但这只是基准测试的平均值,并不能保证在特定困难案例中不会出现错误。
定位准确性取决于底层阅读能力。如果模型误读了一个数字,它绘制的边界框会自信地指向错误的证据。定位提供了可验证性,而非正确性。这比“相信我”有了显著改进,但并不是证明。
此外,这里的基准测试仍然主要是英语和西方文档格式。论文摘要中并未提及对多语言文档、手写表单或现实世界积压中更混乱的扫描件(倾斜、低对比度、咖啡渍)进行测试。干净的基准测试性能与混乱的现实世界性能相关,但并不相同。
为什么这对任何构建或购买 OCR 的人都很重要
如果您正在为产品选择文档 AI 引擎,那么这里提到的“定位(grounding)”能力是您应该关注的重点,其重要性甚至超过了原始基准测试数据。一个只能输出“总计为 $482.19”的模型,在您出错时无法提供任何纠错手段。而一个同时输出数字及其边界框(bounding box)的模型,则允许您构建一个用户界面,让人类审核者一眼就能看到高亮区域并确认或拒绝,而无需重新阅读整个文档。对于任何涉及金钱、合同或合规性的工作流程来说,这种差异就是“可以抽查的 OCR”与“必须完全信任的 OCR”之间的区别。鉴于中文等表意文字系统拥有数千个字符且版面密集,这种基于视觉定位的验证机制对于确保高密度文本识别的准确性尤为关键。
这也是一个数据点,反映了从“先 OCR 再解析”的流水线向“单次读取并理解”的单一模型转变的大趋势。这一转变在我们跟踪的许多模型中都有体现,它改变了那些假设 OCR 文本提取和文档理解是由不同工具分步完成的现有基础设施的计算逻辑。这些步骤正日益融合,而那些跳过中间交接环节的模型在文档密集型基准测试中胜出,原因很简单:OCR 字符串与读取它的模型之间不会发生任何信息丢失。
从实用角度来看,Token 效率的角度也很重要。如果您正在大规模运行推理,一种既能减少冗余 Token 又能提高准确性的技术是罕见的,足以引起注意:效率和质量提升通常不会同时出现,但在这里它们确实同时实现了。