La IA que lee planos como un ingeniero, no como un escáner
Basado en: Drawing-Recode: Annotation Grounding for Parametric CAD Code Generation from Raster 2D CAD Drawings — Mingi Kim, Yongjun Kim, Hyungki Kim
En alguna planta de fabricación, en este mismo instante, hay un archivador lleno de planos de piezas que ya nadie puede pedir. Un soporte de 1994, dimensionado a mano, fotocopiado tantas veces que las líneas se han desdibujado. La empresa que fabricó la pieza original ya no existe. El ingeniero que la diseñó se jubiló hace una década. Pero un cliente aún necesita ese soporte exacto, y el único registro de él es una hoja de papel plana.
Para fabricar esa pieza en una máquina CNC moderna o una impresora 3D, alguien tiene que convertir el plano de nuevo en un modelo 3D paramétrico y funcional: no una imagen de la pieza, sino un conjunto de instrucciones que un ordenador pueda redimensionar, editar y mecanizar. Hoy en día, eso significa que un técnico de CAD se sienta y redibuje todo el plano a mano, leyendo cada dimensión del papel y volviéndola a introducir en el software. Es lento, es caro y es exactamente el tipo de tarea con la que un buen sistema de IA debería poder ayudar.
Un nuevo artículo titulado Drawing-Recode, de los investigadores Mingi Kim, Yongjun Kim y Hyungki Kim, intenta automatizar ese flujo de trabajo: se introduce un plano 2D escaneado y se obtiene código CAD funcional. Lo interesante no es solo que intente hacer esto. Es el problema específico que los autores identifican como el verdadero cuello de botella, y es uno que la mayoría de los sistemas relacionados con el OCR ignoran silenciosamente.
La brecha entre leer un número y comprender qué mide
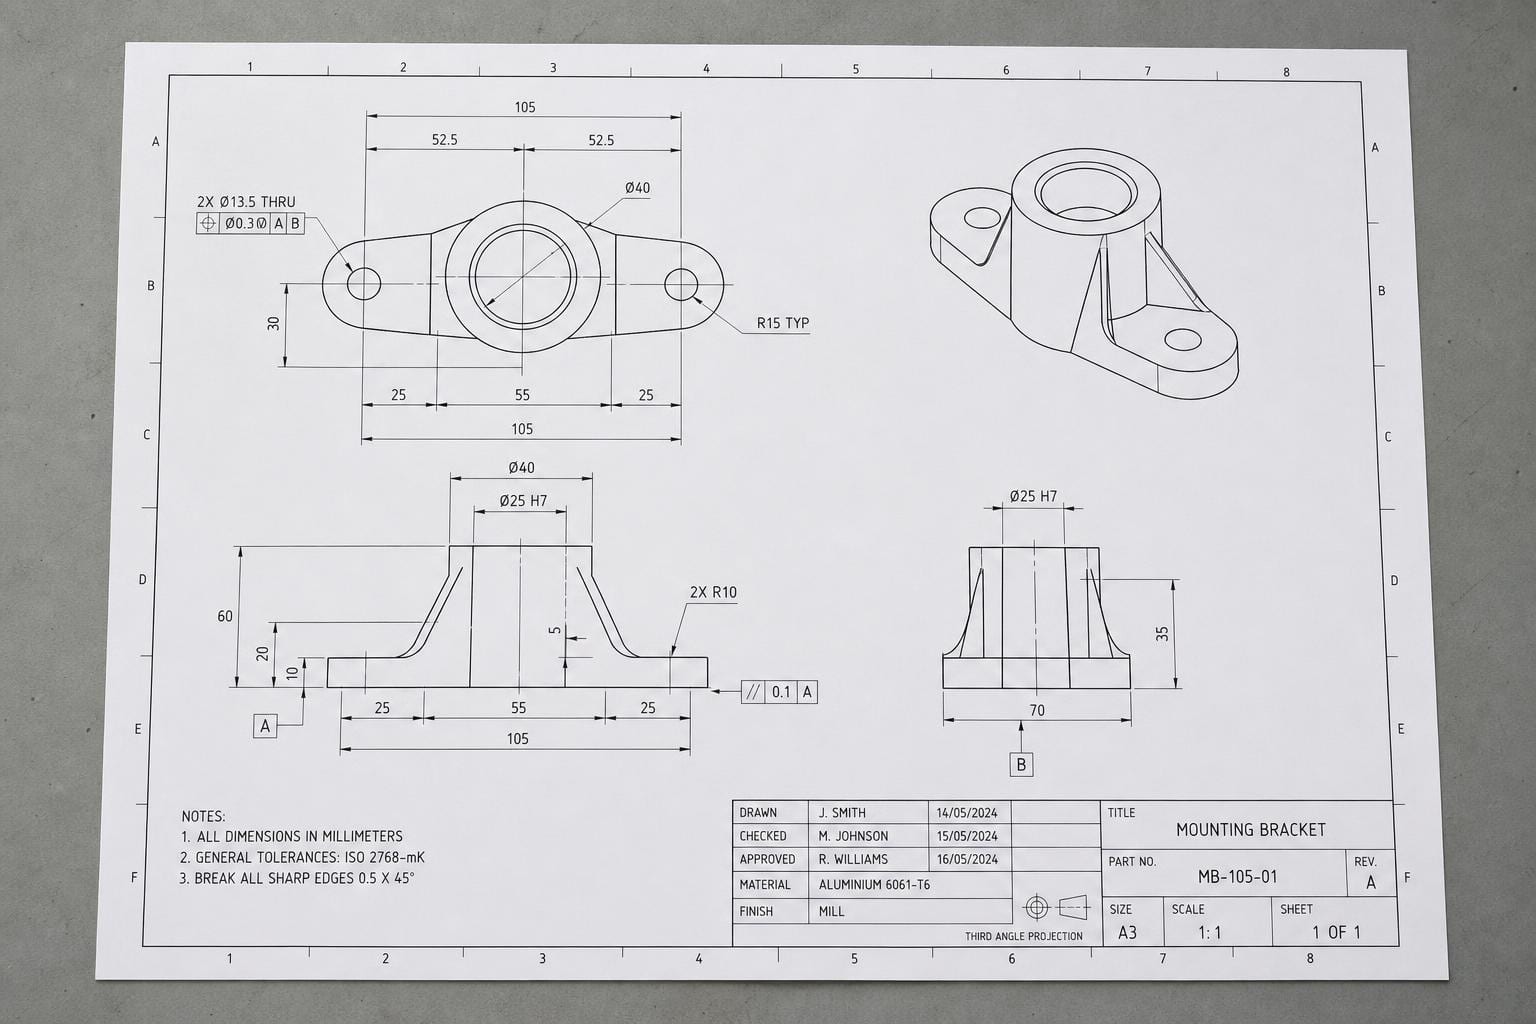
Comencemos con una distinción que es fundamental aquí: raster frente a vector. Un archivo CAD vectorial (como un DXF o un archivo nativo de SolidWorks, por ejemplo) almacena la geometría como datos estructurados: esta línea va desde el punto A hasta el punto B, este círculo tiene este radio. Una imagen raster son simplemente píxeles. Un plano escaneado, una foto de un plano técnico, un PDF que en realidad es una imagen subyacente, todos estos son raster. No tienen estructura alguna, solo puntos de color que, para el ojo humano, parecen líneas y texto.
Leer el texto de un plano CAD raster es un problema resuelto (o casi). El OCR puede extraer "Ø25" o "50.5" de una página con bastante precisión, incluyendo los símbolos de cota. Eso no es de lo que se trata realmente Drawing-Recode.
El problema más difícil es este: una vez que has leído "50.5" en la página, ¿a qué pertenece? Un plano CAD no es un formulario con campos etiquetados. Es una imagen de una pieza, con una dispersión de líneas de cota y números que apuntan a bordes, orificios y superficies específicas. Un "50.5" cerca de un rectángulo probablemente describe su ancho, pero podría describir la diagonal, la separación de un orificio, o algo que está a tres líneas de distancia y que la línea de extensión simplemente cruza. Si esa vinculación es incorrecta, no obtienes una pieza ligeramente desviada. Obtienes una pieza que es estructuralmente incorrecta, porque un modelo CAD paramétrico es una secuencia de operaciones (trazar este rectángulo, extruirlo esta distancia, cortar este orificio) donde cada paso depende de que los números estén asociados a la geometría correcta.
El enfoque del artículo es que los sistemas anteriores funcionan solo con planos vectoriales (que ya tienen esta estructura incorporada, por lo que no hay nada que resolver) o son estrechos, diseñados para un tipo de plano o una industria específica, y ninguno de ellos conecta explícitamente una anotación con la geometría que describe. Tratan el reconocimiento de texto y el reconocimiento de geometría como tareas separadas y esperan que la conexión se resuelva por sí misma en etapas posteriores. Por lo general, no lo hace.
Cómo Drawing-Recode vincula un número con la línea que mide
La arquitectura tiene varias piezas distintas, y la más interesante está en el medio.
Primero, un codificador de imágenes examina el dibujo rasterizado y extrae características geométricas: esencialmente, una representación interna rica de las líneas, curvas y formas en la página, independiente de cualquier texto. Por separado, un módulo de reconocimiento de texto lee las anotaciones: los números de cota, tolerancias y etiquetas dispersas por el dibujo. Hasta ahora, esto es IA documental estándar, dos lectores especializados trabajando en paralelo.
La contribución real es lo que sucede a continuación. Drawing-Recode utiliza cross-attention (atención cruzada), un mecanismo que permite que un conjunto de características "observe" otro conjunto y decida qué es relevante, para conectar cada anotación reconocida con las características geométricas específicas que describe. Piénselo como el modelo aprendiendo a dibujar sus propias líneas de extensión: dado el texto "50.5", aprende a buscar en la representación geométrica el borde que ese número mide con mayor probabilidad, de la misma manera que el ojo humano sigue una línea de cota desde el número hasta el contorno de la pieza.
Para hacer que esa conexión sea confiable en lugar de aproximada, los autores agregan algo que llaman Annotation Grounding Loss (AGL). Una "pérdida" (loss) en el aprendizaje automático es simplemente la penalización que recibe el modelo durante el entrenamiento cuando su salida es incorrecta, la señal que utiliza para mejorar. Una configuración de entrenamiento normal podría solo penalizar al modelo por obtener el código CAD final incorrecto. AGL agrega una penalización adicional y explícita por obtener incorrecto el vínculo entre anotación y geometría, incluso antes de llegar a la salida final. Esa es una elección de diseño deliberada: en lugar de esperar que el anclaje correcto surja como un efecto secundario de una buena generación de código, entrenan al modelo para obtener el anclaje correcto por sus propios términos.
Una vez que la geometría, el texto reconocido y los vínculos anclados entre ellos se combinan en un único conjunto de características, esto se alimenta a un modelo de lenguaje grande (LLM), la misma familia de modelos detrás de herramientas como ChatGPT, adaptado aquí para generar código en lugar de prosa. La salida no es una imagen ni un conjunto de coordenadas. Es código CAD en lo que los autores llaman formato Structured Parametric CAD Code (SPCC): una secuencia de operaciones como "dibujar este perfil, extruirlo 12 mm, cortar un agujero de 6 mm aquí" que un programa CAD puede ejecutar para reconstruir el modelo 3D real, totalmente editable, no solo una forma estática.
Lo que encontraron y la parte que realmente importa para el uso en el mundo real
El artículo informa que Drawing-Recode supera a los métodos de referencia existentes en la recuperación de secuencias CAD paramétricas correctas a partir de dibujos en formato ráster. Esto es de esperar. Cualquier nuevo método presentado en un artículo debe superar a lo que vino antes, de lo contrario, no hay artículo.
El resultado más revelador es la segunda afirmación: el sistema mantiene su robustez en dibujos escaneados que se asemejan a condiciones industriales reales. Esto merece una reflexión, porque es la diferencia entre una demostración y una herramienta. Los renderizados CAD limpios y de alta resolución son el caso fácil. Los dibujos del mundo real, los que están guardados en ese archivador, son fotocopias de fotocopias, desvanecidos, ligeramente rotados, con manchas de café y marcas de lápiz que la IA debe sortear. Un sistema que solo funciona bien con entradas impecables está resolviendo un problema que nadie tiene realmente. Los autores diseñaron específicamente y probaron contra escaneos degradados, lo que sugiere que entendieron que el caso de laboratorio limpio nunca fue el punto central.
Dicho esto, el resumen no proporciona los números duros, porcentajes de precisión, comparaciones exactas con las líneas base ni tamaños de conjuntos de datos, por lo que hay que tratar "supera" y "mantiene su robustez" como afirmaciones direccionales respaldadas por experimentos, en lugar de un marcador que se pueda citar directamente. Si estás decidiendo si construir sobre esto, el mecanismo (anclaje explícito mediante cross-attention y una pérdida dedicada) es la idea transferible, más que cualquier número específico de referencia en este artículo inicial.
Por qué importa para cualquiera que construya o elija OCR
Si ampliamos la perspectiva más allá del CAD específicamente, hay una lección aquí para la IA de documentos en general, que es precisamente el territorio de OpenOCR.
Una gran cantidad del procesamiento de documentos del mundo real no es "leer el texto". Es "determinar a qué elemento pertenece cada texto". Un ítem de una factura debe vincularse con el SKU correcto y el total correcto. La casilla de verificación de un formulario médico debe vincularse con la etiqueta adyacente, no con la etiqueta de tres filas arriba. El marcador de nota al pie de un estado financiero debe vincularse con el número que anota. En todos estos casos, el OCR básico te proporciona los caracteres y falla por completo al obtener la relación. Esa relación es generalmente donde reside el valor real.
Drawing-Recode es un estudio de caso claro sobre cómo resolver ese problema de relaciones intencionalmente, en lugar de esperar que un modelo lo aprenda por accidente. La decisión de diseño explícita, una función de pérdida dedicada solo para el anclaje (grounding), una cross-attention que arquitectónicamente se fuerza a conectar las dos modalidades, es la parte que vale la pena recordar incluso si nunca tocas un dibujo CAD. Cuando estés evaluando un motor de OCR o IA de documentos para una tarea que implique anotaciones, etiquetas o referencias cruzadas (no solo texto continuo), pregúntale al proveedor si su sistema modela explícitamente esos enlaces o simplemente extrae texto y geometría por separado y te deja unirlos. La brecha entre esos dos enfoques es generalmente donde residen los problemas de precisión.
Para los usuarios de OpenOCR específicamente, esto también señala una categoría que vale la pena vigilar: los motores construidos para una tarea estrecha pero profunda, como la digitalización de piezas, tienden a superar al OCR de propósito general en esa tarea, incluso cuando el motor de propósito general tiene un mayor presupuesto de entrenamiento detrás. Si estás digitalizando archivos de ingeniería, la mejor opción probablemente no sea ejecutar un motor de OCR genérico y escribir código de integración personalizado para adivinar a qué líneas pertenecen los números. Se trata de encontrar o construir algo más cercano al enfoque de Drawing-Recode, donde el enlace es parte del modelo, no un añadido posterior en el postprocesamiento.
Dónde sigue quedando corto
Hay algunas lagunas que destacan, algunas reconocidas por el enfoque del artículo, otras simplemente inherentes al método descrito.
El alcance se limita a planos 2D que producen secuencias paramétricas 3D para piezas individuales, no para ensamblajes completos. Un archivo de fabricación real no consiste solo en planos de piezas unitarias; incluye planos de ensamblaje con múltiples componentes, subreferencias y llamadas cruzadas entre hojas ("ver detalle en la hoja 3"). Nada en el resumen sugiere que Drawing-Recode maneje aún ese caso más amplio.
También existe el riesgo habitual con cualquier generación de código basada en LLM: una salida fluida y estructuralmente válida no es lo mismo que una salida dimensionalmente correcta. Una secuencia SPCC generada puede parecer correcta, extruir la forma adecuada en la dirección correcta y, aun así, estar construida a partir de un número mal leído o una decisión de anclaje ligeramente errónea. Para un artículo de blog, es una curiosidad. Para una pieza fabricada que se atornillará en una máquina, es la diferencia entre un repuesto funcional y un error muy costoso. El resumen no describe ninguna etapa de verificación posterior que compruebe el código generado frente a tolerancias físicas, lo cual es el tipo de salvaguarda que esto necesita antes de que alguien lo aplique a piezas de producción sin supervisión.
Y como la mayoría de los modelos de reconocimiento especializados, la calidad de los datos de entrenamiento es el techo. Un modelo tan ajustado para leer convenciones de anotación específicas de CAD presumiblemente se ha entrenado con datos específicos de CAD, lo que significa que su rendimiento con estilos de dibujo, convenciones de símbolos o industrias fuera de esa distribución de entrenamiento es una pregunta abierta que el artículo no pretende responder.
Nada de eso socava la idea central. Anclar explícitamente las anotaciones a la geometría, en lugar de tratar el reconocimiento de texto y el reconocimiento de formas como dos tareas que simplemente ocurren cerca una de la otra, es el instinto correcto, y es algo que todo el campo de la IA para documentos podría beneficiarse de adoptar con más frecuencia.