TrOCR: ¿Qué pasa cuando desechas todo el manual de estrategias de OCR?
Basado en: TrOCR: Transformer-based Optical Character Recognition with Pre-trained Models — Minghao Li, Tengchao Lv, Jingye Chen, Lei Cui, Yijuan Lu, Dinei Florencio, Cha Zhang, Zhoujun Li, Furu Wei
El fin de los parches en el OCR
Imagine el pipeline de OCR que se implementaba en casi todos los sistemas de producción antes de 2021. Una CNN analizaba la imagen y extraía características visuales. Una RNN leía esas características de izquierda a derecha y predecía los caracteres uno por uno. Luego, debido a que las predicciones de la RNN solían ser deficientes, se añadía un modelo de lenguaje independiente al final para limpiar la salida, corrigiendo, por ejemplo, "rn" por "m" y solucionando las otras quince formas en que un escáner puede deformar un recibo.
Tres modelos, tres regímenes de entrenamiento, tres conjuntos de errores. Esa es la configuración que TrOCR (Microsoft, 2021) desecha. Su propuesta es simple: usar un Transformer para la imagen, un Transformer para el texto, pre-entrenar ambos y saltarse por completo el paso de limpieza con un modelo de lenguaje independiente. Sin CNN. Sin RNN. Sin correctores ortográficos añadidos a posteriori. Y según el paper, este diseño más sencillo supera a los sistemas especializados y ajustados manualmente que reemplaza, ya sea en texto impreso, manuscrito o de escenas.
Esa es la parte sorprendente que merece un análisis. El OCR es uno de esos campos donde décadas de trucos acumulados suelen vencer a una arquitectura limpia. TrOCR es un caso donde la arquitectura limpia ganó de todos modos.
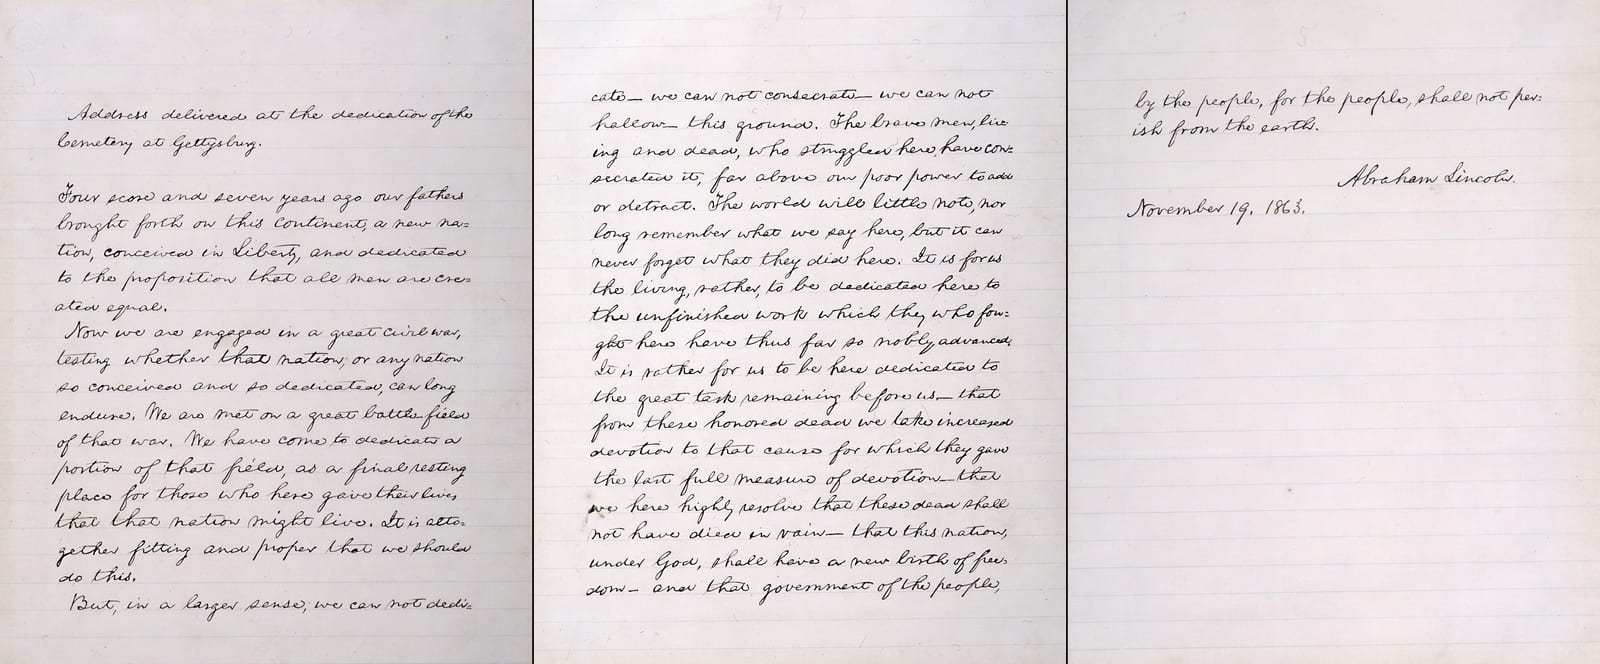
The Bliss copy of the Gettysburg Address, in Abraham Lincoln's hand (1864); public domain, via Wikimedia Commons.

Por qué el OCR es un problema más complejo de lo que parece
Si nunca has construido un sistema de OCR, es fácil asumir que la parte difícil es "leer las letras". No lo es. Lo complicado es que la conversión de imagen a texto son en realidad dos problemas unidos, y fallan de maneras distintas.
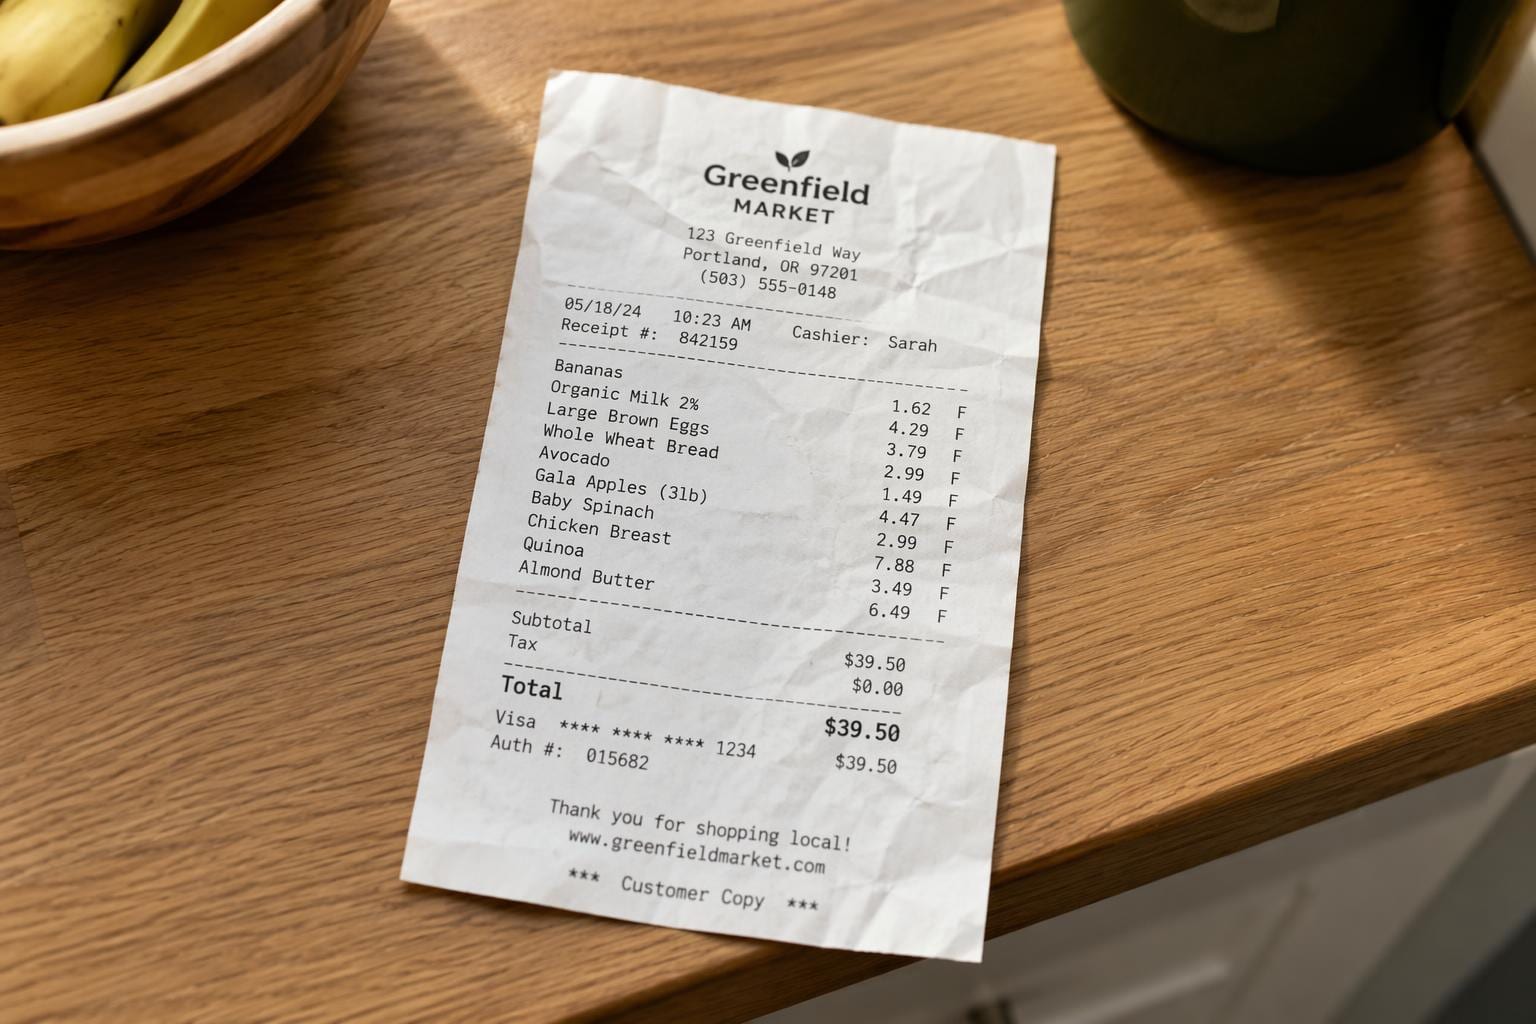
El primer problema: entender qué hay en la imagen. Las fuentes varían. La escritura a mano varía aún más, a veces tanto que dos muestras de la misma persona apenas se parecen. Los recibos escaneados tienen pliegues, sombras y manchas de café. Las fotos de señales callejeras tienen ángulos e iluminación extraños.
El segundo problema: generar texto coherente a partir de esas pistas visuales. Un modelo puede identificar correctamente cada trazo de una palabra y, aun así, producir algo sin sentido, porque reconocer formas y generar secuencias válidas son habilidades diferentes. Es por esto que los pipelines tradicionales añadieron el lenguaje modelo en primer lugar. El componente de visión era bueno en el "a qué se parece esto" y malo en el "cuál sería una palabra real en este contexto".
La solución tradicional —RNNs para la decodificación más un modelo de lenguaje acoplado— funciona, pero es frágil de una manera específica: cada corrección ataca un modo de fallo sin afectar a los demás. La calidad de imagen borrosa es un problema de visión. La ortografía extraña y los problemas de delimitación de palabras son un problema de lenguaje. Terminas parcheando cada pieza por separado, y las costuras entre ellas se convierten en su propia fuente de errores.
La idea real: dos Transformers pre-entrenados comunicándose entre sí
La estrategia de TrOCR consiste en notar que ambas mitades del problema, "comprender una imagen" y "generar una secuencia plausible", ya cuentan con excelentes soluciones pre-entrenadas, solo que originalmente no fueron diseñadas para interactuar entre sí.
Para la parte de la imagen, TrOCR utiliza un codificador Vision Transformer (estilo ViT), ya pre-entrenado en grandes conjuntos de datos de imágenes. En lugar de una CNN que desliza filtros sobre los píxeles, un Transformer divide la imagen en una cuadrícula de patches y permite que cada patch preste atención a todos los demás. Esto es fundamental específicamente para el texto: la atención de un Transformer puede conectar directamente un carácter en el borde izquierdo de una palabra con uno en el borde derecho, algo que las CNN aproximan de manera más laboriosa a través de capas apiladas.
Para la parte del texto, TrOCR utiliza un decodificador Transformer, pre-entrenado al estilo de los grandes modelos de lenguaje: predecir la siguiente pieza de texto basándose en lo anterior. Crucialmente, no genera carácter por carácter, sino que lo hace mediante wordpieces (fragmentos de subpalabras, el mismo esquema de tokenización utilizado por los modelos estilo BERT y GPT). Esta es una decisión de diseño significativa: predecir "ing" como un solo token en lugar de "i", "n", "g" como tres suposiciones separadas permite que el modelo se apoye en el mismo tipo de conocimiento lingüístico que hace que la generación de texto moderna sea fluida, en lugar de depender de un corrector ortográfico añadido posteriormente.
Ambas mitades parten de modelos pre-entrenados en sus dominios nativos (imágenes, texto) y luego se someten a un fine-tuning conjunto para la tarea de OCR propiamente dicha. Esa receta de dos etapas —pre-entrenar por separado y ajustar conjuntamente— es la verdadera contribución del artículo. La arquitectura (un codificador Transformer alimentando a un decodificador Transformer) no es nueva. Lo novedoso es utilizarla para unificar la comprensión de imágenes y la generación de texto en un único modelo diferenciable que no requiere una etapa separada de modelo de lenguaje.
En la práctica, esto significa que la tercera etapa tradicional, el modelo de lenguaje post-hoc, desaparece. El conocimiento lingüístico no se añade a posteriori; está integrado en el decodificador desde el pre-entrenamiento y se ajusta conjuntamente con la parte de visión, en lugar de operar como un parche independiente.
El truco de entrenamiento que lo hace funcionar: primero datos sintéticos, luego datos reales
Los Transformers son conocidos por su voracidad de datos, y los datos de OCR etiquetados (un humano transcribiendo exactamente lo que dice una imagen escaneada) son costosos de producir a gran escala. TrOCR soluciona esto mediante el pre-entrenamiento sintético: se generan millones de imágenes de texto renderizado utilizando diversas fuentes, fondos y distorsiones, donde la "etiqueta" es simplemente el texto utilizado para renderizar la imagen. No se necesitan humanos, ya que se conoce de antemano la verdad fundamental (ground truth); tú mismo la creaste.
Las cifras son la clave. TrOCR se pre-entrena con cientos de millones de estas imágenes sintéticas de líneas de texto antes de tocar cualquier conjunto de datos etiquetado por humanos. Solo después de esto, se realiza el ajuste fino (fine-tuning) con benchmarks reales etiquetados por humanos, mucho más pequeños (como SROIE para recibos o IAM para escritura a mano). Este es el mismo patrón que permitió el éxito de los modelos de lenguaje extensos: un pre-entrenamiento abundante, económico y "cuasi-sintético", seguido de una pequeña dosis de datos de ajuste fino costosos y de alta calidad. TrOCR aplica esa misma receta a la conversión de visión a texto en lugar de texto a texto.
Lo que realmente encontraron
En texto impreso (la tarea de reconocimiento de recibos SROIE), TrOCR-large alcanza un F1 del 96.4%, superando al mejor sistema previo en esa clasificación. Los recibos son un caso de prueba genuinamente complejo: diseños variables, impresión térmica desvanecida y fuentes inconsistentes entre los sistemas POS de diferentes tiendas. Superar aquí a un sistema especializado, probablemente ajustado específicamente para las peculiaridades de los recibos, utilizando una arquitectura general es un resultado contundente, no marginal.
En escritura a mano (el dataset IAM, un benchmark consolidado basado en formularios manuscritos escaneados), TrOCR registra una tasa de error de caracteres (character error rate) de alrededor del 2.89%, situándose nuevamente por delante de los enfoques state-of-the-art anteriores, que consistían en pilas de CNN-RNN-language-model diseñadas a medida. Intuitivamente, la escritura a mano es el problema más difícil de los dos, ya que la forma de las letras varía mucho entre autores, por lo que el hecho de que una arquitectura Transformer general se mantenga firme aquí es el resultado más sólido de los dos.
En texto de escena (fotos de texto en entornos reales, como letreros de tiendas o empaques de productos tomados en ángulo, en ICDAR y otros benchmarks), TrOCR también supera a los sistemas de comparación reportados en el artículo. El texto de escena es típicamente la categoría más brutal del OCR: la distorsión de perspectiva, la oclusión y la iluminación inconsistente se suman al problema habitual de reconocimiento.
En las tres categorías —texto impreso, manuscrito y de escena— la misma arquitectura gana sin necesidad de un rediseño específico para cada tarea. Esa consistencia es más importante que cualquier cifra individual. Los sistemas state-of-the-art anteriores tendían a estar especializados por categoría; TrOCR es una sola receta aplicada tres veces.
Puntos débiles y por qué esto no es magia
Las cifras del artículo se refieren al reconocimiento a nivel de línea. TrOCR lee una línea de texto que ya ha sido localizada y recortada; no encuentra esa línea en la página por sí solo. En un sistema de producción real, se requiere un paso de detección independiente que determine dónde están las regiones de texto antes de que TrOCR pueda procesarlas. Ese problema de "dónde está el texto" (denominado text detection o layout analysis) es un área de investigación completamente distinta que TrOCR no aborda.
Los datos de pre-entrenamiento sintéticos, aunque voluminosos, siguen siendo sintéticos. Las fuentes renderizadas sobre fondos renderizados no capturan a la perfección el caos de un documento escaneado real: esquinas rotas, agujeros de grapas, daños por agua o las rayas de tóner de una fotocopiadora. La etapa de fine-tuning con datos reales etiquetados es lo que cierra esa brecha, pero esto implica que el techo de rendimiento de TrOCR para cualquier tipo de documento específico sigue dependiendo de qué tan bien se ajuste el set de datos de fine-tuning a dicho tipo de documento.
Además, el tamaño del modelo juega un papel fundamental. TrOCR-large es un modelo considerable, y los resultados más sólidos del artículo provienen de la variante large, no de las versiones base o small. La diferencia entre TrOCR-small y TrOCR-large es significativa, lo que significa que la viabilidad de implementar "TrOCR" depende en gran medida de qué tamaño estés ejecutando y de cuánto presupuesto de cómputo y latencia tengas disponible.
Por qué es importante para quien desarrolle o adquiera OCR
Si actualmente está evaluando motores de OCR, vale la pena comprender TrOCR por una razón específica: es un indicador claro de hacia dónde se movió todo el sector después de 2021. La mayoría de los modelos modernos de OCR y document-AI, incluidos muchos de los que aparecen ahora en catálogos de motores y comparativas de benchmarks, descienden de esta misma idea: un vision Transformer preentrenado que alimenta a un text Transformer preentrenado, ajustado (fine-tuned) de extremo a extremo, sin un modelo de lenguaje añadido a posteriori. Cuando vea un modelo más reciente que presuma de una arquitectura basada en Transformer en lugar de CNN-RNN, es muy probable que forme parte del linaje que llevó al campo hasta ese punto.
En la práctica, este cambio modificó la naturaleza de los casos "difíciles". Los antiguos pipelines de CNN-RNN más un modelo de lenguaje tenían más dificultades con cualquier elemento que el modelo de lenguaje no pudiera predecir: nombres propios inusuales, números de pieza, documentos en varios idiomas o cualquier caso donde el texto "correcto" no sea una palabra plausible de diccionario. Los enfoques basados en Transformer como TrOCR aún no son perfectos en estos casos —ningún modelo lo es—, pero el modo de fallo cambia. Dado que la comprensión del lenguaje está integrada en el preentrenamiento en lugar de ser un parche posterior, estos modelos tienden a ser más consistentes en diversos tipos de documentos, en lugar de destacar en texto impreso limpio y desplomarse ante una caligrafía más descuidada o fotos de escenas reales.
Para quien compare motores de OCR en la práctica: no se limite a verificar la precisión en documentos impresos limpios, ya que ese es el caso sencillo que casi todo el mundo maneja bien hoy en día. Evalúe el rendimiento específicamente en escritura a mano, recibos y texto de escenas (scene text) —las categorías que el paper de TrOCR señala como históricamente las más difíciles—, porque ahí es donde las decisiones arquitectónicas subyacentes de un motor determinado se reflejan realmente en las cifras.