TrOCR: क्या होता है जब आप OCR की पूरी प्लेबुक को हटा देते हैं
आधारित शोध-पत्र: TrOCR: Transformer-based Optical Character Recognition with Pre-trained Models — Minghao Li, Tengchao Lv, Jingye Chen, Lei Cui, Yijuan Lu, Dinei Florencio, Cha Zhang, Zhoujun Li, Furu Wei
पुराने OCR सिस्टम और TrOCR का उदय
कल्पना कीजिए उस OCR pipeline की जो 2021 से पहले लगभग हर production system में इस्तेमाल होती थी। एक CNN इमेज को देखता था और visual features निकालता था। फिर एक RNN उन features को बाएं से दाएं पढ़ता था और एक-एक करके characters का अनुमान लगाता था। चूंकि RNN के अनुमान अक्सर गलत होते थे, इसलिए आउटपुट को साफ करने के लिए बाद में एक अलग language model जोड़ा जाता था, जो "rn" को "m" में बदलता था और स्कैनर द्वारा रसीदों (receipts) में की गई अन्य गलतियों को ठीक करता था।
तीन मॉडल्स, ट्रेनिंग के तीन अलग तरीके और बग्स के तीन अलग सेट। यही वह सेटअप है जिसे TrOCR (Microsoft, 2021) ने पूरी तरह बदल दिया। इसका विचार सरल था: इमेज के लिए Transformer का उपयोग करें, टेक्स्ट के लिए Transformer का उपयोग करें, दोनों को pre-train करें, और अलग से language-model cleanup स्टेप को पूरी तरह हटा दें। कोई CNN नहीं। कोई RNN नहीं। कोई अलग से जोड़ा गया spell-checker नहीं। और पेपर के अनुसार, यह सरल डिज़ाइन उन विशेष, hand-tuned सिस्टम्स को मात देता है जिन्हें इसने रिप्लेस किया है—चाहे वह printed हो, handwritten हो या scene text।
यही वह चौंकाने वाला हिस्सा है जिस पर गौर करना जरूरी है। OCR उन क्षेत्रों में से एक है जहां दशकों से जमा किए गए 'जुगाड़' (hacks) आमतौर पर clean architecture पर भारी पड़ते हैं। TrOCR एक ऐसा उदाहरण है जहां clean architecture की जीत हुई।
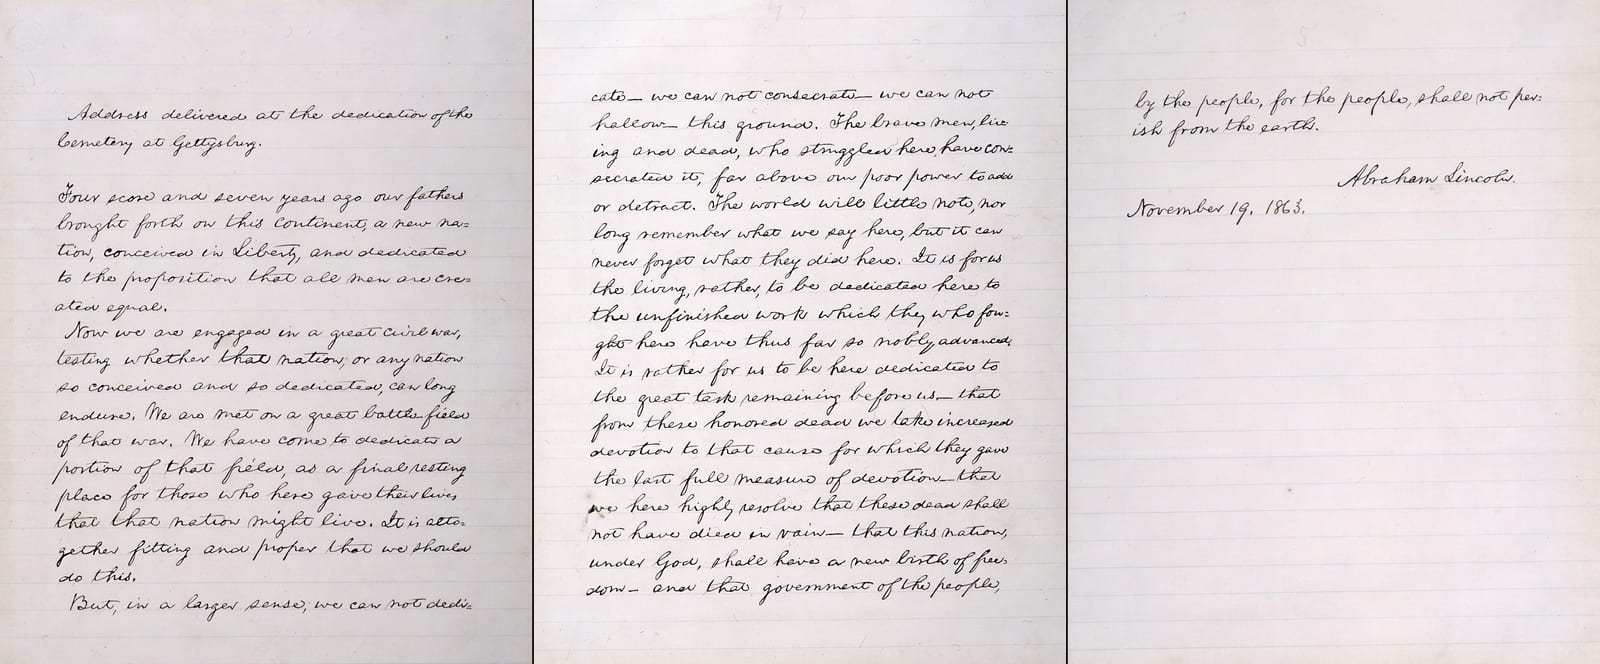
The Bliss copy of the Gettysburg Address, in Abraham Lincoln's hand (1864); public domain, via Wikimedia Commons.

OCR दिखने में जितना आसान लगता है, असल में उससे कहीं अधिक कठिन क्यों है
यदि आपने कभी OCR सिस्टम नहीं बनाया है, तो यह मान लेना आसान है कि सबसे कठिन काम "अक्षरों को पढ़ना" है। लेकिन ऐसा नहीं है। असल चुनौती यह है कि image-to-text वास्तव में दो अलग-अलग समस्याओं का मेल है, और दोनों के विफल होने के तरीके अलग-अलग होते हैं।
पहली समस्या: इमेज में क्या है, इसे समझना। Fonts अलग-अलग होते हैं। Handwriting और भी अधिक भिन्न होती है, कभी-कभी इतनी कि एक ही व्यक्ति के दो सैंपल्स में भी कोई समानता नहीं दिखती। स्कैन की गई रसीदों में सिलवटें, परछाइयां और कॉफी के दाग हो सकते हैं। स्ट्रीट साइन्स की तस्वीरों में अजीब एंगल और लाइटिंग हो सकती है।
दूसरी समस्या: उन विजुअल संकेतों (visual cues) से सुसंगत टेक्स्ट तैयार करना। एक मॉडल किसी शब्द के हर स्ट्रोक को सही ढंग से पहचान सकता है, फिर भी वह निरर्थक परिणाम दे सकता है, क्योंकि आकृतियों को पहचानना और वैध सीक्वेंस (valid sequences) तैयार करना दो अलग-अलग कौशल हैं। यही कारण है कि पारंपरिक पाइपलाइन्स में शुरुआत में language model को जोड़ा गया था। विजन कंपोनेंट "यह कैसा दिखता है" बताने में तो माहिर था, लेकिन "यहाँ वास्तव में कौन सा शब्द होना चाहिए" बताने में कमजोर था।
पारंपरिक समाधान—डिकोडिंग के लिए RNNs और साथ में एक bolted-on language model—काम तो करता है, लेकिन यह एक विशिष्ट तरीके से नाजुक (fragile) है: हर सुधार केवल एक विफलता (failure mode) को लक्षित करता है, जबकि अन्य अप्रभावित रहते हैं। धुंधली इमेज क्वालिटी एक विजन समस्या है। अजीब स्पेलिंग और word-boundary की समस्याएं एक लैंग्वेज समस्या हैं। अंततः आप हर हिस्से को अलग-अलग पैच करते हैं, और इन हिस्सों के बीच के जोड़ (seams) खुद बग्स का स्रोत बन जाते हैं।
असली विचार: दो pre-trained Transformers, जो एक-दूसरे से संवाद करते हैं
TrOCR की रणनीति यह पहचानना है कि इस समस्या के दोनों हिस्सों—"इमेज को समझना" और "एक सटीक सीक्वेंस जेनरेट करना"—के लिए पहले से ही बेहतरीन pre-trained समाधान उपलब्ध हैं, बस उन्हें मूल रूप से एक-दूसरे के साथ काम करने के लिए नहीं बनाया गया था।
इमेज साइड के लिए, TrOCR एक Vision Transformer (ViT-style) encoder का उपयोग करता है, जिसे पहले से ही बड़े इमेज डेटासेट्स पर pre-train किया गया है। पिक्सेल पर CNN फिल्टर्स चलाने के बजाय, एक Transformer इमेज को पैच के ग्रिड में तोड़ देता है और हर पैच को अन्य सभी पैच के साथ जुड़ने (attend करने) की अनुमति देता है। टेक्स्ट के मामले में यह विशेष रूप से महत्वपूर्ण है: एक Transformer का attention किसी शब्द के बाएं किनारे के अक्षर को सीधे दाएं किनारे के अक्षर से जोड़ सकता है, जबकि CNNs इसे कई लेयर्स के माध्यम से काफी मुश्किल तरीके से करते हैं।
टेक्स्ट साइड के लिए, TrOCR एक Transformer decoder का उपयोग करता है, जिसे उसी तरह pre-train किया गया है जैसे बड़े language models को किया जाता है: पिछले टेक्स्ट के आधार पर अगले हिस्से का अनुमान लगाना। महत्वपूर्ण बात यह है कि यह एक-एक अक्षर (character by character) जेनरेट नहीं करता। यह wordpieces (subword chunks, वही tokenization scheme जो BERT और GPT-style मॉडल्स द्वारा उपयोग की जाती है) में जेनरेट करता है। यह एक महत्वपूर्ण डिज़ाइन विकल्प है: "i", "n", "g" के तीन अलग-अलग अनुमानों के बजाय "ing" को एक टोकन के रूप में प्रेडिक्ट करना मॉडल को उसी भाषाई ज्ञान का लाभ उठाने देता है जो आधुनिक टेक्स्ट जनरेशन को सहज बनाता है, बजाय इसके कि वह बाद में किसी अलग spell-checker पर निर्भर रहे।
दोनों हिस्से अपने मूल डोमेन (इमेज, टेक्स्ट) पर pre-trained मॉडल्स से शुरू होते हैं और फिर उन्हें वास्तविक OCR टास्क पर एक साथ fine-tune किया जाता है। यह दो-चरणीय तरीका—अलग-अलग pre-train करना और फिर संयुक्त रूप से fine-tune करना—इस पेपर का असली योगदान है। आर्किटेक्चर (Transformer encoder जो Transformer decoder को फीड करता है) नया नहीं है। लेकिन इमेज अंडरस्टैंडिंग और टेक्स्ट जनरेशन को एक ही differentiable मॉडल में एकीकृत करना, जिसमें कोई अलग language-model स्टेज न हो, वास्तव में नया है।
व्यावहारिक रूप से, इसका मतलब है कि पारंपरिक तीसरा चरण, यानी post-hoc language model, खत्म हो जाता है। भाषाई ज्ञान को बाद में अलग से नहीं जोड़ा जाता; यह pre-training के माध्यम से decoder में ही समाहित होता है, और यह एक स्वतंत्र पैच के रूप में काम करने के बजाय विज़न हिस्से के साथ संयुक्त रूप से fine-tune होता है।
वह ट्रेनिंग ट्रिक जो इसे सफल बनाती है: पहले नकली डेटा, फिर असली डेटा
Transformers अपनी भारी डेटा भूख के लिए जाने जाते हैं, और लेबल किया हुआ OCR डेटा (जहाँ एक इंसान स्कैन की गई इमेज को देखकर उसे सटीक रूप से ट्रांसक्राइब करता है) बड़े पैमाने पर तैयार करना काफी महंगा होता है। TrOCR इस समस्या को 'synthetic pre-training' के जरिए हल करता है: इसमें अलग-अलग फोंट्स, बैकग्राउंड्स और डिस्टॉर्शन्स का उपयोग करके रेंडर किए गए टेक्स्ट की लाखों इमेज जेनरेट की जाती हैं, जहाँ "लेबल" वही टेक्स्ट होता है जिसका उपयोग इमेज बनाने के लिए किया गया था। इसमें इंसानों की ज़रूरत नहीं पड़ती, क्योंकि ग्राउंड ट्रुथ पहले से ही पता होता है; क्योंकि इसे आपने खुद बनाया है।
यहाँ के आंकड़े इसकी गवाही देते हैं। TrOCR किसी भी ह्यूमन-लेबल डेटासेट को छूने से पहले, इन करोड़ों सिंथेटिक टेक्स्ट-लाइन इमेजेस पर प्री-ट्रेन होता है। उसके बाद ही इसे बहुत छोटे, वास्तविक और ह्यूमन-लेबल बेंचमार्क्स (जैसे रसीदों के लिए SROIE, हैंडराइटिंग के लिए IAM) पर फाइन-ट्यून किया जाता है। यह वही पैटर्न है जिसने लार्ज लैंग्वेज मॉडल्स (LLMs) को सफल बनाया: पहले सस्ता और प्रचुर मात्रा में उपलब्ध सिंथेटिक-जैसा प्री-ट्रेनिंग डेटा, और उसके बाद महंगे, उच्च-गुणवत्ता वाले फाइन-ट्यूनिंग डेटा की एक छोटी खुराक। TrOCR इसी रेसिपी को text-to-text के बजाय vision-to-text पर लागू कर रहा है।
उन्हें वास्तव में क्या मिला
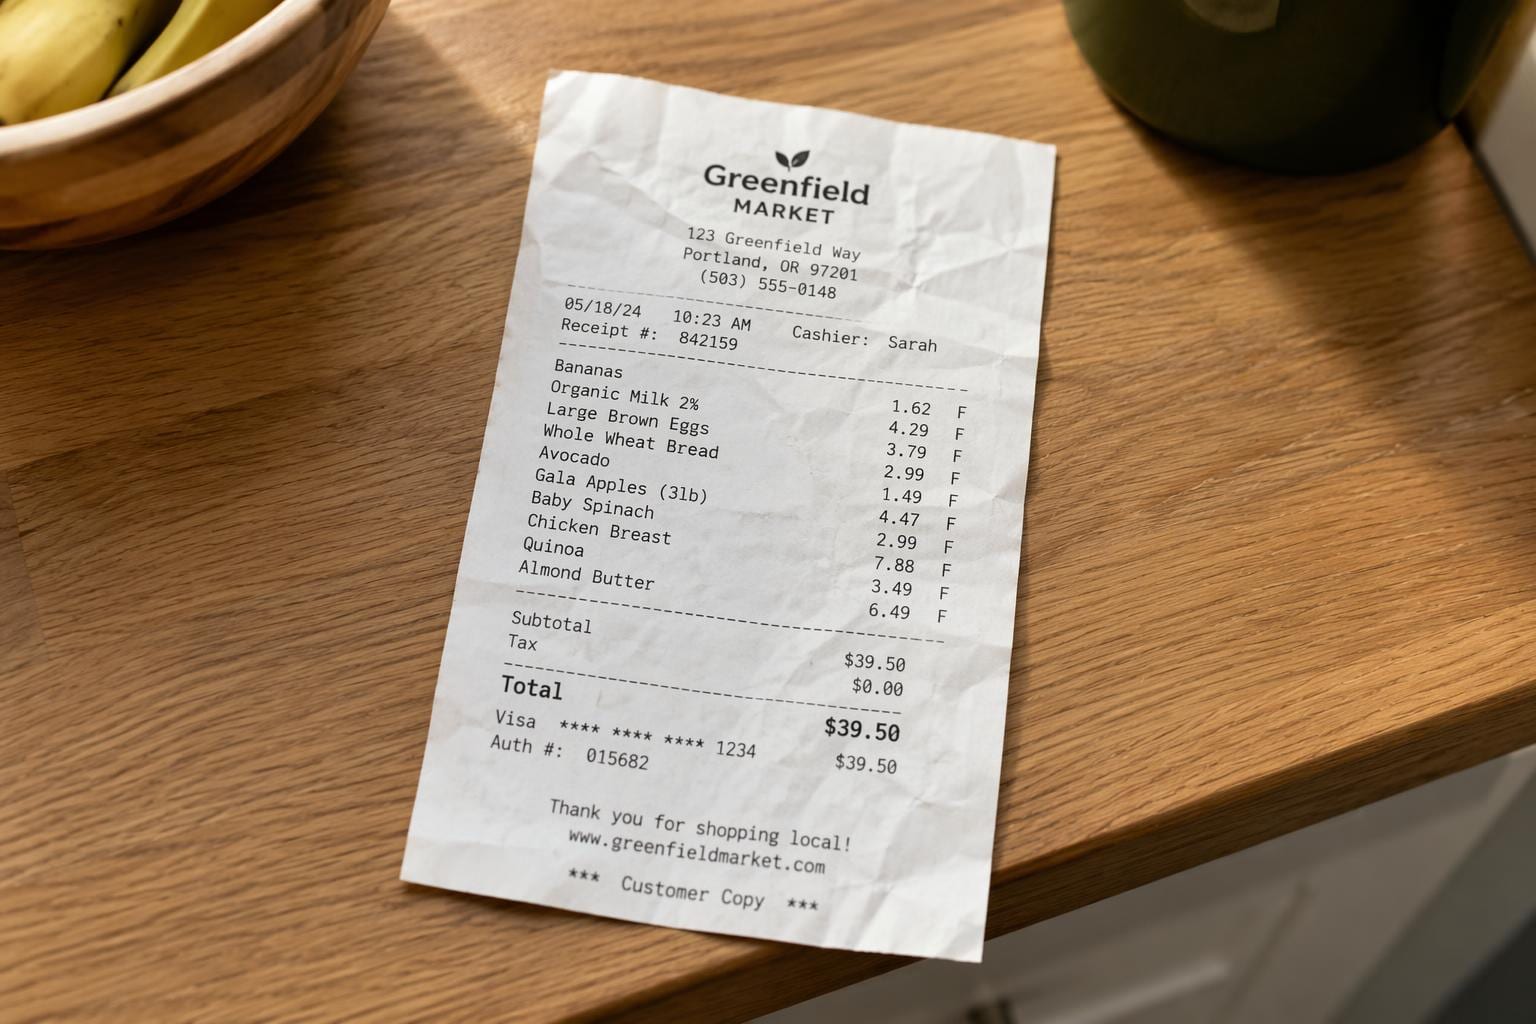
प्रिंटेड टेक्स्ट (SROIE रसीद-पहचान कार्य) पर, TrOCR-large ने 96.4% F1 स्कोर हासिल किया, जिससे उसने उस लीडरबोर्ड पर पिछले सर्वश्रेष्ठ सिस्टम को पीछे छोड़ दिया। रसीदें वास्तव में एक कठिन टेस्ट केस होती हैं: इनमें लेआउट अलग-अलग होते हैं, थर्मल प्रिंटिंग फीकी पड़ जाती है, और अलग-अलग स्टोर्स के POS सिस्टम में फोंट्स भी अलग होते हैं। यहाँ एक सामान्य आर्किटेक्चर के साथ एक स्पेशलाइज्ड सिस्टम को हराना—जो संभवतः रसीदों की बारीकियों के लिए ही ट्यून किया गया था—एक वास्तविक उपलब्धि है, न कि कोई मामूली सुधार।
हैंडराइटिंग (IAM डेटासेट, जो स्कैन किए गए हस्तलिखित फॉर्मों से बना एक पुराना बेंचमार्क है) पर, TrOCR ने लगभग 2.89% का कैरेक्टर एरर रेट दर्ज किया। यह एक बार फिर उन पिछले state-of-the-art दृष्टिकोणों से आगे था जो विशेष रूप से CNN-RNN-language-model स्टैक के रूप में बनाए गए थे। अधिकांश लोगों की समझ के अनुसार, हैंडराइटिंग इन दोनों समस्याओं में से अधिक कठिन है, क्योंकि अलग-अलग लेखकों के लिखने का तरीका बहुत भिन्न होता है, इसलिए यहाँ एक सामान्य Transformer आर्किटेक्चर का सफल होना इन दोनों परिणामों में से अधिक प्रभावशाली है।
सीन टेक्स्ट (प्राकृतिक वातावरण में टेक्स्ट की तस्वीरें, जैसे कि स्टोरफ्रंट साइन या किसी कोण से ली गई प्रोडक्ट पैकेजिंग, ICDAR और अन्य बेंचमार्क पर), TrOCR उन तुलनात्मक सिस्टमों से भी आगे निकला जिनका उल्लेख पेपर में किया गया है। सीन टेक्स्ट आमतौर पर OCR की सबसे चुनौतीपूर्ण श्रेणी होती है: इसमें सामान्य पहचान की समस्या के साथ-साथ पर्सपेक्टिव डिस्टॉर्शन, ऑक्लूजन (occlusion) और असंगत लाइटिंग जैसी मुश्किलें भी जुड़ जाती हैं।
तीनों श्रेणियों—प्रिंटेड, हैंडरिटन और सीन टेक्स्ट—में एक ही आर्किटेक्चर बिना किसी टास्क-स्पेसिफिक रीडिज़ाइन के जीतता है। यह निरंतरता किसी भी एक संख्या (metric) से अधिक मायने रखती है। पिछले state-of-the-art सिस्टम आमतौर पर प्रत्येक श्रेणी के लिए स्पेशलाइज्ड होते थे; जबकि TrOCR एक ही रेसिपी है जिसे तीन बार लागू किया गया है।
यह कहाँ कमजोर पड़ता है, और यह कोई जादू क्यों नहीं है
पेपर में दिए गए आंकड़े line-level recognition के लिए हैं। TrOCR टेक्स्ट की उस लाइन को पढ़ता है जिसे आप पहले ही लोकेट और क्रॉप कर चुके होते हैं; यह आपके लिए पेज पर उस लाइन को खुद नहीं ढूँढता। एक वास्तविक प्रोडक्शन सिस्टम में, TrOCR के देखने से पहले, एक अलग डिटेक्शन स्टेप (detection step) को यह पता लगाना होता है कि टेक्स्ट रीजन्स कहाँ हैं। यह "टेक्स्ट कहाँ है" वाली समस्या (जिसे text detection या layout analysis कहा जाता है) रिसर्च का एक पूरी तरह से अलग क्षेत्र है, और TrOCR इसमें कोई हस्तक्षेप नहीं करता।
सिंथेटिक प्री-ट्रेनिंग डेटा, भले ही बहुत बड़ा हो, फिर भी सिंथेटिक ही रहता है। रेंडर्ड बैकग्राउंड्स पर रेंडर्ड फोंट्स एक वास्तविक स्कैन किए गए दस्तावेज़ की अव्यवस्था को पूरी तरह से नहीं पकड़ पाते: जैसे फटे हुए कोने, स्टेपल के छेद, पानी से हुआ नुकसान, या फोटोकॉपीयर की टोनर धारियाँ। असली लेबल किए गए डेटा पर fine-tuning का चरण ही इस अंतर को कम करता है, लेकिन इसका मतलब यह है कि किसी विशिष्ट दस्तावेज़ प्रकार के लिए TrOCR की क्षमता अभी भी इस बात पर निर्भर करती है कि fine-tuning डेटा उस दस्तावेज़ प्रकार से कितनी अच्छी तरह मेल खाता है।
साथ ही, यहाँ मॉडल का आकार (model size) महत्वपूर्ण भूमिका निभा रहा है। TrOCR-large एक बड़ा मॉडल है, और पेपर के सबसे मजबूत आंकड़े large वेरिएंट से आए हैं, न कि base या small वेरिएंट से। TrOCR-small और TrOCR-large के बीच का अंतर काफी महत्वपूर्ण है, जिसका अर्थ है कि "TrOCR" की डिप्लॉयबिलिटी (deployability) इस बात पर बहुत अधिक निर्भर करती है कि आप वास्तव में किस साइज का मॉडल चला रहे हैं, और आपका लेटेंसी (latency) और कंप्यूट बजट कितना है।
OCR बनाने या खरीदने वालों के लिए यह क्यों महत्वपूर्ण है
अगर आप आज OCR engines का मूल्यांकन कर रहे हैं, तो TrOCR को समझना एक खास वजह से जरूरी है: यह इस बात का एक मजबूत संकेत है कि 2021 के बाद यह पूरा क्षेत्र किस दिशा में बढ़ा है। अधिकांश आधुनिक OCR और document-AI models, जिनमें से कई अब इंजन कैटलॉग और benchmark comparisons में दिखते हैं, इसी विचार पर आधारित हैं: एक pre-trained vision Transformer जो एक pre-trained text Transformer को फीड करता है, जिसे end-to-end fine-tune किया गया हो, और जिसमें कोई अलग से bolted-on language model न हो। जब आप किसी नए मॉडल को CNN-RNN के बजाय Transformer-based architecture का दावा करते हुए देखते हैं, तो बहुत संभावना है कि वह उसी lineage का हिस्सा है जिसने इस क्षेत्र को यहाँ तक पहुँचाया है।
व्यावहारिक रूप से, इस बदलाव ने "hard" cases की परिभाषा बदल दी है। पुराने CNN-RNN-plus-language-model pipelines उन चीजों के साथ सबसे ज्यादा संघर्ष करते थे जिन्हें language model प्रेडिक्ट नहीं कर पाता था: जैसे असामान्य proper nouns, part numbers, mixed-language documents, या ऐसी कोई भी चीज़ जहाँ "सही" टेक्स्ट कोई सामान्य dictionary word न हो। TrOCR जैसे Transformer-based approaches अभी भी इन पर पूरी तरह परफेक्ट नहीं हैं—कोई भी मॉडल नहीं है—लेकिन failure mode बदल गया है। चूंकि language understanding बाद में पैच करने के बजाय pre-training में ही शामिल है, इसलिए ये मॉडल्स अलग-अलग document types पर अधिक consistent रहते हैं, बजाय इसके कि वे केवल साफ printed text पर अच्छा प्रदर्शन करें और messy handwriting या scene photos पर फेल हो जाएं। हालांकि, यह ध्यान रखना जरूरी है कि अंग्रेजी के लिए मजबूत OCR का मतलब यह नहीं है कि Devanagari OCR भी उतना ही सटीक होगा, क्योंकि भारतीय लिपियों की जटिलता अलग होती है।
प्रैक्टिस में OCR engines की तुलना करने वालों के लिए: केवल साफ printed documents पर accuracy चेक न करें, क्योंकि यह आसान केस है जिसे अब लगभग हर कोई अच्छे से हैंडल कर लेता है। विशेष रूप से handwriting, receipts, और scene text पर performance चेक करें—वे श्रेणियां जिन्हें TrOCR के paper ने ऐतिहासिक रूप से सबसे कठिन बताया है—क्योंकि यहीं पर किसी इंजन के underlying architectural choices वास्तव में numbers में नजर आते हैं।