TrOCR:OCRの定石をすべて捨てると何が起こるか
元論文: TrOCR: Transformer-based Optical Character Recognition with Pre-trained Models — Minghao Li, Tengchao Lv, Jingye Chen, Lei Cui, Yijuan Lu, Dinei Florencio, Cha Zhang, Zhoujun Li, Furu Wei
OCRのパラダイムシフト
2021年以前のほぼすべての商用システムに搭載されていたOCRパイプラインを想像してみてください。まずCNNが画像を解析して視覚的特徴を抽出します。次にRNNがそれらの特徴を左から右へと読み取り、一文字ずつ文字を推測します。しかし、RNNの推測結果は不正確なことが多いため、後付けで別の言語モデルを組み込み、出力をクリーンアップさせます。「rn」を「m」に修正したり、スキャナーがレシートを読み間違える15通りものパターンを修正したりするためです。
3つのモデル、3つの学習体制、そして3つのバグの温床。これが、TrOCR (Microsoft, 2021) が打破した構成です。TrOCRの提案はシンプルです。画像にTransformerを使い、テキストにTransformerを使い、その両方を事前学習させることで、後付けの言語モデルによる修正ステップを完全に省くというものです。CNNも、RNNも、後付けのスペルチェッカーも不要です。論文によれば、このシンプルな設計が、印刷文字、手書き文字、シーンテキストのすべてにおいて、これまで使われてきた専門的で微調整を重ねたシステムを上回る性能を示しました。
こここそが、じっくり考える価値のある驚くべき点です。OCRは、数十年にわたって蓄積された「ハック(場当たり的な工夫)」が、クリーンなアーキテクチャに勝ることが一般的だった分野の一つです。TrOCRは、クリーンなアーキテクチャが最終的に勝利した稀な事例と言えるでしょう。
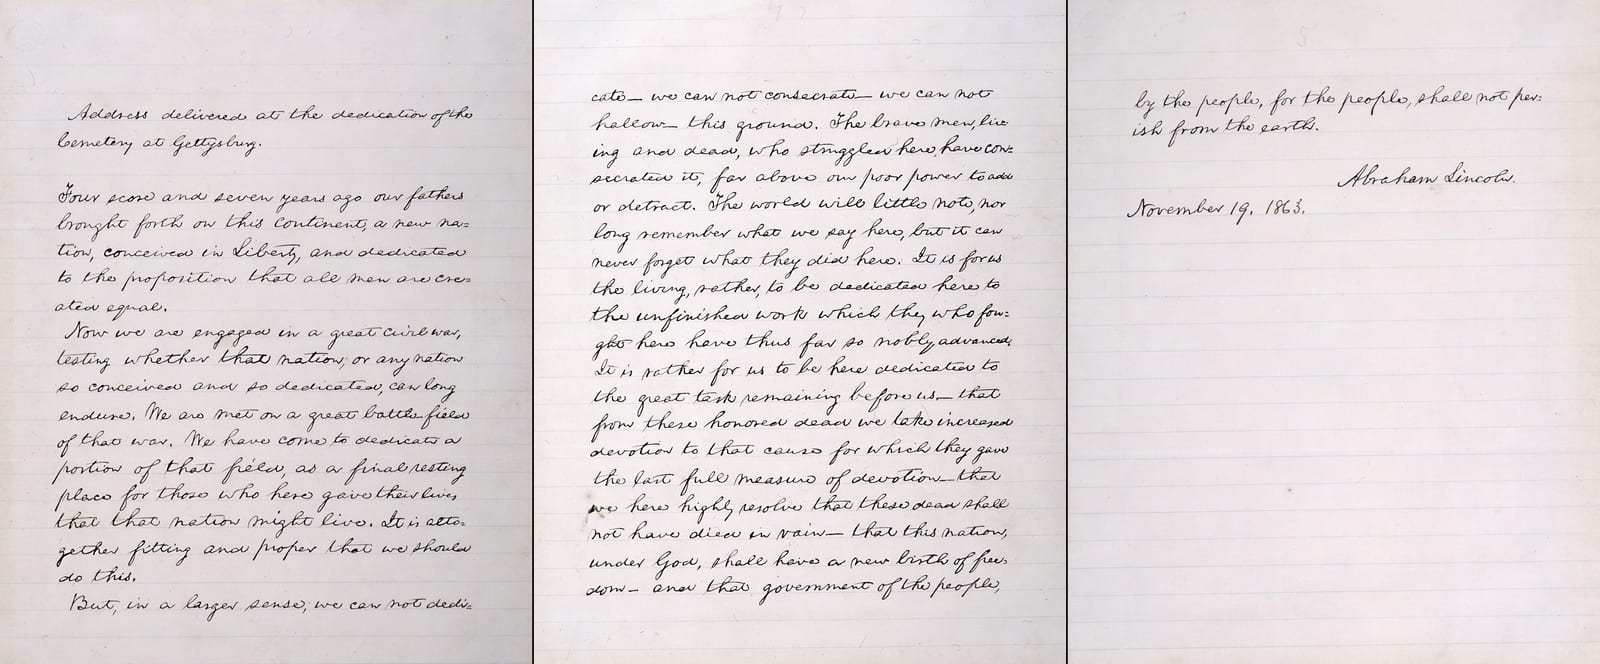
エイブラハム・リンカーンの自筆によるゲティスバーグ演説のブリス写本 (1864年);パブリックドメイン、Wikimedia Commons より。

OCRが想定以上に困難な問題である理由
OCRシステムを構築したことがない人は、最も難しいのは「文字を読み取ること」だと思いがちです。しかし、実際はそうではありません。本当に困難なのは、画像からテキストへの変換が実質的に2つの異なる問題が組み合わさったものであり、それぞれ失敗の仕方が異なる点にあります。
1つ目の問題は、「画像に何が写っているかを理解すること」です。フォントは多種多様です。手書き文字はさらにばらつきが大きく、同一人物が書いたものであっても、2つのサンプルがほとんど似ていないことさえあります。スキャンしたレシートには折り目や影、コーヒーのシミがついているかもしれません。道路標識の写真には、奇妙な角度や照明条件が伴います。
2つ目の問題は、「それらの視覚的な手がかりから、一貫性のあるテキストを生成すること」です。モデルが単語のすべてのストロークを正しく識別できたとしても、意味不明な出力を出すことがあります。なぜなら、「形状を認識すること」と「妥当なシーケンスを生成すること」は異なるスキルだからです。だからこそ、従来のパイプラインでは、そもそも言語モデルが追加されました。ビジョンコンポーネントは「これは何に見えるか」には長けていましたが、「ここにあるべき実際の単語は何か」という判断は苦手だったためです。
従来の解決策である「デコーディング用のRNNと後付けの言語モデル」という構成は機能はしますが、特有の脆弱性があります。それは、個々の修正が他の部分に影響を与えず、特定の失敗モードのみをターゲットにしている点です。画像のぼやけはビジョンの問題であり、不自然な綴りや単語の境界の問題は言語の問題です。結果として、各パーツを個別にパッチで修正することになり、パーツ間の継ぎ目そのものが新たなバグの原因となってしまいます。
核心となるアイデア:対話する2つの学習済みTransformer
TrOCRの画期的な点は、「画像を理解する」ことと「妥当なシーケンスを生成する」という問題の双方に対して、すでに優れた学習済みソリューションが存在することに着目した点にあります。ただ、それらは元々、互いに連携するように設計されていませんでした。
画像側において、TrOCRは大規模な画像データセットで学習済みのVision Transformer (ViTスタイル) エンコーダを採用しています。CNNのようにフィルタをピクセル上でスライドさせるのではなく、Transformerは画像をパッチのグリッドに分割し、各パッチが他のすべてのパッチを参照(attend)できるようにします。これは特にテキストにおいて重要です。TransformerのAttention機構は、単語の左端にある文字と右端にある文字を直接結びつけることができます。CNNでこれを実現しようとすると、層を積み重ねて近似的に処理する必要があり、非常に困難です。
テキスト側では、大規模言語モデルと同様の手法で学習済みのTransformerデコーダを使用しています。つまり、「それまでに現れたテキストに基づいて、次の断片を予測する」という仕組みです。重要なのは、文字単位ではなくwordpieces(BERTやGPTスタイルのモデルで採用されているサブワード単位のトークナイゼーション)で生成することです。これは意味のある設計上の選択です。「ing」を「i」「n」「g」という3つの独立した推測ではなく、1つのトークンとして予測することで、後付けのスペルチェッカーに頼ることなく、現代のテキスト生成を流暢にしている言語知識をそのまま活用できるからです。
これら両者は、それぞれのネイティブドメイン(画像、テキスト)で事前学習されたモデルから始まり、その後、実際のOCRタスクに合わせて共同でファインチューニングされます。「個別に事前学習し、共同でファインチューニングする」というこの2段階のレシピこそが、本論文の真の貢献です。アーキテクチャ(TransformerエンコーダからTransformerデコーダへ入力する構成)自体は新しいものではありません。しかし、画像理解とテキスト生成を一つの微分可能なモデルに統合し、独立した言語モデルステージを排除した点は斬新です。
実用上のメリットは、従来の第3段階であった「事後的な言語モデル」が不要になることです。言語知識を後から継ぎ足すのではなく、事前学習によってデコーダに組み込まれており、独立したパッチとして動作させるのではなく、ビジョン側と共に共同でファインチューニングされるためです。
成功の鍵となった学習トリック:擬似データを先に、実データを後に
Transformerは極めて大量のデータを必要とすることで知られていますが、ラベル付きのOCRデータ(人間がスキャン画像の内容を正確に書き起こしたもの)を大規模に作成するには多大なコストがかかります。TrOCRはこの問題を「合成データによる事前学習」で解決しました。多様なフォント、背景、歪みを加えてレンダリングしたテキスト画像を数百万枚生成し、その画像を作成した際に使用したテキストをそのまま「ラベル」とする手法です。正解(ground truth)は作成時に既に分かっているため、人間の手は一切必要ありません。
このアプローチの核心は、その規模感にあります。TrOCRは、人間がラベル付けしたデータセットに触れる前に、まず数億枚もの合成テキスト行画像で事前学習を行います。その後、はるかに小規模で高品質な、人間によるラベル付きのリアルなベンチマークデータ(レシート用のSROIEや手書き文字用のIAMなど)を用いてファインチューニングを行います。これは、大規模言語モデル(LLM)を成功させたパターンと同じです。つまり、「安価で大量の擬似的なデータで事前学習し、その後に少量の高コストで高品質なデータでファインチューニングする」という手法です。TrOCRは、このレシピを「text-to-text」ではなく「vision-to-text」に適用したと言えます。
実際の結果について
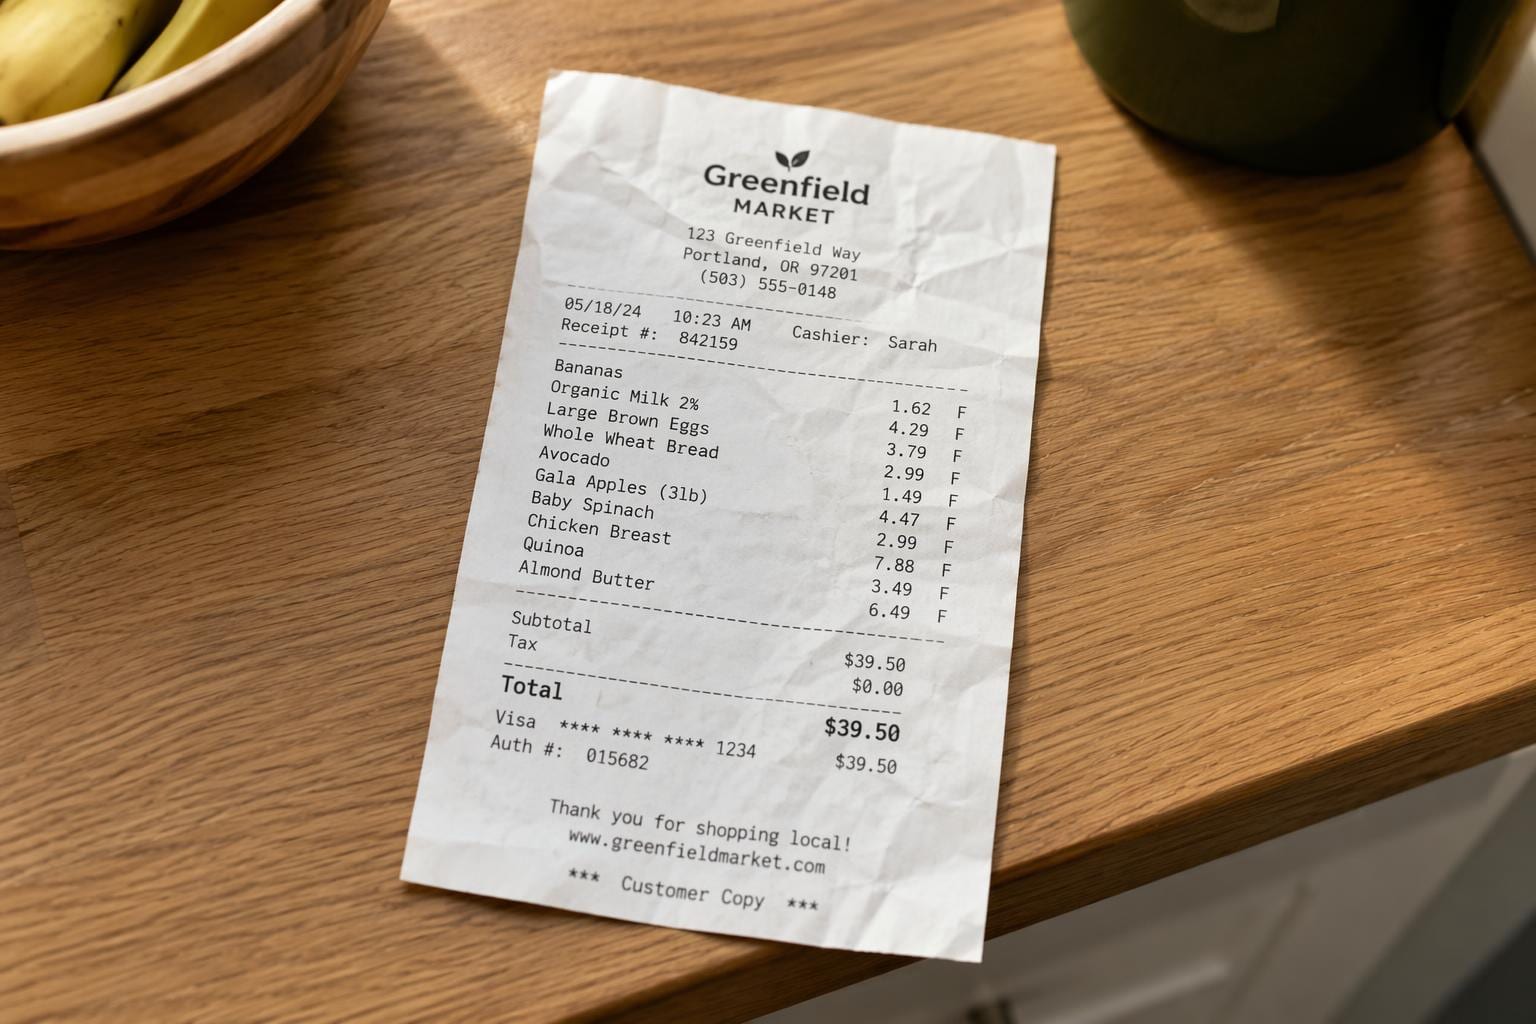
印刷テキスト(SROIEレシート認識タスク)において、TrOCR-largeはF1スコア96.4%を記録し、リーダーボード上の既存の最高システムを上回りました。レシートは、レイアウトの変動、感熱印刷のかすれ、店舗ごとのPOSシステムによるフォントの不一致など、非常に困難なテストケースです。レシート特有の癖に合わせて調整されたであろう専門的なシステムを、汎用的なアーキテクチャで打ち負かしたことは、単なる微増ではなく、実質的な成果と言えます。
手書き文字(スキャンされた手書きフォームから構築された長年のベンチマークであるIAMデータセット)では、TrOCRは文字誤り率(CER)約2.89%を記録しました。これも、CNN-RNN-言語モデルを組み合わせた専用設計の従来手法(SOTA)を上回る結果です。一般的に、書き手によって文字の形状が大きく異なる手書き文字の方が認識は難しいとされるため、汎用的なTransformerアーキテクチャがここで通用したことは、2つの結果の中でもより強力な成果と言えます。
シーンテキスト(ICDARなどのベンチマークにある、店舗の看板や製品パッケージなど、屋外で斜めに撮影されたテキスト写真)においても、TrOCRは論文で報告されている比較システムを上回りました。シーンテキストは通常、OCRにおいて最も過酷なカテゴリーです。通常の認識問題に加え、透視投影による歪み、遮蔽、不均一な照明といった要因がすべて重なるためです。
印刷、手書き、シーンテキストという3つのカテゴリーすべてにおいて、タスク固有の再設計を行うことなく、同一のアーキテクチャが勝利しました。この一貫性こそが、個々の数値以上に重要な意味を持ちます。従来のSOTAシステムはカテゴリーごとに特化させる傾向にありましたが、TrOCRは「一つのレシピを3回適用した」に過ぎないのです。
弱点と、これが「魔法」ではない理由
論文に記載されている数値は、行レベルの認識(line-level recognition)に基づいたものです。TrOCRは、すでに位置が特定され、クロップ(切り出し)された1行のテキストを読み取るものであり、ページ上のどこにその行があるかを自ら探すわけではありません。実際のプロダクションシステムでは、TrOCRに渡す前に、別の検出ステップ(detection step)を用いてテキスト領域を特定する必要があります。この「テキストがどこにあるか」という問題(テキスト検出またはレイアウト解析と呼ばれます)は全く別の研究領域であり、TrOCRはこの部分をカバーしていません。
また、事前学習に使用された合成データは膨大ですが、あくまで合成データです。レンダリングされた背景にレンダリングされたフォントを載せただけでは、実際のスキャン文書にあるような「汚れ」——破れた角、ステープルの穴、水濡れ、コピー機のトナー汚れなど——を完全に再現することはできません。実データによるファインチューニング(fine-tuning)段階でこのギャップを埋めることになりますが、つまり、特定の文書タイプにおけるTrOCRの性能上限は、ファインチューニングデータがその文書タイプにどれだけ適合しているかに依存することを意味します。
さらに、モデルサイズが性能に大きく寄与しています。TrOCR-largeは巨大なモデルであり、論文で示された最高の数値はbaseやsmallではなく、このlargeバリアントによるものです。TrOCR-smallとTrOCR-largeの間には有意な性能差があるため、「TrOCR」を実際に導入できるかどうかは、どのサイズを運用し、どれほどのレイテンシと計算リソースの予算を割けるかに大きく左右されます。
OCRの構築や導入を検討している方にとって重要な理由
現在OCRエンジンを評価しているのであれば、TrOCRを理解しておく価値があります。なぜなら、2021年以降にこの分野がどのような方向へ進んだかを示す強力な指標となるからです。現在、エンジンのカタログやベンチマーク比較に登場する多くの最新OCRおよびドキュメントAIモデルは、同じコンセプトに基づいています。つまり、「事前学習済みのVision Transformerが事前学習済みのText Transformerに情報を渡し、後付けの言語モデルなしでエンドツーエンドにファインチューニングされる」という仕組みです。CNN-RNNではなくTransformerベースのアーキテクチャを謳う最新モデルを見かけた場合、それはおそらくTrOCRの流れを汲んでいると言えます。
実用面では、この転換によって「困難なケース」の定義が変わりました。従来の「CNN-RNN+言語モデル」のパイプラインでは、言語モデルが予測できない内容、例えば珍しい固有名詞や部品番号、多言語混在のドキュメントなど、辞書的な正解が導き出せないケースで特に苦戦していました。TrOCRのようなTransformerベースのアプローチでも、完璧なモデルは存在しませんが、失敗の傾向が異なります。言語理解が後付けではなく事前学習に組み込まれているため、綺麗な印刷体には強いが乱雑な手書き文字や風景写真では崩れるといった極端な差が出にくく、ドキュメントの種類を問わず一貫した性能を発揮する傾向があります。なお、本手法は主に水平方向のテキストを想定しており、日本語特有の縦書きレイアウトや複雑な漢字の組み合わせへの対応については十分にカバーされていない点に注意が必要です。
実際にOCRエンジンを比較される際は、単に綺麗な印刷ドキュメントでの精度を確認しないでください。それは今やどのモデルでも容易に処理できるケースだからです。TrOCRの論文でも歴史的に最難関とされている「手書き文字」「レシート」「シーンテキスト(看板などの自然風景内の文字)」でのパフォーマンスを重点的に確認してください。そこにこそ、採用されているアーキテクチャの真の実力が数値として現れるからです。