TrOCR:当你抛弃 OCR 的所有传统方案时会发生什么
参考论文: TrOCR: Transformer-based Optical Character Recognition with Pre-trained Models — Minghao Li, Tengchao Lv, Jingye Chen, Lei Cui, Yijuan Lu, Dinei Florencio, Cha Zhang, Zhoujun Li, Furu Wei
重新审视 OCR 的演进
想象一下 2021 年之前几乎所有生产系统中所采用的 OCR 流水线:首先由一个 CNN 扫描图像并提取视觉特征;接着由一个 RNN 从左到右读取这些特征,逐个预测字符。然而,由于 RNN 的预测结果往往质量堪忧,系统通常需要在末端强行挂载一个独立的语言模型来清理输出,将 "rn" 修正为 "m",并修复扫描仪在处理收据时产生的各种乱码。
三个模型,三套训练方案,三类 Bug。而 TrOCR (Microsoft, 2021) 直接摒弃了这套架构。它的核心理念是:图像端使用 Transformer,文本端同样使用 Transformer,对两者进行预训练,从而完全跳过独立的语言模型清理步骤。没有 CNN,没有 RNN,也没有外挂的拼写检查器。根据论文显示,这种更简洁的设计在印刷体、手写体和场景文本上的表现,均优于那些经过精心手工调优的专业系统。
这正是最令人惊讶且值得深思的地方。在 OCR 领域,几十年来积累的各种“技巧”通常比纯净的架构更有效。而 TrOCR 则证明了,纯净的架构最终也能胜出。
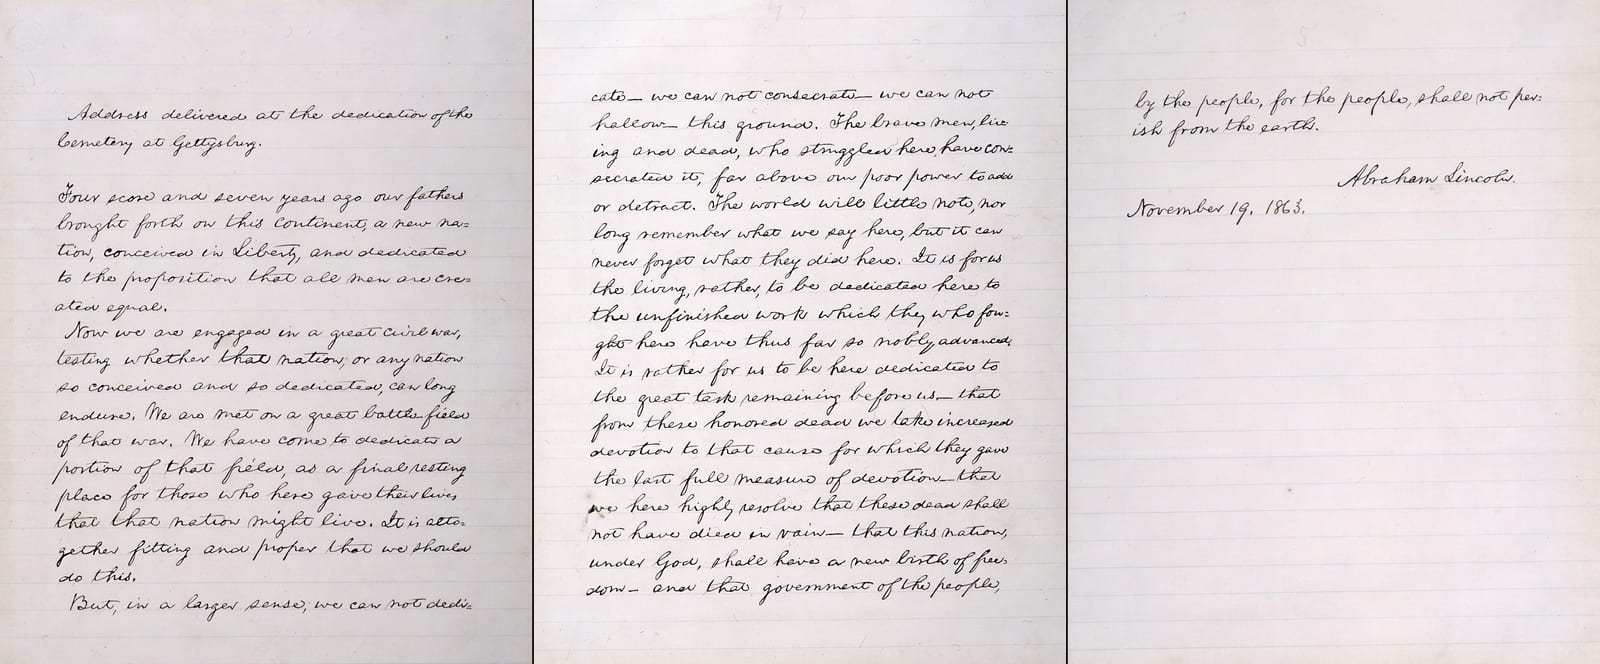
亚伯拉罕·林肯手写的《葛底斯堡演说》Bliss 副本 (1864);公有领域,由 Wikimedia Commons 提供。

为什么 OCR 比看起来更难
如果你从未构建过 OCR 系统,很容易认为最难的部分是“识别字母”。其实不然。真正的难点在于,图像转文本实际上是将两个截然不同的问题强行拼接在一起,而这两者失效的方式也完全不同。
第一个问题:理解图像中包含的内容。字体千差万别,手写体则更加多变,有时同一个人的两个样本之间几乎没有任何关联。扫描的收据可能有折痕、阴影和咖啡渍;街头路牌的照片则可能存在奇怪的角度和光照。
第二个问题:根据这些视觉线索生成连贯的文本。一个模型即使能正确识别单词的每一个笔画,依然可能输出毫无意义的内容,因为“识别形状”与“生成有效的序列”是两种不同的能力。这就是为什么传统流水线最初要引入语言模型——视觉组件擅长处理“这看起来像什么”,但不擅长处理“这里实际会出现什么单词”。
传统的解决方案(使用 RNN 进行解码并外接一个语言模型)虽然有效,但在某种程度上非常脆弱:每一次修复都只针对一种失效模式,而无法兼顾其他。图像模糊是视觉问题,拼写尴尬和词界识别错误则是语言问题。最终,你不得不分别对每个部分进行打补丁,而这些组件之间的接缝反而成了 Bug 的温床。
核心思路:两个相互协作的预训练 Transformer
TrOCR 的精妙之处在于它意识到,OCR 问题的两个核心环节——“理解图像”和“生成合理的序列”——都已经有了非常出色的预训练解决方案,只不过它们最初并非为了协同工作而设计。
在图像端,TrOCR 使用了一个 Vision Transformer (ViT-style) 编码器,该编码器已经在海量图像数据集上进行了预训练。不同于 CNN 通过滤波器在像素上滑动,Transformer 将图像分解为一系列 patch(图像块),并允许每个 patch 与其他所有 patch 进行注意力交互。这对于文本识别尤为重要:Transformer 的注意力机制可以直接将单词左边缘的字符与右边缘的字符连接起来,而 CNN 必须通过堆叠多层网络才能艰难地实现类似的近似效果。
在文本端,TrOCR 使用了一个 Transformer 解码器,其预训练方式与大语言模型一致:根据前文预测下一个文本片段。关键在于,它并非逐字符生成,而是以 wordpieces(子词块,即 BERT 和 GPT 类模型所采用的分词方案)为单位进行生成。这是一个极具意义的设计选择:将 "ing" 作为一个 token 预测,而不是将其拆分为 "i"、"n"、"g" 三次独立猜测,使模型能够利用让现代文本生成变得流畅的语言知识,而无需依赖下游强行挂载的拼写检查器。
这两个部分最初分别在各自的原生领域(图像、文本)进行预训练,随后在实际的 OCR 任务上进行联合微调。这种“分别预训练,联合微调”的两阶段方案才是该论文真正的贡献。其架构(Transformer 编码器喂给 Transformer 解码器)本身并不新鲜,但将其用于统一图像理解和文本生成,构建一个无需独立语言模型阶段的可微模型,则是其创新所在。
在实际应用中,这意味着传统的第三阶段——事后语言模型(post-hoc language model)——消失了。语言知识不再是事后强行补丁,而是通过预训练深植于解码器之中,并与视觉部分共同微调,而非作为一个独立的补丁运行。
让其生效的训练技巧:先伪数据,后真数据
众所周知,Transformers 对数据的需求量极大,而标注 OCR 数据(由人工精确转录扫描图像中的内容)的大规模生产成本极高。TrOCR 通过合成预训练(synthetic pre-training)巧妙地解决了这个问题:利用各种字体、背景和畸变效果生成数百万张渲染文本图像,此时的“标签”就是用于渲染图像的原始文本。由于图像是由系统生成的,真值(ground truth)已知,因此无需人工参与。
数据量揭示了其核心逻辑。TrOCR 在接触任何人工标注数据集之前,先在数亿张此类合成文本行图像上进行预训练。之后,它才在规模小得多的真实人工标注基准数据集(如用于收据的 SROIE 或用于手写体的 IAM)上进行微调。这与大语言模型(LLM)成功的模式如出一辙:先进行廉价且海量的类合成数据预训练,再辅以少量昂贵且高质量的微调数据。TrOCR 将这一方案从“文本到文本”迁移到了“视觉到文本”的领域。
实际研究结果
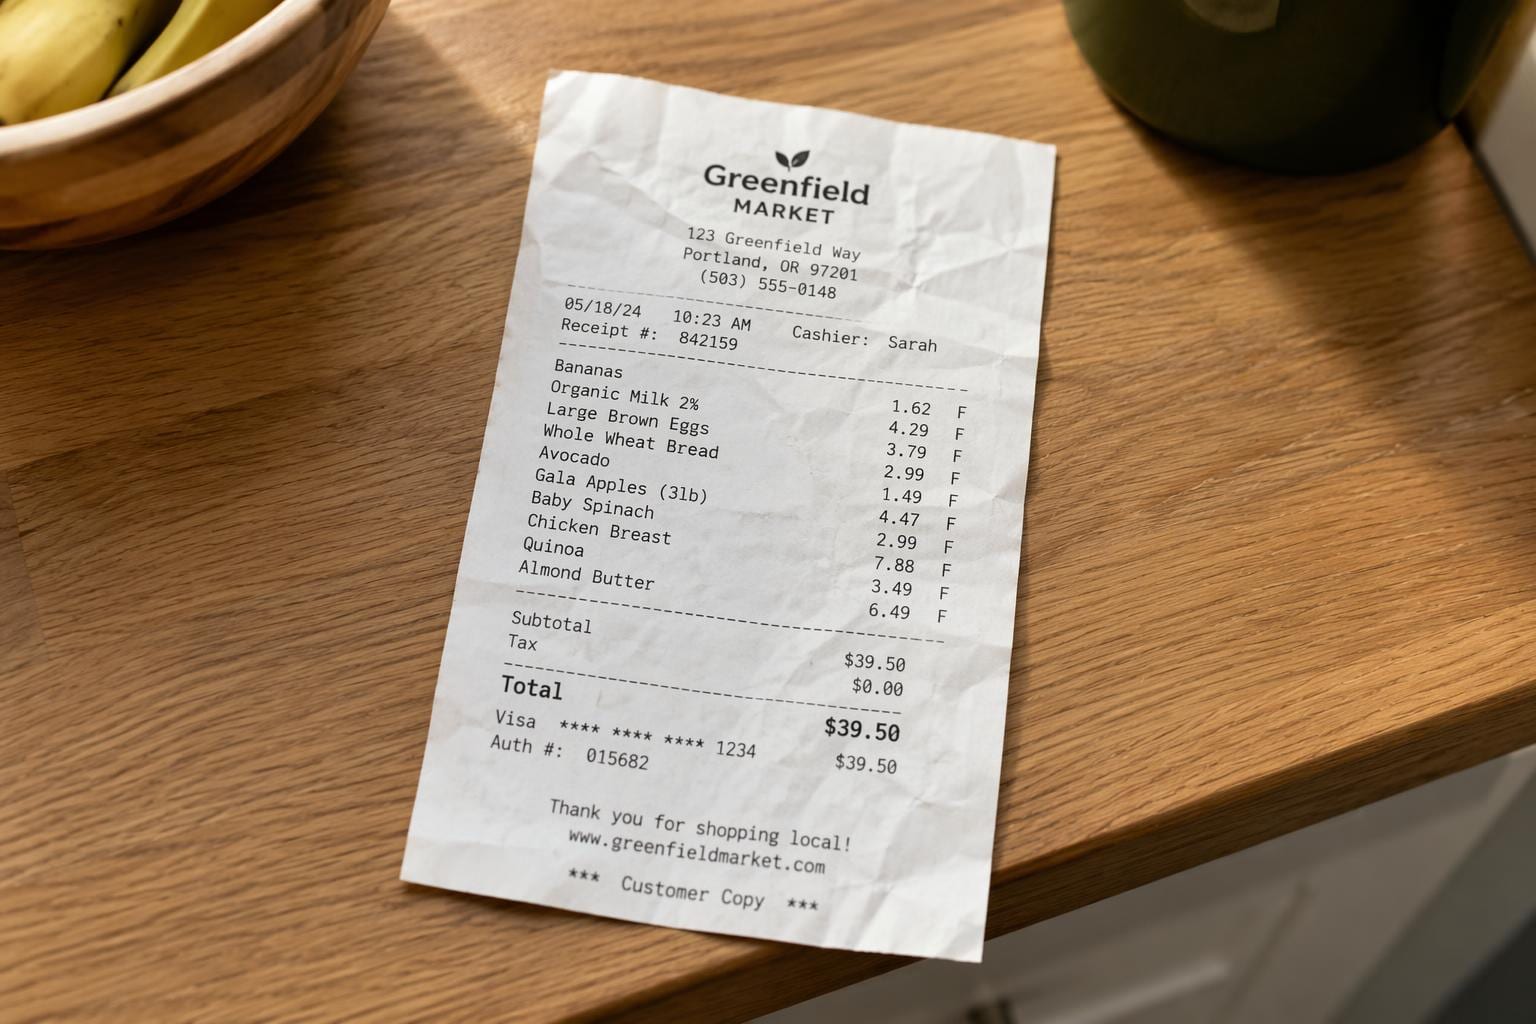
在印刷文本(SROIE 收据识别任务)上,TrOCR-large 达到了 96.4% 的 F1 分数,超越了该排行榜上之前的最佳系统。收据是一个极具挑战性的测试用例:布局多变、热敏打印褪色,且不同商店的 POS 系统字体不统一。能够用一个通用架构击败一个可能针对收据特性进行了专门调优的专业系统,这是一个实质性的突破,而非微小的提升。
在手写文本(IAM 数据集,一个基于扫描手写表单的长期基准测试)上,TrOCR 的字符错误率(CER)约为 2.89%,再次领先于之前那些由 CNN-RNN-语言模型堆叠而成的专用 SOTA 方法。在大多数人的直觉中,手写识别比印刷识别更难,因为不同书写者的字母形态差异极大,因此通用 Transformer 架构在此表现出色,是两个结果中更具说服力的一个。
在场景文本(自然场景中的文本照片,如倾斜拍摄的店面招牌或产品包装,基于 ICDAR 等基准测试)上,TrOCR 同样优于论文中报告的对比系统。场景文本通常是 OCR 中最残酷的类别:透视畸变、遮挡以及光照不均,这些因素在常规识别问题的基础上进一步增加了难度。
在印刷文本、手写文本和场景文本这三个类别中,同一套架构在无需针对特定任务重新设计的情况下全部获胜。这种一致性比任何单一的指标都更重要。之前的 SOTA 系统往往针对每个类别进行专业化定制,而 TrOCR 则是将同一套方案成功应用了三次。
局限性分析:为什么这并非魔法
论文中的数据是针对行级识别(line-level recognition)的。TrOCR 读取的是你已经定位并裁剪好的单行文本,它并不能帮你从页面中寻找这些行。在实际的生产系统中,仍然需要一个独立的检测步骤来确定文本区域的位置,然后才能交给 TrOCR 处理。这个“文本在哪里”的问题(称为文本检测或布局分析)是一个完全不同的研究领域,TrOCR 并不涉及此项功能。
尽管合成预训练数据的规模很大,但它终究是合成的。在渲染背景上生成的字体无法完美模拟真实扫描文档中的各种复杂情况:如撕裂的边角、订书钉孔、水渍或复印机的碳粉条纹。虽然在真实标注数据上进行微调(fine-tuning)可以弥补这一差距,但这意味着 TrOCR 在特定文档类型上的性能上限,仍然取决于微调数据与该文档类型的匹配程度。
此外,模型规模在其中起到了关键作用。TrOCR-large 是一个庞大的模型,论文中最强的数据来自 large 版本,而非 base 或 small 版本。TrOCR-small 与 TrOCR-large 之间存在显著的性能差距,这意味着“TrOCR”的实际部署可行性在很大程度上取决于你运行的模型尺寸,以及你所拥有的延迟容忍度和计算预算。
为什么这对构建或购买 OCR 的用户至关重要
如果你现在正在评估 OCR 引擎,那么理解 TrOCR 非常有必要,因为它是 2021 年后整个领域演进方向的一个强信号。目前大多数现代 OCR 和文档 AI 模型(包括许多出现在产品目录和基准测试对比中的模型)都源自同一个核心理念:由预训练的 Vision Transformer 引导预训练的 Text Transformer,并进行端到端微调,而不再是简单地外接一个语言模型。当你看到新模型标榜采用 Transformer 架构而非 CNN-RNN 时,它极有可能是 TrOCR 这一技术演进路线的产物。
在实际应用中,这种转变改变了“难点”的定义。传统的“CNN-RNN + 语言模型”流水线在面对语言模型无法预测的内容时最为吃力,例如罕见的专有名词、零件编号、多语言混合文档,以及任何不符合词典常识的“正确”文本。对于汉字等复杂且密集的表意文字识别,这种端到端的架构能更有效地捕捉空间布局与语义的关联。虽然像 TrOCR 这样的 Transformer 方法在这些场景下仍非完美,但其失效模式发生了变化。由于语言理解能力被植入预训练阶段而非事后修补,这些模型在不同文档类型之间表现得更加一致,而不会出现“在整洁的印刷体上表现卓越,但在凌乱的手写体或场景照片中崩溃”的情况。
对于在实践中对比 OCR 引擎的用户:不要只检查在整洁印刷文档上的准确率,因为那是目前几乎所有模型都能轻松处理的简单情况。请专门测试手写体、收据和场景文本的性能——这些正是 TrOCR 论文中指出的历史性难点。因为只有在这些场景下,引擎底层的架构选择才会真正体现在数据指标上。