TrOCR: ماذا يحدث عندما تتخلى عن جميع قواعد الـ OCR التقليدية
استنادًا إلى: TrOCR: Transformer-based Optical Character Recognition with Pre-trained Models — Minghao Li, Tengchao Lv, Jingye Chen, Lei Cui, Yijuan Lu, Dinei Florencio, Cha Zhang, Zhoujun Li, Furu Wei
تطور أنظمة التعرف الضوئي على الحروف (OCR)
تخيل مسار عمل OCR الذي كان مستخدماً في كل أنظمة الإنتاج تقريباً قبل عام 2021. تبدأ العملية بـ CNN يقوم بفحص الصورة واستخراج الميزات البصرية، ثم يأتي دور RNN ليقرأ هذه الميزات من اليسار إلى اليمين ويخمن الحروف واحداً تلو الآخر. وبسبب أن تخمينات RNN غالباً ما تكون غير دقيقة، يتم دمج نموذج لغوي منفصل في النهاية لتنقية المخرجات، بحيث يقوم مثلاً بتصحيح "rn" إلى "m" ومعالجة الطرق الخمس عشرة الأخرى التي قد يشوه بها الماسح الضوئي شكل الإيصال.
ثلاثة نماذج، ثلاثة أنظمة تدريب، وثلاث مجموعات من الأخطاء البرمجية. هذا هو بالضبط النظام الذي تخلى عنه نموذج TrOCR (Microsoft, 2021). تكمن فكرته في استخدام Transformer للصورة، و Transformer للنص، مع تدريب مسبق (pre-train) لكليهما، وتجاوز خطوة التنقية عبر النموذج اللغوي المنفصل تماماً. لا CNN، لا RNN، ولا مدقق إملائي مضاف. ووفقاً للورقة البحثية، فإن هذا التصميم الأكثر بساطة يتفوق على الأنظمة المتخصصة والمعدلة يدوياً في التعامل مع النصوص المطبوعة، والمكتوبة بخط اليد، ونصوص المشاهد (scene text).
هذا هو الجزء المثير للدهشة؛ فمجال OCR هو أحد تلك المجالات التي تتفوق فيها عادةً "الحلول الترقيعية" المتراكمة عبر عقود على البنية الهندسية النظيفة. لكن TrOCR يمثل حالة انتصرت فيها البنية النظيفة في نهاية المطاف.
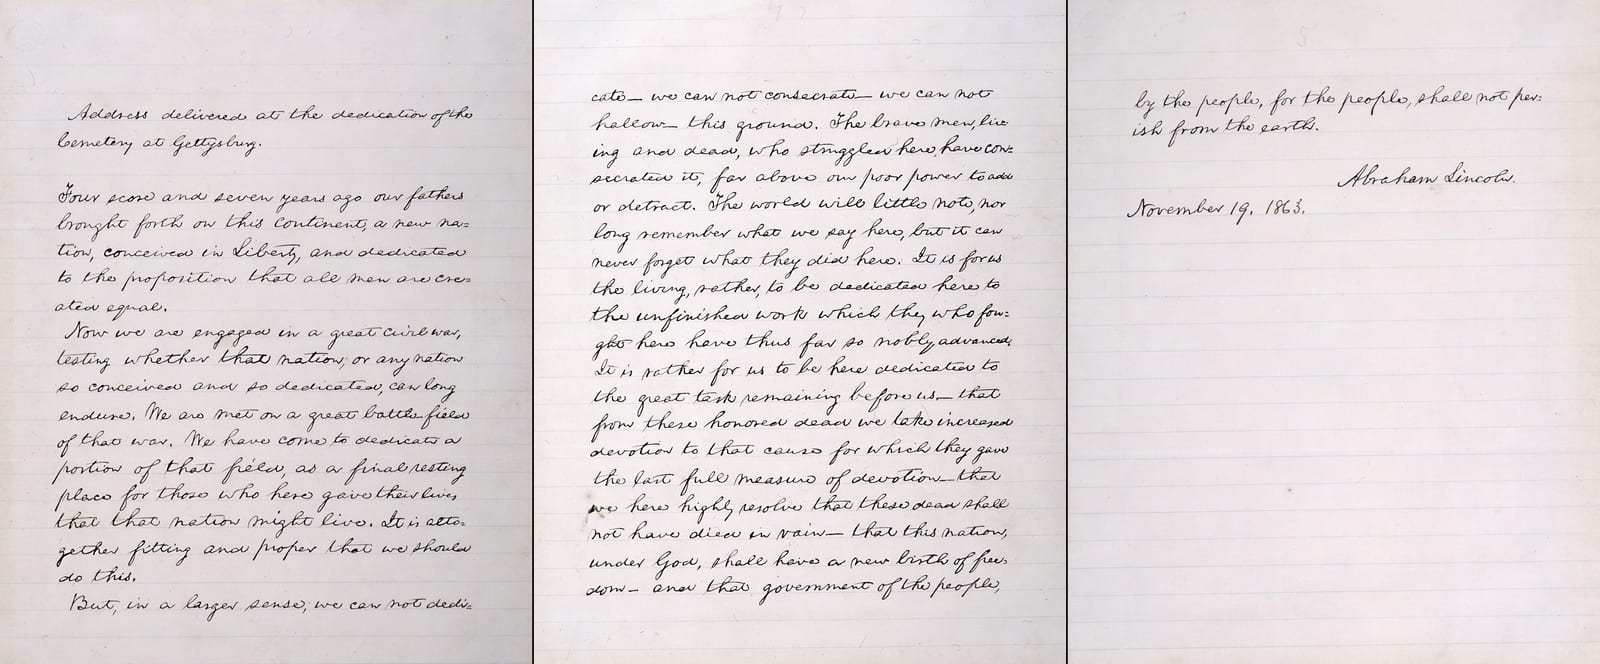
نسخة Bliss من خطاب غيتيسبيرغ، بخط يد أبراهام لينكولن (1864)؛ ملكية عامة، عبر Wikimedia Commons.

لماذا تُعد تقنية OCR مشكلة أصعب مما تبدو عليه
إذا لم يسبق لك بناء نظام OCR، فمن السهل أن تفترض أن الجزء الأصعب يكمن في "قراءة الحروف"، لكن الأمر ليس كذلك. تكمن الصعوبة في أن عملية تحويل الصورة إلى نص هي في الواقع مشكلتان مدمجتان معاً، وكل منهما تفشل بطريقة مختلفة.
المشكلة الأولى: فهم محتوى الصورة. فالخطوط تختلف، والكتابة اليدوية تختلف بشكل أكبر، لدرجة أن عينتين لنفس الشخص قد لا تبدوان مترابطتين أحياناً. كما أن الإيصالات الممسوحة ضوئياً تحتوي على ثنيات وظلال وبقع قهوة، بينما تعاني صور لافتات الشوارع من زوايا وإضاءة غريبة.
المشكلة الثانية: توليد نص متماسك من تلك الإشارات البصرية. فقد يتمكن النموذج من تحديد كل خط في الكلمة بشكل صحيح، ومع ذلك ينتج نصاً غير مفهوم؛ لأن التعرف على الأشكال وإنتاج تسلسلات نصية صحيحة هما مهارتان مختلفتان. وهذا هو السبب الذي جعل خطوط الإنتاج التقليدية تضيف الـ language model في المقام الأول؛ حيث كان مكون الرؤية (vision component) جيداً في الإجابة على سؤال "كيف يبدو هذا الشيء؟" ولكنه كان سيئاً في تحديد "ما هي الكلمة الحقيقية التي يجب أن تكون هنا؟".
الحل التقليدي، المتمثل في استخدام RNNs لفك التشفير (decoding) مع إضافة language model، يؤدي الغرض، ولكنه هش بطريقة معينة: كل إصلاح يستهدف نمط فشل واحد دون المساس بالأنماط الأخرى. فجودة الصورة الضبابية هي مشكلة رؤية (vision problem)، بينما مشاكل التهجئة الغريبة وحدود الكلمات هي مشكلة لغوية (language problem). وينتهي بك الأمر بترقيع كل جزء على حدة، لتصبح الفواصل بين هذه الأجزاء مصدراً للأخطاء بحد ذاتها.
الفكرة الجوهرية: نموذجان من Transformer مُدربان مسبقاً يتواصلان معاً
تعتمد استراتيجية TrOCR على ملاحظة أن شقي المشكلة، وهما "فهم الصورة" و"توليد تسلسل منطقي"، يمتلكان بالفعل حلولاً ممتازة مُدربة مسبقاً، ولكنها لم تُصمم في الأصل للتواصل مع بعضها البعض.
بالنسبة لجانب الصورة، يستخدم TrOCR مشفراً (encoder) من نوع Vision Transformer (بنمط ViT)، وهو مُدرب مسبقاً على مجموعات بيانات صور ضخمة. وبدلاً من استخدام CNN التي تمرر المرشحات (filters) فوق البكسلات، يقوم Transformer بتقسيم الصورة إلى شبكة من الرقع (patches) ويسمح لكل رقعة بالانتباه (attend) إلى جميع الرقع الأخرى. وهذا أمر بالغ الأهمية بالنسبة للنصوص تحديداً؛ حيث يمكن لآلية الانتباه في Transformer أن تربط مباشرة بين حرف في الحافة اليسرى للكلمة وحرف في الحافة اليمنى، وهو أمر تحاول CNNs تحقيقه بصعوبة أكبر من خلال تكديس الطبقات.
أما بالنسبة لجانب النص، فيستخدم TrOCR مفكك شفرة (decoder) من نوع Transformer، مُدرب مسبقاً بنفس طريقة النماذج اللغوية الكبيرة: التنبؤ بقطعة النص التالية بناءً على ما سبقها. ومن النقاط الجوهرية هنا أنه لا يقوم بالتوليد حرفاً بحرف، بل يولد النصوص عبر "قطع كلمات" (wordpieces - أجزاء من الكلمات، وهو نفس نظام التجزئة tokenization المستخدم في نماذج BERT و GPT). هذا خيار تصميمي هام؛ فالتنبؤ بـ "ing" كرمز (token) واحد بدلاً من "i" و "n" و "g" كثلاث تخمينات منفصلة، يتيح للنموذج الاعتماد على نفس نوع المعرفة اللغوية التي تجعل توليد النصوص الحديثة انسيابياً، بدلاً من الاعتماد على مدقق إملائي خارجي يتم إضافته في مرحلة لاحقة.
يبدأ كلا الشقين من نماذج مُدربة مسبقاً في مجالاتهما الأصلية (الصور، النصوص)، ثم يتم ضبطهما بدقة (fine-tuned) معاً على مهمة OCR الفعلية. هذه الوصفة المكونة من مرحلتين — التدريب المسبق بشكل منفصل، ثم الضبط المشترك — هي المساهمة الحقيقية للورقة البحثية. فالبنية المعمارية (مشفّر Transformer يغذي مفكك شفرة Transformer) ليست جديدة، ولكن الجديد هو استخدامها لتوحيد فهم الصور وتوليد النصوص في نموذج واحد قابل للتفاضل (differentiable model) لا يتطلب مرحلة نموذج لغوي منفصلة.
من الناحية العملية، هذا يعني اختفاء المرحلة الثالثة التقليدية، وهي النموذج اللغوي الذي يُطبق بعد المعالجة (post-hoc language model). فالمعرفة اللغوية لم تعد مجرد إضافة خارجية يتم تركيبها لاحقاً، بل أصبحت جزءاً أصيلاً في مفكك الشفرة منذ مرحلة التدريب المسبق، ويتم ضبطها بدقة بالتزامن مع شق الرؤية بدلاً من أن تعمل كترقيع مستقل.
خدعة التدريب التي جعلته ينجح: البيانات الاصطناعية أولاً، ثم البيانات الحقيقية
تُعرف نماذج Transformers بنهمها الشديد للبيانات، كما أن إنتاج بيانات OCR مُصنفة (أي وجود إنسان يقوم بنسخ ما تظهره الصورة الممسوحة ضوئياً بدقة) عملية مكلفة للغاية عند تنفيذها على نطاق واسع. يتجاوز TrOCR هذه العقبة عبر "التدريب المسبق الاصطناعي" (synthetic pre-training): حيث يتم توليد الملايين من صور النصوص باستخدام خطوط وخلفيات وتشوهات متنوعة، وتكون "التسمية" (label) هي ببساطة النص الذي استُخدم لإنشاء الصورة. هنا لا حاجة للبشر، لأنك تعرف مسبقاً الحقيقة المطلقة (ground truth)؛ فأنت من صنعها.
وتكشف الأرقام هنا سر النجاح؛ إذ يخضع TrOCR لتدريب مسبق على مئات الملايين من صور أسطر النصوص الاصطناعية هذه قبل أن يلمس أي مجموعة بيانات مصنفة بشرياً. وبعد ذلك فقط، يتم إجراء "الضبط الدقيق" (fine-tuning) على مجموعات بيانات مرجعية حقيقية ومصنفة بشرياً وأصغر حجماً بكثير (مثل SROIE للإيصالات، و IAM للكتابة اليدوية). هذا هو ذات النمط الذي جعل النماذج اللغوية الكبيرة (LLMs) تنجح في المقام الأول: تدريب مسبق رخيص ووفير وشبه اصطناعي، يليه جرعة صغيرة من بيانات الضبط الدقيق عالية الجودة والمكلفة. ببساطة، يطبق TrOCR هذه الوصفة على تحويل الرؤية إلى نص (vision-to-text) بدلاً من تحويل النص إلى نص (text-to-text).
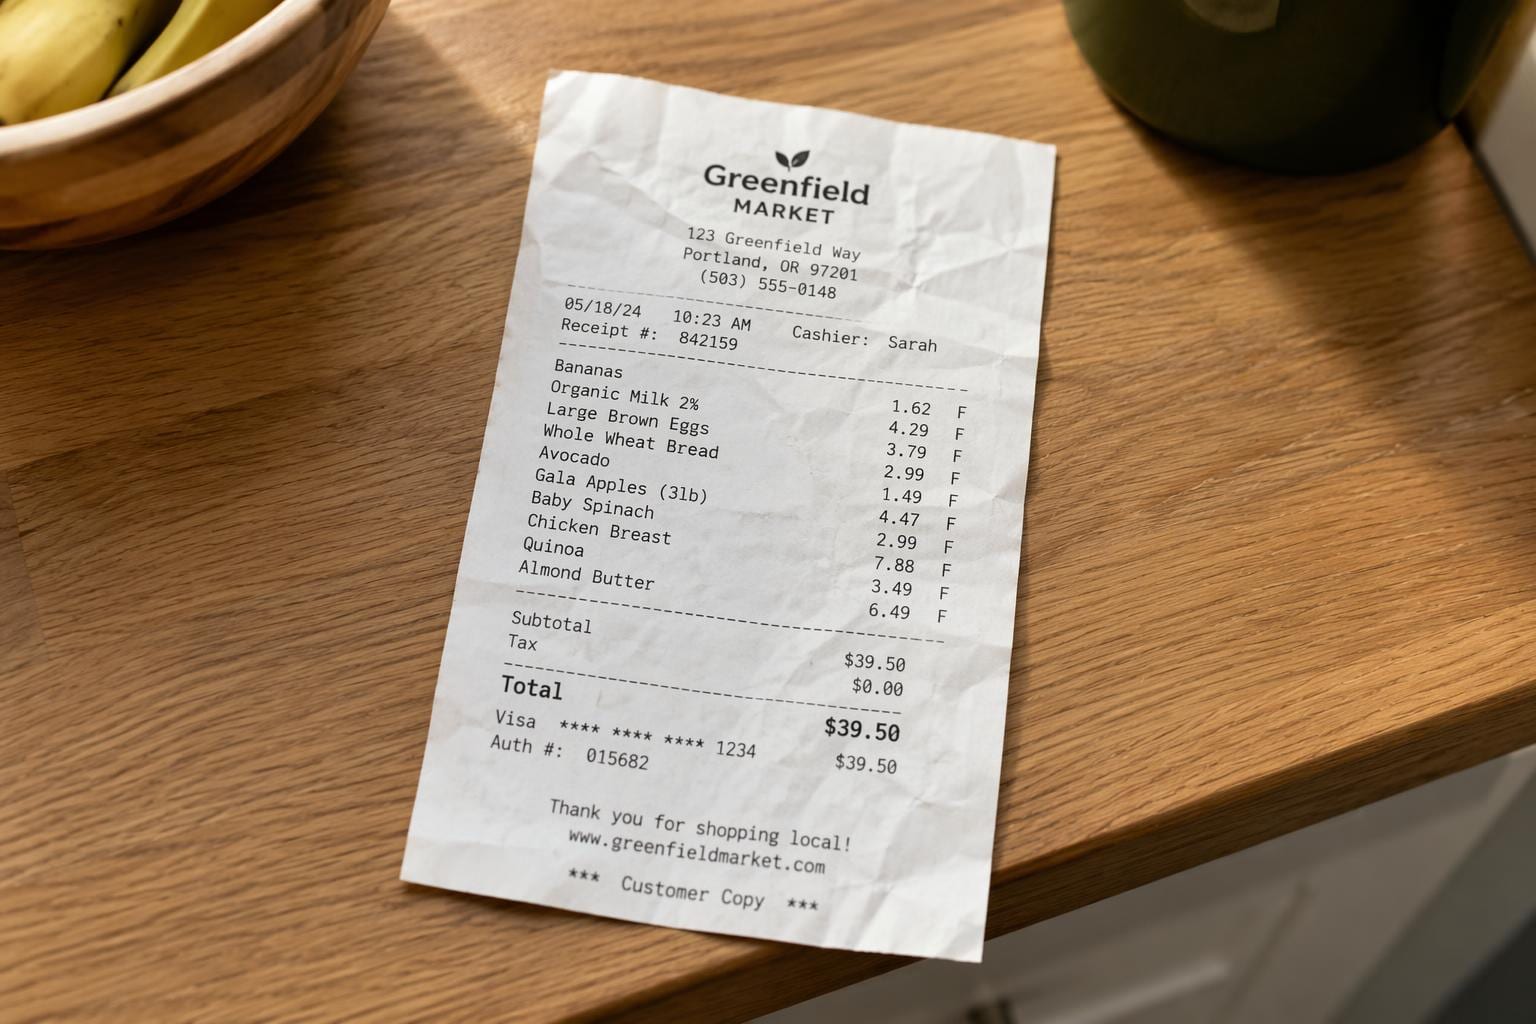
النتائج الفعلية التي توصلوا إليها
فيما يخص النصوص المطبوعة (مهمة التعرف على الإيصالات SROIE)، حقق نموذج TrOCR-large نسبة 96.4% في مقياس F1، متفوقاً بذلك على أفضل نظام سابق في قائمة المتصدرين. وتُعد الإيصالات حالة اختبار صعبة للغاية؛ نظراً لتنوع التنسيقات، وبهتان الطباعة الحرارية، وعدم اتساق الخطوط عبر أنظمة نقاط البيع (POS) المختلفة في المتاجر. لذا، فإن التفوق على نظام متخصص —من المرجح أنه صُمم خصيصاً للتعامل مع تعقيدات الإيصالات— باستخدام بنية عامة، يُعد نتيجة ملموسة وليست مجرد تحسن هامشي.
أما بالنسبة للكتابة اليدوية (مجموعة بيانات IAM، وهي معيار قياسي قديم يعتمد على نماذج مكتوبة بخط اليد وممسوحة ضوئياً)، فقد سجل TrOCR معدل خطأ في الحروف (character error rate) يبلغ حوالي 2.89%، ليتفوق مرة أخرى على النهج السابقة التي كانت تمثل أحدث ما توصل إليه العلم (state-of-the-art)، والتي كانت عبارة عن حزم مخصصة من CNN-RNN-language-model. وبما أن الكتابة اليدوية تُعتبر المشكلة الأصعب من وجهة نظر معظم الناس، نظراً للتفاوت الكبير في أشكال الحروف بين الكُتّاب، فإن صمود بنية Transformer العامة هنا يمثل النتيجة الأقوى من بين النتائج المذكورة.
وفيما يتعلق بنصوص المشاهد (صور للنصوص في البيئات الطبيعية، مثل لافتات المتاجر أو أغلفة المنتجات المصورة بزوايا مختلفة، على معايير ICDAR وغيرها)، تفوق TrOCR أيضاً على أنظمة المقارنة التي ذكرتها الورقة البحثية. وعادة ما تكون نصوص المشاهد هي الفئة الأكثر قسوة في مجال OCR؛ حيث تتراكم تشوهات المنظور، والتداخل (occlusion)، والإضاءة غير المتسقة، فوق مشكلة التعرف التقليدية.
وعبر الفئات الثلاث —النصوص المطبوعة، والمكتوبة بخط اليد، ونصوص المشاهد— فازت البنية ذاتها دون الحاجة إلى إعادة تصميم خاصة بكل مهمة. وهذا الاتساق أهم من أي رقم منفرد؛ فبينما كانت الأنظمة السابقة المتقدمة تميل إلى التخصص حسب الفئة، فإن TrOCR هو "وصفة واحدة" طُبقت ثلاث مرات.
نقاط الضعف، ولماذا لا يُعد هذا الأمر سحراً
تتعلق الأرقام الواردة في الورقة البحثية بالتعرف على النصوص على مستوى السطر (line-level recognition). حيث يقوم TrOCR بقراءة سطر نصي قمت بتحديده وقصه مسبقاً؛ فهو لا يقوم بالبحث عن هذا السطر في الصفحة نيابة عنك. وفي أنظمة الإنتاج الفعلية، لا تزال هناك حاجة إلى خطوة منفصلة للكشف (detection step) لتحديد مناطق النصوص قبل أن يتعامل معها TrOCR. إن مشكلة "أين يوجد النص" (والتي تُسمى text detection أو layout analysis) هي مجال بحثي منفصل تماماً، ولا يتطرق إليها TrOCR.
أما بيانات التدريب المسبق الاصطناعية (synthetic pre-training data)، فرغم ضخامتها، تظل اصطناعية. فالخطوط المجهزة على خلفيات مصطنعة لا تعكس بدقة فوضى المستندات الممسوحة ضوئياً في الواقع: مثل الزوايا الممزقة، وثقوب الدبابيس، وتلف المياه، أو خطوط الحبر الناتجة عن آلات التصوير. مرحلة الضبط الدقيق (fine-tuning) باستخدام بيانات حقيقية مصنفة هي التي تسد هذه الفجوة، ولكن هذا يعني أن سقف أداء TrOCR في أي نوع محدد من المستندات لا يزال يعتمد على مدى تطابق بيانات الضبط الدقيق مع ذلك النوع من المستندات.
كما يلعب حجم النموذج دوراً محورياً هنا؛ فنموذج TrOCR-large هو نموذج ضخم، وأقوى الأرقام الواردة في الورقة البحثية جاءت من النسخة الكبيرة (large variant)، وليس من النسخ الأساسية (base) أو الصغيرة (small). الفجوة بين TrOCR-small و TrOCR-large ملموسة، مما يعني أن إمكانية نشر واستخدام "TrOCR" تعتمد بشكل كبير على حجم النموذج الذي تقوم بتشغيله فعلياً، وعلى ميزانيتك المتاحة من حيث زمن الاستجابة (latency) والقدرات الحوسبية (compute budget).
لماذا يهم هذا الأمر كل من يقوم ببناء أو شراء أنظمة OCR
إذا كنت تقوم بتقييم محركات OCR اليوم، فإن فهم TrOCR أمر ضروري لسبب محدد: فهو يمثل مؤشراً قوياً على الاتجاه الذي سلكه المجال بأكمله بعد عام 2021. فأغلب نماذج OCR وDocument-AI الحديثة، بما في ذلك العديد من النماذج التي تظهر حالياً في كتالوجات المحركات ومقارنات المعايير (benchmarks)، تنحدر من الفكرة ذاتها: Vision Transformer مُدرب مسبقاً يغذي Text Transformer مُدرباً مسبقاً، مع ضبط دقيق (fine-tuning) شامل من البداية إلى النهاية، دون الحاجة إلى نموذج لغوي مُلحق. لذا، عندما ترى نموذجاً حديثاً يتفاخر بمعمارية تعتمد على Transformer بدلاً من CNN-RNN، فمن المرجح جداً أن يكون TrOCR جزءاً من السلالة التي أوصلت المجال إلى هذه النقطة.
من الناحية العملية، غيّر هذا التحول مفهوم "الحالات الصعبة". فقد كانت خطوط المعالجة القديمة التي تعتمد على CNN-RNN مع نموذج لغوي تعاني بشدة مع أي شيء لا يستطيع النموذج اللغوي توقعه: مثل أسماء العلم غير الشائعة، وأرقام القطع، والمستندات متعددة اللغات، أو أي نص لا يمثل كلمة قاموسية منطقية. وتبرز هذه التحديات بوضوح في اللغة العربية، حيث تزيد طبيعة الخط المتصل والحروف المتغيرة حسب موقعها في الكلمة من تعقيد عملية التعرف الضوئي. ورغم أن النهج المعتمد على Transformer مثل TrOCR ليس مثالياً في هذه الحالات — فلا يوجد نموذج مثالي — إلا أن نمط الفشل قد تغير؛ فبما أن الفهم اللغوي مدمج في مرحلة التدريب المسبق (pre-training) وليس مجرد "رقعة" مضافة لاحقاً، تميل هذه النماذج إلى أن تكون أكثر اتساقاً عبر مختلف أنواع المستندات، بدلاً من التفوق في النصوص المطبوعة النظيفة والانهيار أمام الكتابات اليدوية الفوضوية أو صور المشاهد الطبيعية.
ولكل من يقارن بين محركات OCR في الواقع: لا تكتفِ بالتحقق من الدقة في المستندات المطبوعة النظيفة، لأن هذه هي الحالة السهلة التي تتعامل معها جميع المحركات تقريباً بشكل جيد الآن. بل تحقق من الأداء تحديداً في الكتابة اليدوية، والإيصالات، ونصوص المشاهد (scene text) — وهي الفئات التي حددتها ورقة TrOCR البحثية كأصعب الحالات تاريخياً — لأن هذا هو المكان الذي تظهر فيه الاختيارات المعمارية للمحرك فعلياً في لغة الأرقام.