TrOCR: O que acontece quando você descarta todo o manual do OCR
Baseado em: TrOCR: Transformer-based Optical Character Recognition with Pre-trained Models — Minghao Li, Tengchao Lv, Jingye Chen, Lei Cui, Yijuan Lu, Dinei Florencio, Cha Zhang, Zhoujun Li, Furu Wei
A Evolução do OCR: Do Legado ao TrOCR
Imagine o pipeline de OCR que estava presente em quase todos os sistemas de produção antes de 2021. Uma CNN analisava a imagem e extraía características visuais. Uma RNN lia essas características da esquerda para a direita e previa os caracteres um a um. Então, como as previsões da RNN eram frequentemente imprecisas, um modelo de linguagem separado era acoplado ao final para refinar a saída, corrigindo "rn" para "m" e resolvendo as outras quinze formas que um scanner consegue deformar um recibo.
Três modelos, três regimes de treinamento, três conjuntos de bugs. Essa é a configuração que o TrOCR (Microsoft, 2021) descarta. A proposta é simples: usar um Transformer para a imagem, um Transformer para o texto, pré-treinar ambos e pular completamente a etapa de limpeza com um modelo de linguagem separado. Sem CNN. Sem RNN. Sem corretor ortográfico acoplado. E, de acordo com o artigo, esse design mais simples supera os sistemas especializados e ajustados manualmente que ele substitui em textos impressos, manuscritos e de cena.
Essa é a parte surpreendente que merece reflexão. O OCR é um daqueles campos onde décadas de "gambiarras" acumuladas geralmente vencem a arquitetura limpa. O TrOCR é um caso onde a arquitetura limpa venceu mesmo assim.
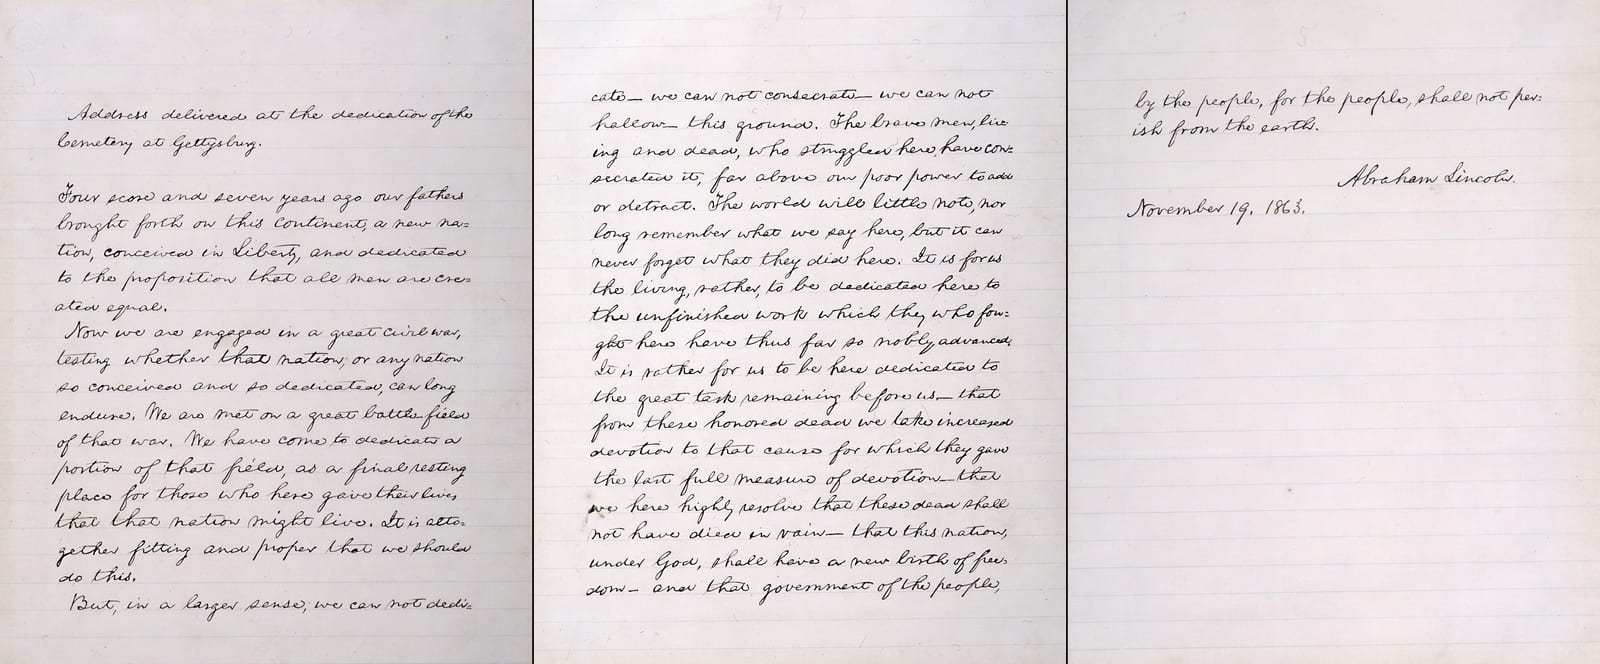
A cópia Bliss do Discurso de Gettysburg, escrita por Abraham Lincoln (1864); domínio público, via Wikimedia Commons.

Por que o OCR é um problema mais difícil do que parece
Se você nunca construiu um sistema de OCR, é fácil presumir que a parte difícil seja "ler as letras". Não é. A parte difícil é que a conversão de imagem para texto é, na verdade, dois problemas unidos, e eles falham de maneiras diferentes.
Primeiro problema: entender o que está na imagem. As fontes variam. A caligrafia varia ainda mais, às vezes a ponto de duas amostras da mesma pessoa mal terem relação entre si. Recibos digitalizados possuem vincos, sombras e manchas de café. Fotos de placas de rua têm ângulos e iluminação estranhos.
Segundo problema: gerar texto coerente a partir dessas pistas visuais. Um modelo pode identificar corretamente cada traço de uma palavra e ainda assim produzir algo sem sentido, porque reconhecer formas e produzir sequências válidas são habilidades diferentes. É por isso que os pipelines tradicionais adicionaram o language model originalmente. O componente de visão era bom em "com o que isso se parece" e ruim em "qual seria a palavra real aqui".
A solução tradicional — RNNs para decodificação somadas a um language model acoplado — funciona, mas é frágil de uma forma específica: cada correção foca em um modo de falha sem tocar nos outros. Qualidade de imagem borrada é um problema de visão. Ortografia estranha e problemas de delimitação de palavras são problemas de linguagem. Você acaba corrigindo cada peça separadamente, e as emendas entre essas peças tornam-se sua própria fonte de bugs.
A ideia central: dois Transformers pré-treinados conversando entre si
A estratégia do TrOCR é perceber que ambas as metades do problema — "compreender uma imagem" e "gerar uma sequência plausível" — já possuem soluções pré-treinadas excelentes, apenas não foram originalmente construídas para interagir entre si.
Para a parte da imagem, o TrOCR utiliza um encoder Vision Transformer (estilo ViT), já pré-treinado em grandes conjuntos de dados de imagens. Em vez de uma CNN deslizando filtros sobre os pixels, um Transformer divide a imagem em uma grade de patches e permite que cada patch preste atenção em todos os outros. Isso é fundamental especificamente para texto: a atenção de um Transformer pode conectar diretamente um caractere na borda esquerda de uma palavra com um na borda direita, algo que as CNNs aproximam de forma mais trabalhosa através de camadas empilhadas.
Para a parte do texto, o TrOCR utiliza um decoder Transformer, pré-treinado da mesma forma que os grandes modelos de linguagem: prevendo a próxima parte do texto com base no que veio antes. Crucialmente, ele não gera caractere por caractere. Ele gera em wordpieces (fragmentos de subpalavras, o mesmo esquema de tokenização usado por modelos estilo BERT e GPT). Essa é uma escolha de design significativa: prever "ing" como um único token, em vez de "i", "n", "g" como três palpites separados, permite que o modelo se apoie no mesmo tipo de conhecimento linguístico que torna a geração de texto moderna fluente, em vez de depender de um corretor ortográfico acoplado posteriormente.
Ambas as metades partem de modelos pré-treinados em seus domínios nativos (imagens, texto) e, em seguida, são ajustados (fine-tuned) juntos na tarefa real de OCR. Essa receita de duas etapas — pré-treinar separadamente e fazer o fine-tuning conjuntamente — é a real contribuição do artigo. A arquitetura (um encoder Transformer alimentando um decoder Transformer) não é nova. O que é novo é utilizá-la para unificar a compreensão de imagem e a geração de texto em um único modelo diferenciável que não compartilha nenhuma etapa separada de modelo de linguagem.
Na prática, isso significa que a tradicional terceira etapa, o modelo de linguagem post-hoc, desaparece. O conhecimento linguístico não é adicionado a posteriori; ele já está incorporado ao decoder desde o pré-treinamento e é ajustado conjuntamente com a metade de visão, em vez de operar como um remendo independente.
O truque de treinamento que faz funcionar: dados sintéticos primeiro, dados reais depois
Os Transformers são notoriamente dependentes de grandes volumes de dados, e dados de OCR rotulados (com um humano transcrevendo exatamente o que consta em uma imagem digitalizada) são caros para produzir em escala. O TrOCR contorna isso com o pré-treinamento sintético: geram-se milhões de imagens de texto renderizado usando diversas fontes, fundos e distorções, onde o "rótulo" é simplesmente o texto utilizado para renderizar a imagem. Não são necessários humanos, pois você já conhece a verdade fundamental (ground truth); foi você quem a criou.
Os números revelam a estratégia. O TrOCR passa por um pré-treinamento com centenas de milhões dessas imagens sintéticas de linhas de texto antes mesmo de tocar em um conjunto de dados rotulado por humanos. Somente após essa etapa é que ele realiza o fine-tuning em benchmarks reais e muito menores, rotulados por humanos (como o SROIE para recibos e o IAM para caligrafia). Este é o mesmo padrão que permitiu o sucesso dos grandes modelos de linguagem: um pré-treinamento abundante e barato com dados "quase sintéticos", seguido por uma pequena dose de dados de fine-tuning caros e de alta qualidade. O TrOCR está aplicando essa receita para a conversão de visão para texto, em vez de texto para texto.
O que eles realmente descobriram
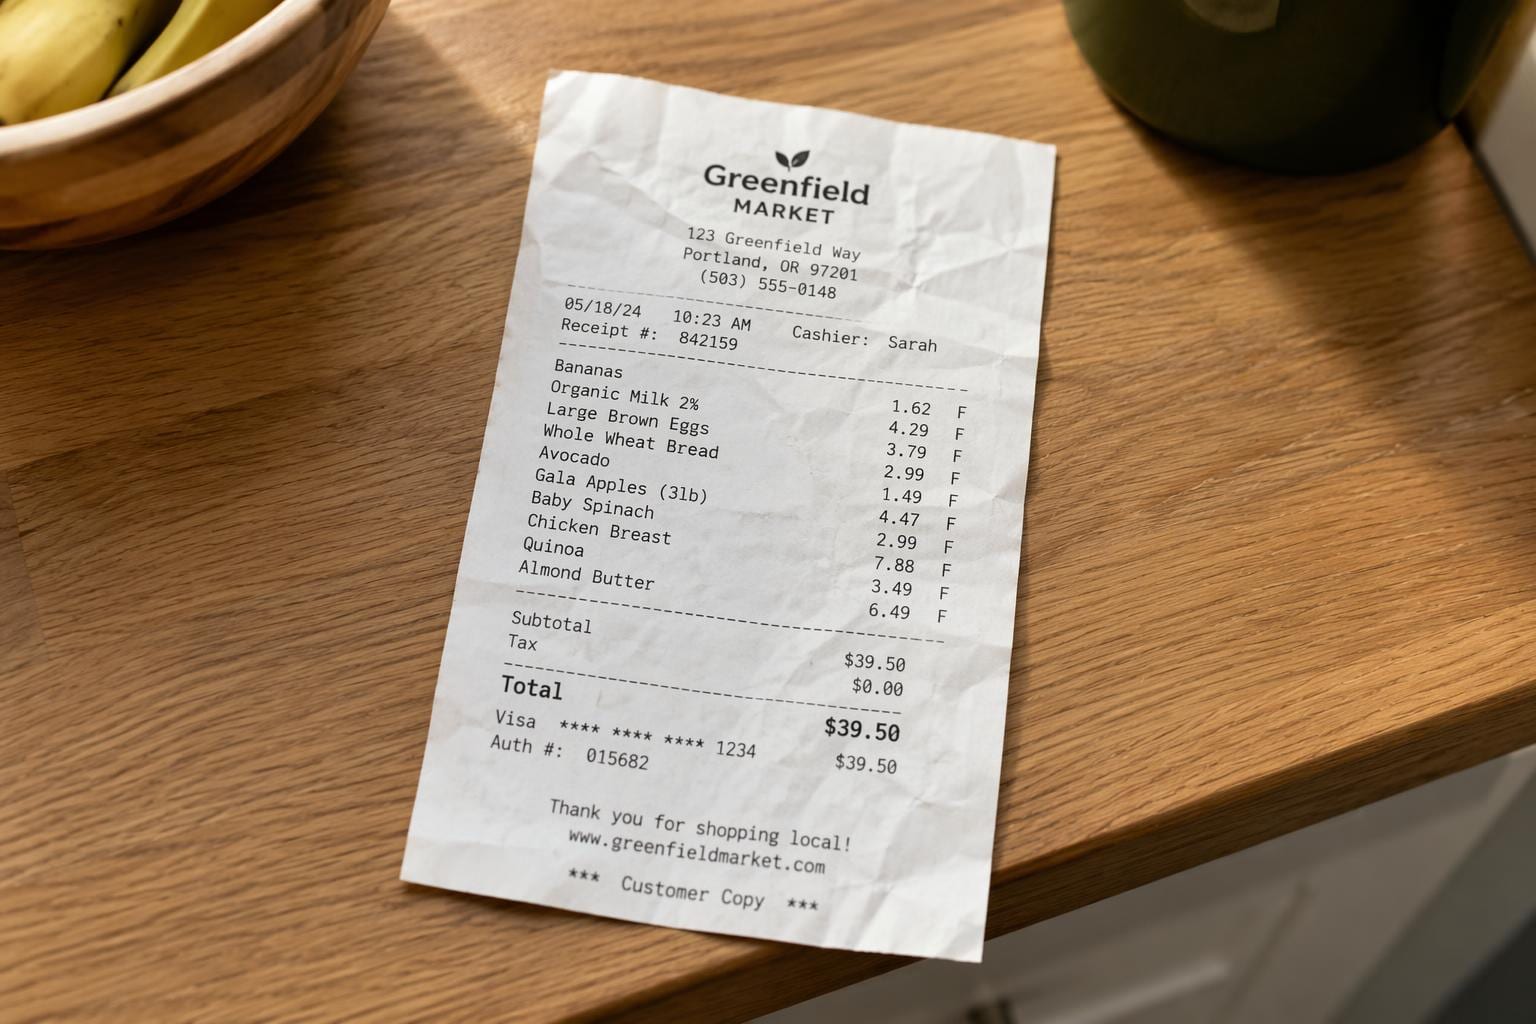
Em texto impresso (a tarefa de reconhecimento de recibos SROIE), o TrOCR-large atingiu 96,4% de F1, superando o melhor sistema anterior naquele leaderboard. Recibos são um caso de teste genuinamente difícil: layouts variáveis, impressão térmica desbotada e fontes inconsistentes entre os sistemas POS de diferentes lojas. Superar um sistema especializado aqui — provavelmente ajustado especificamente para as peculiaridades de recibos — com uma arquitetura geral é um resultado real, e não marginal.
Em escrita manual (o dataset IAM, um benchmark consagrado construído a partir de formulários manuscritos digitalizados), o TrOCR apresenta uma character error rate de aproximadamente 2,89%, novamente à frente de abordagens state-of-the-art anteriores que eram pilhas de CNN-RNN-language-model construídas para esse fim. A escrita manual é o mais difícil dos dois problemas na intuição da maioria das pessoas, já que as formas das letras variam muito entre os escritores; portanto, o fato de uma arquitetura Transformer geral se sustentar aqui é o mais forte dos dois resultados.
Em texto de cena (fotos de textos no mundo real, como placas de lojas ou embalagens de produtos tiradas em ângulo, nos benchmarks ICDAR e outros), o TrOCR também supera os sistemas de comparação relatados no artigo. O texto de cena é tipicamente a categoria mais brutal do OCR: distorção de perspectiva, oclusão e iluminação inconsistente, tudo somado ao problema usual de reconhecimento.
Nas três categorias — texto impresso, manuscrito e de cena — a mesma arquitetura vence sem a necessidade de um redesenho específico para cada tarefa. Essa consistência importa mais do que qualquer número isolado. Os sistemas state-of-the-art anteriores tendiam a ser especializados por categoria; o TrOCR é uma única receita aplicada três vezes.
Onde ele falha e por que isso não é mágica
Os números do artigo referem-se ao reconhecimento em nível de linha. O TrOCR lê uma linha de texto que você já localizou e recortou; ele não encontra essa linha na página por você. Em um sistema de produção real, outra etapa separada de detecção ainda precisa identificar onde estão as regiões de texto antes que o TrOCR as processe. Esse problema de "onde está o texto" (chamado de text detection ou layout analysis) é uma área de pesquisa inteiramente distinta, e o TrOCR não a aborda.
Os dados de pré-treinamento sintéticos, embora volumosos, ainda são sintéticos. Fontes renderizadas em fundos renderizados não capturam perfeitamente a bagunça de um documento digitalizado real: cantos rasgados, furos de grampo, danos por água ou manchas de toner de uma fotocopiadora. A etapa de fine-tuning com dados reais rotulados é o que preenche essa lacuna, mas isso significa que o teto de desempenho do TrOCR para qualquer tipo específico de documento ainda depende de quão bem os dados de fine-tuning correspondem a esse tipo de documento.
Além disso, o tamanho do modelo desempenha um papel fundamental aqui. O TrOCR-large é um modelo robusto, e os números mais fortes do artigo vêm da variante large, não das versões base ou small. A diferença entre o TrOCR-small e o TrOCR-large é significativa, o que significa que a viabilidade de implantação do "TrOCR" depende fortemente de qual tamanho você está executando e de quanto orçamento de latência e computação você possui.
Por que isso é importante para quem está desenvolvendo ou adquirindo OCR
Se você está avaliando engines de OCR hoje, vale a pena entender o TrOCR por um motivo específico: ele é um forte indicativo de para onde todo o campo migrou após 2021. A maioria dos modelos modernos de OCR e document-AI, incluindo muitos que aparecem atualmente em catálogos de engines e comparações de benchmarks, descende dessa mesma ideia: um vision Transformer pré-treinado alimentando um text Transformer pré-treinado, com fine-tuning de ponta a ponta, sem a necessidade de um modelo de linguagem acoplado. Quando você encontrar um modelo mais novo ostentando uma arquitetura baseada em Transformer em vez de CNN-RNN, é muito provável que o TrOCR faça parte da linhagem que levou a área até esse ponto.
Na prática, essa mudança alterou a definição de casos "difíceis". Os pipelines antigos de CNN-RNN mais um modelo de linguagem tinham mais dificuldade com qualquer coisa que o modelo de linguagem não conseguisse prever: nomes próprios incomuns, números de peças, documentos com idiomas mistos — qualquer situação em que o texto "correto" não seja uma palavra plausível de dicionário. Abordagens baseadas em Transformer, como o TrOCR, ainda não são perfeitas nesses casos (nenhum modelo é), mas o modo de falha muda. Como a compreensão da linguagem é integrada ao pré-treinamento, e não aplicada como um "remendo" posterior, esses modelos tendem a ser mais consistentes entre diferentes tipos de documentos, em vez de serem excelentes em textos impressos limpos e falharem miseravelmente em caligrafias complexas ou fotos de cenas.
Para quem está comparando engines de OCR na prática: não verifique apenas a precisão em documentos impressos e limpos, pois esse é o caso fácil que quase tudo resolve bem hoje em dia. Verifique o desempenho especificamente em caligrafia, recibos e scene text — as categorias que o paper do TrOCR destaca como historicamente as mais difíceis —, pois é aí que as escolhas arquiteturais por trás de cada engine realmente se refletem nos números.