写真は一切公開しないが、ラベルの読み方を学ぶ工場
元論文: FedTR: Federated Learning Framework with Transfer Learning for Industrial Visual Inspection — Vikash Sathiamoorthy, Shuo Huai, Hao Kong, Di Liu, Wendy Yong Yi Loy, Christian Makaya, Daren Ho, Ravi Subramaniam, Qian Lin, Weichen Liu
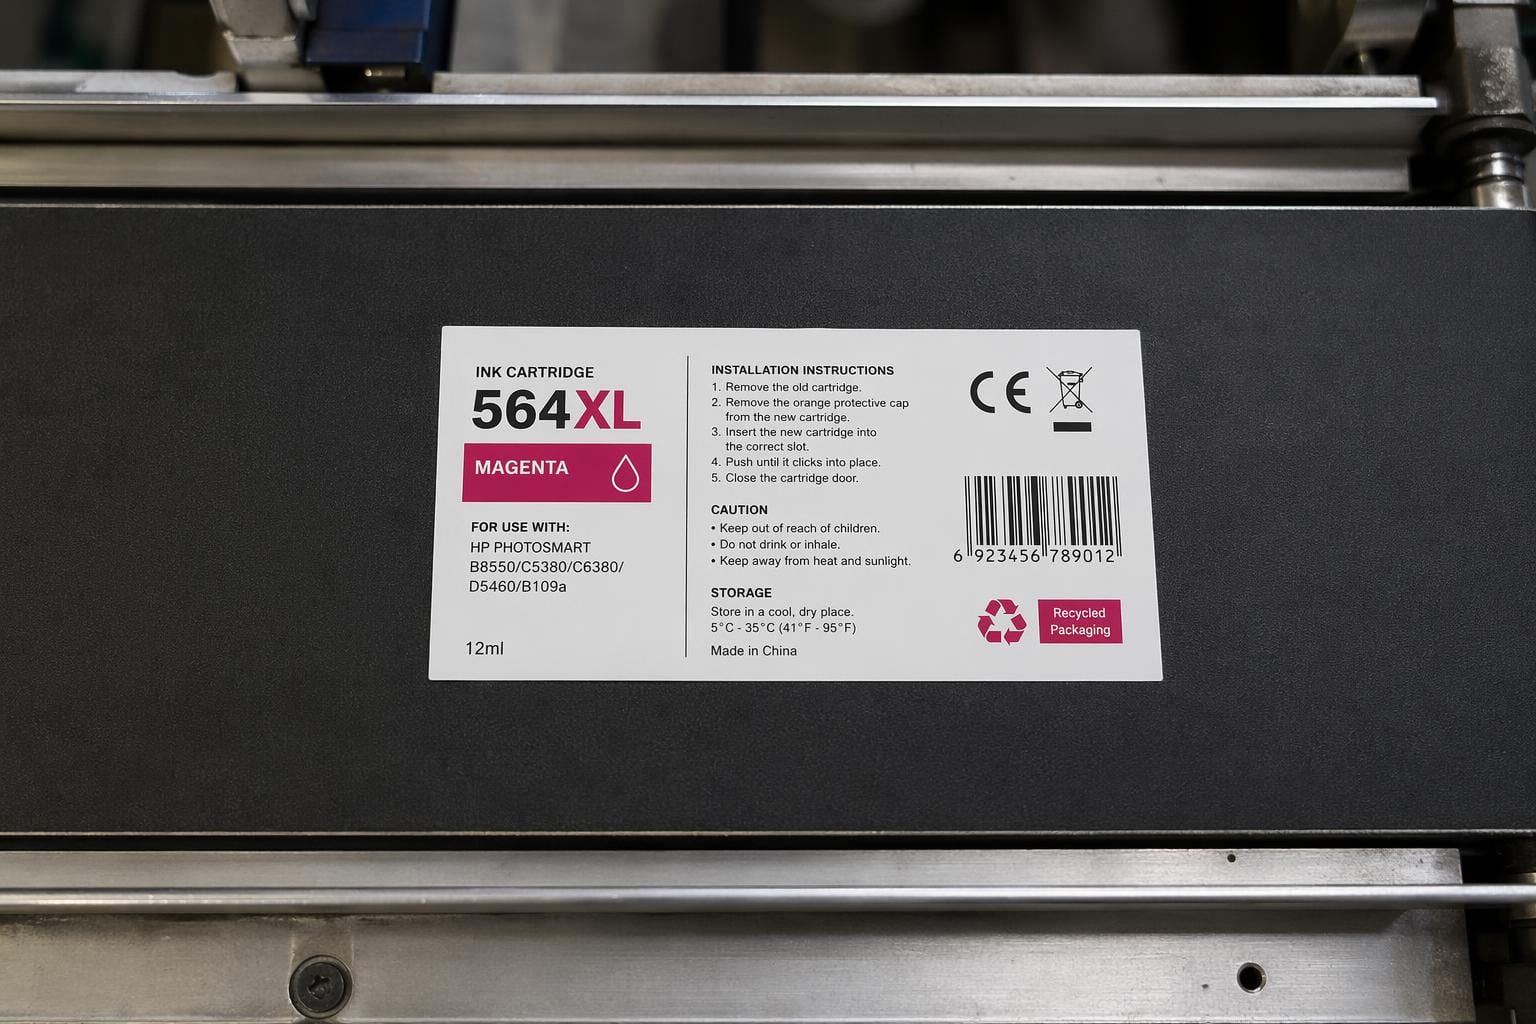
同一企業が所有する3つのインクカートリッジ工場を想像してください。1つは深センに、1つはペナンに、もう1つはチェンナイにあります。各工場にはライン上にカメラが設置され、ラベルが通過する際に撮影され、バッチコードの滲み、有効期限の誤印刷などのチェックを行っています。各工場には数千枚の欠陥ラベル画像がありますが、それらを共有サーバーに送信することはできません。なぜなら、画像には顧客契約に関連するバッチ番号や内部QAデータが含まれており、外部に出回ることを望まない機密情報だからです。
これが、FedTRという新しい論文の背景です。南洋理工大学と業界パートナーからなるチームによって書かれたこの論文は、魅力的ではないが非常に一般的な問題を解決しています。つまり、良いOCRモデルが必要だが、トレーニングデータが法的または契約的にプールできない複数のサイトに分散している状況です。
なぜこれは聞こえるほど簡単な問題ではないのか
フェデレーテッドラーニング(分散学習)は、「集約できないデータで学習する」という課題に対する既存の解決策としてすでに存在します。基本的なアイデアは以下の通りです。データを中央サーバーに送信する代わりに、モデルを各サイトへ送り、ローカルで学習させた後、更新されたモデルの重み(画像そのものではなく)のみを返して平均化します。これを繰り返します。これにより、どの工場の製造ラインの画像も工場外に出ることはありません。
本論文の核心的な主張は、単純なフェデレーテッドラーニングが産業用視覚検査の分野では特に機能しなくなるという点であり、その理由をじっくり検討する価値があります。同時に二つの要因が不利に働きます。
- データ量が小さい。 ラベルの品質管理(QA)を行う工場には、モデルが通常必要とする数百万枚ではなく、数千枚程度の画像しか存在しない場合があります。フェデレーテッドラーニングは、限られたデータ量から大規模なモデルを学習させようとするものです。
- タスクが困難である。 これは「欠陥があるかないか」という二値分類ではありません。エンドツーエンドのテキスト認識です。ラベル上のテキスト領域を検出し、バッチコードごとに文字単位で正確に読み取る必要があります。これは二値分類よりもはるかに厳格なタスクであり、適切に学習するにはより多くのシグナルが必要です。
データ量が少なくタスクが困難であるという組み合わせは、フェデレーテッドであるかどうかに関わらず、あらゆる深層学習手法にとって不利です。十分に学習されていない複数のモデルを平均化しても、十分に学習された一つのモデルが得られるわけではありません。得られるのは、平均化された十分に学習されていないモデルに過ぎません。
解決策:フェデレーション学習の前に「強み」を借りる
FedTRの答えは、空白のモデルからフェデレーション学習を開始しないことです。代わりに:
- まず、大規模で公開されている汎用的な文字認識データセットでモデルを訓練する。これは転移学習であり、モデルはインクカートリッジとは無関係なデータから、文字の見た目、文字の形状、汚れのついた「8」と「6」の見分け方などの一般的なスキルを習得します。
- その事前学習が完了してから、モデルを個々の工場に配布し、それぞれの小規模でプライベートな実データセットを用いてフェデレーション微調整を行います。
ここで実際に成立する比喩は採用です。新しい従業員に請求書の読み方を教えるのに、3日間の業務中の請求書のみを与えて他は何も与えないわけではありません。すでに読み書きのできる人材を採用し、その後で貴社の特定の請求書フォーマットを教えます。FedTRも同様です。公開データセットがモデルに一般的な読み方を教え、フェデレーション学習が貴社工場固有のフォント、レイアウト、欠陥パターンを教えます。
これは理にかなったアイデアであり、率直に言って、画期的なものではありません。転移学習とフェデレーション学習を組み合わせる試みは他の分野でも行われています。この論文が実際に貢献しているのは、それが機能すること、そしてどの程度機能するかを、インクカートリッジ上の欠陥だらけのラベルを読み取るという、真に困難で商業的に現実的なタスクにおいて示し、定量化した点です。
実際に行われたテストとそのコスト
チームは、プライベートなインクカートリッジデータセットを用いて、以下の2つの条件下で実験を行いました。
- ホモジニアス(均質): 各工場のデータが統計的に類似している(ラベルのスタイルが同じ、欠陥の種類が似ている)。
- ヘテロジニアス(非均質): 各工場のデータが異なっている(ラベルデザインが異なる、欠陥の分布が異なる)。これは、異なる国で異なる製品を生産するグローバル企業にとって、はるかに困難で現実的なケースです。
FedTRは、ホモジニアス設定で単語レベルの精度95.5%を、ヘテロジニアス設定で94.2%を達成しました。ここで言う単語レベルの精度とは、単に文字の大部分が正しいだけでなく、単語全体が完全に正しいことを意味します。バッチコードのような用途では、これが実際に重要な基準となります。「LOT4471X」の10文字中9文字が正しくても、それは90%の成功ではなく、読み取り失敗とみなされます。
注目すべき数値は、ホモジニアスとヘテロジニアスの間の差がわずか1.3ポイントであるという点です。連合学習には、クライアントのデータ分布が乖離すると性能が急落するというよく知られた失敗モードがあります(研究者はこれを「非IID問題」と呼び、IIDとは「独立同分布」を意味し、専門用語で「訓練データがすべて同じ統計的分布から来ているわけではない」ということを指します)。ここで差が小さいということは、転移学習による事前学習ステップが、単なる微々たる性能向上ではなく、この失敗モードからモデルを保護する実質的な役割を果たしていることを示しています。
もう一つの注目すべき数値は、FedTRの連合学習の結果が、中央集権型学習(すべてのデータを1箇所に集約して1つのモデルを訓練する方法)とほぼ同等であるという点です。データ集約はここでは許可されていませんが、理論的な上限を示すものです。データを一切集約せずにこの上限に匹敵する性能を達成することが、この取り組みの目的であり、論文は単なる主張ではなく、実際の数値でこの主張を裏付けています。
OCRの構築・導入において、なぜこれが重要なのか
データレジデンス要件のある顧客、マルチサイトの製造業、病院システム間の医療記録、地域別法人間の金融文書など、ドキュメントパイプラインを構築している場合、この論文は「中央集権的に学習させるか、学習を諦めるか」というトレードオフが、一見するほど二項対立ではないことを示す有用なデータポイントとなります。
この種の環境でOCRを評価する際の具体的な示唆は以下の通りです。
- 事前学習は連合学習のメカニズムそのものよりも重要である。 FedTRの巧妙な点は連合平均化ではなく、それは標準的な手法です。真の革新性は、ゼロから連合学習を開始しない点にあります。データがサイロ化されている場合、最もレバレッジが効くのは、洗練された集約アルゴリズムではなく、強力な汎用的なベースモデルです。
- 連合学習が無料の昼食(free lunch)であると想定しないこと。 本論文は、単純な連合学習(FL)が小規模で困難なデータセットでは性能が劣ることを正直に認めており、これは多くの実務者が苦い経験を通じて学んできた事実と一致します。誰かがデータサイロ問題の解決策として「単に連合学習すればよい」と提案してきたら、そのベースモデルが何で事前学習されたのかを問い質してください。
- 文字レベルではなく、単語レベルの精度を要求すべき正しい指標である。 多くのOCRマーケティングは、数値が大きく見栄えが良い文字精度に依存しています。しかし、バッチコード、SKU、日付などのフィールド全体を解析するダウンストリーム処理において、文字精度は実用上役に立たないモデルを隠蔽してしまう可能性があります。95.5%という単語精度は、より厳しい基準であるからこそ、真に強力な数値です。
なお、日本語は漢字と仮名を混在させ、縦書きレイアウトが一般的であるため、英語のみを対象とした研究や縦書きを無視したモデルでは、日本語読者にとって実務上の適用性に大きな制限が生じる点に留意が必要です。
何が欠けており、なぜ過度な外挿を避けるべきか
本論文は、ある企業のインクカートリッジラベルを用いてテストを行っている。これは現実的で、具体的かつ商業的に意味のあるベンチマークではあるが、あくまで1つの製品カテゴリ、1つの論文のプライベートデータセットに限定されており、「異種混合(heterogeneous)」な設定も、実際には1つの企業のデータ内でのシミュレーションされた変動であり、ラベルの慣習が全く異なる真に独立した組織間でのものではない。
また、通信コストや収束に必要なフェデレーテッドラウンド数についての議論も欠けている。これは実務上非常に重要である。3つの工場間でモデル更新を数回やり取りするのは問題ないが、300の工場間(あるいは真にグローバルな企業)で同じことを行うのは、全く異なるインフラストラクチャの問題となる。さらに、他の分野で登場した他の転移学習とフェデレーテッドラーニングの組み合わせとの比較もないため、FedTRの特定の手法が明らかな代替案よりも優れているのか、単にこのデータセットで最初に試されたものなのかを判断するのは難しい。
それでも、その方向性は妥当であり、ここで示されたものと本番環境でのデプロイメントとの間のギャップは、研究上の欠陥ではなく、通常のエンジニアリング作業として埋められるものである。多くの公開論文が実際の、プライベートで商業的に機微なデータセットに触れることがない文書AIの分野において、実際の製造パートナーからの実際のインクカートリッジの品質管理データでテストを行ったという事実は、ある程度の価値を持つ。これは、ベンチマークで手法が機能することを証明する論文と、工場現場での接触に耐え得ることを証明する論文との違いである。