एक फैक्ट्री जो कभी अपनी फोटो शेयर नहीं करती, लेकिन फिर भी लेबल पढ़ना सीखती है
आधारित शोध-पत्र: FedTR: Federated Learning Framework with Transfer Learning for Industrial Visual Inspection — Vikash Sathiamoorthy, Shuo Huai, Hao Kong, Di Liu, Wendy Yong Yi Loy, Christian Makaya, Daren Ho, Ravi Subramaniam, Qian Lin, Weichen Liu
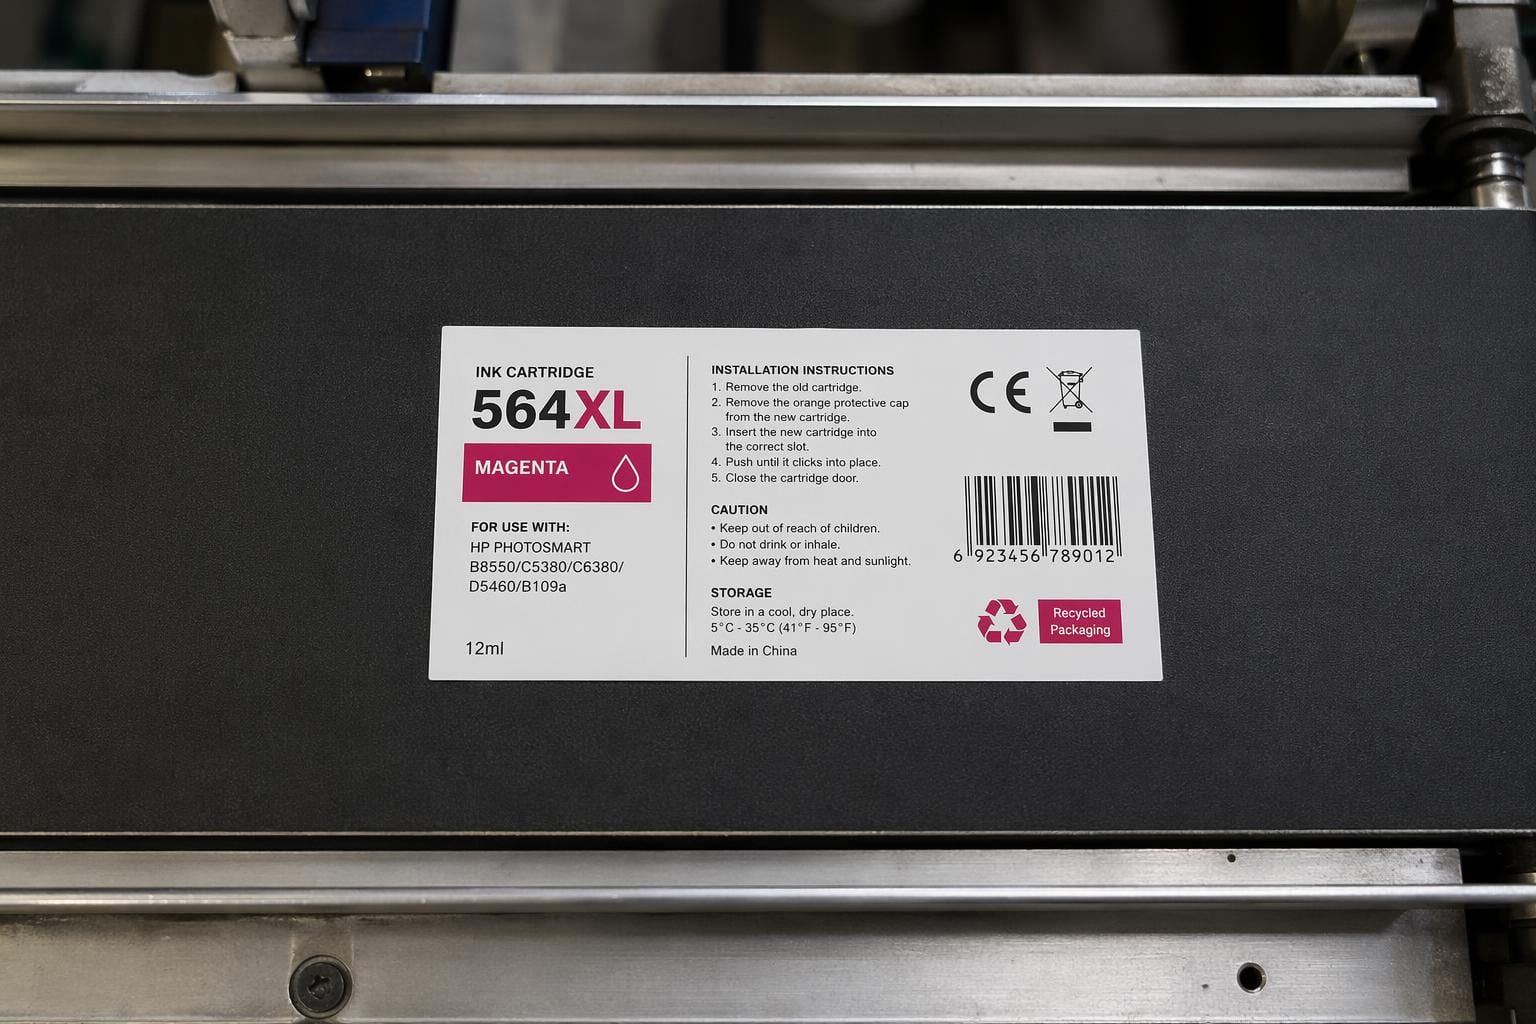
तीन स्याही कार्ट्रिज कारखानों की कल्पना करें जो एक ही कंपनी के स्वामित्व में हैं: एक शेंज़ेन में, एक पेनांग में, और एक चेन्नई में। प्रत्येक कारखाने में लाइन पर कैमरे लगे हैं जो लेबल्स के गुजरते समय उनकी तस्वीरें लेते हैं, ताकि धब्बेदार बैच कोड, गलत छपी समाप्ति तिथियाँ, या इसी प्रकार की अन्य त्रुटियों की जाँच की जा सके। प्रत्येक कारखाने के पास दोषों की शायद कुछ हज़ार लेबल वाली छवियाँ हैं। वे इन छवियों को किसी साझा सर्वर पर नहीं भेज सकते, क्योंकि इनमें संरक्षित लेबल डिज़ाइन, ग्राहक अनुबंधों से जुड़े बैच नंबर और आंतरिक गुणवत्ता नियंत्रण (QA) डेटा शामिल हैं, जिसे किसी भी तरह से इमारत से बाहर जाने की अनुमति नहीं है।
FedTR के पीछे की स्थिति यही है, जो नानयांग टेक्नोलॉजिकल यूनिवर्सिटी और उद्योग भागीदारों की एक टीम द्वारा लिखे गए एक नए पेपर पर आधारित है। वे जिस समस्या को हल कर रहे हैं, वह बहुत आकर्षक नहीं है। यह एक अरुचिकारक, लेकिन अत्यंत सामान्य स्थिति है जहाँ आपको एक अच्छा OCR मॉडल चाहिए, लेकिन प्रशिक्षण डेटा उन स्थलों पर बिखरा हुआ है जो कानूनी या अनुबंधिक कारणों से इसे एकत्रित नहीं कर सकते।
यह समस्या सुनने में जितनी आसान लगती है, उतनी नहीं है
फेडरेटेड लर्निंग (Federated learning) पहले से ही "केंद्रीकृत नहीं किए जा सकने वाले डेटा पर प्रशिक्षण" के लिए एक समाधान के रूप में मौजूद है। इसका मूल विचार यह है: डेटा को एक केंद्रीय सर्वर पर भेजने के बजाय, आप प्रत्येक साइट पर एक मॉडल भेजते हैं, उसे स्थानीय स्तर पर प्रशिक्षित होने देते हैं, और फिर केवल अपडेट किए गए मॉडल वेट्स (छवियाँ नहीं) वापस भेजते हैं ताकि उन्हें औसत किया जा सके। इसे दोहराएं। किसी के फैक्ट्री फ्लोर की फोटो कभी भी फैक्ट्री से बाहर नहीं जातीं।
इस पेपर का मुख्य दावा यह है कि साधारण फेडरेटेड लर्निंग विशेष रूप से औद्योगिक दृश्य निरीक्षण (industrial visual inspection) में विफल हो जाती है, और इसके पीछे के कारणों पर विचार करना महत्वपूर्ण है। एक ही समय में दो चीजें आपके खिलाफ काम करती हैं:
- डेटा छोटा है। लेबल QA कर रही एक फैक्ट्री के पास कुल मिलाकर कुछ हज़ार छवियाँ हो सकती हैं, न कि लाखों छवियाँ जिनकी एक मॉडल को सामान्यतः आवश्यकता होती है। फेडरेटेड लर्निंग डेटा की उसी सीमित मात्रा से एक मॉडल को प्रशिक्षित करने का प्रयास करती है।
- कार्य कठिन है। यह केवल "क्या दोष है, हाँ या नहीं" नहीं है। यह एंड-टू-एंड टेक्स्ट रिकग्निशन है: लेबल पर टेक्स्ट क्षेत्र को खोजें, और फिर बैच कोड से बैच कोड तक, अक्षर-दर-अक्षर इसे सही ढंग से पढ़ें। यह बाइनरी क्लासिफिकेशन की तुलना में एक बहुत ही कम क्षमाशील कार्य है, और अच्छी तरह सीखने के लिए इसमें अधिक सिग्नल की आवश्यकता होती है।
छोटा डेटा और एक कठिन कार्य, फेडरेटेड चाहे हो या न हो, किसी भी डीप लर्निंग विधि के लिए एक खराब संयोजन है। कई अधप्रशिक्षित (undertrained) मॉडलों को औसत करने से एक अच्छी तरह प्रशिक्षित मॉडल नहीं बनता है। यह केवल एक औसत अधप्रशिक्षित मॉडल बनाता है।
समाधान: संघीय शिक्षा से पहले शक्ति उधार लें
FedTR का उत्तर है कि संघीय प्रशिक्षण (federated training) को एक खाली मॉडल से शुरू न करें। इसके बजाय:
- मॉडल को पहले एक बड़े, सार्वजनिक, सामान्य पाठ-पहचान डेटासेट पर प्रशिक्षित करें। यह ट्रांसफर लर्निंग है: मॉडल सामान्य कौशल सीखता है, जैसे कि पाठ कैसा दिखता है, अक्षरों का आकार कैसा होता है, और एक "6" को धुंधले "8" से कैसे अलग किया जाए, उस डेटा से जो कार्ट्रिज की स्याही से कोई लेना-देना नहीं रखता।
- केवल उस प्री-ट्रेनिंग के बाद ही मॉडल को व्यक्तिगत कारखानों में भेजा जाता है, जहाँ उनके छोटे, निजी, वास्तविक डेटासेट पर संघीय फाइन-ट्यूनिंग (federated fine-tuning) की जाती है।
यहाँ जो तुलना वास्तव में काम आती है, वह है नौकरी पर रखना। आप किसी नए कर्मचारी को तीन दिन के ऑन-द-जॉब इनवॉइस और कुछ और नहीं देकर इनवॉइस पढ़ना नहीं सिखाते। आप किसी ऐसे व्यक्ति को भर्ती करते हैं जो पहले से ही पढ़ना जानता हो, फिर उसे आपके विशिष्ट इनवॉइस प्रारूप को सिखाते हैं। FedTR वही करता है: सार्वजनिक डेटासेट मॉडल को सामान्य रूप से पढ़ना सिखाता है, और संघीय शिक्षा उसे आपके कारखाने के विशिष्ट फॉन्ट, लेआउट और दोष पैटर्न सिखाती है।
यह एक उचित विचार है और, ईमानदारी से कहें तो, यह बहुत नया भी नहीं है। ट्रांसफर लर्निंग और संघीय शिक्षा को अन्य क्षेत्रों में मिलाया गया है। जो पेपर वास्तव में योगदान देता है, वह यह दिखा रहा है कि यह काम करता है, और कितनी अच्छी तरह से, एक वास्तव में कठिन और व्यावसायिक रूप से वास्तविक कार्य पर: स्याही कार्ट्रिज पर दोषों से भरे लेबल पढ़ना।
उन्होंने वास्तव में क्या परीक्षण किया, और इसका खर्च क्या था
टीम ने निजी इनक कार्ट्रिज डेटासेट पर दो स्थितियों में प्रयोग किए:
- समजातीय (Homogeneous): प्रत्येक फैक्ट्री का डेटा सांख्यिकीय रूप से अन्य के समान दिखता है (एक ही लेबल शैली, समान दोष प्रकार)।
- विषमजातीय (Heterogeneous): प्रत्येक फैक्ट्री का डेटा अलग दिखता है (भिन्न लेबल डिज़ाइन, भिन्न दोष वितरण)। यह एक वैश्विक कंपनी के लिए बहुत कठिन और अधिक यथार्थवादी स्थिति है जिसके पौधे विभिन्न देशों में विभिन्न उत्पाद बनाते हैं।
FedTR ने समजातीय सेटअप पर 95.5% शब्द-स्तर की सटीकता प्राप्त की और विषमजातीय पर 94.2%। यहाँ शब्द-स्तर की सटीकता का अर्थ है कि मॉडल ने पूरा शब्द सही पाया, न कि केवल अधिकांश वर्ण, जो कि बैच कोड जैसे कुछ के लिए वास्तव में मायने रखने वाला मानक है: "LOT4471X" में 10 में से 9 वर्ण सही पाना असफल पढ़ाई है, 90% सफलता नहीं।
उस संख्या पर रुकने के लिए जो महत्वपूर्ण है वह समजातीय और विषमजातीय के बीच की छोटी खाई है: 1.3 प्रतिशत बिंदु। संघीय शिक्षा (Federated learning) में एक अच्छी तरह से दस्तावेजीकृत विफलता मोड है जहाँ प्रदर्शन गिर जाता है जब क्लाइंट डेटा वितरण अलग होते हैं (शोधकर्ता इसे "non-IID समस्या" कहते हैं, जहाँ IID स्वतंत्र और समान रूप से वितरित के लिए खड़ा है, एक फैंसी तरीका कहने के लिए "आपका प्रशिक्षण डेटा सभी एक ही सांख्यिकीय वितरण से नहीं आता")। यहाँ एक छोटी खाई का अर्थ है कि ट्रांसफर-लर्निंग प्री-ट्रेनिंग चरण उस विफलता मोड से मॉडल को सुरक्षित करने में वास्तविक काम कर रहा है, न कि केवल एक सीमांत बढ़ोतरी जोड़ रहा है।
दूसरी प्रमुख संख्या: FedTR के संघीय परिणाम केंद्रीकृत प्रशिक्षण के लगभग बराबर हैं, जिसका अर्थ है कि सभी डेटा को एक जगह एक साथ पूल करके एक मॉडल को प्रशिक्षित करना, जो यहाँ अनुमति नहीं है लेकिन सैद्धांतिक छत के रूप में कार्य करता है। बिना किसी डेटा को पूल किए उस छत को मिलाना अभ्यास का पूरा उद्देश्य है, और कागज़ दावे को केवल दावा करने के बजाय वास्तविक संख्याओं के साथ समर्थन करता है।
यदि आप OCR बना रहे हैं या खरीद रहे हैं, तो यह क्यों मायने रखता है
यदि आप डेटा रेजिडेंसी आवश्यकताओं, मल्टी-साइट मैन्युफैक्चरिंग, अस्पताल प्रणालियों में स्वास्थ्य रिकॉर्ड, या क्षेत्रीय इकाइयों में वित्तीय दस्तावेज़ों के लिए दस्तावेज़ पाइपलाइन बना रहे हैं, तो यह पेपर एक उपयोगी डेटा पॉइंट है कि "केन्द्रित रूप से ट्रेन करें या बिल्कुल न ट्रेन करें" का ट्रेडऑफ उतना बाइनरी नहीं है जितना दिखता है।
इस प्रकार के वातावरण में OCR का मूल्यांकन करने वालों के लिए कुछ ठोस निष्कर्ष:
- प्रीट्रेनिंग फेडरेशन मेकानिज़म से अधिक महत्वपूर्ण है। FedTR की चालाकता फेडरेटेड एवरेजिंग में नहीं है, जो ज्यादातर मानक है। असली चालाकता फेडरेटेड ट्रेनिंग को शून्य से शुरू करने से इनकार करना है। यदि आप सिलोड डेटा में फंसे हैं, तो सबसे अधिक प्रभावशाली कदम आमतौर पर एक मजबूत जनरल-पर्पोज़ बेस मॉडल होता है, न कि कोई अधिक जटिल एग्रीगेशन एल्गोरिदम।
- मानें नहीं कि फेडरेटेड लर्निंग फ्री लंच है। पेपर ईमानदारी से बताता है कि छोटे, कठिन डेटासेट्स पर साधारण FL कम प्रदर्शन करता है, जो कई प्रैक्टिशनर्स के कठिन अनुभव से मेल खाता है। यदि कोई आपको डेटा-सिलो समस्या के समाधान के रूप में "बस इसे फेडरेट करें" पेश करता है, तो पूछें कि बेस मॉडल किस पर प्रीट्रेन किया गया था।
- वर्ड-लेवल एकरसी ही वह मेट्रिक है जिसकी मांग करनी चाहिए, न कि कैरेक्टर-लेवल। बहुत सारा OCR मार्केटिंग कैरेक्टर एकरसी पर भरोसा करती है क्योंकि यह एक बड़ी, बेहतर दिखने वाली संख्या है। किसी भी डाउनस्ट्रीम प्रक्रिया के लिए जो पूले फील्ड्स (बैच कोड, SKU, तारीखें) को पार्स करती है, कैरेक्टर एकरसी एक ऐसे मॉडल को छुपा सकती है जो व्यावहारिक रूप से उपयोगहीन है। 95.5% वर्ड एकरसी एक वास्तव में मजबूत संख्या है बिल्कुल इसलिए क्योंकि यह एक कठिनतर मानक है।
मजबूत अंग्रेजी OCR का मतलब यह नहीं है कि देवनागरी OCR भी उतना ही अच्छा होगा; देवनागरी लिपि में जटिल संयुक्त अक्षरों, मात्राओं और शिरोरेखा की उपस्थिति के कारण इसकी ओसीआर चुनौतियाँ अलग होती हैं।
क्या गायब है, और क्यों आपको अत्यधिक बाह्यकरण (over-extrapolate) नहीं करना चाहिए
पेपर एक कंपनी के स्याही कार्ट्रिज लेबल पर परीक्षण करता है। यह एक वास्तविक, विशिष्ट, व्यावसायिक रूप से महत्वपूर्ण बेनचमार्क है, लेकिन यह केवल एक उत्पाद श्रेणी, एक पेपर का निजी डेटासेट है, और "विषम" (heterogeneous) सेटअप अभी भी एक कंपनी के डेटा के भीतर सिमुलेटेड विविधता है, बजाय इसके कि वास्तव में स्वतंत्र संगठन हों जिनके पास लेबलिंग की बहुत अलग-अलग परंपराएं हों।
संचार लागत या इस बात पर चर्चा भी नहीं है कि अभिसरण (converge) होने में कितने फेडरेटेड राउंड लगे, जो व्यावहारिक रूप से बहुत महत्वपूर्ण है: तीन कारखानों के बीच मॉडल अपडेट को कुछ बार आगे-पीछे भेजना ठीक है, लेकिन तीन सौ प्लांट्स (या एक वास्तविक वैश्विक कंपनी) के बीच ऐसा करना पूरी तरह से एक अलग बुनियादी ढांचे की समस्या है। और अन्य डोमेन में दिखाई देने वाले अन्य ट्रांसफर-लर्निंग-प्लस-एफएल (transfer-learning-plus-FL) संयोजनों के साथ कोई तुलना नहीं है, इसलिए यह जानना मुश्किल है कि FedTR का विशिष्ट रेसिपी स्पष्ट विकल्पों से बेहतर है या बस पहला ऐसा विकल्प है जिसे इस डेटासेट पर किसी ने आजमाया।
फिर भी, दिशा सही है और यहाँ दिखाए गए और उत्पादन तैनाती के बीच का अंतर सामान्य इंजीनियरिंग का काम है, शोध का अंतर नहीं। दस्तावेज़ एआई के क्षेत्र में, जहाँ बहुत सारे प्रकाशित कार्य कभी भी वास्तविक, निजी, व्यावसायिक रूप से संवेदनशील डेटासेट को नहीं छूते, एक वास्तविक निर्माण भागीदार से वास्तविक स्याही कार्ट्रिज क्वालिटी एशुरेंस (QA) डेटा पर परीक्षण करना कुछ मायने रखता है। यह एक पेपर और दूसरे पेपर के बीच का अंतर है: पहला यह सिद्ध करता है कि एक तकनीक बेनचमार्क पर काम करती है, और दूसरा यह सिद्ध करता है कि यह कारखाने के फर्श के संपर्क में आने पर भी टिकती है।